LFM3-Omni-2B: un solo modelo de 4,5 GB escucha, mira y responde hablando con 5 GB de GPU
El modelo omni de 2B de Liquid AI respondió en voz alta a preguntas habladas y leyó fotos y vídeo con unos 5 GB de GPU. Una tarjeta de 16 GB siguió el ritmo.
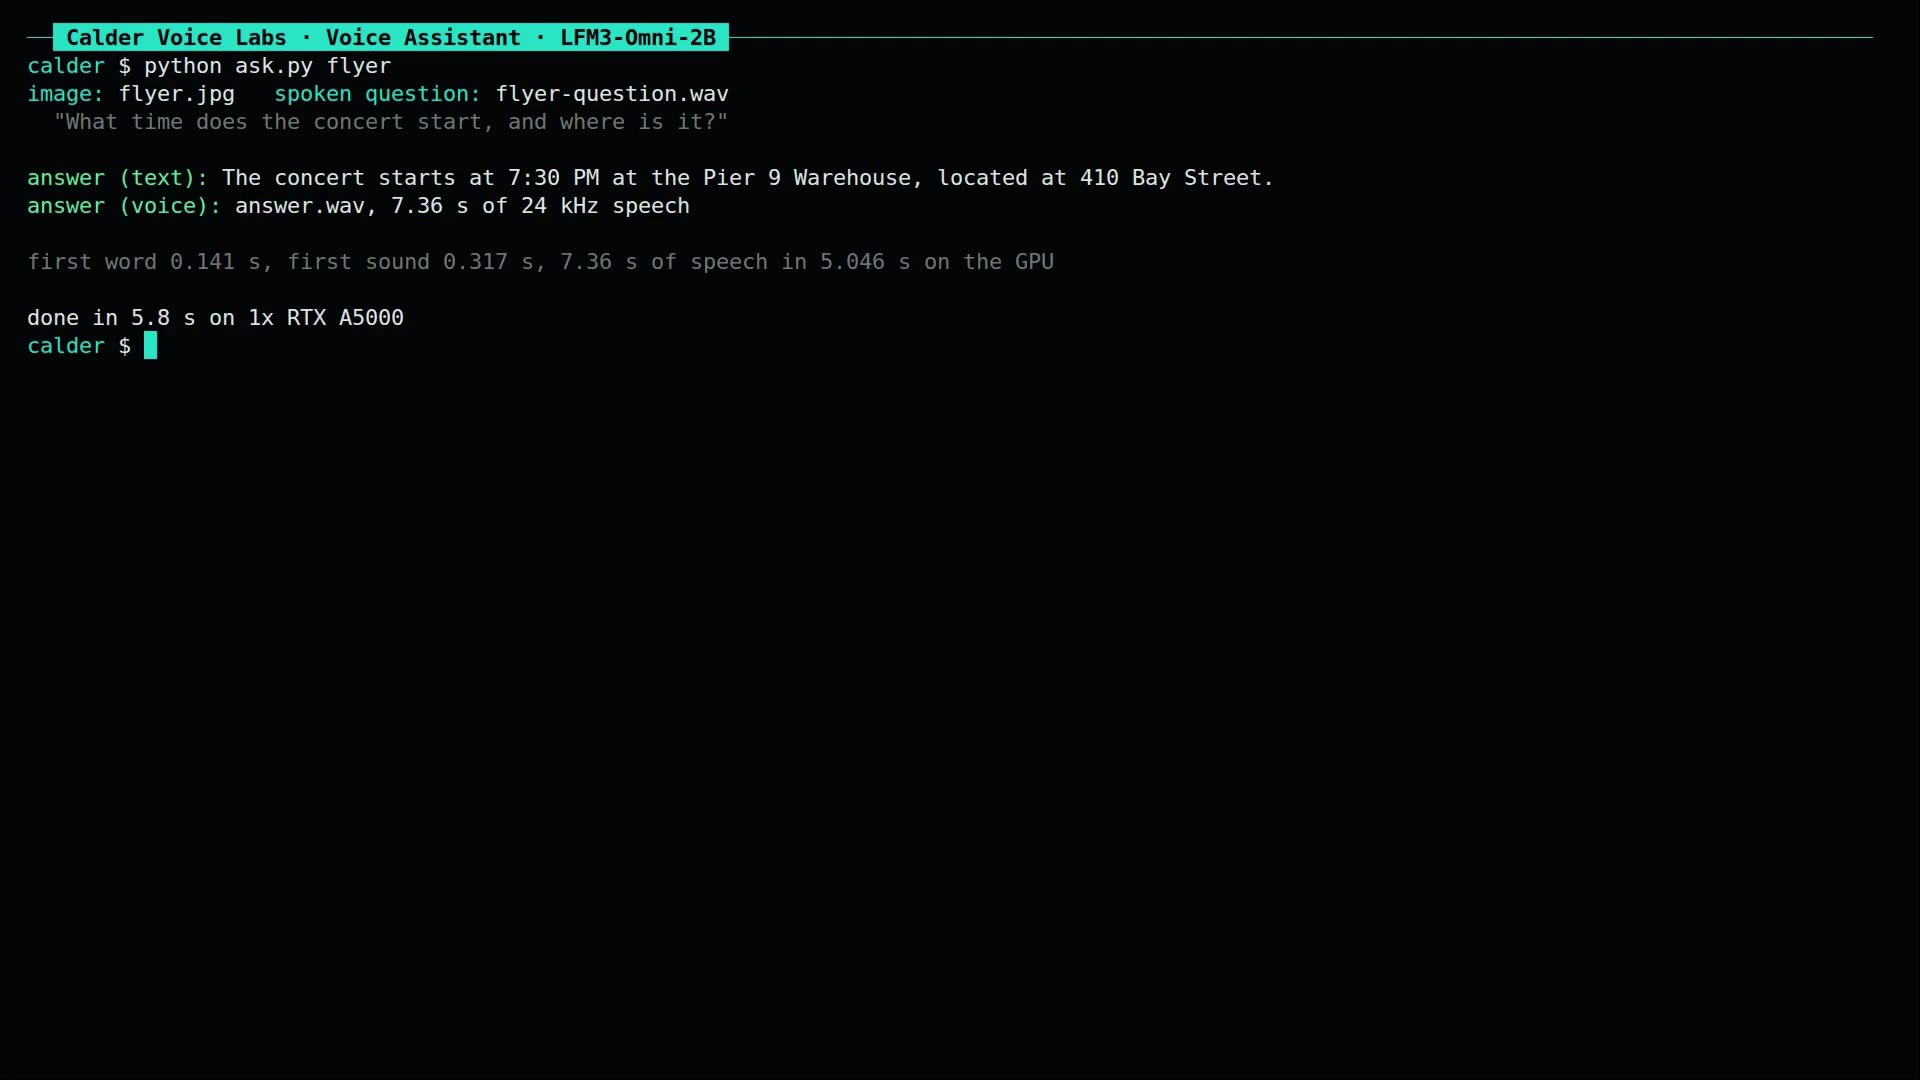
Le enseñamos a LFM3-Omni-2B el cartel de un concierto, le preguntamos en voz alta cuándo y dónde era, y la GPU tuvo la respuesta escrita en menos de un segundo: 7:30 PM, Pier 9 Warehouse. Un asistente de voz suele necesitar cuatro modelos para eso: uno para oír, otro para ver, otro para pensar y otro para hablar. Este modelo abierto de Liquid AI es un único juego de pesos de 4,5 GB que hace las cuatro cosas. Lo ejecutamos en una RTX A5000 de nuestra nube a través de InferenceKey, y también respondió con su propia voz, con unos 5 GB de memoria de GPU.
Si tienes tus propias GPU, eso significa que todas las etapas de un asistente de voz entran en una tarjeta pequeña. Hay dos pegas. El servidor rápido de código abierto para este modelo, SGLang, solo escribe texto, así que para la voz usamos el código del propio modelo, unas cuatro veces más lento con el texto en nuestra prueba. Y la licencia corta el uso comercial a partir de 10 millones de dólares de facturación anual.
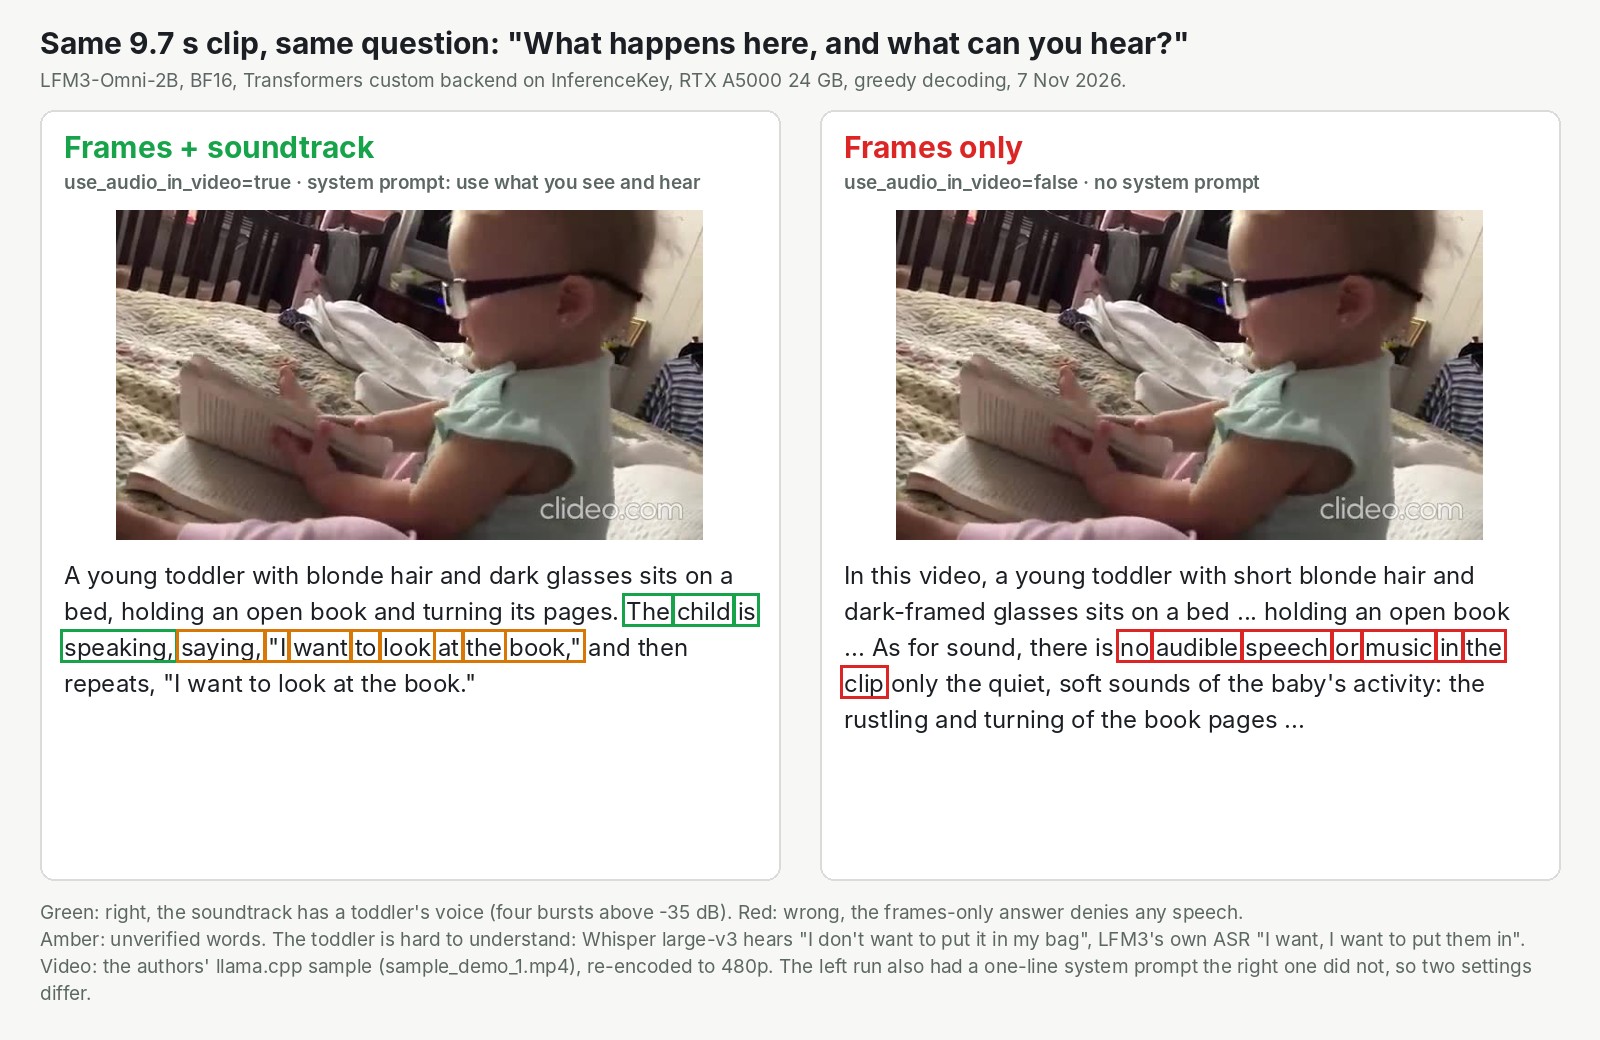
El mismo clip, la misma pregunta escrita. Con la banda sonora, el modelo oye a una niña hablar. Solo con los fotogramas, dice que el clip está en silencio. La ejecución con sonido llevaba además una instrucción de una línea para usar lo que ve y oye, así que cambiaron dos ajustes, no uno. Aun así, solo la ejecución que recibió el sonido supo que estaba ahí.
Un modelo pequeño donde un asistente de voz suele encadenar cuatro
La ficha del modelo de Liquid AI dice que "replaces a separate ASR model, vision-language model, LLM and TTS model". Dicho de forma llana: reconocimiento de voz, un modelo de visión, un modelo de lenguaje y un sintetizador de voz, en una sola red. Nuestra prueba quería ver si eso se sostiene en una tarjeta pequeña.
Acepta texto, imágenes, vídeo con su banda sonora y voz grabada. Responde en texto, en voz o en las dos cosas a la vez. En este último modo escribe una frase y la pronuncia en la misma pasada, así que una pantalla y un altavoz reciben la misma respuesta. Según la lista de Liquid AI, habla 19 combinaciones de idioma y acento, del árabe al chino, con voces femeninas y masculinas; nosotros probamos inglés y español. Puede tener a la vista unos 32.000 fragmentos de palabra: una transcripción escrita larga, pero solo unos pocos minutos de vídeo, porque nuestro clip de un minuto ya ocupó unos 8.500. Responde directamente, sin un paso de razonamiento oculto antes.
Liquid AI lo construyó sobre LFM3-1.7B, su nuevo modelo de lenguaje pequeño. Le añadieron un lector de imágenes, un lector de sonido que empieza a trabajar mientras todavía estás hablando y una parte que convierte la salida en audio. El anuncio de LFM3 de Liquid AI es del 27 de octubre. Es uno de los seis modelos pequeños de la familia. Lo vimos en el vídeo de noticias de AI Search, cuyo narrador lo resumió como un modelo diminuto que puede "see, hear, understand, and even talk back to you".
Los autores lo comparan con otros modelos abiertos pequeños que también aceptan sonido y vídeo. Estas son sus cifras. No las reprodujimos.
| Prueba (cifras de los autores) | LFM3-Omni-2B | Qwen2.5-Omni-3B | Qwen2.5-Omni-7B |
|---|---|---|---|
| Daily-Omni, preguntas sobre vídeo cotidiano con sonido | 70,09 | 58,81 | 61,32 |
| OmniBench, razonamiento mixto con imagen y audio | 46,32 | 47,11 | 49,65 |
| Tasa de error de transcripción en inglés (menos es mejor) | 6,36 | 6,30 | no figura |
Gana la primera fila por mucho margen y pierde la segunda frente a los dos modelos Qwen. En transcripción está a la par con el Qwen más pequeño. Los autores publican también las derrotas, y eso hace que la tabla sea más fácil de creer. La tabla completa, con los modelos pequeños Gemma 4 de Google, está en el apéndice.
Nuestra prueba: dos tarjetas pequeñas y un puñado de grabaciones cortas
Ejecutamos el modelo completo, sin comprimir, en dos GPU de nuestra nube a través de InferenceKey: una RTX A5000 de 24 GB para la prueba principal y una RTX 2000 Ada de 16 GB en una máquina recién creada. Las dos con el mismo código.
Los casos eran pequeños y prácticos. Una pregunta hablada sobre una montaña, con respuesta en voz. Un cartel de concierto inventado más una pregunta hablada sobre él. Un clip de un conjunto público de audiolibros para transcribir. Una petición hablada para bajar el volumen, que debía volver como una orden que una aplicación pueda ejecutar. Dos frases para leer en voz alta, en inglés y en español. Y un clip de 10 segundos de los propios ejemplos de Liquid AI, con y sin su sonido.
Los límites, una sola vez. Una petición cada vez. Entradas cortas nuestras, no los benchmarks de los autores. Ninguna persona juzgó la voz: un reconocedor de voz aparte, Whisper, volvió a leer el audio. No probamos las versiones comprimidas, ni el servidor de voz en tiempo real que recomienda Liquid AI, ni ninguna tarjeta real de menos de 16 GB. Tampoco montamos una cadena de cuatro modelos pequeños separados en la misma tarjeta, así que nada de esto demuestra que la vía de un solo modelo sea más rápida, más pequeña o mejor que esa cadena.
Una respuesta hablada de 10 segundos: generada en unos 7 segundos, entregada en 8 a 10
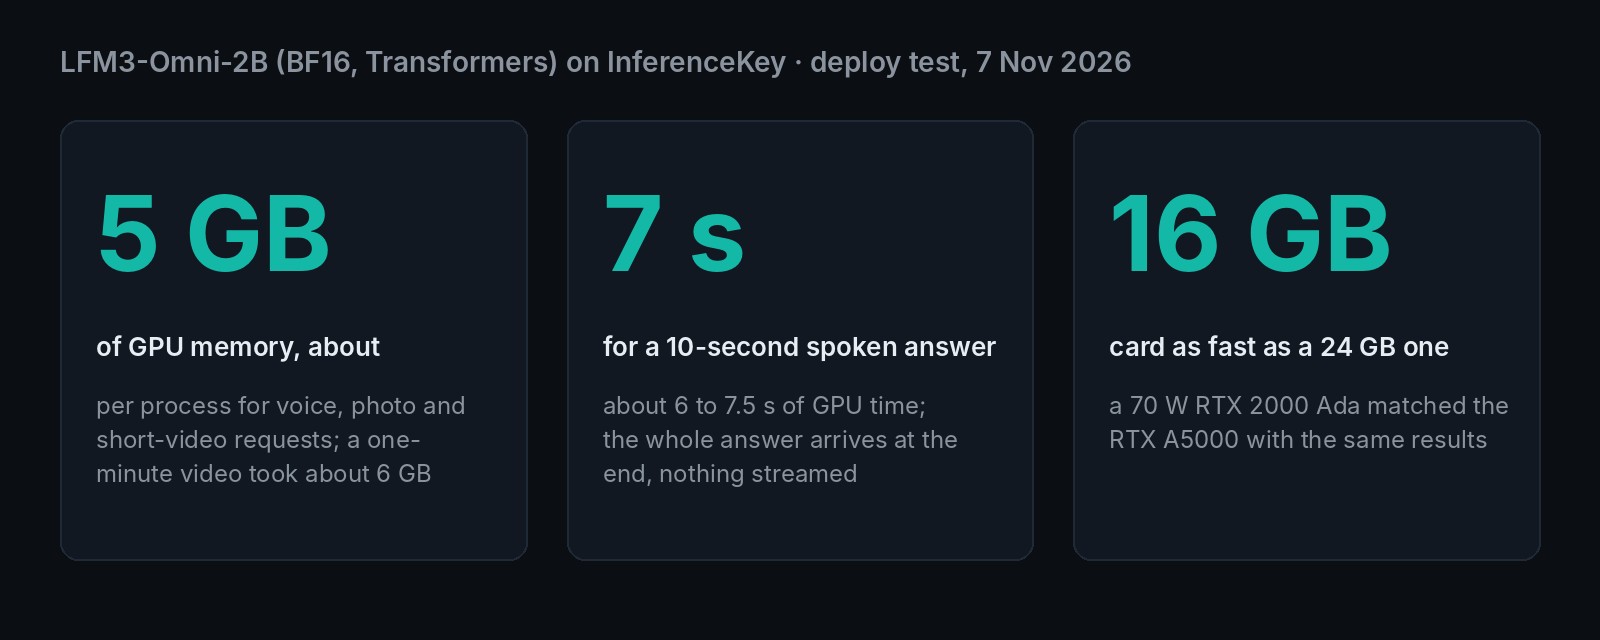
Una respuesta hablada de 10 segundos estaba lista en la GPU en unos 6 a 7,5 segundos. Llegó a quien la pidió a los 8 a 10 segundos, porque nuestro montaje envía el audio como un único fichero al final. Todas las respuestas habladas tardaron menos en generarse que en reproducirse: una frase de 4 segundos tardó de 2 a 3 segundos.
| Qué pedimos | Qué volvió | Tiempo de GPU (A5000 / tarjeta de 16 GB) |
|---|---|---|
| Una pregunta hablada sobre la montaña más alta de África, respuesta en voz | Kilimanjaro, 5.895 metros, unos 10 s de voz | 7,4 s / 6,6 s |
| Cartel de concierto más una pregunta hablada sobre cuándo y dónde | "The concert starts at 7:30 PM, and it is located at Pier 9 Warehouse, 410 Bay Street." | 0,84 s / 0,93 s |
| Clip de audiolibro de 12,5 s, transcribir | Exacta, salvo mayúsculas y comas | 1,16 s / 1,01 s |
| Una petición hablada para poner el volumen a 30, con una herramienta de volumen | set_volume({"volume": 30}) | 0,56 s / 0,45 s |
| Leer en voz alta una frase en español | Whisper oyó "El museo abre a las 10 de la mañana y cierra a las 6 de la tarde." | 2,3 s / 2,2 s |
Esta es la propia voz del modelo respondiendo a la pregunta del cartel:
La respuesta hablada del modelo a la pregunta del cartel, 7,4 s, generada en la A5000
Dentro del servidor, el primer trozo de voz estaba listo a los 0,2 a 0,5 segundos, así que el streaming podría acortar la espera, pero no lo construimos ni lo probamos.
Dónde falla: una cifra en pies y palabras en el balbuceo de una niña
Los datos simples eran correctos. Los fallos fueron una conversión de unidades y dos descripciones de vídeo. Preguntamos diez veces por voz la altura del Kilimanjaro, en las dos tarjetas y con varios límites de memoria. Los metros salieron bien nueve de cada diez veces, y los pies salieron mal en la mayoría de las ejecuciones. Las respuestas habladas cambian de una ejecución a otra, porque la voz se genera con cierto azar incorporado y las palabras la siguen. Un asistente de voz que lee cifras en voz alta necesita una comprobación, o una herramienta, para las conversiones.
La respuesta sobre el vídeo es la otra advertencia. El modelo citó a la niña diciendo "I want to look at the book". Esa frase está sin verificar. Whisper oyó "I don't want to put it in my bag". El propio modelo, cuando solo le pedimos transcribir el sonido, oyó "I want, I want to put them in". A la niña cuesta entenderla, así que toma las palabras citadas de un audio poco claro como una suposición.
En un clip de un minuto de la propia demo callejera de Liquid AI, describió bien la escena y leyó bien los letreros de las tiendas. También llamó a imágenes reales de una calle "a driving video game".
Qué GPU: unos 5 GB de memoria, y una tarjeta real de 16 GB fue tan rápida como una de 24 GB
El modelo necesita unos 5 GB libres para voz, fotos y clips cortos, y unos 6 GB para un vídeo de un minuto. La tarjeta real más pequeña que usamos es la RTX 2000 Ada de 16 GB, una tarjeta de estación de trabajo de 70 vatios. Dio los mismos resultados que la A5000 de 24 GB, sin perder velocidad.
Para ver hasta dónde baja, limitamos paso a paso en la A5000 la memoria que podía usar el código del propio modelo. Es un límite por software en una tarjeta más grande, no una tarjeta más pequeña, y el proceso entero necesita unos 0,4 GB por encima del límite.
| Tarjeta o límite de memoria | Voz, foto, transcripción, lectura en voz alta y un vídeo de 10 s |
|---|---|
| RTX 2000 Ada 16 GB, tarjeta real | todo pasa, tarjeta real |
| Memoria del modelo limitada a 4,8 GB (simulado) | todo pasa |
| Memoria del modelo limitada a 4,7 GB (simulado) | el vídeo de 10 s se queda sin memoria |
El reparto al servir: el servidor rápido es cuatro veces más rápido con texto, y no puede hablar
Con un arreglo todavía sin publicar, el servidor rápido, SGLang, escribe texto cuatro veces más deprisa, pero no puede hablar.
Este es el primer problema con el que te vas a topar. La documentación de Liquid AI da un comando de SGLang de una línea, pero la versión publicada de SGLang (la 0.5.23) no soporta este modelo, y en nuestra tarjeta se cayó durante el arranque. El arreglo existe como un cambio propuesto, #46858, todavía abierto cuando lo comprobamos el día de la prueba. El servidor SGLang listo para usar de InferenceKey usa la versión publicada, así que no puede servir LFM3 hasta que salga ese arreglo. Estado: esperando a SGLang.
Compilamos ese cambio a mano, fuera de la plataforma, para ver cuánto vale. Con respuestas idénticas, un párrafo tardó alrededor de un segundo en vez de cuatro (158 fragmentos de palabra por segundo frente a 38 a 40). Para un solo usuario cada vez, la vía lenta sirve; no probamos varios a la vez. Para mucho tráfico de texto, espera a la versión publicada.
La licencia: el uso comercial se acaba en 10 millones de dólares de facturación
Los pesos se publican con la LFM Open License v1.0, no con una licencia de código abierto estándar. El uso comercial solo está permitido mientras la facturación anual de tu organización se mantenga por debajo de 10 millones de dólares estadounidenses. Por encima de eso, el uso comercial no está licenciado. Las organizaciones sin ánimo de lucro que cumplan los requisitos quedan exentas para investigación y uso no comercial.
Para una startup o un equipo de producto pequeño, es lo bastante abierta para sacar un producto. Para una empresa grande, significa hablar con Liquid AI sobre otras condiciones antes del primer despliegue, no después. El texto de la licencia es corto.
En InferenceKey: listo en menos de un minuto, un backend propio para todos los modos
Un backend propio en una GPU de nuestra nube sirvió voz, fotos, vídeo y órdenes desde una sola dirección, listo en menos de un minuto. Un backend propio es un fichero corto de Python que subes a InferenceKey: la plataforma instala sus dependencias en tu máquina con GPU y le envía las peticiones. Ninguno de los motores integrados de InferenceKey puede hacer hablar a este modelo (el servidor en tiempo real de llama.cpp sí puede, pero no lo probamos), así que el nuestro mueve el código del propio modelo y devuelve el texto y el fichero de audio en una sola respuesta.
En la A5000, el modelo estuvo listo 46 segundos después de pedirlo. En la máquina nueva de 16 GB, que tuvo que instalarlo todo desde cero, tardó 59,5 segundos. La descarga de 4,5 GB en sí tardó de 5 a 6 segundos.
La plataforma corría desde una copia local de InferenceKey, con el mismo código que el servicio alojado. El ejemplo del SDK fija el modelo a una máquina con GPU que registras tú, así que el modelo se ejecuta en hardware que controlas. Las peticiones siguen pasando por la API de InferenceKey, salvo que alojes el propio InferenceKey en tus servidores.
¿Merece la pena? Sí, para montar un asistente de voz en tu propia tarjeta pequeña, con una comprobación de cifras
- Quieres un asistente de voz que oiga, vea y hable en tu propio hardware: sí, como base para construir, con una comprobación de las cifras que lee en voz alta. Tal como lo probamos, quien pregunta espera a la respuesta completa.
- Necesitas texto rápido para mucho tráfico: todavía no. Espera a la versión publicada de SGLang.
- Tienes una tarjeta de menos de 16 GB: los límites de memoria de arriba dicen que bastan unos 5 GB libres.
- Tu empresa factura 10 millones de dólares al año o más: habla con Liquid AI antes de construir sobre él.
Para oír tres de esas mismas respuestas desde tu propia GPU (la respuesta en voz, el cartel y la lectura en voz alta), ejecuta el ejemplo del SDK de LFM3-Omni-2B. Necesita un proyecto, un token del SDK, una API key y una máquina NVIDIA con GPU que registres (una tarjeta reciente) con unos 5 GB libres. Sube el backend una vez con python publish.py y después ejecuta python main.py. Al terminar borra el despliegue.
Para ingenieros
Créditos
- Liquid AI: el modelo, la base LFM3-1.7B, el codificador de visión, el codificador de audio causal, el tokenizador de audio LiquidCodec, la ficha del modelo, los benchmarks, la documentación, las versiones GGUF y los vídeos de ejemplo (incluido el clip de la niña de su ejemplo de llama.cpp y la demo callejera de su vídeo de lanzamiento).
- El autor de la PR de SGLang (tugot17, sgl-project/sglang#46858): la implementación de SGLang que compilamos a mano.
- Los mantenedores de Hugging Face Transformers: la librería sobre la que corre el backend propio (
trust_remote_code,AutoModelForMultimodalLM). - Los mantenedores de llama.cpp: el soporte de GGUF y del servidor en tiempo real (no lo probamos).
- OpenAI Whisper large-v3 (con faster-whisper): la relectura independiente de cada WAV. LibriSpeech: el clip de transcripción.
- Kyutai Pocket TTS (voz "alba"): generó nuestras preguntas habladas de prueba.
- AI Search: donde vimos el modelo (vídeo de noticias del 2026-11-01, capítulo de LFM3 en el 44:17).
- Nuestra parte: el backend propio, el despliegue a través de la plataforma en dos tarjetas, las entradas de prueba, la comprobación de la banda sonora, la escalera de memoria, los intentos con SGLang, el ejemplo del SDK y el vídeo de la demo.
Modelo y ficheros
LiquidAI/LFM3-Omni-2B, revisión21d75123f86c1f7ffb4bef1ea202710c4e7ebe67(creada el 2026-10-21, modificada por última vez el 2026-11-03, sin acceso restringido). 4.499.839.711 bytes:model.safetensors4.333.941.640 B,audio_tokenizer/model.safetensors147.143.540 B,tokenizer.json17.908.634 B. Algunos catálogos indican "5,4 GB": es una estimación de VRAM, no el checkpoint.- 2,17B parámetros. Entradas: texto, imágenes y vídeo a resolución nativa (cada bloque de parches de 2x2 es un token, hasta 2.048 tokens por imagen), vídeo a 2 fps con 4 a 384 fotogramas por defecto, audio a 16 kHz. Salidas: texto, voz a 24 kHz, o intercaladas. Contexto de 32K tokens (entrada más salida). Vocabulario de texto de 128.000 tokens.
- Variantes de voz (19): árabe, danés, alemán, griego, inglés británico, inglés estadounidense, finés, francés, hebreo, italiano, japonés, coreano, neerlandés, polaco, portugués, español, sueco, turco, chino. Idiomas de texto (16): inglés, árabe, chino, francés, alemán, italiano, japonés, coreano, portugués, español, vietnamita, tailandés, indonesio, hindi, ruso, polaco.
- Sin razonamiento:
enable_thinking=Trueno está soportado, todas las respuestas empiezan con un bloque de pensamiento vacío. - Requiere
transformers>=5.20.2contrust_remote_code. El vídeo con sonido necesitaload_audio_from_video=Trueyuse_audio_in_video=True; si no, solo usa los fotogramas. - Muestreo recomendado: greedy para texto; para voz
audio_temperature=0.4,audio_repetition_penalty=1.2(la documentación añadeaudio_repetition_window=64). - Repo GGUF
LiquidAI/LFM3-Omni-2B-GGUF(shad508b88f, creado el 2026-10-27): F16/BF16 3,47 GB, Q8_0 1,85 GB, Q4_K_M 1,10 GB, Q4_0 1,05 GB; mmproj F16/BF16 0,95 GB, Q8_0 0,51 GB, Q4_K_M 0,29 GB, Q4_0 0,27 GB. Necesita llama.cpp b11960 (v0.8.0) o posterior; voz en tiempo real con llamadas a herramientas en el WebSocket/v1/realtimedellama serve, por ejemplollama serve -hf LiquidAI/LFM3-Omni-2B-GGUF:Q4_K_M --reasoning off --temp 0 --port 8080; síntesis de voz conllama-tts. No lo probamos. - Blog de Liquid AI: seis modelos LFM3 de unos 2B a partir de LFM3-1.7B-Base, 22T tokens de preentrenamiento. El codificador de audio causal puede hacer el prefill mientras el usuario habla ("as low as 50 ms" hasta el primer token); LiquidCodec decodifica a unas 87x tiempo real en un hilo de CPU (Apple M4 Max), 12 tokens por cada 80 ms de voz. Son afirmaciones suyas, no las medimos.
Afirmaciones de los autores (no reproducidas)
Todo medido por Liquid AI, sacado de la ficha del modelo:
| Benchmark | LFM3-Omni-2B | Qwen2.5-Omni-3B | Qwen2.5-Omni-7B | Gemma 4 E2B | Gemma 4 E4B | Phi-4-mm |
|---|---|---|---|---|---|---|
| Daily-Omni | 70,09 | 58,81 | 61,32 | 50,63 | 54,14 | 48,87 |
| WorldSense | 47,10 | 44,99 | 45,37 | 38,11 | 43,51 | 42,37 |
| OmniBench global | 46,32 | 47,11 | 49,65 | 16,81 | 20,67 | 38,97 |
| WER de ASR en inglés (menos es mejor) | 6,36 | 6,30 | no figura | 8,26 | 7,82 | 5,14 |
| UTMOSv2 de TTS en inglés | 3,80 | 3,42 | no figura | no figura | no figura | no figura |
| VoiceBench | 64,73 | 66,37 | no figura | 63,28 | 72,90 | 64,97 |
| Llamadas a herramientas (evaluación interna) | 52,20 | 44,30 | no figura | 55,60 | 72,40 | no figura |
"No figura": la tabla de audio de la ficha no tiene columna de Qwen2.5-Omni-7B, da UTMOSv2 solo para LFM3-Omni-2B y Qwen2.5-Omni-3B, y no tiene puntuación de llamadas a herramientas para Phi-4-mm. En llamadas a herramientas, LFM3-Omni-2B supera a Qwen2.5-Omni-3B y queda por detrás de los dos modelos Gemma 4. La ficha también publica resultados de AV-SpeakerBench, OmniBench de voz, preguntas habladas sobre imágenes, visión, ASR multilingüe y MMAR, que no copiamos aquí.
Montaje
- GPU en InferenceKey Cloud: RTX A5000 24 GB (24.564 MiB, 230 W, compute capability 8.6, driver 595.91.07, CUDA 13.2) para la prueba principal; RTX 2000 Ada Generation 16 GB (16.380 MiB, 70 W, compute capability 8.9) para el escalón real de 16 GB, en un worker nuevo. La A5000 fue la primera tarjeta de 24 GB que apareció; la RTX 2000 Ada era la tarjeta real más pequeña disponible.
- Otra vía que da la ficha: versiones GGUF para llama.cpp, en CPU y GPU, con un servidor de voz en tiempo real (detalles en Modelo y ficheros). Sin probar.
- Backend: un backend propio en Python (
lfm3-omni-2b0.1.0, tareatext2audio, ruta de chat) sobre transformers 5.22.2, torch 2.15.0, torchvision 0.29.2, BF16. Por qué propio: la salida de voz e intercalada solo existe en el código Transformers del checkpoint; ningún motor integrado de InferenceKey sirve voz para este modelo (el servidor en tiempo real de llama.cpp no se prueba aquí), y la versión publicada de SGLang no lo sirve en absoluto. setup()instala ffmpeg si falta, descarga el checkpoint en la revisión fijada, cargaAutoModelForMultimodalLM.from_pretrained(dtype=bf16, trust_remote_code=True), el procesador y LiquidCodec, y calienta texto y voz.process()recibe mensajes de OpenAI (text,input_audio,image_url/video_urlcomo data URLs) y devuelve texto, un WAV de 24 kHz en base64, lastool_callsya parseadas y los tiempos (primer token de texto, primer fotograma de voz mediante streamers, segundos de GPU, VRAM pico).- Un manager local de InferenceKey (mismo código que el servicio alojado). Producción no se tocó en ningún momento.
- Texto greedy; voz con
audio_temperature0.4 yaudio_repetition_penalty1.2. Las entradas habladas se hicieron con Pocket TTS de Kyutai (voz "alba"), ejecutado en local; el cartel es una imagen inventada. Las preguntas sobre los vídeos se escribieron, y todas las respuestas sobre vídeo fueron solo texto (modetext).
Paso a paso con el ejemplo del SDK
- Clona inferencekey-sdk y abre
examples/lfm3-omni-2b-voice-vision-custom-backend-private-nvidia(commitba49628ec5b24b68e8c404b1e54772df6b499f6b). cp .env.example .envy rellenaINFERENCEKEY_SDK_TOKEN,INFERENCEKEY_API_KEY,INFERENCEKEY_PROJECTeIK_WORKER_ID(un worker NVIDIA registrado, compatible con bf16, Ampere o posterior, con unos 5 GB de memoria de GPU libre, 6 GB para un vídeo de un minuto, un driver para CUDA 12.8 o posterior, y ffmpeg para vídeo). Parapublish.py, tambiénINFERENCEKEY_TENANT_IDeINFERENCEKEY_USER_TOKEN.- Instala el cliente y la compilación local del SDK:
python -m venv .venv && . .venv/bin/activate
pip install requests
pip install maturin && ( cd ../../bindings/python && maturin develop --release )
python publish.pyuna vez: empaquetabackend.pyy lo sube a tu tenant (o subedist/*.tar.gzen Dashboard, Custom backends, y activa "Chat" en Endpoint settings).python main.py:ensure()declara el workload (backend="lfm3-omni-2b",task_type="text2audio", política fija, una réplica) fijado a tu worker, espera a que esté listo, envía tres peticiones (pregunta hablada con respuesta de voz intercalada, cartel más pregunta hablada, texto a voz), escribe las respuestas en./outputsy llama adelete()salvo queIK_KEEP_ALIVE=1.
Opciones de la petición en extra_body: mode (text, audio, interleaved), max_new_tokens (un fotograma de voz de 80 ms cuenta como uno), temperature, audio_temperature, audio_repetition_penalty, use_audio_in_video (true por defecto), fps, tools (esquemas de funciones de OpenAI). LFM3_VRAM_LIMIT_GIB limita la memoria de PyTorch. Envía "model": "default". Los medios en línea cuentan contra un límite por petición de unos 2 MiB de JSON: un MP4 de 480p y 10 s ocupa unos 230 KB.
Tiempos
| Paso | RTX A5000 | RTX 2000 Ada |
|---|---|---|
De ensure() a listo | 46,0 s (caché de uv caliente) | 59,5 s (worker nuevo, caché de uv vacía) |
| Construcción del venv más setup | 20,0 s | |
| Descarga de pesos (precargada en paralelo) | 5 s | 6 s |
| Carga | 3,6 s | |
| Calentamiento (texto y voz) | 3,1 s | |
| Memoria asignada tras la carga | 4.274 MiB |
Todas las mediciones (a través de la plataforma)
| Caso | RTX A5000 | RTX 2000 Ada 16 GB | Salida |
|---|---|---|---|
| Pregunta hablada (3,3 s) con respuesta intercalada de texto y voz | 10,48 s de voz en 7,418 s (1,41x), ida y vuelta 10,11 s; ejecución de prueba 9,76 s en 6,938 s, primer texto 0,047 s, primer fotograma de voz 0,275 s | 10,08 s en 6,563 s (1,54x), ida y vuelta 8,24 s; ejecución de prueba 10,08 s en 6,148 s (1,64x), primer fotograma 0,203 s | Kilimanjaro, 5.895 m bien; pies mal (19.004 / "19,34" / 19.031) |
| Imagen del cartel más pregunta hablada, texto | 0,836 s, 1.135 tokens de prompt | 0,931 s | bien |
| Lo mismo, voz intercalada | 7,12 s de voz en 5,41 s (1,32x), primer fotograma 0,35 s | 6,32 s en 4,26 s (1,48x) | mismos datos, hablados |
| ASR, LibriSpeech 1272-128104-0002 (12,5 s) | 1,16 s | 1,01 s | exacta salvo mayúsculas y puntuación |
| Vídeo de 9,7 s con banda sonora, pregunta escrita, prompt de sistema "Answer questions about the video using what you see and hear." | 2,63 s | 2,47 s | "The child is speaking, saying, 'I want to look at the book'" (cita sin verificar) |
| Mismo vídeo y pregunta, solo fotogramas, sin prompt de sistema | 5,38 s | 4,87 s | "there is no audible speech or music in the clip" (incorrecto) |
Petición hablada de herramienta con el esquema set_volume | 0,56 s | 0,45 s | set_volume({"volume": 30}) |
| TTS inglés voz femenina / español voz masculina | 4,64 s en 2,93 s (1,58x) / 3,68 s en 2,26 s (1,63x), primer fotograma unos 0,05 s | 4,8 s en 2,68 s (1,79x) / 4,16 s en 2,19 s (1,9x) | Whisper vuelve a leer las frases |
| Texto, párrafo de 146 tokens | 37,6 tok/s | 40,5 tok/s | bien |
| Vídeo de 60 s, 8.472 tokens de prompt | 5,9 a 6,4 s, proceso de 5.966 MiB | proceso de 5.824 MiB | escena y letreros bien, calle real llamada "a driving video game" |
Las dos ejecuciones de vídeo difieren en dos ajustes (use_audio_in_video y el prompt de sistema), así que sus tamaños de prompt y sus tiempos no son una comparación limpia solo del audio; no repetimos la ejecución de solo fotogramas con el mismo prompt de sistema. Los tiempos del primer fotograma de voz se miden dentro del backend desde el inicio de la generación. El backend devuelve la respuesta entera como un único WAV en base64, así que el cliente recibe el audio solo al final de la ida y vuelta.
Memoria de la GPU: pico de PyTorch de 4.285 a 4.434 MiB por petición, proceso de 4.772 a 4.832 MiB en nvidia-smi. La banda sonora tiene cuatro ráfagas por encima de -35 dB (silencedetect). Whisper large-v3 con idioma automático oyó "Ola, ola..."; forzado a inglés, "I don't want to put it in my bag."; el ASR solo de audio de LFM3, "I want, I want to put them in."
Escalera de VRAM
Los escalones emulados usan torch.cuda.set_per_process_memory_fraction en la A5000. Cinco casos: ASR, imagen más voz, TTS, voz a voz, vídeo de 10 s. El límite solo afecta a la memoria de PyTorch, no al proceso entero: la cifra del proceso en nvidia-smi suma unos 400 MiB de memoria ajena a PyTorch (proceso de 4.832 MiB frente a un pico de PyTorch de 4.434 MiB). En el texto principal, 4,45 GiB son 4,8 GB y 4,35 GiB son 4,7 GB; de 4.772 a 4.832 MiB son de 5,0 a 5,1 GB.
| GPU o límite | Configuración | Memoria pico (MiB, proceso en nvidia-smi salvo que se indique) | Tiempo por salida | ¿Salida correcta? | Real o emulada |
|---|---|---|---|---|---|
| RTX A5000 24 GB | BF16, backend propio de Transformers, a través de la plataforma | 4.832 (4.434 PyTorch) | 7,4 s (respuesta en voz) | sí | real |
| RTX 2000 Ada 16 GB | lo mismo, worker nuevo a través de la plataforma | pico de PyTorch 4.434; proceso de 5.824 para el vídeo de 60 s | 6,6 s | sí, mismas respuestas | real |
| Límite de 8 GiB | 5 casos | 4.832 | 6,9 s | sí | emulada |
| Límite de 6 GiB | 5 casos | 4.832 | 5,1 s | sí | emulada |
| Límite de 5 GiB | 5 casos | 4.832 | 6,8 s | sí | emulada |
| Límite de 4,6 GiB | 5 casos | 4.832 | 7,2 s | sí | emulada |
| Límite de 4,45 GiB | 5 casos | 4.772 | 6,8 s | sí | emulada |
| Límite de 4,35 GiB | 5 casos | 4.718 | no: vídeo de 10 s OutOfMemoryError ... Tried to allocate 20.00 MiB ... 4.35 GiB allowed | emulada | |
| Límite de 5,6 GiB, vídeo de 60 s | 8.472 tokens de prompt | 5.966 (5.242 PyTorch) | 5,9 s | sí | emulada |
| Límite de 5,2 GiB, vídeo de 60 s | 8.472 tokens de prompt | no: OutOfMemoryError ... Tried to allocate 142.00 MiB ... 5.20 GiB allowed (también OOM con 4,6) | emulada |
Las velocidades no cambiaron con los límites. Las respuestas de voz a voz no fueron idénticas entre límites: el Kilimanjaro salió como 5.895 m con 19.031, 19.341, "19,34", 19.285 y 19.000 pies, y una vez (límite de 6 GiB) como "five thousand seven hundred and three meters". Sin probar: tarjetas reales de 6, 8 o 12 GB (no había ninguna de menos de 16 GB disponible en nuestra nube para esta prueba), las versiones GGUF y el servidor en tiempo real de llama.cpp, pesos cuantizados, concurrencia, CPU.
SGLang
- Backend
sglangintegrado a través de la plataforma (sglang 0.5.23 de PyPI,sglang serve ... --mem-fraction-static 0.35): primero lo rechazó la comprobación previa de VRAM del worker, "GPU out of memory before sglang spawn: only 19328 MiB free" (quiere el 80 % de la tarjeta libre sin importar--mem-fraction-static). ConINFERENCEKEY_VRAM_MIN_FREE_MB=9000: "Lfm3OmniForConditionalGeneration has no SGLang implementation, falling back to Transformers implementation", y después "Exception: Capture cuda graph failed: The size of tensor a (48) must match the size of tensor b (16) at non-singleton dimension 2". No se sirvió. - PR #46858 compilada a mano en la A5000, fuera de la plataforma (
sglang 0.5.6.post3.dev14179+g47737555a,SGLANG_BUILD_RUST_EXTS=none,--mem-fraction-static 0.3): lista en 185 s en frío (CUDA graphs) / 47 s en caliente, proceso de 7.036 a 7.338 MiB. Texto a 157 a 159 tok/s en un párrafo de 137 tokens (4,2x Transformers). Imagen más pregunta hablada, de 0,41 a 0,43 s. Vídeo con banda sonora, 0,95 s en caliente, pero solo conuse_audio_in_video: trueen el nivel superior (mm_processor_kwargsse ignora y da la respuesta de solo fotogramas). Todas las respuestas greedy idénticas a las del backend de Transformers. Solo salida de texto.input_audioconformat: flacdevolvió 400. - El comando de la documentación de Liquid AI:
python -m sglang.launch_server --model-path LiquidAI/LFM3-Omni-2B(salida de texto). Necesita esa PR hasta que una versión publicada la incluya. El estado de la PR y la versión de PyPI se comprobaron el 2026-11-07 a las 06:40 UTC.
Problemas pendientes
- El soporte de SGLang sin publicar (arriba). Nuestro backend integrado instala sglang de PyPI, así que todavía no puede servir LFM3. Pendiente, en el proyecto original.
- La comprobación previa de VRAM del worker bloquea un segundo motor en una tarjeta donde ya corre el primero (regla del 80 % libre). Solución temporal:
INFERENCEKEY_VRAM_MIN_FREE_MB. Pendiente por nuestra parte. - Falso listo:
wait_until_readydel workload de sglang imprimió "ready [server_up]" a los 23 s mientras uv seguía instalando sglang; el que estaba levantado era otro workload del mismo worker. Pendiente por nuestra parte. - Nombre del modelo en el endpoint:
"model": "lfm3"devuelve 400model_not_available; envía"model": "default". Documentado en el ejemplo. - Sin streaming de voz al cliente en este backend: el cliente espera al WAV completo. Sin construir.
- La decodificación de texto con Transformers es lenta: de 38 a 40 tok/s, lo mismo en la tarjeta de 70 W que en la A5000. Transformers también avisa en el log de que
causal_conv1d_fnrecurre a su implementación de referencia en PyTorch porquecausal_conv1dno está instalado ("This is correct but much slower"); si eso explica la velocidad está sin verificar. - Fallos del modelo: el Kilimanjaro en diez ejecuciones con voz: los metros bien nueve veces (5.703 una vez), los pies bien una vez (19.341) y mal en las otras ocho que dieron pies; las respuestas intercaladas varían con el muestreo del audio; las palabras citadas de un audio poco claro, sin verificar; imágenes reales de una calle llamadas "a driving video game". Whisper leyó un WAV del Kilimanjaro como "19,034 feet" mientras el texto decía "19,34", así que el audio y el texto pueden diferir ligeramente en esa cifra.
- Dos máquinas de nuestra nube (una A5000 y una A4000) no abrieron SSH directo en 180 s y el manager las descartó antes de la prueba.
Vídeo de la demo
El explicador narrado de 172 segundos: los propios ejemplos de Liquid AI con su crédito, un inserto de la arquitectura y otro de los benchmarks de la ficha del modelo, después nuestro despliegue en la A5000, la respuesta hablada del propio modelo sobre el cartel reproducida sin narración, la llamada a herramienta hablada, la comparación clave y la escalera de memoria. Con subtítulos.
Más muestras
- Texto a voz, voz masculina en español, 3,7 s: "El museo abre a las 10 de la mañana y cierra a las 6 de la tarde."
- Respuesta hablada sobre el Kilimanjaro, intercalada, 9,8 s (metros bien, pies mal)
Fuentes
- LiquidAI/LFM3-Omni-2B (ficha del modelo, configuraciones, código del modelo).
- LFM Open License v1.0.
- LiquidAI/LFM3-Omni-2B-GGUF.
- Introducing LFM3: Every Modality for Specialized Intelligence (blog de Liquid AI, 27 de octubre de 2026).
- Documentación de Liquid AI, despliegue con SGLang.
- sgl-project/sglang#46858.
- Vídeo de noticias de AI Search, 2026-11-01 (donde lo vimos).
- Ejemplo del SDK, commit
ba49628ec5b24b68e8c404b1e54772df6b499f6b. - Pruebas anteriores de una sola etapa en esta web: Ming TTS, Nemotron Transcribe, Underdog Bark.