Ripple-65B: un modelo de programación denso de 65B a 15 tokens/s en una tarjeta de 48 GB, y a 2 bits en 24 GB
Un modelo denso de 65B en una tarjeta de 48 GB: 15 tokens/s, un prompt de 237K tokens bien resuelto y una RTX 3090 real de 24 GB a 2 bits con un test erróneo.
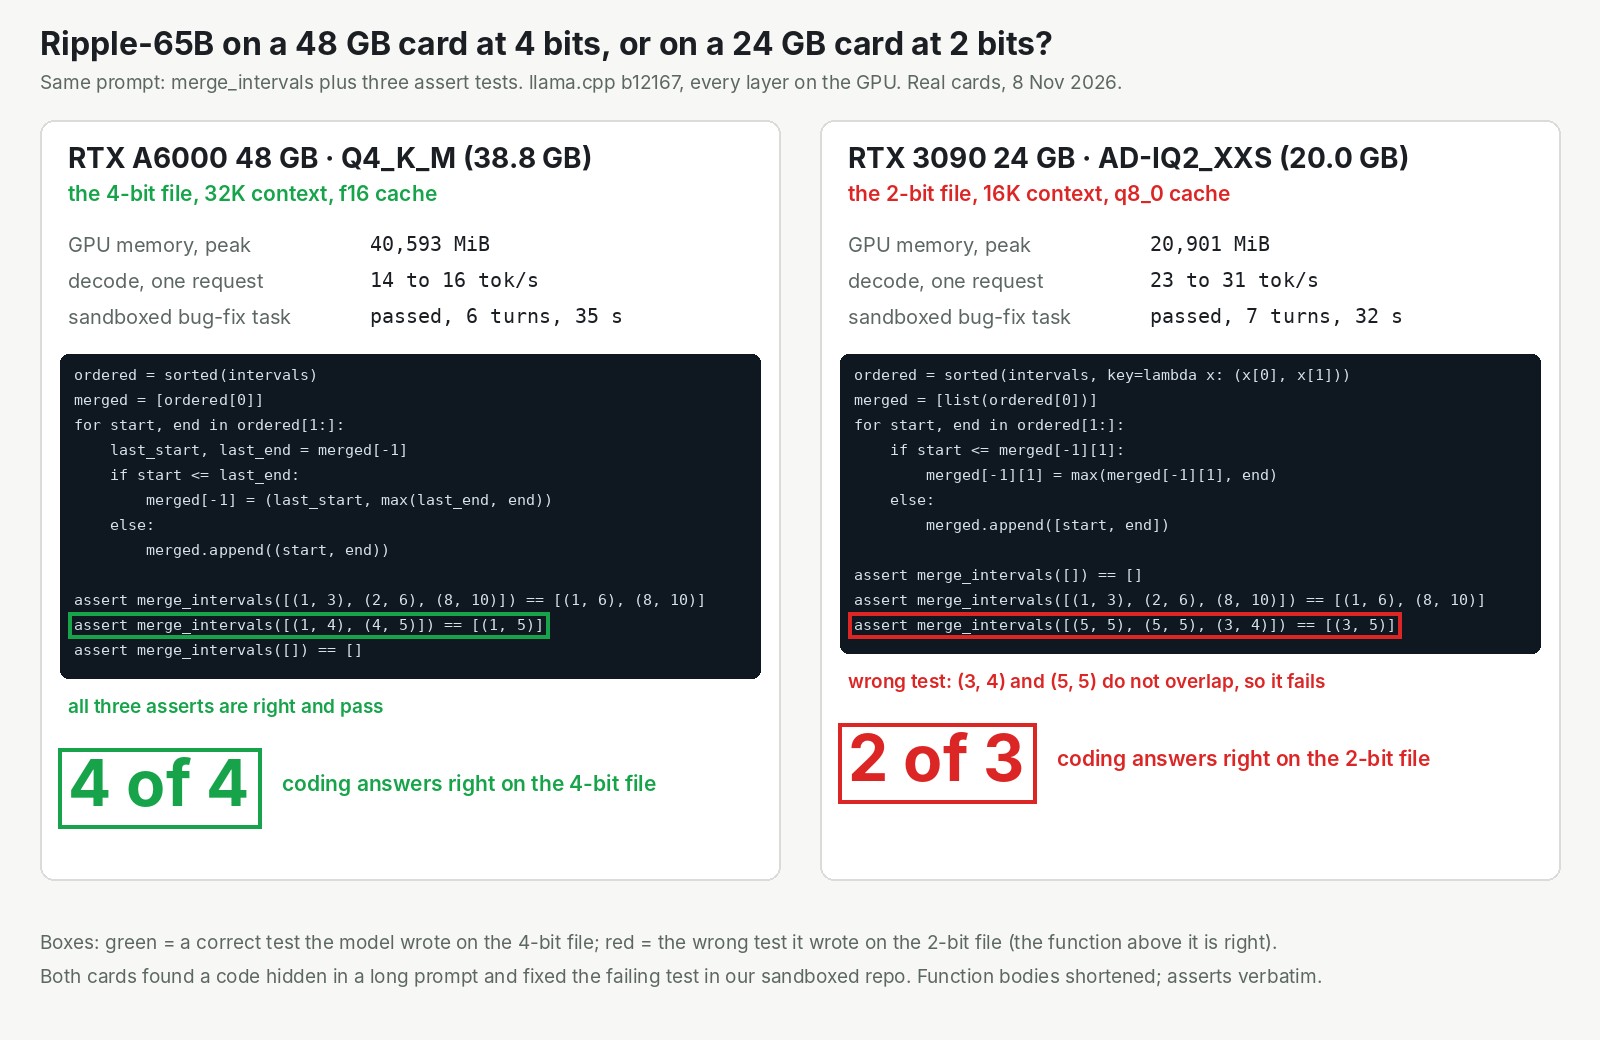
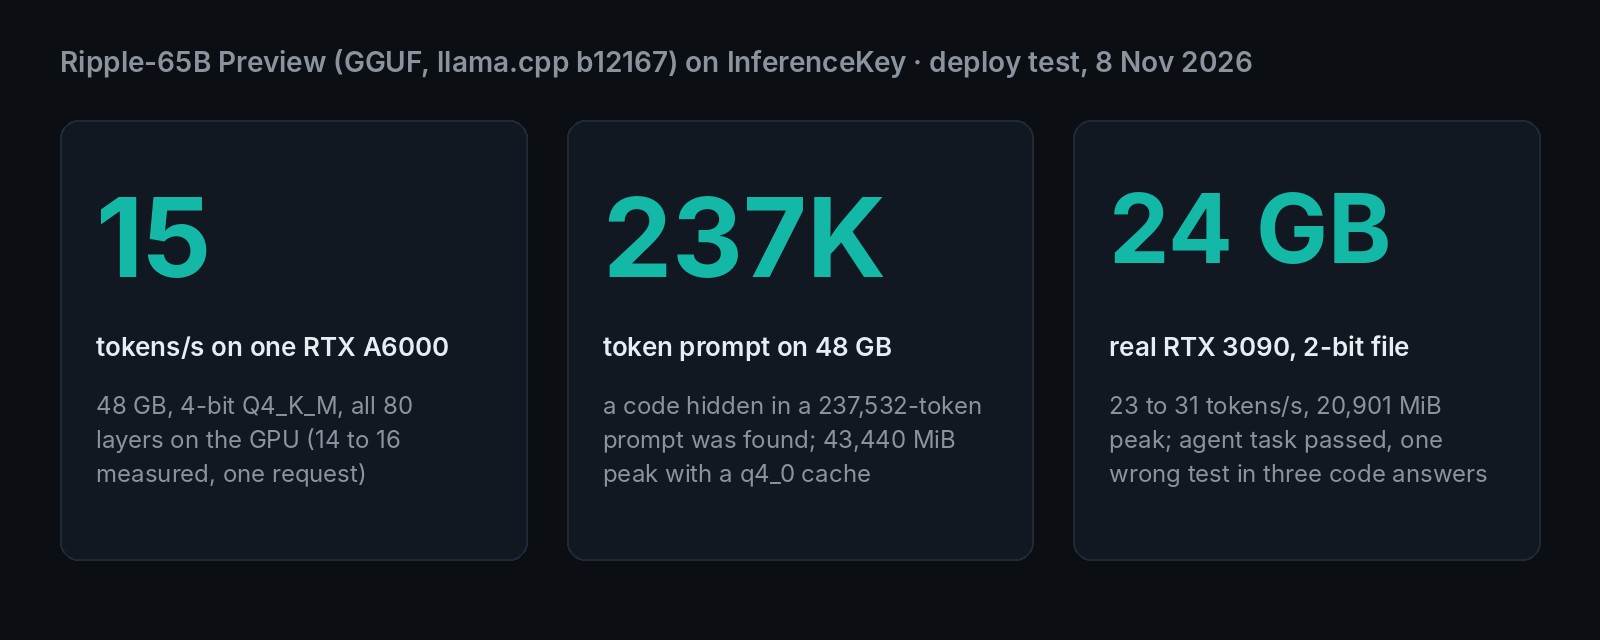
Ripple-65B est livré avec environ 130 GB de poids. La carte sur laquelle nous l'avons fait tourner a 48 GB. En 4 bits par nombre, soit un fichier de 38,8 GB, il a tenu sur une seule RTX A6000 et écrit environ 15 tokens (à peu près des mots) par seconde, parce que chaque mot traverse le modèle entier. En 2 bits, il a aussi tourné sur une vraie RTX 3090 de 24 GB, et plus vite, mais dans une de ses trois réponses de code, le modèle a écrit un test avec un résultat attendu faux.
Sur un benchmark d'agents, ses auteurs le placent au niveau de modèles ouverts de 501B à 975B
Sur Terminal-Bench 2.1, un test d'agents qui travaillent en ligne de commande, Ricursive donne à Ripple 80,5. Dans leur propre tableau, c'est 0,4 point d'avance sur Reflection Beam, autrement dit une égalité, et devant trois modèles ouverts plus grands. Terminal-Bench est sa principale avance. Sur la plupart des autres lignes du même tableau, un concurrent est devant.
| Terminal-Bench 2.1 (chiffres des auteurs) | Taille totale | Score |
|---|---|---|
| Ripple-65B Preview | 65B | 80,5 |
| Reflection Beam | 501B | 80,1 |
| Meta Muse Spark Open | 816B | 76,4 |
| Thinking Machines Inkling | 975B | 63,8 |
| NVIDIA Nemotron 3 Ultra | 550B | 56,4 |
La colonne de taille flatte Ripple : les concurrents sont plus gros, mais chaque mot qu'ils écrivent n'utilise que 23B à 55B paramètres. Ripple les utilise tous les 65B.
Cette ligne est autodéclarée. Les auteurs reconnaissent que "replicating benchmark scores has been challenging" et parlent d'une "best-effort attempt". Quand ils ont refait tourner les concurrents avec la configuration officielle du benchmark, trois sur quatre ont obtenu moins que dans ce tableau. Notre propre lecture de leur tableau : sur SWE-bench Verified, construit à partir de vrais tickets GitHub, Ripple obtient 76,5 contre 81,6 pour Reflection Beam.
Sur le miroir BenchLM du classement public Terminal-Bench 2.1 de Vals, les cinq premières entrées vont de 92,8 (SWE-2 de Cognition) à 80,4 (Claude Sonnet 5). Ce classement utilise une autre configuration de test, donc ses chiffres ne se comparent pas à ceux des auteurs. Ripple est un bon résultat ouvert, pas une prétention à battre les meilleurs modèles de code fermés.
Pourquoi c'est important maintenant : un laboratoire américain a entraîné un modèle de code ouvert à partir de zéro et l'a donné sous Apache 2.0, sans formulaire à remplir. Ricursive chiffre l'ensemble de la recherche à 32 millions de dollars, selon sa propre estimation. Les poids sont arrivés sur Hugging Face le 4 novembre. Les auteurs disent qu'il a été entraîné sur 12 000 milliards de tokens et qu'il lit des prompts jusqu'à environ un million.
Les builds de Ricursive visent du matériel de data center que la plupart des équipes ne possèdent pas. La voie que nous avons prise est celle que la communauté a ouverte en deux jours. Un portage de Ripple dans llama.cpp, un programme gratuit pour faire tourner des modèles sur sa propre carte, a été fusionné le 5 novembre. Nik Bogatyrev a soumis le portage, que la page d'AtomicChat dit avoir écrit. AtomicChat a publié des fichiers llama.cpp la même semaine, de 129,6 GB (pleine précision) jusqu'à 18,5 GB. Une mise à jour de llama.cpp du 6 novembre savait les lire.
Dense veut dire 15 tokens par seconde : chaque mot lit les 65 milliards de paramètres
Ripple a écrit 14,3 à 16,3 tokens par seconde sur l'A6000. C'est le prix de sa conception.
Chaque concurrent du tableau de Ricursive est un mélange d'experts : chaque mot n'utilise qu'une partie du modèle. Ripple est dense : chaque mot passe par les 65 milliards de paramètres. En 4 bits, cela veut dire relire presque tout le fichier de 38,8 GB en mémoire pour chaque mot, et l'A6000 peut le faire environ 15 fois par seconde. C'est cette vitesse de lecture, pas la puissance de calcul de la puce, qui fixe le plafond.
La référence la plus proche est Nanbeige4.3-33B, un modèle de code dense que nous avons testé il y a deux jours. Il a moitié moins de paramètres, donc environ moitié moins d'octets à lire par mot. Il écrivait environ 42 tokens par seconde sur une RTX 4090 de 24 GB, une autre carte. Clover-35B-A3B, qui utilise environ 3 milliards de paramètres par mot, en écrivait 208 sur cette même RTX 4090.
En pratique, 15 tokens par seconde, c'est une réponse de 400 tokens en environ 27 secondes. Les questions courtes commencent à recevoir leur réponse en moins d'une seconde. Pour un développeur qui pilote un agent, c'est utilisable, pas vif.
Notre test : un fichier en 4 bits sur une carte de 48 GB, nos propres prompts
Nous avons utilisé le fichier en 4 bits standard d'AtomicChat, 38,8 GB, entièrement sur une RTX A6000. Il a tourné avec notre configuration llama.cpp standard. La plupart des appels sont passés par le même type d'API qu'appellerait votre produit.
Nos tests étaient modestes : une réponse en un mot, une tâche de code avec ses propres tests, deux types d'appel d'outil, un fait caché loin dans un long prompt, et une tâche d'agent. Un appel d'outil, c'est le modèle qui demande à votre programme d'exécuter quelque chose, ici une commande shell ou une recherche météo.
La tâche d'agent était un petit dépôt jouet dans lequel nous avions planté un bug de décalage d'un (off-by-one) qui faisait échouer un test. Le modèle avait un seul outil, un shell, et chaque commande qu'il envoyait s'exécutait dans un bac à sable sans réseau.
Voici nos limites. Nous avons envoyé une requête à la fois, et chaque test a tourné une fois ou quelques fois : 4 réponses de code avec le fichier en 4 bits, 3 sur la 3090. Les prompts étaient les nôtres, pas les benchmarks des auteurs, que nous n'avons pas reproduits. Nous n'avons essayé ni la configuration de service des auteurs ni leur modèle auxiliaire d'accélération.
Il a corrigé un bug planté dans un dépôt jouet, et chaque appel d'outil était valide
Chaque appel d'outil est revenu valide, seul ou au sein des exécutions de l'agent, dans le format standard que lit le code d'agent existant. Avant chacun, Ripple réfléchit une phrase ou deux. Les questions simples reçoivent une réponse directe.
Sur l'A6000, Ripple a lu le code, lancé les tests, constaté l'échec et remplacé un <= par un <. Il a relancé les tests, constaté qu'ils passaient et rendu compte, 6 tours en tout. Il n'a jamais touché aux tests eux-mêmes.
| Ce que nous avons demandé | Ce qui est revenu | Temps |
|---|---|---|
| "Capital of Australia, one word" | Canberra, sans réflexion | environ 0,5 s |
| Une fonction qui fusionne des intervalles de nombres, avec ses propres tests | Code juste, les tests passent | 12,4 s |
| "Which directory am I in?" avec un outil shell | Une commande pwd valide | 4,8 s |
| "Is it warmer in Lisbon or in Oslo?" | Deux appels météo simultanés, tous deux valides | 7,1 s |
| Corriger le test qui échoue dans un dépôt en bac à sable | Bug corrigé, tests intacts | 35 s |
Les longs prompts coûtent peu en mémoire : 237 532 tokens tiennent dans 48 GB, avec 13 minutes de lecture
La même carte de 48 GB a accepté des prompts jusqu'à 256K tokens et trouvé une phrase secrète cachée au token 237 532, avec environ 46 GB utilisés. C'était un seul test de phrase secrète par longueur : il montre que le modèle sait retrouver un fait, pas qu'il sait raisonner sur toute une base de code.
La raison tient à la façon dont Ripple se souvient de ce qu'il a lu. En lisant, un modèle prend des notes sur chaque token, et ces notes grossissent en général vite avec le prompt. Ripple a 80 couches, comme 80 personnes dans une réunion, et seules 16 prennent des notes sur tout le prompt. Les 64 autres ne gardent que les 1 024 derniers tokens. Le carnet reste petit, et pour les prompts plus longs nous l'avons aussi compressé.
| Prompt le plus long autorisé | Notes compressées en | Mémoire de pic | Phrase secrète à | Réponse en |
|---|---|---|---|---|
| 32K tokens | non (16 bits) | 42,6 GB | 25 930 tokens | 48 s |
| 128K tokens | 8 bits | 44,4 GB | 118 836 tokens | 292 s |
| 256K tokens | 4 bits | 45,6 GB | 237 532 tokens | 760 s |
Les trois l'ont trouvée. Le hic, c'est le temps. Lire 237 532 tokens a pris environ 13 minutes, et une réponse de 400 tokens a ensuite pris environ une minute. Le million complet est hors de portée sur une seule carte de 48 GB : 256K avec des notes compressées, c'est à peu près sa limite.
Quel GPU : une vraie RTX 3090 de 24 GB fonctionne avec le fichier en 2 bits, avec un test faux sur trois
La plus petite carte qui a réussi est une vraie RTX 3090, une carte de jeu de 24 GB, avec le fichier en 2 bits d'AtomicChat de 20,0 GB et des prompts jusqu'à 16K tokens. Moins de bits par nombre, c'est un fichier plus petit et moins à lire par mot, mais des nombres plus grossiers et plus d'erreurs.
Deux lignes ci-dessous sont des budgets : nous les avons fait tourner sur l'A6000 de 48 GB pour voir si le fichier tient dans 32 ou 24 GB. Leurs vitesses sont celles de l'A6000.
| Carte ou budget mémoire | Fichier et prompt le plus long | Mémoire de pic | Vitesse (tokens/s) | Tests | Vraie carte ? |
|---|---|---|---|---|---|
| RTX A6000 48 GB | 4 bits, 32K à 256K | 42,6 à 45,6 GB | 14 à 16 | tout juste, 4 réponses de code justes sur 4 sur les exécutions 32K, 128K et 256K | oui |
| Budget de 32 GB | 3 bits, 32K | 29,8 GB | 16 à 18 | agent réussi, 1 réponse de code sur 2 avec un test faux | non, exécuté sur l'A6000 |
| Budget de 24 GB | 2 bits, 16K | 21,2 GB | 21 à 22 | agent réussi, 2 tests sur 2 passent mais une fonction ne trie jamais son entrée | non, exécuté sur l'A6000 |
| RTX 3090 24 GB | 2 bits, 16K | 21,9 GB | 23 à 31 | agent réussi, 1 réponse de code sur 3 avec un test faux | oui |
| RTX 5090 32 GB | 3 bits | aucune | aucune | pas de résultat : l'hôte téléchargeait trop lentement | oui, pas de résultat |
| 16 GB | aucun | pas essayé : le plus petit fichier fait 18,5 GB |
Les erreurs vont dans le même sens que ce qu'a mesuré AtomicChat. Leur page indique que le modèle complet et le fichier en 4 bits divergent sur le mot suivant environ 7 fois sur 100, le fichier en 3 bits environ 9, le fichier en 2 bits presque 20. La tâche de correction de bug n'a rien relevé de tout cela, parce qu'elle n'a jamais demandé au modèle d'écrire de nouveaux tests. C'est en écrivant du code neuf que les petits fichiers se trahissent.
La carte de 48 GB donne donc le résultat propre, ce n'est pas une obligation. Une carte de 24 GB fait tourner le modèle, et il faut relire ce qu'il écrit.
Sur InferenceKey : prêt en 19 secondes, parce que rien n'a dû être compilé
Une fois le fichier sur la machine, notre configuration llama.cpp standard avait Ripple en train de répondre 19,0 secondes après la demande. La 3090 a mis 19,3 secondes.
Sur InferenceKey, un worker est le petit programme sur votre machine GPU qui reçoit les ordres de la plateforme. Nous avons dit au worker de télécharger un llama.cpp prêt à l'emploi pour NVIDIA au lieu de le compiler.
Le problème que vous pouvez rencontrer : sans ce réglage, notre worker compile llama.cpp lui-même sur les machines NVIDIA, 5 à 20 minutes lors de tests précédents. État : ouvert de notre côté. L'exemple du SDK le règle par défaut, il n'est donc pas concerné.
Cette exécution a utilisé une copie locale de la plateforme, pas le service hébergé. L'exemple du SDK fait tourner le modèle sur une machine que vous désignez. Les requêtes passent par l'endpoint InferenceKey pour l'atteindre.
Faut-il l'utiliser ? Oui sur 48 GB, si vous pouvez vivre avec 15 tokens par seconde
- Vous avez une carte de 48 GB et voulez un agent de code ouvert que vous contrôlez : à essayer. Le fichier en 4 bits a donné nos résultats les plus propres.
- Vous avez besoin de longs prompts : un prompt de 237K tokens a tenu dans 48 GB. Comptez des minutes par question, pas des secondes.
- Vous avez une carte de 24 GB : le fichier en 2 bits tourne, et plus vite, mais relisez ses tests.
- Vous voulez avant tout de la vitesse : cherchez ailleurs. Comme il est dense, Ripple lit le modèle entier pour chaque mot.
Nous avons envoyé une requête à la fois, donc une carte partagée par plusieurs agents sera plus lente que cela, dans une mesure que nous n'avons pas mesurée, et il s'agit d'une Preview avec ce que Ricursive appelle une "relatively light posttraining".
Pour lancer la même tâche de code et le même appel d'outil sur votre propre worker NVIDIA de 48 GB, exécutez python main.py depuis l'exemple du SDK Ripple-65B. Il lui faut un projet, un token SDK et une clé d'API, et il supprime le déploiement à la fin.
Pour les ingénieurs
Crédits
- Ricursive Intelligence : le modèle, entraîné à partir de zéro ; les dépôts BF16, NVFP4 et du drafter DFlash2, tous sous Apache-2.0 (le dépôt Base est lié depuis la page du modèle ; sa licence n'a pas été vérifiée) ; la page du modèle, le tableau de benchmarks, le chat template et la recette serveur ; l'article de lancement.
- Nik Bogatyrev (notforu777) : la PR llama.cpp #31692, "model : add Ripple (ricursiveai)", fusionnée le 2026-11-05 (commit de merge
fecdc81e, +406/-3, aucune nouvelle op ggml ; KLD 0 et top-1 100 % face au code de l'éditeur sur un petit modèle aléatoire et les 10 premières vraies couches ; PPL BF16 3,01 ; usage d'IA déclaré). La page GGUF d'AtomicChat dit qu'AtomicChat a écrit le portage. - AtomicChat : les quantifications GGUF que nous avons utilisées (Q4_K_M standard, AD-IQ3_XXS, AD-IQ2_XXS) et leur tableau de KLD et de top-token.
- Les mainteneurs de llama.cpp : la release b12167 (2026-11-06), avec les tarballs précompilés
ubuntu-cuda-12.8-x64etubuntu-cuda-13.4-x64, plus l'analyse des appels d'outils de--jinja. - AI Search : là où nous l'avons repéré (vidéo d'actualité du 2026-11-08, chapitre à 41:26).
- Notre part : le déploiement via la plateforme, les prompts et la tâche d'agent en bac à sable, les exécutions en contexte long, l'échelle de mémoire sur deux vraies cartes plus deux exécutions sur l'A6000 dimensionnées pour des budgets de 32 et 24 GB, l'exemple du SDK et la vidéo de démo.
Modèle et fichiers
ricursiveAI/Ripple-65B-Preview: shada94cc01, créé le 2026-11-04T02:41Z, dernière modification le 2026-11-06, environ 129,6 GB en BF16 en 16 shards, sans accès restreint. Dépôt NVFP499eea447(6 shards, environ 57,2 GB ; "experimental", MLP en NVFP4 et attention en BF16 ; fournitspark.pyet un notebook). Drafter DFlash235609b3b(4,04B paramètres, environ 8,08 GB en BF16). GGUF d'AtomicChatdf550a71.- Architecture :
RicursiveForCausalLM(code personnalisé,model_typericursive), 80 couches selon un motif 4:1 (64 couches à fenêtre glissante, fenêtre de 1 024, RoPE ; 16 couches globales à attention complète avec NoPE), hidden 5120, FFN 40960, 80 têtes de requête / 8 têtes KV, head_dim 128, vocabulaire de 100 352,max_position_embeddings2 097 152, attention à porte, résidus de valeurs, clamp FFN 20, échelle d'embedding sqrt(5120). La page le qualifie de "Gemma 3N-like" et de "thin-and-deep", parti d'une base Olmo 3. - Étapes d'entraînement (page du modèle) : pré-entraînement sur 12T tokens à 8K ; midtrain 200B à 64K ; contexte long 6,5B à 2M ; SFT 183B à 128K ; SFT contexte long 13,5B à 2M ; RL 700 étapes à 128K. "Relatively light posttraining, with a focus on agentic coding."
- Cache KV en f16 : 16 couches globales x 8 x 128 x 2 x 2 B = 64 KiB par token, plus l'anneau de la fenêtre glissante. Selon ce calcul, 1M en f16 représente environ 64 GiB de cache à lui seul.
- Tailles AtomicChat et taux de même top-token face au BF16 : Q4_K_M 38,8 GB 93,0 % (KLD moyen 0,0380) ; AD-IQ4_XS 38,7 GB 95,6 % ; AD-Q4_K_M 40,4 GB 95,9 % ; AD-IQ3_XXS 28,0 GB 91,2 % ("32 GB (RTX 5090)") ; AD-IQ2_XXS 20,0 GB 80,8 % ("24 GB (RTX 3090 / 4090)") ; AD-IQ1_M 18,5 GB 76,8 % ("research") ; Q8_0 68,8 GB ; BF16 129,6 GB. Leur propre vitesse : Q4_K_M standard sur un GH200 96 GB, prefill 309 tokens/s, décodage 40,6 tokens/s. Ricursive ne publie aucun échantillonnage par défaut.
- Affirmations de l'éditeur que nous n'avons pas vérifiées : équipe "scaled from 1 to 5 people", 40 % de MFU avec un sharding simple et sans kernels personnalisés, "can fit on consumer hardware such as the NVIDIA DGX Spark", "250 tok/s on 2xB200 batch=8 prior to quantization or custom kernels", 32 millions de dollars de R&D au total (leur estimation), RL jusqu'à 80,5 avec 1,4M rollouts, qualité à 1M de contexte.
Benchmarks des auteurs (non reproduits)
D'après la page du modèle ; tous les modèles en BF16 complet, effort maximal ; les cellules en italique de leur tableau sont les exécutions des concurrents faites par Ricursive.
| Benchmark | Ripple-65B | Meilleur autre de leur tableau |
|---|---|---|
| Terminal-Bench 2.1 | 80,5 | Reflection Beam 80,1 |
| Terminal-Bench 2.1, harnais Terminus 2 | 80,5 | Muse Spark Open 78,7 (Beam 70,8, Inkling 56,2, Nemotron 55,1) |
| SWE-bench Verified | 76,5 | Reflection Beam 81,6 |
| SWE-bench Pro v1.0 | 61,42 | Reflection Beam 66,1 |
| SWE-bench Pro v2.0 Hard | 79,1 | meilleur du tableau |
| DeepSWE 1.1 | 44,3 | Muse Spark Open 60,0 |
| MCP Atlas | 71,67 | Muse Spark Open 89,2 |
| SciCode | 39,4 | Muse Spark Open 58,5 |
| GPQA Diamond | 85,2 | Reflection Beam 90,6 |
| AIME 2026 | 95,0 | |
| AA-LCR | 75,0 | Muse Spark Open 80,7 |
| IFBench | 79,2 |
Les concurrents sont tous des modèles à mélange d'experts avec 23B à 55B paramètres actifs ; le nombre de paramètres actifs de Ripple est la totalité de ses 65B. Contexte public : cinq premières entrées du miroir BenchLM de Vals Terminal-Bench 2.1 (mis à jour le 2026-11-07) : SWE-2 92,8, GPT-5.6 Sol 91,9, Claude Mythos 5 88,0, Claude Fable 5 84,3, Claude Sonnet 5 80,4. Les harnais diffèrent de ceux des auteurs, donc les lignes ne sont pas directement comparables.
Installation
- GPU sur InferenceKey Cloud : RTX A6000 48 GB (46 068 MiB, 300 W, compute capability 8.6) pour l'exécution principale ; RTX 3090 24 GB (compute capability 8.6) pour le vrai échelon de 24 GB.
- Backend : le backend
llamacppintégré,INFERENCEKEY_LLAMACPP_TAG=b12167(le tag par défaut du worker est plus ancien et ne sait pas lire l'architecturericursive) etINFERENCEKEY_LLAMACPP_ASSET=ubuntu-cuda-13.4-x64. Les bibliothèques du tarball se sont résolues sur leslibcublas.so.13/libcudart.so.13CUDA 13 de l'image ; le tarball séparécudart-llama-*n'est pas téléchargé. - Pourquoi llama.cpp et pas vLLM ou SGLang : l'architecture est personnalisée. La recette serveur de l'éditeur (
inference/serverdans le dépôt BF16) fait tourner SGLang 0.5.19 avec le code de modèle propre à Ricursive : cible BF16 non quantifiée plus DFlash2 natif, TP=2 sur deux B200, contexte de 1Mi par défaut, parsers de raisonnement et d'appels d'outils de Ripple. Ricursive dit aussi que la build NVFP4 expérimentale tient sur un DGX Spark (non testé par nous). Par ailleurs, la page de DFlash2 nomme un runtimeripple-sglang, utilisé pour une validation d'export sur 8x H100 avec la cible RL-step-500. Nous n'avons pas vérifié si vLLM ou SGLang standard chargent le modèle sans le code supplémentaire de Ricursive. Le support de llama.cpp est en amont depuis b12167, et le GGUF est ce qui tient sur une seule carte. --jinja --reasoning-format deepseek: le<tool_call>{json}</tool_call>du template est revenu sous forme detool_callsOpenAI ; le raisonnement avant les appels d'outils (61 à 213 caractères) a atterri dansreasoning_content, contenu jamais vide.- Un manager InferenceKey local, compilé depuis notre branche main (
435050e1), joint par les workers à travers des tunnels. La production n'a jamais été touchée. Température d'échantillonnage 0,6, top_p 0,95 ; échelons de l'échelle avec seed 42.
Pas à pas avec l'exemple du SDK
- Clonez inferencekey-sdk et ouvrez
examples/ripple-65b-agent-llamacpp-private-nvidia(commitea32931f8486a5ff164c57a7a6c3abaea64cfc90). cp .env.example .envet remplissezINFERENCEKEY_SDK_TOKEN,INFERENCEKEY_API_KEY,INFERENCEKEY_PROJECTetIK_WORKER_ID(un worker NVIDIA privé avec 48 GB). Optionnel :RIPPLE_GGUF_FILE(Q4_K_M par défaut),RIPPLE_CONTEXT(32768),RIPPLE_KV_TYPE(f16),RIPPLE_LLAMACPP_TAG(b12167),RIPPLE_LLAMACPP_ASSET(ubuntu-cuda-13.4-x64; vide, il compile depuis les sources),IK_KEEP_ALIVE=1.pip install -r requirements.txt(requests>=2.31) plus la build locale du SDK avec maturin (le SDK n'est pas sur PyPI).- L'asset précompilé demande un pilote CUDA 13 et
libcudart.so.13/libcublas.so.13sur le worker. Il n'a pas été essayé sur des cartes Blackwell (sm_120). python main.py. Il fait unensure()d'un workloadllamacppfixe épinglé à votre worker, attend jusqu'à 3 600 s, envoie une tâche de code avecgenerate_text(), fait un appel d'outilexecute_bashet renvoie un résultat préparé, écritoutputs/answers.jsonet appelledelete()sauf siIK_KEEP_ALIVE=1.
La commande de lancement qu'exécute le backend :
INFERENCEKEY_LLAMACPP_TAG=b12167 \
INFERENCEKEY_LLAMACPP_ASSET=ubuntu-cuda-13.4-x64 \
llama-server \
  -hf AtomicChat/Ripple-65B-Preview-GGUF \
  --hf-file Ripple-65B-Preview-Q4_K_M.gguf \
  --alias ripple-65b-preview -ngl 99 -fa on \
  -c 32768 -ctk f16 -ctv f16 \
  --jinja --reasoning-format deepseek
Pour 128K, utilisez -c 131072 -ctk q8_0 -ctv q8_0 ; pour 256K, -c 262144 -ctk q4_0 -ctv q4_0. Pour une carte de 24 GB, réglez RIPPLE_GGUF_FILE=Ripple-65B-Preview-AD-IQ2_XXS.gguf, RIPPLE_CONTEXT=16384 et RIPPLE_KV_TYPE=q8_0.
Délais
| Étape | RTX A6000 | RTX 3090 |
|---|---|---|
ensure() jusqu'à prêt | 19,0 s | 19,3 s |
| Téléchargement et installation du tarball llama.cpp (169 MB) | environ 1 s | |
| Chargement du modèle | environ 8 s | |
| Pré-téléchargement du GGUF (hors du chemin jusqu'à prêt) | 32 s (Q4_K_M) | 41 s (AD-IQ2_XXS) |
| Redémarrage direct de llama-server, à chaud | 7,0 à 13,4 s jusqu'à /health |
Log du worker sur l'A6000 : install_llamacpp ok à 06:52:07, llama-server lancé à 06:52:15, modèle prêt à 06:52:23 (UTC).
Vitesse et sorties (RTX A6000, Q4_K_M, 32K, cache f16, streaming à travers l'endpoint)
| Test | Tokens générés | Secondes | Premier token s | Décodage tokens/s | Résultat |
|---|---|---|---|---|---|
| Capitale de l'Australie x2 | 3 / 4 | 0,46 / 0,57 | 0,31 / 0,35 | 20,6 / 18,0 | Canberra, sans réflexion |
merge_intervals + 3 asserts | 174 | 12,37 | 0,33 | 14,4 | les asserts passent dans le bac à sable |
execute_bash "Which directory am I in?" | 65 | 4,82 | 0,56 | 15,3 | {"command": "pwd"}, 154 caractères de raisonnement |
Lisbonne ou Oslo, get_weather | 93 | 7,1 | 0,88 | 14,9 | deux appels parallèles |
| Agent : corriger le test qui échoue | 410 en 6 tours | 35,2 | 14,5 à 15,5 par tour | <= en <, pytest 2 passed, tests intacts | |
| Aiguille, prompt de 25 930 tokens | 6 | 48,53 | 48,16 (environ 540 tokens/s de prefill) | 16,3 | trouvée |
Exécutions de l'exemple du SDK : A6000 Q4_K_M prêt en 19,0 s, code 12,9 s (les asserts passent), appel pwd 4,47 s, réponse finale 1,22 s à 15,7 tokens/s. RTX 3090 AD-IQ2_XXS prêt en 19,3 s, code 9,0 s avec un troisième assert faux, appel d'outil 3,02 s, réponse 2,26 s à 25,9 tokens/s.
Échelle de VRAM
VRAM de pic d'après nvidia-smi échantillonné toutes les 0,5 s. Les échelons de budget ont tourné sur l'A6000 et leur pic est resté sous le budget ; leurs vitesses sont celles de l'A6000.
| GPU ou budget | Config | VRAM de pic | Vitesse | Sortie OK | Réel ou émulé |
|---|---|---|---|---|---|
| RTX A6000 48 GB | Q4_K_M, 32K, f16 (l'exemple, à travers l'endpoint) | 40 593 MiB | 14,3 à 16,3 tokens/s ; agent 6 tours 35,2 s (prise enregistrée 5 tours, 439 tokens, 36,3 s) | oui ; code 2 sur 2 | réel |
| RTX A6000 48 GB | Q4_K_M, 128K, q8_0 | 42 373 MiB | 13,5 à 14,3 ; aiguille à 118 836 tokens en 292,3 s, 9,1 en profondeur | oui | réel |
| RTX A6000 48 GB | Q4_K_M, 256K, q4_0 | 43 440 MiB | 13,5 à 14,3 ; aiguille à 237 532 tokens en 760,4 s, prefill 312,9 en moyenne, 6,8 en profondeur | oui | réel |
| Budget de 32 GB | AD-IQ3_XXS (28,0 GB), 32K, q8_0 | 28 395 MiB | 16,4 à 17,8 ; agent 5 tours 29,6 s ; aiguille à 25 930 tokens trouvée | agent oui ; code 1 sur 2, test faux [(5,7),(1,2),(3,4)] == [(1,2),(3,7)] | émulé sur l'A6000 |
| Budget de 24 GB | AD-IQ2_XXS (20,0 GB), 16K, q8_0 | 20 249 MiB | 20,6 à 21,9 ; agent 6 tours 36,7 s ; aiguille à 12 562 tokens trouvée | agent oui ; code 2 asserts sur 2 passent, mais une fonction ne trie jamais son entrée | émulé sur l'A6000 |
| RTX 3090 24 GB | AD-IQ2_XXS, 16K, q8_0, à travers l'endpoint | 20 901 MiB (environ 130 W) | 23,6 à 30,9 ; agent 7 tours 32,0 s (prise enregistrée 5 tours 28,7 s) ; aiguille à 12 562 tokens à 22,5 ; deux appels météo 4,38 s | agent oui ; code 2 sur 3, test faux [(5,5),(5,5),(3,4)] == [(3,5)] (fonction juste) | réel |
| RTX 5090 32 GB | AD-IQ3_XXS (32K, q8_0 prévus, jamais lancé) | aucune | aucune | pas de résultat : téléchargement bloqué à 14,49 GB (environ 12 MB/s) | vraie carte, pas de résultat |
| 16 GB | aucune | pas essayé : le plus petit fichier, AD-IQ1_M, fait 18,5 GB |
Totaux de code sur l'ensemble des lignes : Q4_K_M 4 sur 4 (les exécutions 32K, 128K et 256K) ; AD-IQ2_XXS 4 sur 5 avec les asserts qui passent sur le budget de 24 GB et la vraie 3090, dont un avec le bug de tri ; AD-IQ3_XXS 1 sur 2.
Pas essayé : le checkpoint NVFP4 expérimental (57,2 GB ; notre estimation est une carte Blackwell de 96 GB comme la RTX PRO 6000, alors que la page de Ricursive nomme le DGX Spark et que le dépôt NVFP4 fournit un spark.py) ; la recette BF16 + DFlash2 des auteurs sur 2x B200 (le drafter DFlash2 est un modèle de 4,04B qui propose des blocs de 16 tokens pour accélérer l'écriture) ; les benchmarks des auteurs ; un contexte de 512K ou 1M ; AD-Q4_K_M et AD-IQ4_XS (meilleurs taux de top-token pour une taille similaire) ; une L40S ; le débit multi-requêtes ; une vraie RTX 5090 ; le tarball CUDA 13.4 sur Blackwell (sm_120).
Problèmes restants
- Le worker compile llama.cpp depuis les sources sur NVIDIA par défaut.
asset.rsdit que la release ne publie aucun tarball CUDA pour Linux, ce qui n'est plus vrai depuis que b12167 en fournit deux. FixerINFERENCEKEY_LLAMACPP_ASSETa fonctionné sur les deux cartes. Ouvert : préférer le tarball CUDA quand le pilote et les bibliothèques le permettent. - La variable d'environnement du disque du conteneur n'est plus lue par le manager ; la taille du disque est venue du
min_disk_gb=100de la requête (87 GB de GGUF, 82 % utilisés). Ouvert, documentation à mettre à jour. - Deux hôtes inutilisables : un hôte RTX 3090 n'exposait pas de SSH TCP direct et le manager l'a arrêté au bout de 180 s ; un hôte RTX 5090 téléchargeait à environ 12 MB/s et a été supprimé au bout d'environ 16 minutes sans résultat. Les hôtes des exécutions qui ont fonctionné téléchargeaient à 1,0 à 1,2 GB/s.
- Qualité des fichiers en 3 et 2 bits : un test faux chacun, et une réponse en 2 bits qui ne trie jamais son entrée. La tâche d'agent de correction de bug ne met pas cela à l'épreuve.
- Nom d'affichage du workload codé en dur à "Q4_K_M" dans
main.pyalors que la 3090 servait le fichier en 2 bits. Corrigé dans l'exemple avant le commit ; masqué dans la vidéo.
Vidéo de démo
La démo commentée de 165 secondes : d'abord le matériel des auteurs (page du modèle, tableau de benchmarks à côté du classement public, les lignes de code où Ripple n'est pas premier, les tailles de fichiers d'AtomicChat), puis le déploiement dans le panneau sur la RTX A6000, la correction de bug en bac à sable, les résultats en contexte long, et la RTX 3090 de 24 GB avec la comparaison clé.
Sources
- ricursiveAI/Ripple-65B-Preview (page du modèle, config, chat template, recette serveur).
- ricursiveAI/Ripple-65B-Preview-NVFP4.
- ricursiveAI/Ripple-65B-Preview-DFlash2.
- AtomicChat/Ripple-65B-Preview-GGUF.
- PR llama.cpp #31692 et release b12167.
- Article de lancement de Ricursive.
- Miroir BenchLM du classement Vals Terminal-Bench 2.1, mis à jour le 2026-11-07.
- Nos tests précédents de Nanbeige4.3-33B et de Clover-35B-A3B, tous deux sur une RTX 4090 24 GB.
- Vidéo d'actualité d'AI Search, 2026-11-08 (là où nous l'avons repéré).
- Exemple du SDK, commit
ea32931f8486a5ff164c57a7a6c3abaea64cfc90.