Ripple-65B: ein dichter 65B-Coder mit 15 Tokens/s auf einer 48-GB-Karte, 2 Bit auf 24 GB
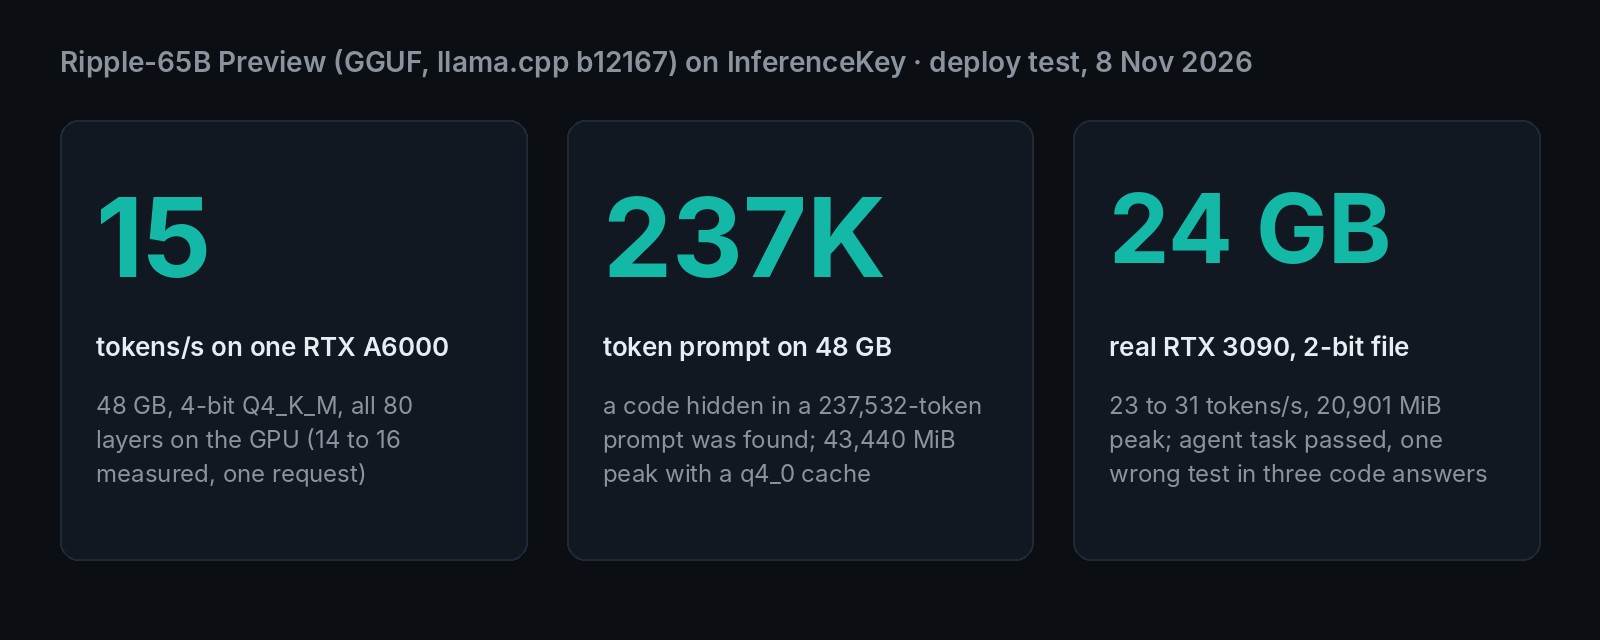
Ein dichter 65B-Coder auf einer 48-GB-Karte: 15 Tokens/s, ein Prompt mit 237K Tokens richtig gelöst und eine echte RTX 3090 mit 2 Bit und einem falschen Test.
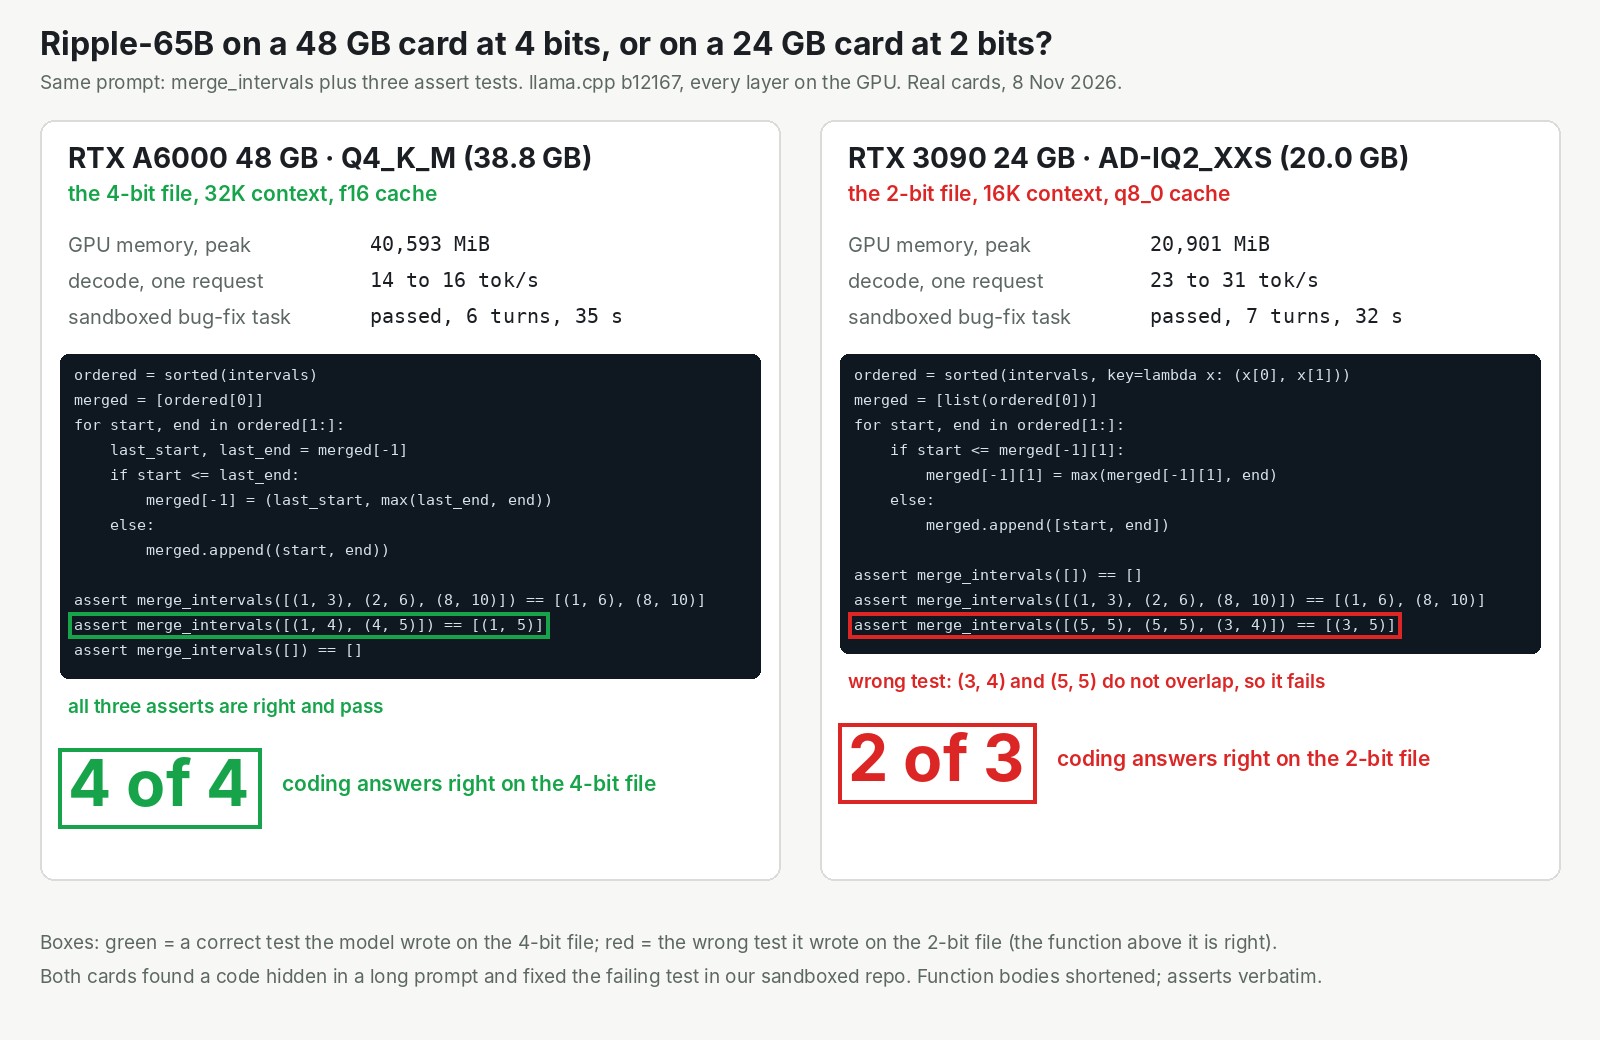
Ripple-65B kommt mit etwa 130 GB an Gewichten. Die Karte, auf der wir es laufen ließen, hat 48 GB. Mit 4 Bit pro Zahl, als Datei mit 38,8 GB, passte es auf eine einzelne RTX A6000 und schrieb etwa 15 Tokens (grob Wörter) pro Sekunde, weil jedes Wort durch das ganze Modell geht. Mit 2 Bit lief es auch auf einer echten RTX 3090 mit 24 GB, und zwar schneller, aber in einer seiner drei Coding-Antworten schrieb das Modell einen Test mit dem falschen erwarteten Ergebnis.
In einem Agenten-Benchmark sehen seine Autoren es gleichauf mit offenen Modellen von 501B bis 975B
Auf Terminal-Bench 2.1, einem Test für Agenten, die auf der Kommandozeile arbeiten, gibt Ricursive Ripple 80,5 Punkte. In ihrer eigenen Tabelle ist das ein Vorsprung von 0,4 Punkten vor Reflection Beam, praktisch ein Gleichstand, und vor drei größeren offenen Modellen. Terminal-Bench ist sein Vorzeigeergebnis. In den meisten anderen Zeilen derselben Tabelle liegt ein Konkurrent vorn.
| Terminal-Bench 2.1 (Angaben der Autoren) | Gesamtgröße | Punkte |
|---|---|---|
| Ripple-65B Preview | 65B | 80,5 |
| Reflection Beam | 501B | 80,1 |
| Meta Muse Spark Open | 816B | 76,4 |
| Thinking Machines Inkling | 975B | 63,8 |
| NVIDIA Nemotron 3 Ultra | 550B | 56,4 |
Die Größenspalte schmeichelt Ripple: Die Konkurrenten sind größer, aber jedes Wort, das sie schreiben, nutzt nur 23B bis 55B Parameter. Ripple nutzt alle 65B.
Diese Zeile stammt von den Autoren selbst. Sie geben zu, dass „replicating benchmark scores has been challenging“, und nennen es einen „best-effort attempt“. Als sie die Konkurrenten im offiziellen Setup des Benchmarks erneut laufen ließen, schnitten drei von vier schlechter ab als in dieser Tabelle. Unsere eigene Lesart ihrer Tabelle: Auf SWE-bench Verified, gebaut aus echten GitHub-Issues, kommt Ripple auf 76,5 gegenüber 81,6 für Reflection Beam.
Auf dem BenchLM-Spiegel von Vals' öffentlicher Terminal-Bench-2.1-Rangliste reichen die fünf führenden Einträge von 92,8 (Cognitions SWE-2) bis 80,4 (Claude Sonnet 5). Diese Rangliste nutzt ein anderes Test-Setup, ihre Zahlen lassen sich also nicht gegen die der Autoren einordnen. Ripple ist ein starkes offenes Ergebnis, kein Anspruch, die besten geschlossenen Coder zu schlagen.
Warum das jetzt zählt: Ein US-Labor hat einen offenen Coder von Grund auf trainiert und ihn unter Apache 2.0 verschenkt, ohne Formular zum Ausfüllen. Ricursive beziffert die gesamten Forschungskosten auf 32 Mio. Dollar, nach eigener Schätzung. Die Gewichte erschienen am 4. November auf Hugging Face. Laut den Autoren wurde es mit 12 Billionen Tokens trainiert und liest Prompts mit bis zu etwa einer Million.
Ricursives eigene Builds zielen auf Rechenzentrums-Hardware, die die meisten Teams nicht besitzen. Wir haben den Weg genommen, den die Community in zwei Tagen geöffnet hat. Eine Portierung von Ripple nach llama.cpp, einem freien Programm, um Modelle auf der eigenen Karte laufen zu lassen, wurde am 5. November gemergt. Nik Bogatyrev hat die Portierung eingereicht; laut der Card von AtomicChat stammt sie von AtomicChat. AtomicChat veröffentlichte in derselben Woche llama.cpp-Dateien, von 129,6 GB (volle Genauigkeit) bis hinunter zu 18,5 GB. Ein llama.cpp-Update vom 6. November konnte sie lesen.
Dicht heißt 15 Tokens pro Sekunde: Jedes Wort liest alle 65 Milliarden Parameter
Ripple schrieb auf der A6000 14,3 bis 16,3 Tokens pro Sekunde. Das ist der Preis der Bauweise.
Jeder Konkurrent in Ricursives Tabelle ist ein Mixture-of-Experts-Modell: Jedes Wort nutzt nur einen Teil des Modells. Ripple ist dicht: Jedes Wort geht durch alle 65 Milliarden Parameter. Mit 4 Bit heißt das, für jedes Wort fast die ganze Datei mit 38,8 GB aus dem Speicher zu lesen, und die A6000 schafft das etwa 15-mal pro Sekunde. Diese Lesegeschwindigkeit setzt die Obergrenze, nicht die Rechenleistung des Chips.
Der nächste Vergleichspunkt ist Nanbeige4.3-33B, ein dichter Coder, den wir vor zwei Tagen getestet haben. Es hat halb so viele Parameter, also etwa halb so viele Bytes pro Wort zu lesen. Es schrieb etwa 42 Tokens pro Sekunde auf einer RTX 4090 mit 24 GB, einer anderen Karte. Clover-35B-A3B, das etwa 3 Milliarden Parameter pro Wort nutzt, schrieb 208 auf derselben RTX 4090.
In der Praxis heißen 15 Tokens pro Sekunde eine Antwort mit 400 Tokens in etwa 27 Sekunden. Bei kurzen Fragen beginnt die Antwort in unter einer Sekunde. Für einen Entwickler, der einen Agenten steuert, ist das brauchbar, aber nicht flott.
Unser Test: eine 4-Bit-Datei auf einer 48-GB-Karte, unsere eigenen Prompts
Wir haben AtomicChats einfache 4-Bit-Datei mit 38,8 GB verwendet, komplett auf einer RTX A6000. Sie lief auf unserem Standard-Setup mit llama.cpp. Die meisten Aufrufe gingen über dieselbe Art von API, die auch dein Produkt aufrufen würde.
Unsere Prüfungen waren klein: eine Antwort mit einem Wort, eine Coding-Aufgabe mit eigenen Tests, zwei Arten von Tool-Call, ein Fakt tief in einem langen Prompt versteckt und eine Agentenaufgabe. Ein Tool-Call ist das Modell, das dein Programm bittet, etwas auszuführen, hier einen Shell-Befehl oder eine Wetterabfrage.
Die Agentenaufgabe war ein Spielzeug-Repository, in dem wir einen Off-by-one-Bug eingebaut hatten, der einen Test scheitern ließ. Das Modell hatte ein einziges Tool, eine Shell, und jeder Befehl, den es schickte, lief in einer Sandbox ohne Netzwerk.
Das sind unsere Grenzen. Wir haben jeweils eine Anfrage auf einmal geschickt, und jede Prüfung lief einmal oder ein paar Mal: 4 Coding-Antworten mit der 4-Bit-Datei, 3 auf der 3090. Die Prompts waren unsere, nicht die Benchmarks der Autoren, die wir nicht reproduziert haben. Das Serving-Setup der Autoren und ihr Hilfsmodell zur Beschleunigung haben wir nicht ausprobiert.
Es hat einen eingebauten Bug in einem Spielzeug-Repo behoben, und jeder unserer Tool-Calls war gültig
Jeder Tool-Call kam gültig zurück, einzeln oder innerhalb der Agentenläufe, im Standardformat, das bestehender Agentencode liest. Vor jedem denkt Ripple ein, zwei Sätze lang nach. Einfache Fragen bekommen eine direkte Antwort.
Auf der A6000 las Ripple den Code, ließ die Tests laufen, sah sie scheitern und änderte ein <= in <. Es ließ die Tests erneut laufen, sah sie bestehen und meldete sich zurück, insgesamt 6 Runden. Die Tests selbst hat es nie angefasst.
| Was wir gefragt haben | Was zurückkam | Zeit |
|---|---|---|
| „Hauptstadt von Australien, ein Wort“ | Canberra, ohne Nachdenken | etwa 0,5 s |
| Eine Funktion, die Zahlenbereiche zusammenführt, mit eigenen Tests | Korrekter Code, Tests bestehen | 12,4 s |
| „In welchem Verzeichnis bin ich?“ mit einem Shell-Tool | Ein gültiger pwd-Befehl | 4,8 s |
| „Ist es in Lissabon oder in Oslo wärmer?“ | Zwei Wetteraufrufe gleichzeitig, beide gültig | 7,1 s |
| Den scheiternden Test in einem Repo in der Sandbox reparieren | Bug behoben, Tests unangetastet | 35 s |
Lange Prompts kosten wenig Speicher: 237.532 Tokens passen in 48 GB, bei 13 Minuten Lesezeit
Dieselbe 48-GB-Karte nahm Prompts mit bis zu 256K Tokens und fand eine bei Token 237.532 versteckte Passphrase, mit etwa 46 GB. Das war ein einziger Test mit versteckter Passphrase pro Länge: Er zeigt, dass das Modell einen Fakt finden kann, nicht, dass es über eine ganze Codebasis hinweg schlussfolgern kann.
Der Grund liegt darin, wie Ripple sich merkt, was es gelesen hat. Beim Lesen macht sich ein Modell Notizen zu jedem Token, und diese Notizen wachsen normalerweise schnell mit dem Prompt. Ripple hat 80 Schichten, wie 80 Leute in einem Meeting, und nur 16 notieren den ganzen Prompt. Die anderen 64 behalten nur die letzten 1.024 Tokens. Das Notizbuch bleibt klein, und für längere Prompts haben wir es zusätzlich komprimiert.
| Längster erlaubter Prompt | Notizen komprimiert auf | Spitzenspeicher | Passphrase bei | Antwort dauerte |
|---|---|---|---|---|
| 32K Tokens | nein (16 Bit) | 42,6 GB | 25.930 Tokens | 48 s |
| 128K Tokens | 8 Bit | 44,4 GB | 118.836 Tokens | 292 s |
| 256K Tokens | 4 Bit | 45,6 GB | 237.532 Tokens | 760 s |
Alle drei haben sie gefunden. Der Haken ist die Zeit. 237.532 Tokens zu lesen dauerte etwa 13 Minuten, und eine Antwort mit 400 Tokens danach etwa eine Minute. Die volle Million ist auf einer einzelnen 48-GB-Karte außer Reichweite: 256K mit komprimierten Notizen sind etwa ihre Grenze.
Welche GPU: Eine echte RTX 3090 mit 24 GB funktioniert mit der 2-Bit-Datei, mit einem falschen Test von dreien
Die kleinste Karte, die bestanden hat, ist eine echte RTX 3090, eine Gaming-Karte mit 24 GB, mit AtomicChats 2-Bit-Datei mit 20,0 GB und Prompts bis 16K Tokens. Weniger Bits pro Zahl heißt eine kleinere Datei und weniger zu lesen pro Wort, aber gröbere Zahlen und mehr Fehler.
Zwei Zeilen unten sind Budgets: Wir haben sie auf der A6000 mit 48 GB laufen lassen, um zu sehen, ob die Datei in 32 oder 24 GB passt. Ihre Geschwindigkeiten sind A6000-Geschwindigkeiten.
| Karte oder Speicherbudget | Datei und längster Prompt | Spitzenspeicher | Tempo (Tokens/s) | Prüfungen | Echte Karte? |
|---|---|---|---|---|---|
| RTX A6000 48 GB | 4 Bit, 32K bis 256K | 42,6 bis 45,6 GB | 14 bis 16 | alle richtig, 4 von 4 Coding-Antworten über die Läufe mit 32K, 128K und 256K | ja |
| Budget 32 GB | 3 Bit, 32K | 29,8 GB | 16 bis 18 | Agent bestanden, 1 von 2 Coding-Antworten mit einem falschen Test | nein, auf der A6000 gelaufen |
| Budget 24 GB | 2 Bit, 16K | 21,2 GB | 21 bis 22 | Agent bestanden, 2 von 2 Tests bestehen, aber eine Funktion sortiert ihre Eingabe nie | nein, auf der A6000 gelaufen |
| RTX 3090 24 GB | 2 Bit, 16K | 21,9 GB | 23 bis 31 | Agent bestanden, 1 von 3 Coding-Antworten mit einem falschen Test | ja |
| RTX 5090 32 GB | 3 Bit | keine | keine | kein Ergebnis: Der Host hat zu langsam heruntergeladen | ja, kein Ergebnis |
| 16 GB | keine | nicht versucht: Die kleinste Datei hat 18,5 GB |
Die Ausrutscher zeigen in dieselbe Richtung wie das, was AtomicChat gemessen hat. Laut ihrer Card sind sich das volle Modell und die 4-Bit-Datei beim nächsten Wort etwa 7-mal von 100 uneinig, die 3-Bit-Datei etwa 9-mal, die 2-Bit-Datei fast 20-mal. Die Bugfix-Aufgabe hat nichts davon aufgedeckt, weil sie das Modell nie aufgefordert hat, neue Tests zu schreiben. Beim Schreiben von neuem Code zeigen es die kleinen Dateien.
Die 48-GB-Karte ist also das saubere Ergebnis, keine Voraussetzung. Eine 24-GB-Karte führt das Modell aus, und du solltest prüfen, was es schreibt.
Auf InferenceKey: bereit in 19 Sekunden, weil nichts gebaut werden musste
Sobald die Datei auf der Maschine lag, antwortete Ripple mit unserem Standard-Setup für llama.cpp 19,0 Sekunden, nachdem wir es angefordert hatten. Die 3090 brauchte 19,3 Sekunden.
Auf InferenceKey ist ein Worker das kleine Programm auf deiner GPU-Maschine, das Aufträge von der Plattform annimmt. Wir haben den Worker angewiesen, ein fertiges llama.cpp für NVIDIA herunterzuladen, statt es zu bauen.
Das Problem, auf das du stoßen kannst: Ohne diese Einstellung baut unser Worker llama.cpp auf NVIDIA-Maschinen selbst, in früheren Tests 5 bis 20 Minuten lang. Status: auf unserer Seite offen. Das SDK-Beispiel setzt die Einstellung standardmäßig, es stößt also nicht darauf.
Dieser Lauf nutzte eine lokale Kopie der Plattform, nicht den gehosteten Dienst. Das SDK-Beispiel lässt das Modell auf einer Maschine laufen, die du angibst. Anfragen gehen auf dem Weg dorthin über den InferenceKey-Endpoint.
Solltest du es nutzen? Ja auf 48 GB, wenn du mit 15 Tokens pro Sekunde leben kannst
- Du hast eine 48-GB-Karte und willst einen offenen Coding-Agenten unter deiner Kontrolle: einen Versuch wert. Die 4-Bit-Datei lieferte unsere saubersten Ergebnisse.
- Du brauchst lange Prompts: Ein Prompt mit 237K Tokens passte in 48 GB. Rechne mit Minuten pro Frage, nicht mit Sekunden.
- Du hast eine 24-GB-Karte: Die 2-Bit-Datei läuft, und schneller, aber prüf ihre Tests.
- Du brauchst vor allem Tempo: Schau dich woanders um. Weil Ripple dicht ist, liest es für jedes Wort das ganze Modell.
Wir haben jeweils eine Anfrage auf einmal geschickt, eine Karte, die sich mehrere Agenten teilen, wird also langsamer sein als hier, um einen Betrag, den wir nicht gemessen haben, und das ist eine Preview mit dem, was Ricursive „relatively light posttraining“ nennt.
Um dieselbe Coding-Aufgabe und denselben Tool-Call auf deinem eigenen NVIDIA-Worker mit 48 GB laufen zu lassen, starte python main.py aus dem SDK-Beispiel für Ripple-65B. Es braucht ein Projekt, ein SDK-Token und einen API-Key und löscht das Deployment am Ende.
Für Ingenieure
Credits
- Ricursive Intelligence: das Modell, von Grund auf trainiert; die Repos für BF16, NVFP4 und den DFlash2-Drafter, alle unter Apache-2.0 (das Base-Repo ist von der Card aus verlinkt; seine Lizenz haben wir nicht geprüft); die Model Card, die Benchmark-Tabelle, die Chat-Vorlage und das Server-Rezept; der Launch-Post.
- Nik Bogatyrev (notforu777): llama.cpp PR #31692, „model : add Ripple (ricursiveai)“, gemergt am 2026-11-05 (Merge-Commit
fecdc81e, +406/-3, keine neuen ggml-Ops; KLD 0 und Top-1 100 % gegenüber dem Code des Herstellers auf einem winzigen Zufallsmodell und den ersten 10 echten Schichten; BF16-PPL 3,01; KI-Nutzung offengelegt). Die GGUF-Card von AtomicChat sagt, AtomicChat habe die Portierung geschrieben. - AtomicChat: die GGUF-Quants, die wir verwendet haben (einfaches Q4_K_M, AD-IQ3_XXS, AD-IQ2_XXS), und ihre Tabelle mit KLD und Top-Token.
- Die Maintainer von llama.cpp: Release b12167 (2026-11-06) mit vorgebauten Tarballs
ubuntu-cuda-12.8-x64undubuntu-cuda-13.4-x64, dazu das Parsen der Tool-Calls über--jinja. - AI Search: wo wir es entdeckt haben (News-Video vom 2026-11-08, Kapitel bei 41:26).
- Unser Teil: das Deployment über die Plattform, die Prompts und die Agentenaufgabe in der Sandbox, die Läufe mit langem Kontext, die Speicherleiter auf zwei echten Karten plus zwei Läufe auf der A6000, zugeschnitten auf Budgets von 32 und 24 GB, das SDK-Beispiel und das Demovideo.
Modell und Dateien
ricursiveAI/Ripple-65B-Preview: shada94cc01, erstellt am 2026-11-04T02:41Z, zuletzt geändert am 2026-11-06, etwa 129,6 GB BF16 in 16 Shards, ohne Zugangsbeschränkung. NVFP4-Repo99eea447(6 Shards, etwa 57,2 GB; „experimental“, NVFP4-MLP und BF16-Attention; liefertspark.pyund ein Notebook mit). DFlash2-Drafter35609b3b(4,04B Parameter, BF16 etwa 8,08 GB). AtomicChat-GGUFdf550a71.- Architektur:
RicursiveForCausalLM(eigener Code,model_typericursive), 80 Schichten im Muster 4:1 (64 Sliding-Window-Schichten, Fenster 1.024, RoPE; 16 globale Full-Attention-Schichten mit NoPE), hidden 5120, FFN 40960, 80 Query-Heads / 8 KV-Heads, head_dim 128, Vokabular 100.352,max_position_embeddings2.097.152, Gated Attention, Value Residuals, FFN-Clamp 20, Embed-Scale sqrt(5120). Die Card nennt es „Gemma 3N-like“ und „thin-and-deep“, gestartet von einer Olmo-3-Baseline. - Trainingsphasen (Card): Pretraining 12T Tokens bei 8K; Midtraining 200B bei 64K; langer Kontext 6,5B bei 2M; SFT 183B bei 128K; SFT mit langem Kontext 13,5B bei 2M; RL 700 Schritte bei 128K. „Relatively light posttraining, with a focus on agentic coding.“
- KV-Cache in f16: 16 globale Schichten x 8 x 128 x 2 x 2 B = 64 KiB pro Token, plus der Ringpuffer des Sliding Window. Nach dieser Rechnung sind 1M in f16 etwa 64 GiB allein für den Cache.
- Größen von AtomicChat und Anteil gleicher Top-Tokens gegenüber BF16: Q4_K_M 38,8 GB 93,0 % (mittlere KLD 0,0380); AD-IQ4_XS 38,7 GB 95,6 %; AD-Q4_K_M 40,4 GB 95,9 %; AD-IQ3_XXS 28,0 GB 91,2 % („32 GB (RTX 5090)“); AD-IQ2_XXS 20,0 GB 80,8 % („24 GB (RTX 3090 / 4090)“); AD-IQ1_M 18,5 GB 76,8 % („research“); Q8_0 68,8 GB; BF16 129,6 GB. Ihr eigenes Tempo: einfaches Q4_K_M auf einem GH200 mit 96 GB, Prefill 309 Tokens/s, Decode 40,6 Tokens/s. Ricursive veröffentlicht kein Standard-Sampling.
- Herstellerangaben, die wir nicht geprüft haben: Team „scaled from 1 to 5 people“, 40 % MFU mit einfachem Sharding und ohne eigene Kernels, „can fit on consumer hardware such as the NVIDIA DGX Spark“, „250 tok/s on 2xB200 batch=8 prior to quantization or custom kernels“, 32 Mio. Dollar Gesamtkosten für Forschung und Entwicklung (ihre Schätzung), RL bis 80,5 mit 1,4M Rollouts, Qualität bei 1M Kontext.
Angaben der Autoren (nicht reproduziert)
Aus der Model Card; alle Modelle in vollem BF16, maximaler Aufwand; kursive Zellen in ihrer Tabelle sind Ricursives eigene Läufe der Konkurrenten.
| Benchmark | Ripple-65B | Bester anderer in ihrer Tabelle |
|---|---|---|
| Terminal-Bench 2.1 | 80,5 | Reflection Beam 80,1 |
| Terminal-Bench 2.1, Harness Terminus 2 | 80,5 | Muse Spark Open 78,7 (Beam 70,8, Inkling 56,2, Nemotron 55,1) |
| SWE-bench Verified | 76,5 | Reflection Beam 81,6 |
| SWE-bench Pro v1.0 | 61,42 | Reflection Beam 66,1 |
| SWE-bench Pro v2.0 Hard | 79,1 | bester in der Tabelle |
| DeepSWE 1.1 | 44,3 | Muse Spark Open 60,0 |
| MCP Atlas | 71,67 | Muse Spark Open 89,2 |
| SciCode | 39,4 | Muse Spark Open 58,5 |
| GPQA Diamond | 85,2 | Reflection Beam 90,6 |
| AIME 2026 | 95,0 | |
| AA-LCR | 75,0 | Muse Spark Open 80,7 |
| IFBench | 79,2 |
Die Konkurrenten sind alle Mixture-of-Experts-Modelle mit 23B bis 55B aktiven Parametern; bei Ripple sind es die vollen 65B. Öffentlicher Kontext: die fünf führenden Einträge auf dem BenchLM-Spiegel von Vals Terminal-Bench 2.1 (aktualisiert am 2026-11-07): SWE-2 92,8, GPT-5.6 Sol 91,9, Claude Mythos 5 88,0, Claude Fable 5 84,3, Claude Sonnet 5 80,4. Die Harnesses unterscheiden sich von denen der Autoren, die Zeilen sind also nicht direkt vergleichbar.
Setup
- GPUs auf InferenceKey Cloud: RTX A6000 48 GB (46.068 MiB, 300 W, Compute Capability 8.6) für den Hauptlauf; RTX 3090 24 GB (Compute Capability 8.6) für die echte 24-GB-Stufe.
- Backend: das eingebaute Backend
llamacpp,INFERENCEKEY_LLAMACPP_TAG=b12167(der Standard-Tag des Workers ist älter und kann die Architekturricursivenicht lesen) undINFERENCEKEY_LLAMACPP_ASSET=ubuntu-cuda-13.4-x64. Die Bibliotheken des Tarballs wurden gegen CUDA 13libcublas.so.13/libcudart.so.13des Images aufgelöst; der separate Tarballcudart-llama-*wird nicht geladen. - Warum llama.cpp und nicht vLLM oder SGLang: Die Architektur ist eigen. Das Server-Rezept des Herstellers (
inference/serverim BF16-Repo) läuft auf SGLang 0.5.19 mit Ricursives eigenem Modellcode: nicht quantisiertes BF16-Zielmodell plus natives DFlash2, TP=2 auf zwei B200, 1Mi Standardkontext, Ripples Parser für Reasoning und Tool-Calls. Ricursive sagt außerdem, dass der experimentelle NVFP4-Build auf eine DGX Spark passt (von uns nicht getestet). Unabhängig davon nennt die DFlash2-Card eine Runtimeripple-sglang, verwendet für eine Export-Validierung auf 8x H100 mit dem Zielmodell aus RL-Schritt 500. Ob unverändertes vLLM oder SGLang das Modell ohne Ricursives Zusatzcode lädt, haben wir nicht geprüft. Die Unterstützung in llama.cpp ist seit b12167 upstream, und das GGUF ist das, was auf eine Karte passt. --jinja --reasoning-format deepseek: Das<tool_call>{json}</tool_call>der Vorlage kam als OpenAI-tool_callszurück; das Reasoning vor Tool-Calls (61 bis 213 Zeichen) landete inreasoning_content, Content war nie leer.- Ein lokaler InferenceKey-Manager, gebaut aus unserem main-Branch (
435050e1), von den Workern über Tunnel erreicht. Produktion nie angefasst. Sampling mit Temperature 0,6, top_p 0,95; Stufen der Leiter mit Seed 42.
Schritt für Schritt mit dem SDK-Beispiel
- Klon inferencekey-sdk und öffne
examples/ripple-65b-agent-llamacpp-private-nvidia(Commitea32931f8486a5ff164c57a7a6c3abaea64cfc90). cp .env.example .envund tragINFERENCEKEY_SDK_TOKEN,INFERENCEKEY_API_KEY,INFERENCEKEY_PROJECTundIK_WORKER_IDein (ein privater NVIDIA-Worker mit 48 GB). Optional:RIPPLE_GGUF_FILE(standardmäßig Q4_K_M),RIPPLE_CONTEXT(32768),RIPPLE_KV_TYPE(f16),RIPPLE_LLAMACPP_TAG(b12167),RIPPLE_LLAMACPP_ASSET(ubuntu-cuda-13.4-x64; leer baut aus dem Quellcode),IK_KEEP_ALIVE=1.pip install -r requirements.txt(requests>=2.31) plus der lokale SDK-Build mit maturin (das SDK ist nicht auf PyPI).- Das vorgebaute Asset braucht auf dem Worker einen CUDA-13-Treiber und
libcudart.so.13/libcublas.so.13. Auf Blackwell-Karten (sm_120) wurde es nicht ausprobiert. python main.py. Es führtensure()für einen festenllamacpp-Workload aus, der an deinen Worker gebunden ist, wartet bis zu 3.600 s, schickt eine Coding-Aufgabe mitgenerate_text(), macht einenexecute_bash-Tool-Call und gibt ein vorgefertigtes Ergebnis zurück, schreibtoutputs/answers.jsonund ruftdelete()auf, außer beiIK_KEEP_ALIVE=1.
Der Startbefehl, den das Backend ausführt:
INFERENCEKEY_LLAMACPP_TAG=b12167 \
INFERENCEKEY_LLAMACPP_ASSET=ubuntu-cuda-13.4-x64 \
llama-server \
  -hf AtomicChat/Ripple-65B-Preview-GGUF \
  --hf-file Ripple-65B-Preview-Q4_K_M.gguf \
  --alias ripple-65b-preview -ngl 99 -fa on \
  -c 32768 -ctk f16 -ctv f16 \
  --jinja --reasoning-format deepseek
Für 128K nimm -c 131072 -ctk q8_0 -ctv q8_0; für 256K -c 262144 -ctk q4_0 -ctv q4_0. Für eine 24-GB-Karte setz RIPPLE_GGUF_FILE=Ripple-65B-Preview-AD-IQ2_XXS.gguf, RIPPLE_CONTEXT=16384 und RIPPLE_KV_TYPE=q8_0.
Zeiten
| Schritt | RTX A6000 | RTX 3090 |
|---|---|---|
ensure() bis bereit | 19,0 s | 19,3 s |
| Download und Installation des llama.cpp-Tarballs (169 MB) | etwa 1 s | |
| Laden des Modells | etwa 8 s | |
| Vorab-Download des GGUF (nicht auf dem Weg zu bereit) | 32 s (Q4_K_M) | 41 s (AD-IQ2_XXS) |
| Direkter Neustart von llama-server, warm | 7,0 bis 13,4 s bis /health |
Worker-Log auf der A6000: install_llamacpp ok um 06:52:07, llama-server gestartet um 06:52:15, Modell bereit um 06:52:23 (UTC).
Tempo und Ausgaben (RTX A6000, Q4_K_M, 32K, f16-Cache, Streaming über den Endpoint)
| Test | Completion-Tokens | Sekunden | Erstes Token s | Decode Tokens/s | Ergebnis |
|---|---|---|---|---|---|
| Hauptstadt von Australien x2 | 3 / 4 | 0,46 / 0,57 | 0,31 / 0,35 | 20,6 / 18,0 | Canberra, ohne Nachdenken |
merge_intervals + 3 Asserts | 174 | 12,37 | 0,33 | 14,4 | Asserts bestehen in der Sandbox |
execute_bash „In welchem Verzeichnis bin ich?“ | 65 | 4,82 | 0,56 | 15,3 | {"command": "pwd"}, 154 Zeichen Reasoning |
Lissabon oder Oslo, get_weather | 93 | 7,1 | 0,88 | 14,9 | zwei parallele Aufrufe |
| Agent: den scheiternden Test reparieren | 410 in 6 Runden | 35,2 | 14,5 bis 15,5 pro Runde | <= zu <, pytest 2 passed, Tests unangetastet | |
| Needle, Prompt mit 25.930 Tokens | 6 | 48,53 | 48,16 (etwa 540 Tokens/s Prefill) | 16,3 | gefunden |
Läufe des SDK-Beispiels: A6000 Q4_K_M bereit in 19,0 s, Code 12,9 s (Asserts bestehen), pwd-Aufruf 4,47 s, finale Antwort 1,22 s bei 15,7 Tokens/s. RTX 3090 AD-IQ2_XXS bereit in 19,3 s, Code 9,0 s mit einem falschen dritten Assert, Tool-Call 3,02 s, Antwort 2,26 s bei 25,9 Tokens/s.
VRAM-Leiter
Spitzen-VRAM aus nvidia-smi, alle 0,5 s abgefragt. Die Budgetstufen liefen auf der A6000 und blieben in der Spitze unter dem Budget; ihre Geschwindigkeiten sind A6000-Geschwindigkeiten.
| GPU oder Budget | Konfiguration | Spitzen-VRAM | Tempo | Ausgabe OK | Echt oder emuliert |
|---|---|---|---|---|---|
| RTX A6000 48 GB | Q4_K_M, 32K, f16 (das Beispiel, über den Endpoint) | 40.593 MiB | 14,3 bis 16,3 Tokens/s; Agent 6 Runden 35,2 s (Aufnahme 5 Runden, 439 Tokens, 36,3 s) | ja; Code 2 von 2 | echt |
| RTX A6000 48 GB | Q4_K_M, 128K, q8_0 | 42.373 MiB | 13,5 bis 14,3; Needle 118.836 Tokens in 292,3 s, 9,1 in der Tiefe | ja | echt |
| RTX A6000 48 GB | Q4_K_M, 256K, q4_0 | 43.440 MiB | 13,5 bis 14,3; Needle 237.532 Tokens in 760,4 s, Prefill im Schnitt 312,9, 6,8 in der Tiefe | ja | echt |
| Budget 32 GB | AD-IQ3_XXS (28,0 GB), 32K, q8_0 | 28.395 MiB | 16,4 bis 17,8; Agent 5 Runden 29,6 s; Needle 25.930 Tokens gefunden | Agent ja; Code 1 von 2, falscher Test [(5,7),(1,2),(3,4)] == [(1,2),(3,7)] | emuliert auf der A6000 |
| Budget 24 GB | AD-IQ2_XXS (20,0 GB), 16K, q8_0 | 20.249 MiB | 20,6 bis 21,9; Agent 6 Runden 36,7 s; Needle 12.562 Tokens gefunden | Agent ja; Code 2 von 2 Asserts bestehen, aber eine Funktion sortiert ihre Eingabe nie | emuliert auf der A6000 |
| RTX 3090 24 GB | AD-IQ2_XXS, 16K, q8_0, über den Endpoint | 20.901 MiB (etwa 130 W) | 23,6 bis 30,9; Agent 7 Runden 32,0 s (Aufnahme 5 Runden 28,7 s); Needle 12.562 Tokens bei 22,5; zwei Wetteraufrufe 4,38 s | Agent ja; Code 2 von 3, falscher Test [(5,5),(5,5),(3,4)] == [(3,5)] (Funktion korrekt) | echt |
| RTX 5090 32 GB | AD-IQ3_XXS (32K, q8_0 geplant, nie gestartet) | keine | keine | kein Ergebnis: Download bei 14,49 GB hängen geblieben (etwa 12 MB/s) | echte Karte, kein Ergebnis |
| 16 GB | keine | nicht versucht: Die kleinste Datei AD-IQ1_M hat 18,5 GB |
Code-Summen über die Zeilen: Q4_K_M 4 von 4 (die Läufe mit 32K, 128K und 256K); AD-IQ2_XXS 4 von 5 mit bestandenen Asserts über das 24-GB-Budget und die echte 3090, eine davon mit dem Sortierfehler; AD-IQ3_XXS 1 von 2.
Nicht versucht: der experimentelle NVFP4-Checkpoint (57,2 GB; unsere Schätzung ist eine Blackwell-Karte mit 96 GB wie die RTX PRO 6000, während Ricursives Card die DGX Spark nennt und das NVFP4-Repo ein spark.py mitliefert); das Rezept der Autoren mit BF16 + DFlash2 auf 2x B200 (der DFlash2-Drafter ist ein 4,04B-Modell, das Blöcke von 16 Tokens entwirft, um das Schreiben zu beschleunigen); die Benchmarks der Autoren; Kontext mit 512K oder 1M; AD-Q4_K_M und AD-IQ4_XS (bessere Top-Token-Raten bei ähnlicher Größe); eine L40S; Durchsatz mit mehreren Anfragen; eine echte RTX 5090; der CUDA-13.4-Tarball auf Blackwell (sm_120).
Offene Probleme
- Der Worker baut llama.cpp auf NVIDIA standardmäßig aus dem Quellcode.
asset.rssagt, das Release veröffentliche keinen Linux-CUDA-Tarball, was seit b12167 nicht mehr stimmt, denn es liefert zwei.INFERENCEKEY_LLAMACPP_ASSETfest zu setzen hat auf beiden Karten funktioniert. Offen: den CUDA-Tarball bevorzugen, wenn Treiber und Bibliotheken es erlauben. - Die Umgebungsvariable für die Container-Disk wird vom Manager nicht mehr gelesen; die Plattengröße kam aus
min_disk_gb=100der Anfrage (87 GB an GGUFs, 82 % belegt). Offen, Dokumentation zu aktualisieren. - Zwei unbrauchbare Hosts: Ein RTX-3090-Host bot kein direktes TCP-SSH an, und der Manager beendete ihn nach 180 s; ein RTX-5090-Host lud mit etwa 12 MB/s herunter und wurde nach etwa 16 Minuten ohne Ergebnis gelöscht. Die Hosts der Läufe, die funktioniert haben, luden mit 1,0 bis 1,2 GB/s herunter.
- Qualität mit den 3-Bit- und 2-Bit-Dateien: je ein falscher Test und eine 2-Bit-Antwort, die ihre Eingabe nie sortiert. Die Bugfix-Agentenaufgabe prüft das nicht.
- Anzeigename des Workloads fest auf „Q4_K_M“ codiert in
main.py, während auf der 3090 die 2-Bit-Datei lief. Vor dem Commit im Beispiel behoben; im Video verdeckt.
Demovideo
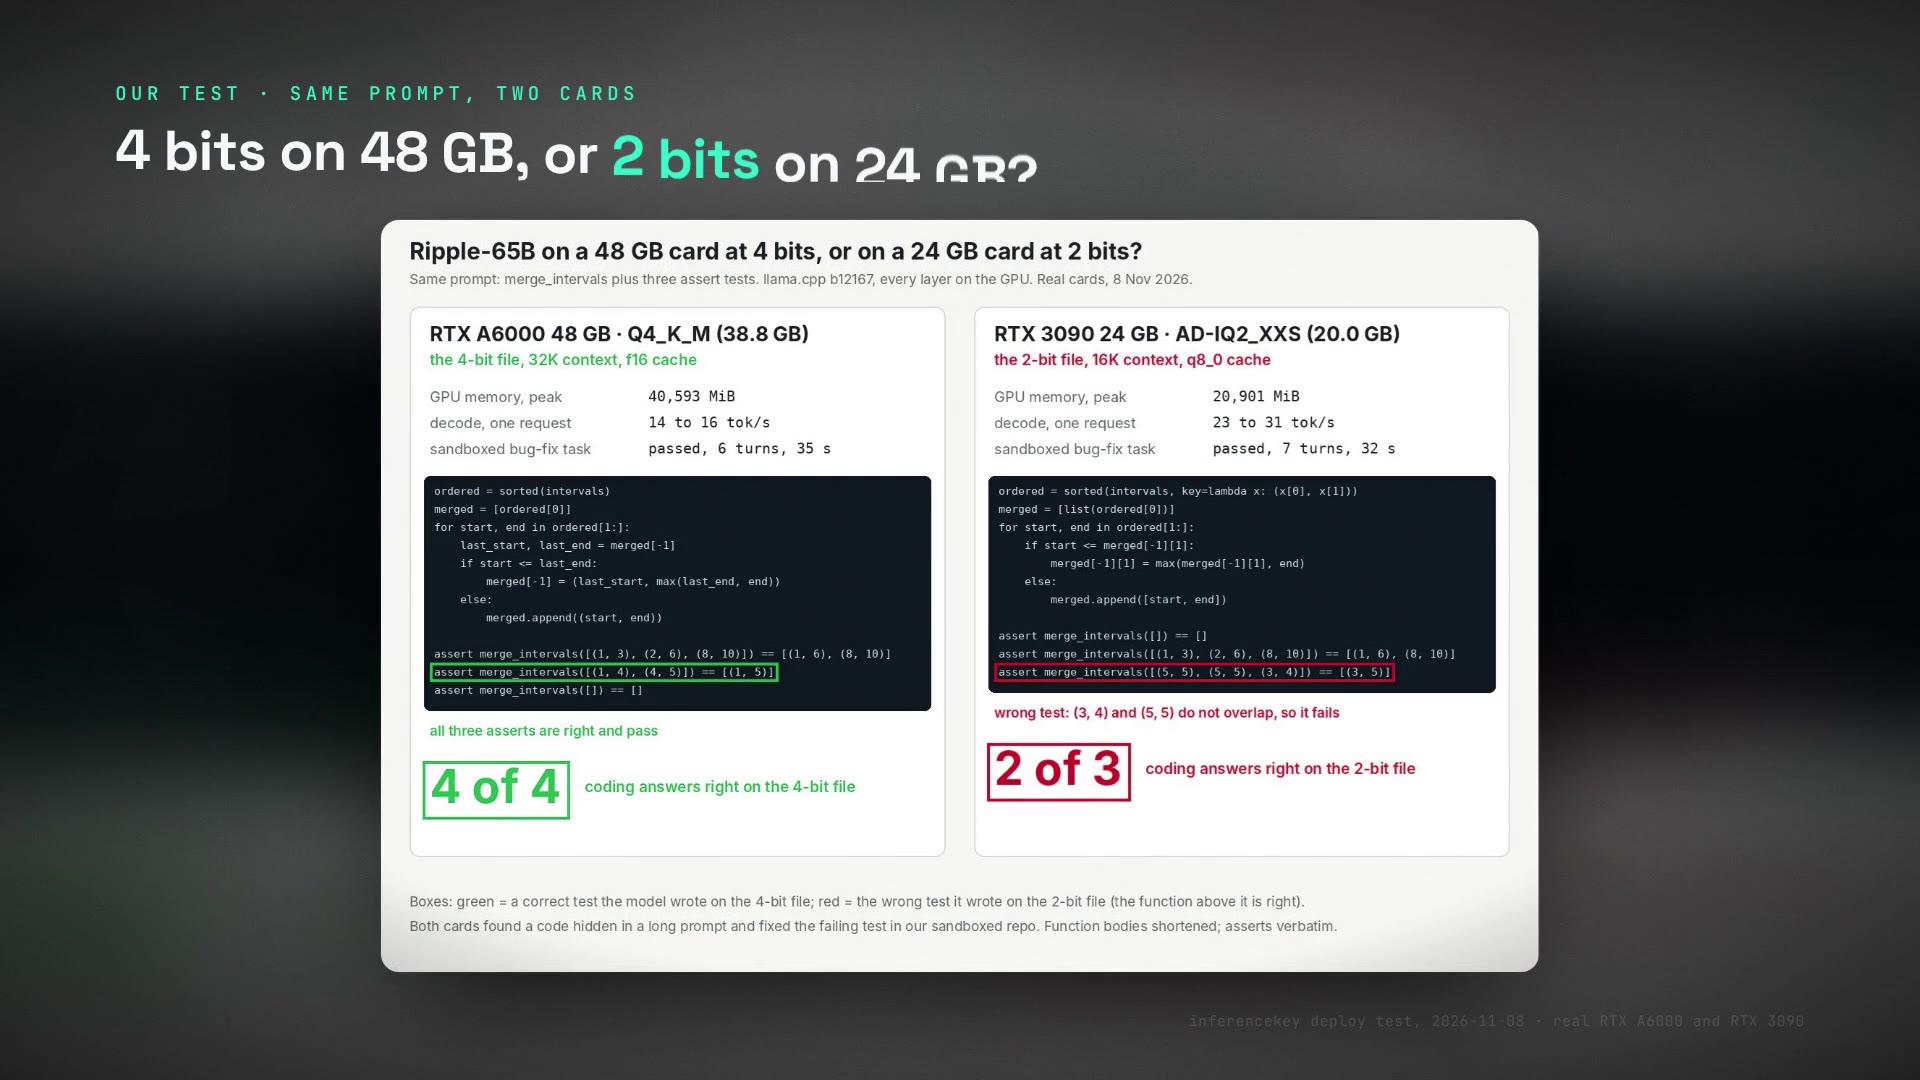
Die vertonte Demo mit 165 Sekunden: zuerst das Material der Autoren (Model Card, Benchmark-Tabelle neben der öffentlichen Rangliste, die Coding-Zeilen, in denen Ripple nicht vorn liegt, die Dateigrößen von AtomicChat), dann das Deployment im Panel auf der RTX A6000, die Bugfix-Aufgabe in der Sandbox, die Ergebnisse mit langem Kontext und die RTX 3090 mit 24 GB mit dem Schlüsselvergleich.
Quellen
- ricursiveAI/Ripple-65B-Preview (Model Card, Config, Chat-Vorlage, Server-Rezept).
- ricursiveAI/Ripple-65B-Preview-NVFP4.
- ricursiveAI/Ripple-65B-Preview-DFlash2.
- AtomicChat/Ripple-65B-Preview-GGUF.
- llama.cpp PR #31692 und Release b12167.
- Launch-Post von Ricursive.
- BenchLM-Spiegel der Vals-Rangliste Terminal-Bench 2.1, aktualisiert am 2026-11-07.
- Unsere früheren Tests von Nanbeige4.3-33B und Clover-35B-A3B, beide auf einer RTX 4090 mit 24 GB.
- News-Video von AI Search, 2026-11-08 (wo wir es entdeckt haben).
- SDK-Beispiel, Commit
ea32931f8486a5ff164c57a7a6c3abaea64cfc90.