Qwen3.5-0.8B: Eine KI hat 0,016 % seiner Gewichte editiert, und die Denkschleifen fielen von 93 % auf etwa 32 %
Kein Training, zwei editierte Schichten. Am Tokenlimit abgeschnittene Antworten fielen von 93 % auf etwa 32 %. Bei 50 Aufgaben: 62 % richtig statt 8 %.
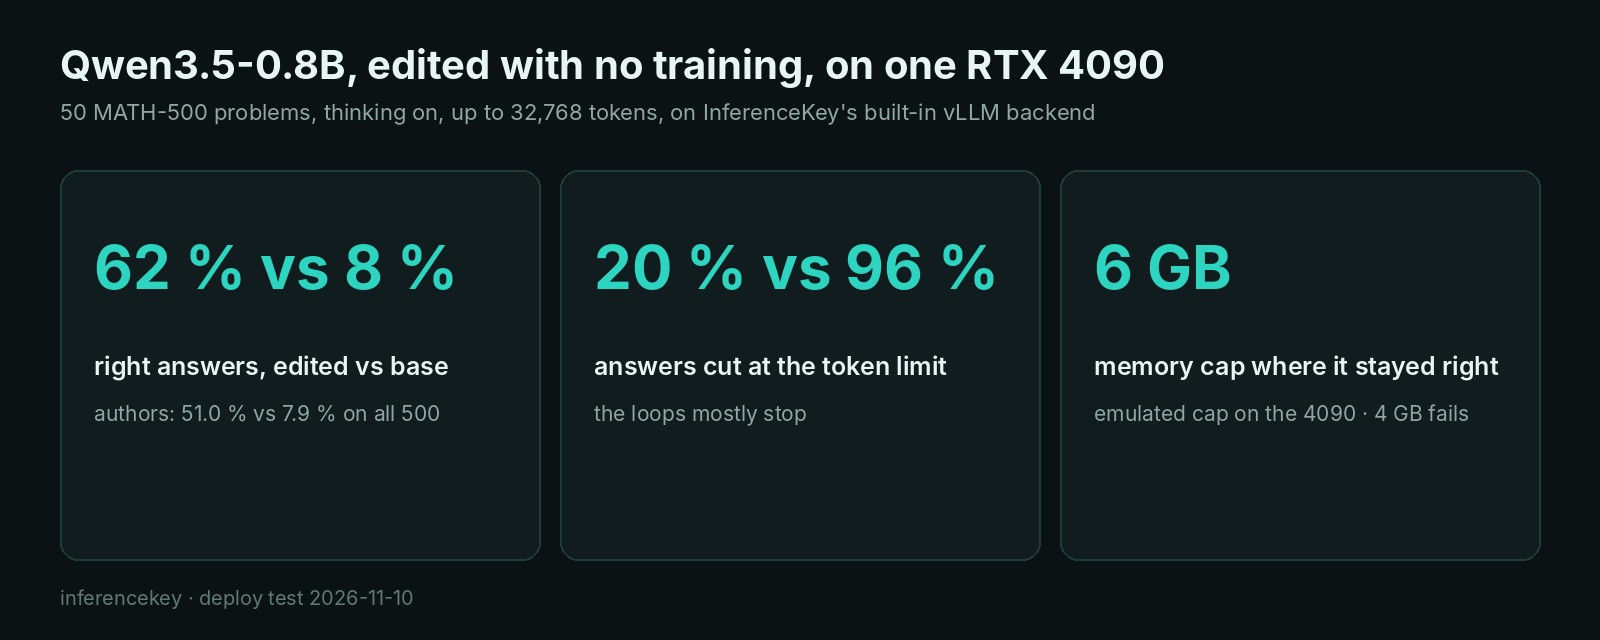
Eine andere KI hat in Qwen3.5-0.8B, einem kleinen offenen Reasoning-Modell, an zwei Stellen je 64 Spalten von Zahlen geändert, und zwar ganz ohne Training. Wir haben das editierte Modell und das Original nebeneinander auf einer RTX 4090 in unserer Cloud laufen lassen, mit denselben 50 Matheaufgaben und denselben Einstellungen. Das editierte kam auf 62 % richtige Antworten. Das Original auf 8 %, weil 96 % seiner Antworten nie endeten: Es dachte im Kreis, bis es das Limit von 32.768 Tokens (Wortstücken) erreichte. Wenn du kleine Reasoning-Modelle auf deinen eigenen GPUs betreibst, geht es hier genauso um Kosten wie um Genauigkeit. Eine Antwort, die nie endet, belegt einen Platz auf deiner Karte, bis das Limit sie abschneidet, und meistens kommt dabei keine Antwort heraus. Die editierte Datei lädt und läuft mit demselben Befehl wie das Basismodell. Geprüft haben wir nur Mathe mit eingeschaltetem Denken.
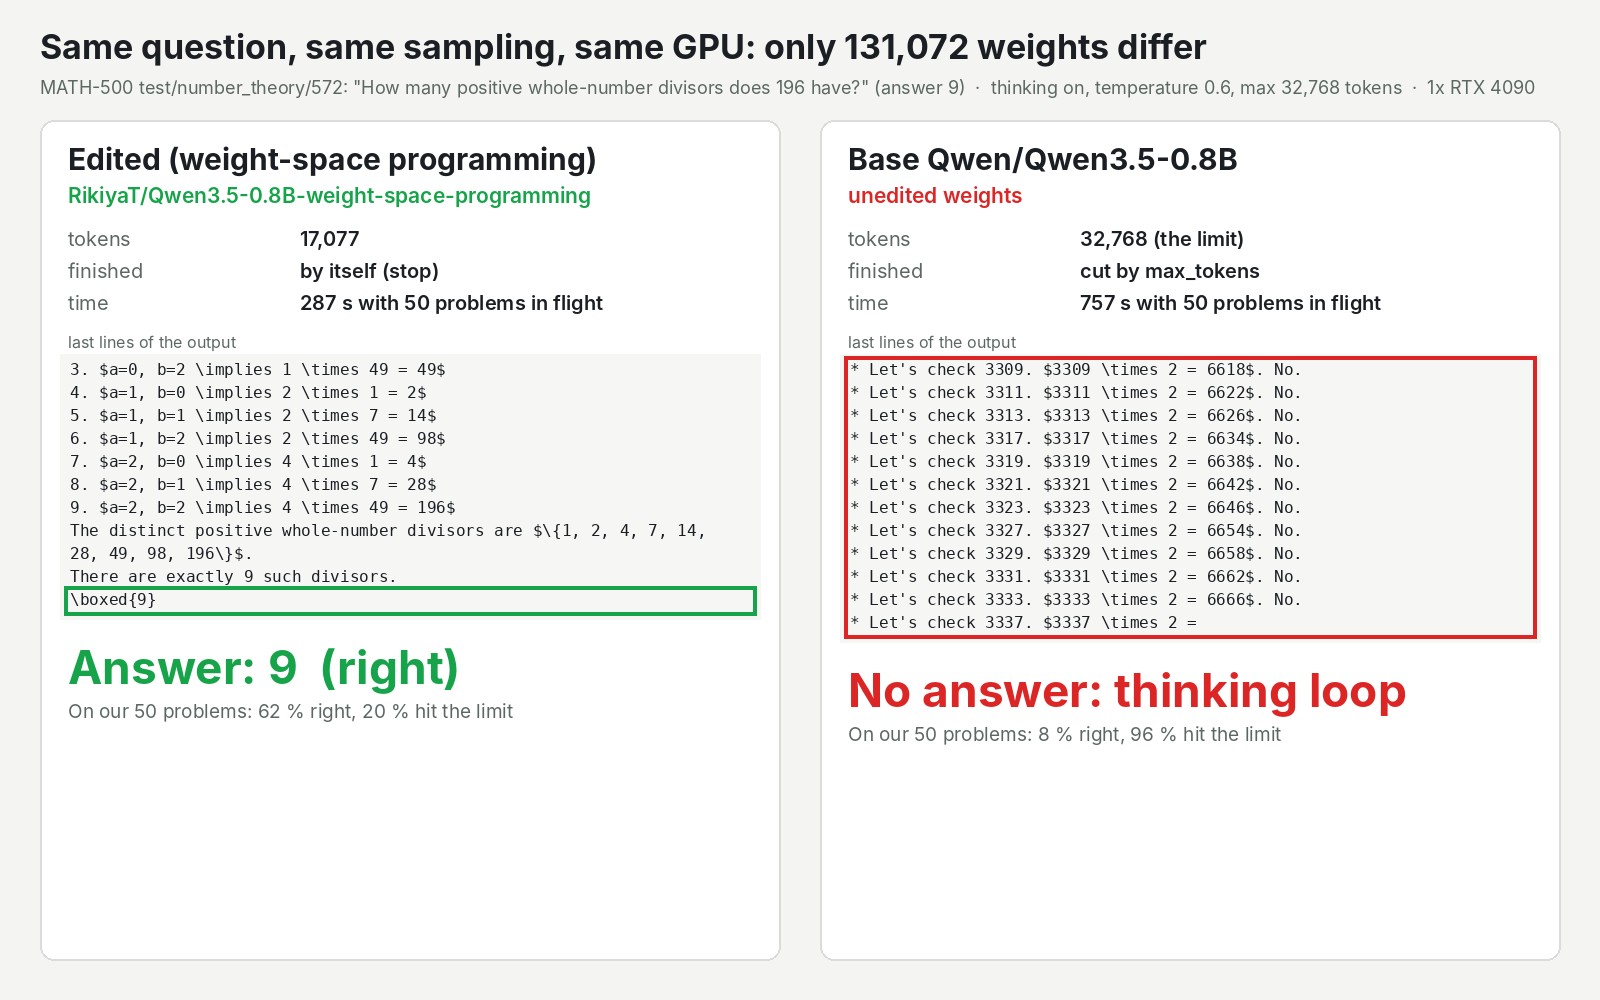
Die Frage auf dem Bild ist einfach: Wie viele Teiler hat 196? Die Antwort ist 9. Das editierte Modell fand sie und hörte auf. Das Basismodell begann, Zahlen jenseits von 3.300 einzeln aufzuzählen, und war immer noch dabei, als das Limit es abschnitt.
| Bei unseren 50 Wettbewerbs-Matheaufgaben (MATH-500) | Editiert | Basis |
|---|---|---|
| Richtige Antworten | 62 % | 8 % |
| Am Limit von 32.768 Tokens abgeschnittene Antworten | 20 % | 96 % |
| Durchschnittliche Tokens pro Antwort | 20.444 | 31.832 |
Ein Modell, das das Ende nicht findet, und ein Edit, der ihm eines gibt
Der Edit macht genau eine Sache: Er entfernt die Gewohnheit, die das Modell in Schleifen laufen ließ. Die Mathematik, die das Modell richtig löst, steckte schon vorher drin.
Qwen3.5-0.8B gehört zur Qwen3.5-Familie und hat etwa 0,8 Milliarden gelernte Zahlen (die Gewichte). Bevor ein Reasoning-Modell antwortet, schreibt es einen Notizblock: Es denkt laut nach und gibt dann das Ergebnis aus. Qwens eigene Model Card warnt, dass diese Größe „more prone to entering thinking loops“ ist als ihre Geschwister. Stell dir eine Band vor, die das Ende eines Songs nicht findet. Alle spielen noch in der richtigen Tonart, aber das Outro dreht sich im Kreis, bis der Tontechniker den Stecker zieht. Auf einer GPU ist der Tontechniker das Tokenlimit, und jedes Token, das das Modell schreibt, kostet Zeit auf der Karte.
Am 2. November 2026 veröffentlichte ein Team am MIT CSAIL einen Blogpost über das, was es Weight-Space Programming nennt. In einem ihrer Experimente bekommt ein großes Modell, das sie GPT-6 Astra nennen, ein Werkzeug, um die Zahlen des kleinen Modells zu untersuchen und zu ändern. Dazu bekommt es Übungsaufgaben, keine davon aus dem Test, auf dem es bewertet wird. Sein Budget ist eine Anzahl von Übungsläufen des kleinen Modells: 10, 25 oder 50. Astra beobachtet, was das Modell tut, liest sein Inneres und ändert die Zahlen direkt. Keinerlei Training.
Von den ersten 96 Übungsantworten des Basismodells liefen 85 bis zum Limit von 32.768 Tokens. Mit 50 Läufen fand Astra das Muster hinter den Schleifen an zwei Stellen im Modell und löschte es dort aus jeweils 64 Spalten von Zahlen. Das sind 131.072 Gewichte des gesamten Modells: 0,016 %. Auf MATH-500, einem Standardsatz von 500 Wettbewerbs-Matheaufgaben, berichten die Autoren einen Sprung von 7,9 % auf 48,1 % richtige Antworten. Der Anteil der am Limit abgeschnittenen Antworten fiel von 93 % auf 33,1 %. Ähnliche Sprünge berichten sie auf zwei weiteren Tests, die wir nicht wiederholt haben (siehe Anhang).
Die Autoren haben die genaue Änderung veröffentlicht und ein Skript, das sie nachbaut. Der Hugging-Face-Nutzer akhaliq hat die editierte Modelldatei nachgebaut, sie auf allen 500 Aufgaben neu laufen lassen und eine öffentliche Demo online gestellt. Sein Lauf kam auf 51,0 % richtige Antworten, mit 31,6 % am Limit abgeschnittenen. Wir sind auf die Geschichte im News-Video von AI Search vom 8. November gestoßen.
62 % richtig gegen 8 % auf einer RTX 4090, und die Schleifen fallen von 96 % auf 20 %
Mit den Evaluationseinstellungen der Autoren hörte die editierte Datei auf unserer Hardware mit den meisten ihrer Schleifen auf und beantwortete fast achtmal so viele Aufgaben richtig.
Beide Modelle liefen nebeneinander auf einer einzigen RTX 4090 mit 24 GB in unserer Cloud, jedes hinter seinem eigenen API-Endpoint. Beide nutzten vLLM, die Open-Source-Serving-Engine, die auch akhaliqs Lauf verwendete, mit eingeschaltetem Denk-Notizblock und den Zufallseinstellungen der Autoren.
Die Fragen waren die ersten 50 MATH-500-Aufgaben in der Reihenfolge von akhaliqs Lauf, ein Versuch pro Aufgabe, bis zu 32.768 Tokens pro Antwort. Alle 50 liefen pro Modell gleichzeitig, beide Modelle zur selben Zeit. Bewertet haben wir mit dem Bewertungsskript der Autoren.
| Editiert | Basis | |
|---|---|---|
| Richtig | 31 von 50 (62 %) | 4 von 50 (8 %) |
| Abgeschnitten bei 32.768 Tokens | 10 (20 %) | 48 (96 %) |
| Durchschnittliche Tokens pro Antwort | 20.444 | 31.832 |
Unsere 62 % liegen über beiden veröffentlichten Werten. Das liegt an der kleinen Stichprobe: Auf diesen 50 Aufgaben kam akhaliqs Lauf im Schnitt auf 54 %, und unsere Antworten stimmten bei 42 von 50 mit seinem üblichen Ergebnis überein. Die 8 % und 96 % des Basismodells liegen genau auf den Werten der Autoren.
Die beiden Male, in denen das Basismodell eine Antwort zu Ende brachte, war sie richtig. Seine anderen 2 richtigen Antworten kamen aus Schleifen, die die richtige Zahl schon geschrieben hatten, bevor das Limit sie abschnitt.
Die Ersparnis: 1,02 Millionen Tokens statt 1,59 Millionen für dieselben 50 Aufgaben
Auf denselben 50 Aufgaben brauchte das editierte Modell im Schnitt 20.444 Tokens pro Antwort und das Basismodell 31.832, und 20 % der editierten Antworten wurden am Limit abgeschnitten gegenüber 96 %. Pro richtiger Antwort: etwa 5 Minuten Batch-Zeit gegenüber 32 Sekunden (398.000 Tokens gegenüber 33.000). Dieser Abstand beruht auf nur 4 richtigen Antworten des Basismodells, nimm ihn also als grobe Schätzung.
Eine GPU bedient eine feste Zahl von Antworten gleichzeitig. Beim Basismodell steckte fast jeder dieser Plätze in einer Schleife fest, bei der Teiler-Frage bis zu 12,6 Minuten lang. Das editierte Modell schreibt immer noch lange Antworten, aber die meisten enden mit einem Ergebnis.
Warum nicht einfach das Limit senken oder den Stream beobachten und eine Schleife abbrechen, wie Qwens Card vorschlägt? Damit scheitert eine Schleife früher, und das spart Zeit auf der Karte. Das haben wir beim Basismodell nicht ausprobiert, ebenso wenig das Ausschalten des Denkens, also teste das, bevor du die Dateien tauschst.
Wo es aufhört zu funktionieren: Es entfernt Schleifen, es fügt kein Können hinzu
Der Edit hat eine schlechte Gewohnheit behoben. Klüger hat er das Modell nicht gemacht, und das sagen die Autoren selbst.
Sie haben denselben Ansatz bei Gemma 3 270M versucht, einem Modell, das selten in Schleifen gerät: Nur 8,5 % seiner Antworten erreichten das Limit. Astra konnte es nicht verbessern. Es blieb auf MATH-500 zwischen 6,8 % und 7,7 %, egal mit welchem Budget. In ihren Worten: „Editing weights could remove an obstacle that hid an ability, but it could not add an ability the model lacked.“ Erwarte also nicht, dass das bei einem Modell funktioniert, dessen Problem keine Schleifen sind.
Auch editiert lief noch ein Fünftel unserer Antworten in eine Schleife, und 3 weitere endeten ohne finale Antwort. Die Antworten sind lang, eine einzelne Antwort braucht allein etwa eine Minute. Und der Sprung kam erst mit dem größten Budget: Mit 10 oder 25 Läufen ließen Astras Edits das Modell bei 12,3 % und 14,1 %.
Auch das Video von AI Search warnt vor dem Hype und erwähnt eine Analyse, die das unveränderte Modell angeblich allein durch geänderte Einstellungen auf etwa 44 % bei MATH-500 brachte. Das Video nennt keine Quelle, und wir haben es nicht geprüft.
Getestet haben wir nur Mathe mit eingeschaltetem Denken. Allgemeinen Chat, das Befolgen von Anweisungen, ausgeschaltetes Denken und Bilder haben wir mit der editierten Datei nicht geprüft. Laut Qwens Card läuft das 0.8B-Modell standardmäßig mit ausgeschaltetem Denken.
Welche GPU: Das editierte Modell kam unter einer emulierten Speichergrenze von 6 GB ans Ziel
Diese Prüfung zeigt, dass das Modell unter jeder Grenze startet und lange Antworten zu Ende bringt. Wir nahmen fünf Aufgaben, die es im Batch schon gelöst hatte, und unter 6 GB lieferte es dieselben fünf richtigen Antworten wie unter 8 GB, in derselben Zeit. Bei 5 GB kam es erst durch, nachdem wir den für parallele Unterhaltungen reservierten Platz von 256 auf 32 reduziert hatten. Bei 4 GB startete es nicht.
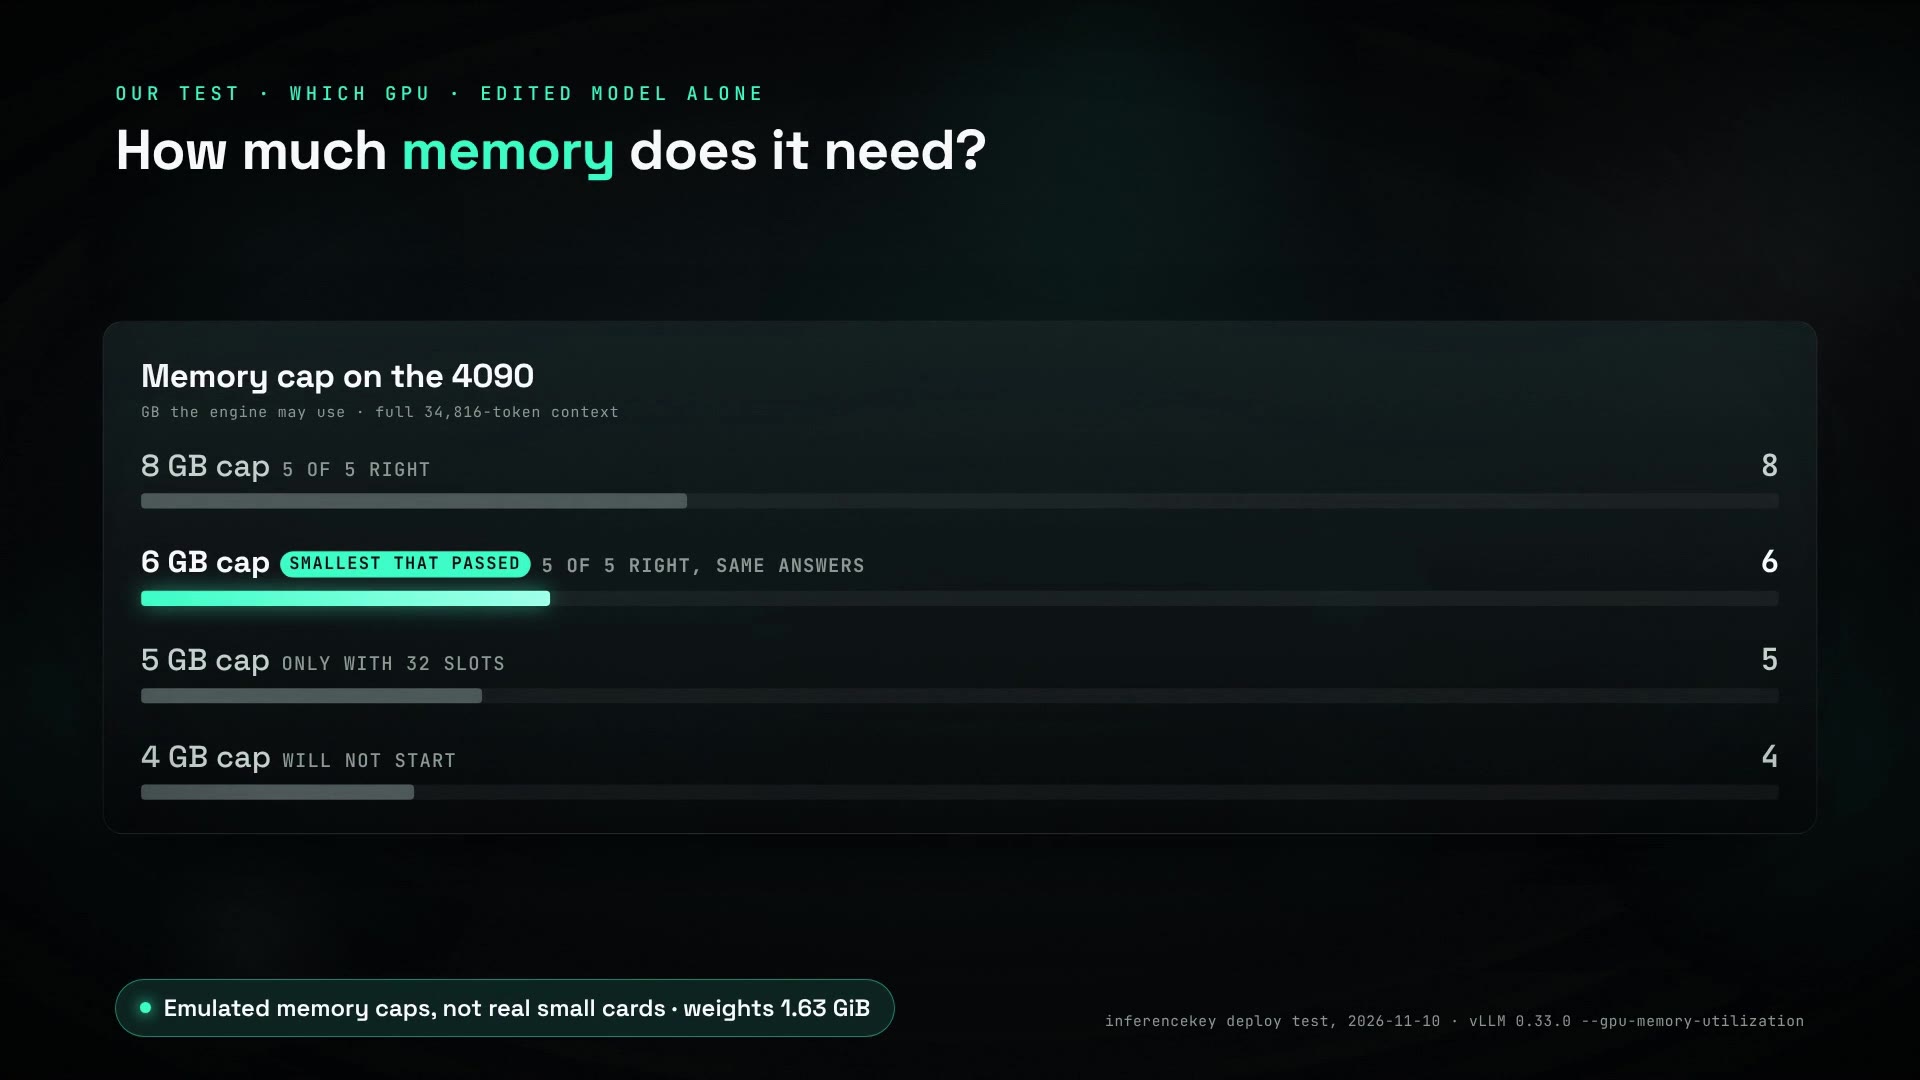
Jede Grenze unter 24 GB war ein Limit, das wir auf der 4090 gesetzt haben. Eine echte Karte mit 6 oder 8 GB haben wir nicht laufen lassen. Eine echte kleine Karte hat außerdem langsameren Speicher, rechne also damit, dass sie langsamer läuft als hier. Die Grenze von 4 GB mit einem kürzeren Antwortlimit oder eine komprimierte Version des Modells haben wir nicht ausprobiert.
Auf InferenceKey: das Basismodell und sein editierter Zwilling auf einer 24-GB-Karte, bereit in 7 Minuten
Eine Karte mit 24 GB hielt das Basismodell und seinen editierten Zwilling gleichzeitig, jedes mit weniger als der halben Karte, mit 16,9 GiB in der Spitze. Beide waren 418 Sekunden, nachdem wir sie angefordert hatten, bereit, von einer kalten Maschine aus. Etwa drei Minuten gingen für die Installation von vLLM drauf und etwa drei weitere für das Aufwärmen der Engine selbst. Sobald diese Installation auf der Maschine lag, war eine neue Engine in etwa einer Minute bereit.
Unsere API kann einige Einstellungen noch nicht pro Anfrage ändern, etwa den Denk-Schalter, deshalb haben wir sie auf dem Server für alle Aufrufer festgelegt.
Ein Problem, auf das du stoßen wirst: Eine über den Endpoint gestreamte Antwort des Basismodells brach nach 152 Sekunden ab, ohne Fehler, den unser Client sehen konnte, und ohne Endmarkierung. Für einen Client sieht eine abgeschnittene Antwort aus wie eine fertige. Wir vermuten den Stille-Timeout der Plattform von zwei Minuten, der einen Fehler schicken würde, den unser Beispielskript ignoriert, aber die Ursache ist nicht bestätigt. Bis dahin: Prüf bei jeder gestreamten Antwort, dass sie ordentlich als beendet markiert ist, bevor du ihr vertraust.
Solltest du es nutzen? Probier es, wenn du Qwen3.5-0.8B mit eingeschaltetem Denken betreibst
- Wenn du Qwen3.5-0.8B schon mit eingeschaltetem Denken betreibst und ihm Mathe schickst: Probier den Tausch. Gleiche Größe, gleiche Lizenz, und es läuft auf derselben Engine.
- Wenn du die beste Mathe aus einem winzigen Modell willst: Sieh es als Reparatur, nicht als Upgrade. Es holt heraus, was das Modell schon wusste, und es schreibt immer noch lange Antworten.
- Wenn du eine GPU dimensionierst: Das Ergebnis mit 6 GB wurde auf einer 24-GB-Karte emuliert, nicht auf einer echten 6-GB-Karte; siehe den Abschnitt zum Speicher.
- Wenn du ein anderes kleines Modell betreibst, das in Schleifen läuft: Das ist eine veröffentlichte Methode mit Logs, kein Produkt. Das Ergebnis mit Gemma zeigt, dass sie nur hilft, wenn Schleifen das Problem sind.
Um denselben Vergleich auf deiner eigenen GPU-Maschine laufen zu lassen, nimm das SDK-Beispiel für den Gewichts-Edit von Qwen3.5-0.8B mit IK_WITH_BASELINE=1. Es braucht eine registrierte NVIDIA-Maschine (einen Worker) mit einer 24-GB-Karte und etwa 15 GB freiem Plattenplatz. Die Zugangsschlüssel und den lokalen SDK-Build findest du in der Schritt-für-Schritt-Anleitung unten. Am Ende löscht es beide Workloads.
Für Ingenieure
Credits
- Qwen-Team: Qwen/Qwen3.5-0.8B, Apache-2.0, einschließlich der Warnung vor Schleifen in der Card.
- Rikiya Takehi, Jayden Teoh (gleicher Beitrag), Alex Zhang, Omar Khattab, MIT CSAIL: die Methode, Experiment 8, der bitgenaue Diff und
apply_edit.py, das den Edit nachbaut und per Hash prüft, sowie die Logs. Blogpost (2. November 2026), Checkpoint, Logs und Diffs. Das editierende Modell ist „GPT-6 Astra“. - akhaliq, mit ML Intern auf HF Jobs (2026-11-02): hat den Edit auf der CPU nachgebaut, per Hash geprüft und den Hugging-Face-Checkpoint samt Card gebaut; der unabhängige vollständige Lauf über MATH-500; der Demo-Space (zuerst veröffentlicht als
akhaliq/weight-space-programming-demo, Gradio auf ZeroGPU). - AI Search: wo wir es entdeckt haben, Video 9RIK3A24ZxA, Abschnitt 12:01 bis 16:59.
- Prüfung: Das Log-Repository der Autoren enthält den genauen Diff zum Basismodell und
apply_edit.py, das den sha256 jedes nachgebauten Tensors prüft; akhaliq hat damit den Checkpoint nachgebaut und geprüft. - Unser Teil: beide Modelle auf einer Karte über InferenceKey bereitgestellt (die Tensor-Hashes haben wir nicht nachgerechnet; die Datei lief so, wie sie veröffentlicht wurde), der Vergleich auf 50 Aufgaben, die Aufnahmen über die Endpoints, die Speicherleiter, das SDK-Beispiel.
Modell und Edit
| Punkt | Wert |
|---|---|
| Editiertes Repo | RikiyaT/Qwen3.5-0.8B-weight-space-programming, sha d1671a178705bcab7644806d23c535517f35723b, Apache-2.0, ein bf16-Shard mit 1.746.943.032 Bytes (1,75 GB, 1,63 GiB) |
| Basis-Repo | Qwen/Qwen3.5-0.8B, sha 2fc06364715b967f1860aea9cf38778875588b17, Apache-2.0, Shard mit 1.746.942.600 Bytes |
generation_config.json | in keinem der beiden Repos enthalten |
| Architektur | Qwen3_5ForConditionalGeneration (vollständiges multimodales Release). Der Post hat einen reinen Text-Export evaluiert, die LM-Tensoren sind hash-identisch, und Text-Prompts nutzen den Vision-Tower nicht |
| Geänderte Tensoren | model.language_model.layers.15.mlp.down_proj.weight sha256 82e2d733ea64feaeb4af93a1e065641d3df98b494a8b7576ef2f52e90fe2ee53; model.language_model.layers.19.mlp.down_proj.weight sha256 8ef3c61bc36af113ad58e89dbb0a4a14dcba5a45cb750c15ab515c82ddd12eb2 (rohe bf16-Bytes) |
| Form | jeweils [1024, 3584] bf16, 64 geänderte Spalten, 131.072 berührte Gewichte (0,016 %) |
Manifest (exp8_math/runs/p50c/edit/manifest.json) | geänderte Einträge 65.260 (Schicht 15) und 64.928 (Schicht 19), zusammen 130.188 (berührte Einträge, die auf denselben bf16-Wert zurückgerundet werden, zählen nicht); relative Änderung 0,106 und 0,081 |
| Nachbau | exp8_math/code/apply_edit.py prüft jeden nachgebauten Tensor per sha256 gegen den im Post evaluierten Checkpoint |
| Lizenz der Logs | die Card sagt CC BY 4.0 / MIT; GitHub meldet NOASSERTION |
Experiment 8: Astra führte die Schleifen auf eine Richtung zurück, die von den MLPs der Schichten 15 und 19 geschrieben wird, und zog sie in jeder der beiden Schichten von 64 Ausgabespalten von down_proj ab. Harness: ein Python-Kernel über den Gewichten (keine GPU für Astra), Übungsaufgaben (7.469 Trainingsaufgaben aus GSM8K und 7.275 aus MATH, keine Testsätze), ein Budget von 10, 25 oder 50 Forward-Passes (ein Pass: bis zu 512 beantwortete Aufgaben oder 1.024 gelesene Texte). Evaluation: Denken an, bis zu 32.768 Tokens, Temperature 0,6, top-p 0,95, top-k 20, Presence Penalty 1,5. MATH-500 mittelt über 4 Samples, GSM8K und IFEval über 2.
Angaben der Autoren (von uns nicht reproduziert, außer MATH-500 auf 50 Aufgaben)
| MATH-500 | GSM8K | IFEval | Tokenlimit erreicht | |
|---|---|---|---|---|
| Basis | 7,9 | 13,8 | 21,0 | 93,0 % |
| Editiert, 10 Passes | 12,3 | 25,7 | 49,0 | 87,2 % |
| Editiert, 25 Passes | 14,1 | 25,1 | 39,9 | 86,4 % |
| Editiert, 50 Passes (der veröffentlichte Checkpoint) | 48,1 | 67,1 | 62,3 | 33,1 % |
Gemma 3 270M: Basis 6,8 % auf MATH-500, editiert 7,0 / 7,6 / 7,7 / 7,0 % mit 5 / 10 / 25 / 50 Passes, 8,5 % der Basisantworten erreichten das Limit.
Unabhängiger Lauf (akhaliq, 2026-11-02): vollständiges MATH-500, 500 x 4 = 2.000 Generierungen, 43.407.495 Tokens, 3.059 s auf einer H200, vLLM 0.33.0, transformers 5.20.2, math-verify 0.9.0, Seed 0: 51,0 % richtig, 31,6 % am Limit, 14.190,9 Tokens/s, Mittelwert 21.704 Tokens. Smoke-Test des Basismodells, 25 Aufgaben x 4: 5,0 % richtig, 95 % am Limit, Mittelwert 31.690 Tokens.
Die Model Card nennt keine Mindestversion von vLLM. Der Lauf von akhaliq nutzte 0.33.0, wir ebenfalls. Keine andere Version wurde getestet.
Setup
- Eine RTX 4090 24 GB auf InferenceKey Cloud (Treiber 595.91.07, CUDA 13.2), beide Modelle auf derselben Karte.
- Lokaler InferenceKey-Manager, gebaut aus
origin/maineb1ee503, eingebautes Backendvllm,vllm_version="0.33.0". Produktion nie angefasst. - Serving-Befehl, pro Workload:
vllm serve <model> --dtype bfloat16 --max-model-len 34816 \
  --gpu-memory-utilization 0.45 \
  --default-chat-template-kwargs '{"enable_thinking": true}' \
  --override-generation-config '{"temperature": 0.6, "top_p": 0.95, "top_k": 20, "presence_penalty": 1.5}'
Nimm --gpu-memory-utilization 0.90, wenn das editierte Modell allein läuft. Das vLLM-Log bestätigt den Override: „Default vLLM sampling parameters have been overridden ... {'presence_penalty': 1.5, 'temperature': 0.6, 'top_k': 20, 'top_p': 0.95}“.
Warum auf dem Server: Bei eb1ee503 leitet ChatSampling des Managers (crates/shared/src/models.rs) temperature, max_tokens, top_p, stop, presence_penalty, frequency_penalty und seed weiter. top_k und chat_template_kwargs werden nicht weitergeleitet, und generate_text() des SDK hat weder presence_penalty noch top_k.
Schritt für Schritt mit dem SDK-Beispiel
Ordner: examples/qwen3-5-0-8b-weight-edit-math-vllm-private-nvidia (Commit 7661793, plus 07215bb).
- Bau das SDK lokal mit maturin und installier die
requirements.txtdes Beispiels. - Kopier
.env.examplenach.envund trag einik_sdk_-Token ein, einenik_live_-API-Key mit Scope<project>/*, den Projekt-Slug undIK_WORKER_ID(ein registrierter NVIDIA-Worker mit etwa 15 GB freiem Plattenplatz). - Optional:
IK_WITH_BASELINE=1deployt das Basismodell neben dem editierten (je 0,45 der Karte),IK_MAX_TOKENS(Standard 32.768),IK_KEEP_ALIVE=1behält die Workloads nach dem Lauf. python main.py. Es ruftensure()für jeden Workload auf, dannwait_until_ready(), streamt MATH-500test/number_theory/572(Teiler von 196, Antwort 9) von jedem Endpoint über einfaches HTTP, gibt Tokens, Zeit und die Antwort in der Box aus und löscht die Workloads, außer beiIK_KEEP_ALIVE=1.- Für ein Budget von 5 GB füg dem Befehl
--max-num-seqs 32hinzu (im Beispiel dokumentiert).
Zeiten
| Schritt | Editiert | Basis |
|---|---|---|
ensure() bis bereit, kalter Worker | 418,1 s | 418,2 s |
pip install vllm==0.33.0 | etwa 3 min (gemeinsam) | |
| Laden der Gewichte (vorab heruntergeladen) | 0,29 bis 0,32 s | |
| Engine-Init (Profiling, KV-Cache, Aufwärmen) | 181,7 s | 186,0 s |
| davon torch.compile | 17,3 bis 17,7 s | |
| CUDA-Graphen | 8 bis 9 s | |
| Warme Engines der Leiter, einzeln | 60 bis 63 s (133 s für die 5-GB-Stufe) |
MATH-500, 50 Aufgaben pro Modell
Die ersten 50 Aufgaben-IDs in der Reihenfolge von akhaliqs Lauf-Datei eval/scores_edited_math500.json (im HF-Checkpoint), 1 Sample, Seed 0, maximal 32.768 neue Tokens, alle 50 pro Modell gleichzeitig in Arbeit, beide Modelle zugleich, Anfragen direkt an die zwei vLLM-Server, die die Plattform gestartet hatte. Bewertet mit mathqa.py der Autoren (letztes \boxed{} der gesamten Ausgabe) und math-verify 0.9.0; aus den bewerteten Dateien neu berechnet, identisch.
| Editiert | Basis | |
|---|---|---|
| Richtig | 31/50 (62 %) | 4/50 (8 %) |
| 32.768 Tokens erreicht | 10 (20 %) | 48 (96 %) |
| Beendet ohne Box | 3 | 0 |
| Mittel / Maximum Tokens | 20.444 / 32.768 | 31.832 / 32.768 |
| Median-Tokens der beendeten Antworten | 17.477 (40 beendet) | 9.377 (2 beendet, beide richtig; die anderen 2 richtigen Antworten wurden am Limit abgeschnitten, nachdem sie die richtige Antwort in die Box gesetzt hatten) |
| Tokens gesamt / Laufzeit | 1.022.176 in 986,7 s | 1.591.617 in 1.194,4 s |
| Tokens pro richtiger Antwort | etwa 33.000 | etwa 398.000 |
| Nach Gebiet | Algebra 10/12, Zahlentheorie 5/7, Präalgebra 4/7, Präkalkül 4/7, Geometrie 3/5, fortgeschrittene Algebra 3/8, Kombinatorik 2/4 | Präalgebra 2/7, Algebra 2/12, andere 0 |
| Lauf von akhaliq | dieselben 50: 54 % (Mittel über 4 Samples); unser Richtig/Falsch mit 1 Sample stimmt bei 42/50 mit seiner Mehrheit überein | Smoke-Test des Basismodells, 25 Aufgaben x 4: 5 % (95 % abgeschnitten) |
Durchsatz: eine Anfrage allein 300 bis 380 Tokens/s; zwei gleichzeitig über die Endpoints etwa 175 Tokens/s pro Anfrage; 3.100 bis 4.300 Tokens/s pro Engine zu Beginn mit 50 laufenden Anfragen, fallend, während sich der KV-Cache füllte. Gesamt über den Lauf: etwa 1.036 Tokens/s editiert gegenüber 1.333 Basis, kein fairer Vergleich: Die beiden Engines starteten im selben Moment, und die editierte bekam die Hälfte des Arbeitsspeichers, also begann sie früher, Anfragen in die Warteschlange zu stellen. Details: KV-Cache aufgeteilt in Basis 6,48 GiB (517.266 Tokens) gegenüber editiert 3,32 GiB (265.098 Tokens) bei derselben Einstellung 0,45, weil beide Engines den Speicher im selben Moment profilierten, sodass die editierte Engine Anfragen in die Warteschlange stellte (99 % KV, 22 laufend, 21 wartend zu einem Zeitpunkt). Der ganze Lauf mit 100 Aufgaben (2,61 M Tokens) dauerte 1.194 s.
Aufgabe 572 (Teiler von 196)
- Über die Endpoints der Plattform, beide gleichzeitig, aufgezeichnet: editiert
\boxed{9}in 14.518 Tokens, 87 s. Basis 32.768 Tokens nach 138 s, keine Antwort, die letzten Zeilen wiederholen „Wait, $14 \times 14 = 196$.“ - Batch-Lauf: editiert 17.077 Tokens, beendet, richtig, etwa 287 s mit 50 gleichzeitig in Arbeit. Basis 32.768 Tokens, abgeschnitten, zählt „Let's check 3309. $3309 \times 2 = 6618$. No.“ aufwärts, etwa 757 s. Das ist das Bild des Schlüsselvergleichs.
GPU-Speicher und VRAM-Leiter
Gewichte 1,63 GiB pro Modell. Spitze der Karte 17.282 MiB (16,9 GiB) mit beiden Engines bei 0,45, 100 % Auslastung, 286 W. Editierte Engine allein bei 0,45, im Leerlauf: 6.846 MiB.
Leiter: editiertes Modell allein, derselbe Befehl, --max-model-len 34816, 5 Aufgaben, die das editierte Modell im Batch gelöst hatte (572, 515, 807, 2584, 248), gleichzeitig in Arbeit, maximal 32.768. Jede Stufe unter 24 GB ist eine Grenze, die mit --gpu-memory-utilization auf der 4090 gesetzt wurde, keine echte Karte.
| GPU oder Grenze | Konfiguration | KV-Cache | Ergebnis | Echt oder emuliert |
|---|---|---|---|---|
| RTX 4090 24 GB | beide Modelle, je 0,45, je 50 Aufgaben | 6,48 / 3,32 GiB | 62 % gegen 8 % richtig, Spitze 16,9 GiB | echt |
| Grenze 8 GB | 0,333 | 4,3 GiB (343.186 Tokens) | 5/5 richtig, 25 bis 96 s pro Antwort, längste 31.606 Tokens in 95,5 s | emuliert |
| Grenze 6 GB | 0,245 | 2,23 GiB (177.561 Tokens) | 5/5 richtig, identische Ausgaben und Zeiten wie bei 8 GB (95,7 s) | emuliert |
| Grenze 5 GB | 0,204, Standard-max_num_seqs 256 | scheitert: max_num_seqs (256) exceeds available Mamba cache blocks (202) | emuliert | |
| Grenze 5 GB | 0,204, --max-num-seqs 32 | 1,74 GiB (138.766 Tokens) | 5/5 richtig (andere Texte, andere Batch-Formen), längste 30.948 Tokens in 97 s | emuliert |
| Grenze 4 GB | 0,163 | 0,29 GiB | scheitert: braucht 0,44 GiB KV-Cache für eine Anfrage mit 34.816 Tokens; vLLM schlägt maximal 22.304 Tokens vor | emuliert |
| Grenze 3 GB | 0,122 | -0,66 GiB | scheitert: kein verfügbarer Speicher für die Cache-Blöcke | emuliert |
Nicht versucht: eine echte kleine Karte (an dem Tag war nichts unter 16 GB verfügbar, die RTX 2000 Ada mit 16 GB haben wir nicht ausprobiert), 4 GB mit kürzerem Kontext, fp8, mehr als 50 gleichzeitige Anfragen, der Vision-Pfad. Echte Karten mit 6 bis 8 GB haben weniger Speicherbandbreite: Rechne damit, dass sie langsamer sind als diese Zeiten.
Offene Probleme
- Stilles Ende einer gestreamten Basisantwort (offen). Über den Endpoint, während der KV-Cache der Basis-Engine gesättigt war, schloss sich der Stream nach 152,3 s mit 3.286 Zeichen, ohne
finish_reason, ohneusage. Ursache nicht bestätigt, rohes SSE nicht mitgeschnitten. Beieb1ee503nutzt der GPU-Stream-Pfad des ManagersSTREAM_IDLE_TIMEOUT_MS = 120_000und sendet beim Timeout einen Chunk{"error":{"code":"inference_timeout",...}}, gefolgt von[DONE]. Dasask()des Beispiels liest nurchoicesundusage, also würde der Client einen solchen Chunk stillschweigend ignorieren; das Beispiel braucht noch einen Fix, der ihn sichtbar macht. Prüf in deinem eigenen Client auf einenerror-Schlüssel und einenfinish_reason. - Gleichzeitiges pip in dasselbe venv (offen). Zwei Workloads mit derselben
vllm_versionführtenpip install vllm==0.33.0gleichzeitig im selben venv aus. Hier hat es funktioniert. Es ist eine Race Condition. - Ungleiche KV-Aufteilung (Workaround). Zwei Engines, die zusammen auf einer Karte starten, profilieren den Speicher gleichzeitig, und die zweite sieht weniger freien Speicher. Starte sie nacheinander.
- 5 GB braucht
--max-num-seqs 32(im Beispiel dokumentiert). - Das Modell: 20 % der editierten Antworten laufen weiterhin bis 32.768 Tokens, und 3 endeten ohne Box. Ein früher Lauf des Beispiels mit einem Standard von 16.384 Tokens schnitt die editierte Antwort ab, deshalb ist der Standard jetzt 32.768.
- Kleinigkeit:
min_disk_gb60 in der Anfrage zum Anlegen des Workers wurde ignoriert (100 GB vergeben). Der erste Start des nats-proxy im lokalen Stack scheiterte an einem fehlendenJWT_SECRET. - Bewertung:
mcqa.pyder Autoren ist nicht veröffentlicht. Ein Stub deckte einen Import ab, der nur in den Schleifenstatistiken genutzt wird; der Bewertungscode blieb unangetastet. - Von uns nicht geprüft: GSM8K, IFEval; die Erwähnung im Video von AI Search von etwa 44 % für das unveränderte Modell mit anderen Einstellungen (keine Quelle genannt).
Demovideo
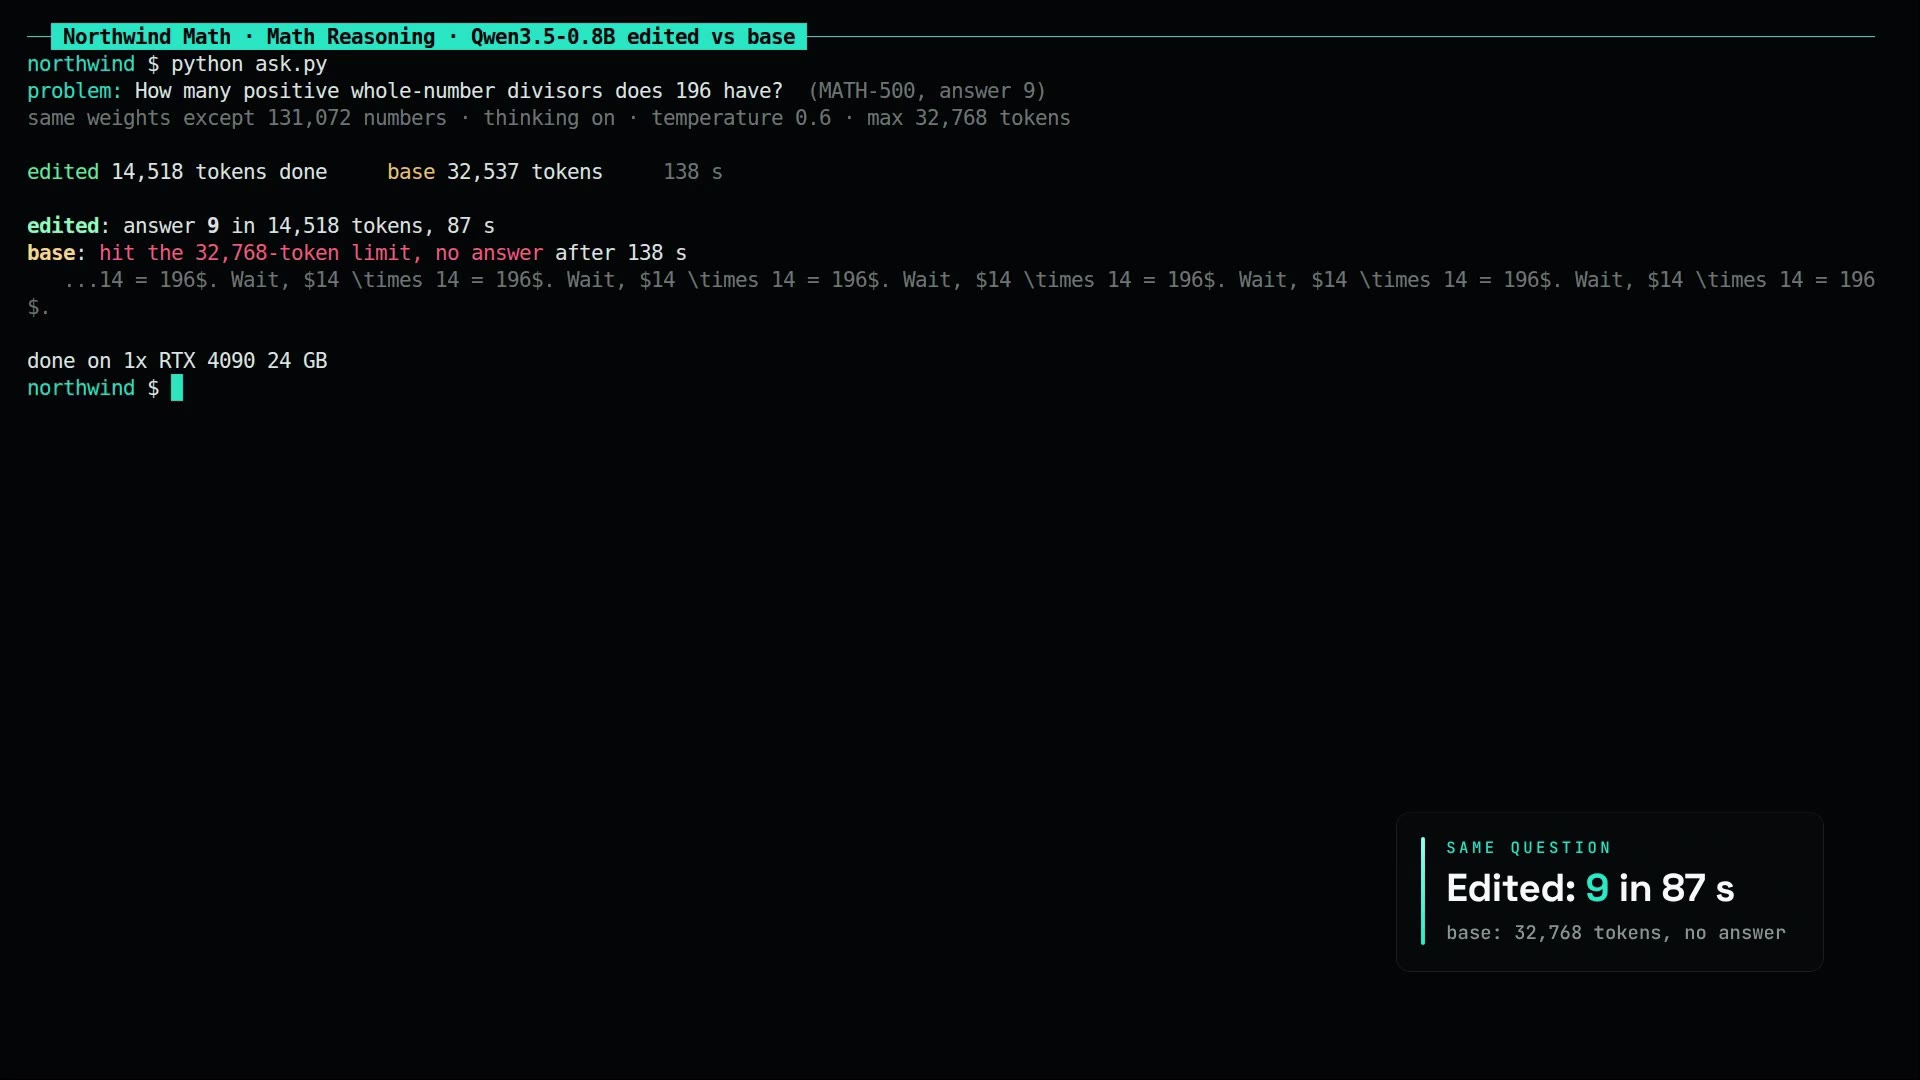
176,6 s, vertont: der Blog der Autoren mit Credits, Qwens Warnung vor Schleifen, die Zahlen der Autoren und unsere, die beiden Modelle, die die Teiler-Frage über die Endpoints beantworten, und die Speichergrenzen.
Quellen
- Blog: Sparks of Weight-Space Programming, Takehi, Teoh, Zhang, Khattab (MIT CSAIL), 2. November 2026.
- Editierter Checkpoint und Card, samt Lauf und Hashes: RikiyaT/Qwen3.5-0.8B-weight-space-programming.
- Basismodell und Warnung vor Schleifen: Qwen/Qwen3.5-0.8B.
- Logs, Diffs und
apply_edit.py: RikiyaT/lm_understand-logs. - Demo-Space: ML-Intern-lab/weight-space-programming-demo (früher
akhaliq/weight-space-programming-demo). - Wo wir es entdeckt haben: AI Search, 8. November 2026.
- Unser Beispiel: inferencekey-sdk, qwen3-5-0-8b-weight-edit-math-vllm-private-nvidia.