Qwen3.5-0.8B : une IA a modifié 0,016 % de ses poids, et les boucles de réflexion sont passées de 93 % à environ 32 %
Aucun entraînement, deux couches modifiées. Réponses coupées à la limite : de 93 % à environ 32 %. Sur nos 50 problèmes : 62 % justes contre 8 %.
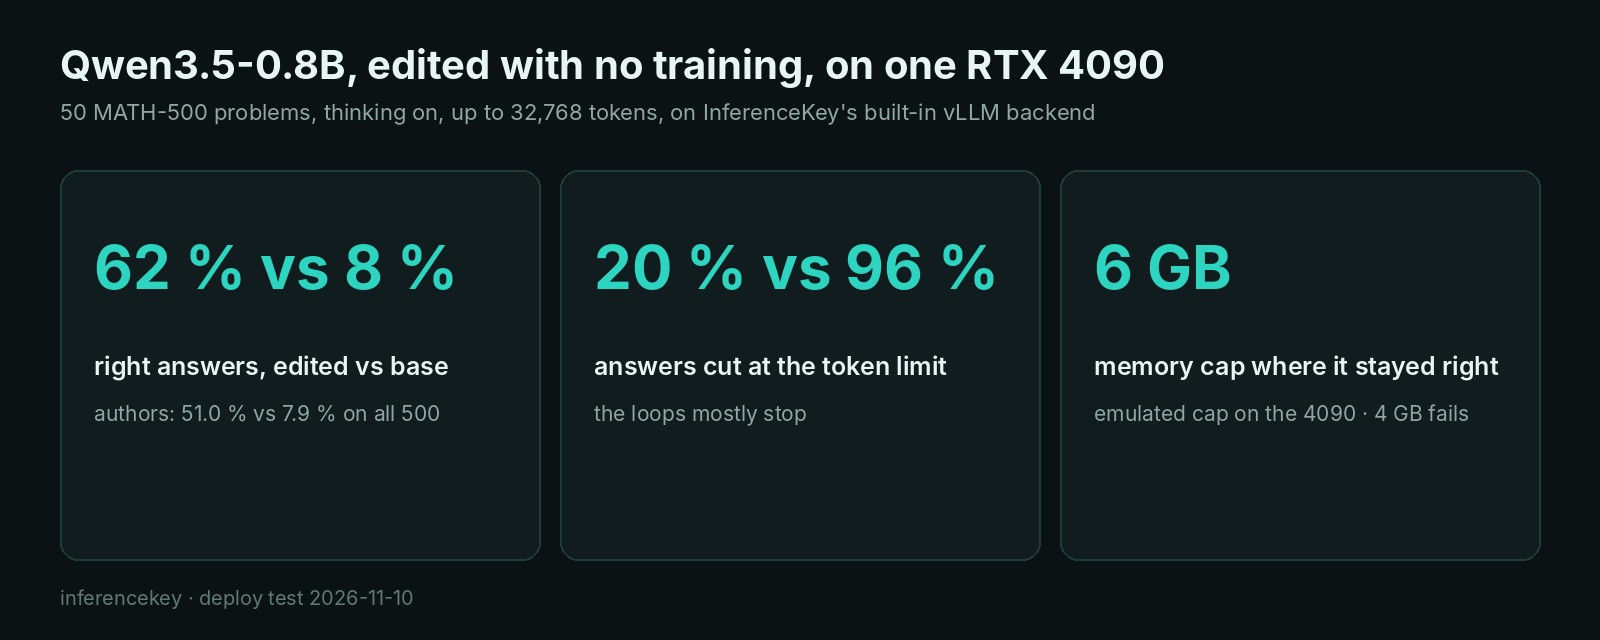
Une autre IA a changé 64 colonnes de nombres à deux endroits de Qwen3.5-0.8B, un petit modèle de raisonnement ouvert, et elle l'a fait sans le moindre entraînement. Nous avons fait tourner le modèle modifié et l'original côte à côte sur une RTX 4090 de notre cloud, sur les mêmes 50 problèmes de maths avec les mêmes réglages. Le modèle modifié a eu 62 % de bonnes réponses. L'original, 8 %, parce que 96 % de ses réponses ne se terminaient jamais : il tournait en rond dans sa réflexion jusqu'à la limite de 32 768 tokens (des morceaux de mots). Si vous servez de petits modèles de raisonnement sur vos propres GPU, c'est une histoire de coût autant que de précision. Une réponse qui ne finit jamais occupe une place sur votre carte jusqu'à ce que la limite la coupe, et le plus souvent elle ne donne aucune réponse. Le fichier modifié se charge et se sert avec la même commande que le modèle de base. Nous n'avons vérifié que les maths, avec la réflexion activée.
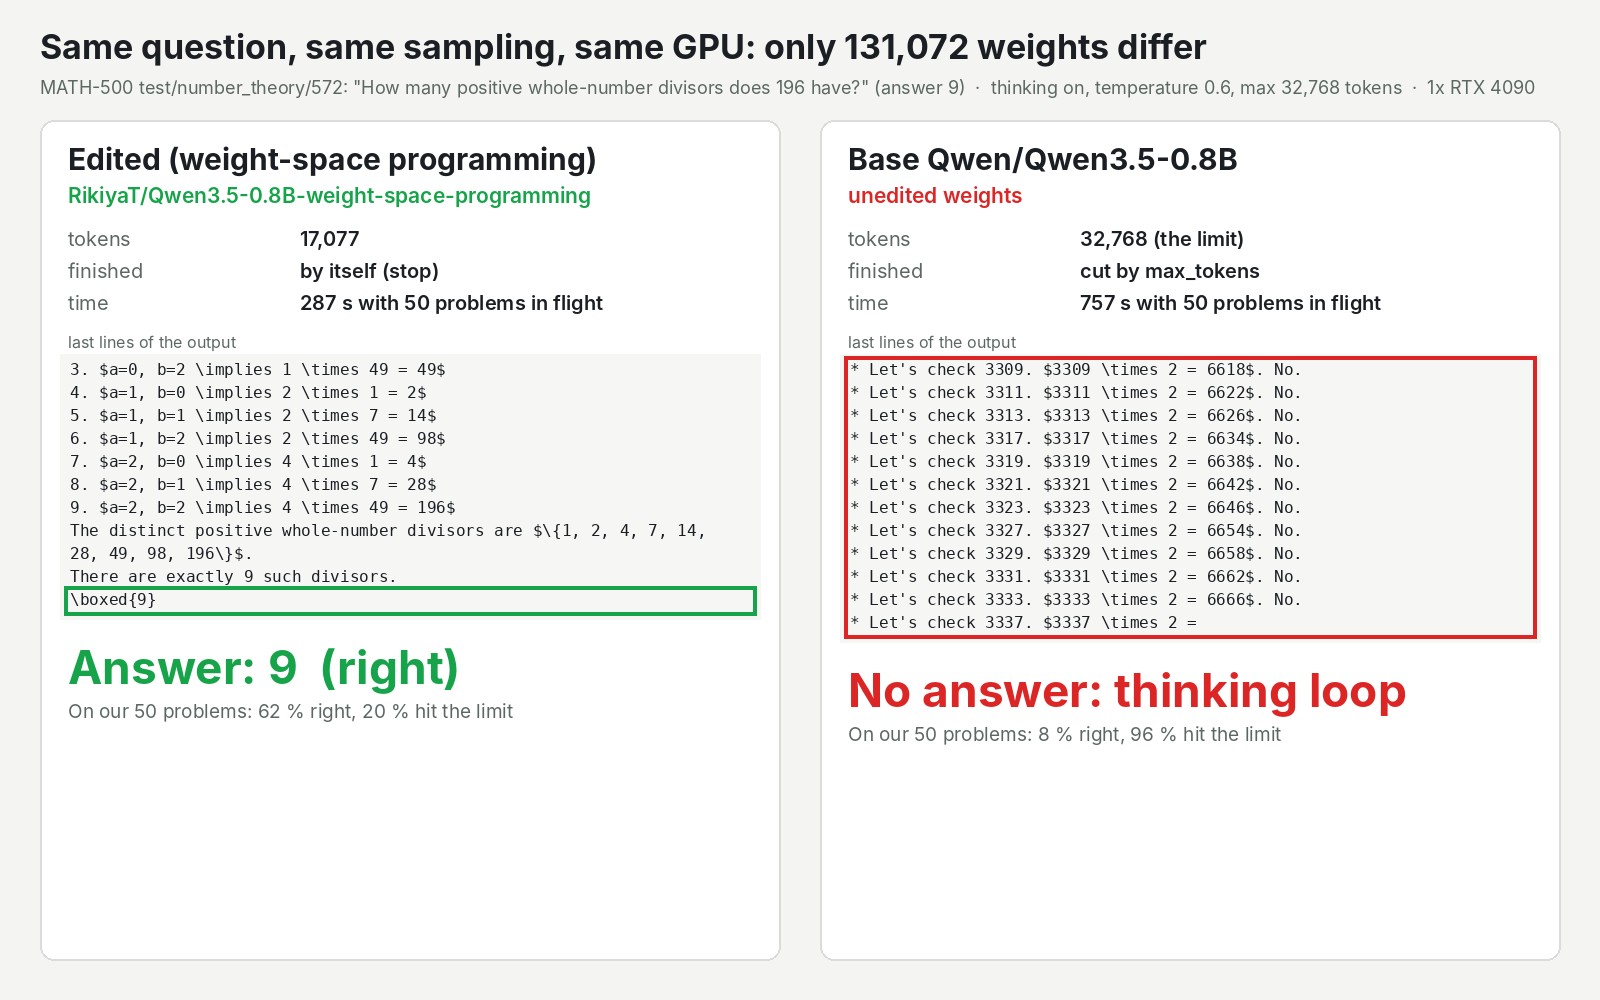
La question de l'image est simple : combien de diviseurs a 196 ? La réponse est 9. Le modèle modifié l'a trouvée et s'est arrêté. Le modèle de base s'est mis à énumérer des nombres au-delà de 3 300, un par un, et continuait encore quand la limite l'a coupé.
| Sur nos 50 problèmes de maths de compétition (MATH-500) | Modifié | Base |
|---|---|---|
| Bonnes réponses | 62 % | 8 % |
| Réponses coupées à la limite de 32 768 tokens | 20 % | 96 % |
| Tokens moyens par réponse | 20 444 | 31 832 |
Un modèle qui ne trouve pas la fin, et une modification qui la lui donne
La modification fait une seule chose : elle supprime l'habitude qui faisait boucler le modèle. Les maths que le modèle réussit, il les savait déjà.
Qwen3.5-0.8B fait partie de la famille Qwen3.5, avec environ 0,8 milliard de nombres appris (les poids). Avant de répondre, un modèle de raisonnement écrit un brouillon : il réfléchit à voix haute, puis donne le résultat. La propre page du modèle chez Qwen prévient que cette taille est "more prone to entering thinking loops" que ses grands frères. Imaginez un groupe qui n'arrive pas à trouver la fin d'un morceau. Tout le monde joue encore juste, mais l'outro tourne en boucle jusqu'à ce que l'ingé son coupe le courant. Sur un GPU, l'ingé son, c'est la limite de tokens, et chaque token que le modèle écrit prend du temps sur la carte.
Le 2 novembre 2026, une équipe du MIT CSAIL a publié un billet de blog sur ce qu'elle appelle la programmation dans l'espace des poids. Dans une de leurs expériences, un grand modèle qu'ils appellent GPT-6 Astra reçoit un outil pour inspecter et modifier les nombres du petit modèle. Il reçoit aussi des problèmes d'entraînement, aucun tiré du test sur lequel il est noté. Son budget est un nombre d'exécutions d'essai du petit modèle : 10, 25 ou 50. Astra observe ce que fait le modèle, lit ses rouages internes et modifie directement les nombres. Aucun entraînement d'aucune sorte.
Sur les 96 premières réponses d'essai du modèle de base, 85 sont allées jusqu'à la limite de 32 768 tokens. Avec 50 exécutions, Astra a trouvé le motif derrière les boucles à deux endroits du modèle, et l'a effacé de 64 colonnes de nombres à chacun. Cela fait 131 072 poids sur l'ensemble du modèle : 0,016 %. Sur MATH-500, un jeu standard de 500 problèmes de maths de compétition, les auteurs annoncent un bond de 7,9 % à 48,1 % de bonnes réponses. La part de réponses coupées à la limite est tombée de 93 % à 33,1 %. Ils annoncent des bonds similaires sur deux autres tests, que nous n'avons pas refaits (voir l'annexe).
Les auteurs ont publié la modification exacte et un script qui la reconstruit. L'utilisateur Hugging Face akhaliq a reconstruit le fichier du modèle modifié, l'a relancé sur les 500 problèmes et a mis en ligne une démo publique. Sa réexécution a obtenu 51,0 % de bonnes réponses, avec 31,6 % des réponses coupées à la limite. Nous avons repéré l'histoire dans la vidéo d'actualité d'AI Search du 8 novembre.
62 % de bonnes réponses contre 8 % sur une RTX 4090, et les boucles tombent de 96 % à 20 %
Avec les réglages d'évaluation des auteurs, le fichier modifié a arrêté la plupart de ses boucles sur notre matériel et a eu presque huit fois plus de bonnes réponses.
Les deux modèles ont tourné côte à côte sur une seule RTX 4090 de 24 GB de notre cloud, chacun derrière son propre endpoint d'API. Les deux utilisaient vLLM, le moteur de service open source utilisé par la réexécution d'akhaliq, avec le brouillon de réflexion activé et les réglages d'aléatoire des auteurs.
Les questions étaient les 50 premiers problèmes de MATH-500 dans l'ordre de la réexécution d'akhaliq, un essai chacun, jusqu'à 32 768 tokens par réponse. Les 50 tournaient en même temps pour chaque modèle, et les deux modèles en même temps. Nous les avons notées avec le propre script de notation des auteurs.
| Modifié | Base | |
|---|---|---|
| Justes | 31 sur 50 (62 %) | 4 sur 50 (8 %) |
| Coupées à 32 768 tokens | 10 (20 %) | 48 (96 %) |
| Tokens moyens par réponse | 20 444 | 31 832 |
Nos 62 % sont au-dessus des deux chiffres publiés. C'est la petite taille de l'échantillon qui parle : sur ces 50 problèmes, la réexécution d'akhaliq faisait 54 % en moyenne, et nos réponses concordaient avec son résultat habituel sur 42 des 50. Les 8 % et 96 % du modèle de base tombent pile sur les chiffres des auteurs.
Les deux fois où le modèle de base a terminé une réponse, elle était juste. Ses 2 autres bonnes réponses venaient de boucles qui avaient écrit le bon nombre avant que la limite les coupe.
L'économie : 1,02 million de tokens au lieu de 1,59 million pour les mêmes 50 problèmes
Sur les mêmes 50 problèmes, le modèle modifié a fait en moyenne 20 444 tokens par réponse et le modèle de base 31 832, et 20 % des réponses modifiées ont été coupées à la limite contre 96 %. Par bonne réponse : environ 5 minutes de temps de batch contre 32 secondes (398 000 tokens contre 33 000). Cet écart repose sur seulement 4 bonnes réponses du modèle de base, donc prenez-le comme un ordre de grandeur.
Un GPU sert un nombre fixe de réponses à la fois. Avec le modèle de base, presque chacune de ces places restait coincée dans une boucle, jusqu'à 12,6 minutes sur la question des diviseurs. Le modèle modifié écrit toujours de longues réponses, mais la plupart se terminent avec un résultat.
Pourquoi ne pas simplement baisser la limite, ou surveiller le flux et arrêter une boucle, comme le suggère la page de Qwen ? Cela fait échouer une boucle plus tôt et économise du temps de carte. Nous ne l'avons pas essayé, pas plus que la réflexion désactivée, sur le modèle de base, donc testez cela avant de changer de fichier.
Là où ça s'arrête : ça supprime les boucles, ça n'ajoute pas de compétence
La modification a corrigé une mauvaise habitude. Elle n'a pas rendu le modèle plus intelligent, et les auteurs le disent eux-mêmes.
Ils ont essayé la même approche sur Gemma 3 270M, un modèle qui boucle rarement : seulement 8,5 % de ses réponses atteignent la limite. Astra n'a pas réussi à l'améliorer. Il est resté entre 6,8 % et 7,7 % sur MATH-500 quel que soit le budget. Dans leurs mots : "Editing weights could remove an obstacle that hid an ability, but it could not add an ability the model lacked." N'attendez donc pas que cela marche sur un modèle dont le problème n'est pas les boucles.
Même modifié, un cinquième de nos réponses bouclait encore, et 3 autres se sont terminées sans réponse finale. Les réponses sont longues, donc une seule réponse prend environ une minute à elle seule. Et le bond n'est venu qu'avec le plus gros budget : avec 10 ou 25 exécutions, les modifications d'Astra laissaient le modèle à 12,3 % et 14,1 %.
La vidéo d'AI Search met aussi en garde contre l'emballement, et mentionne une analyse qui aurait amené le modèle non modifié à environ 44 % sur MATH-500 rien qu'en changeant les réglages. La vidéo ne cite aucune source, et nous ne l'avons pas vérifié.
Nous n'avons testé que les maths avec la réflexion activée. Nous n'avons pas vérifié la conversation générale, le suivi d'instructions, la réflexion désactivée ni les images sur le fichier modifié. La page de Qwen indique que le modèle 0.8B tourne par défaut avec la réflexion désactivée.
Quel GPU : le modèle modifié a terminé sous un plafond mémoire émulé de 6 GB
Cette vérification montre que le modèle démarre et termine de longues réponses sous chaque plafond. Nous avons utilisé cinq problèmes qu'il avait déjà résolus dans le batch, et il a donné les mêmes cinq bonnes réponses sous 6 GB que sous 8 GB, dans le même temps. À 5 GB, il n'est passé qu'après avoir réduit de 256 à 32 la place réservée aux conversations en parallèle. À 4 GB, il n'a pas démarré.
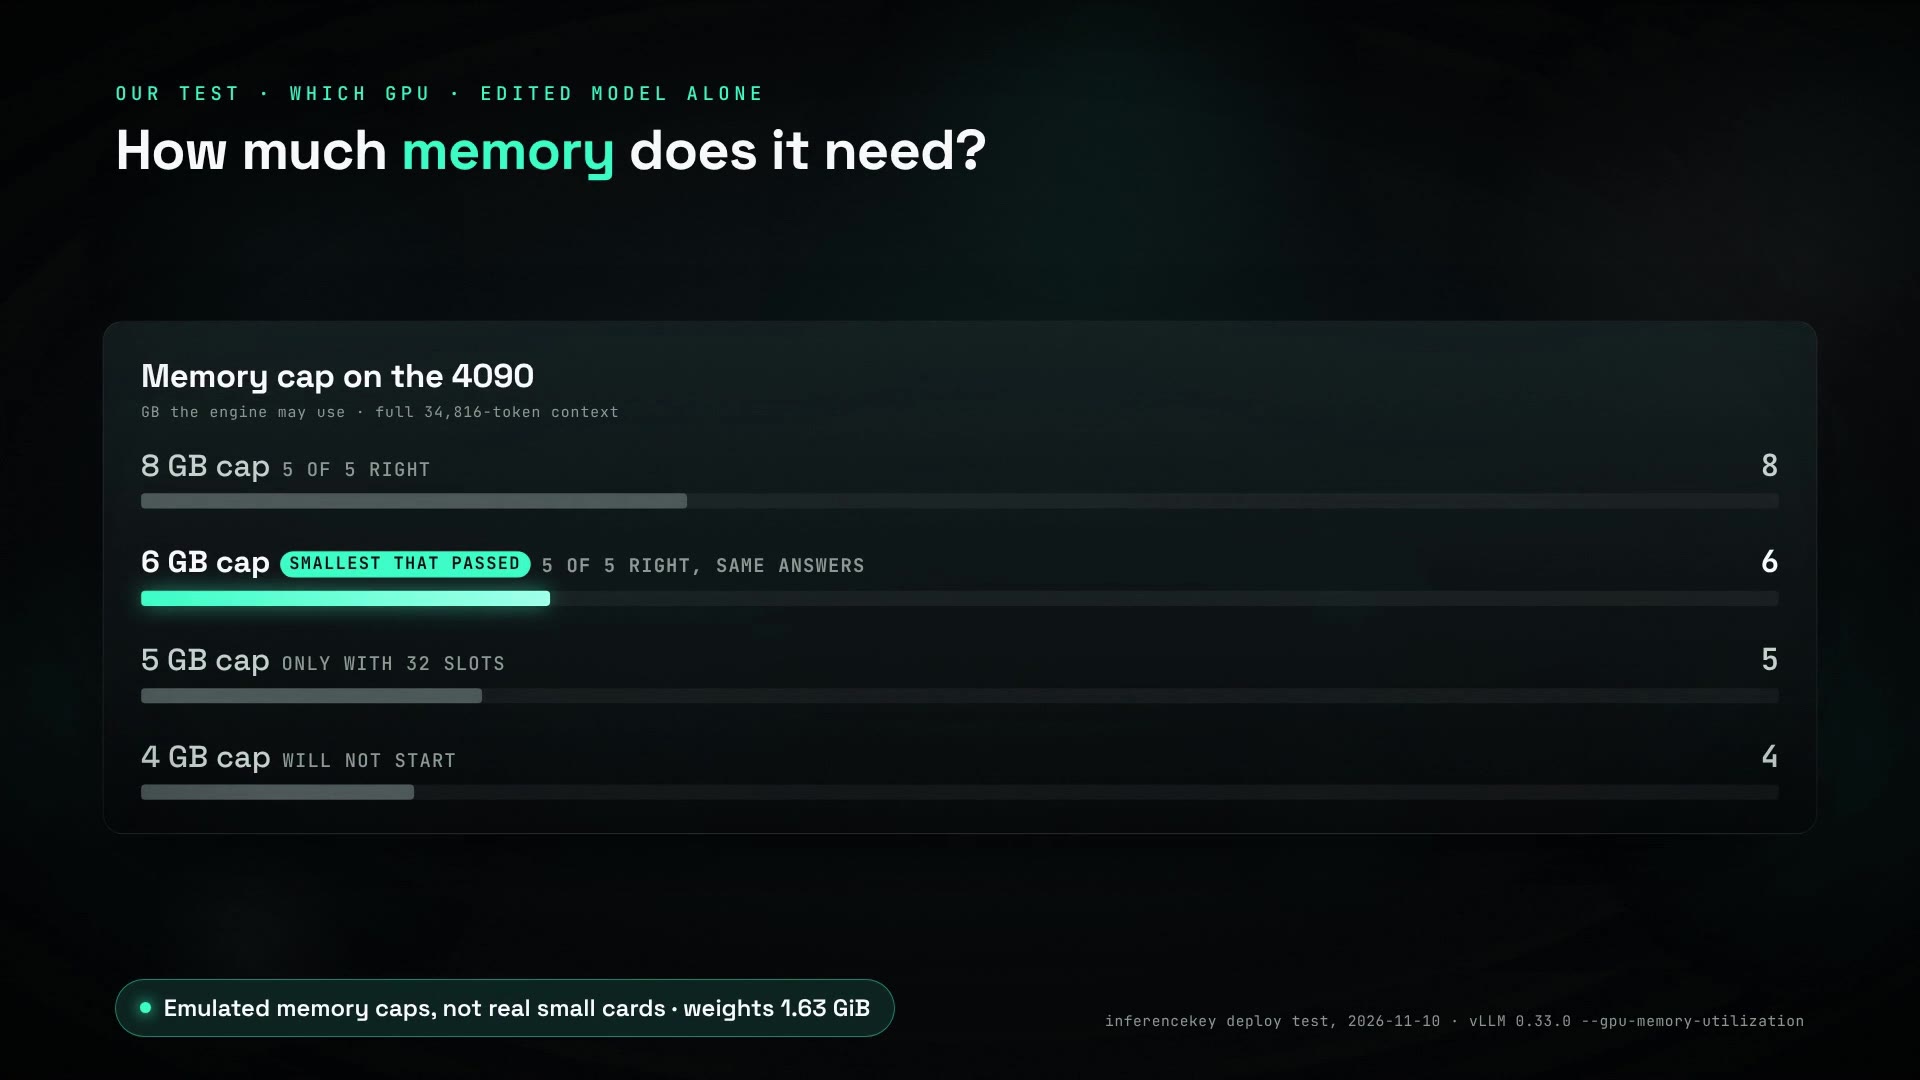
Chaque plafond sous 24 GB était une limite que nous avons fixée sur la 4090. Nous n'avons pas fait tourner de vraie carte de 6 ou 8 GB. Une vraie petite carte a aussi une mémoire plus lente, donc attendez-vous à ce qu'elle soit plus lente que ceci. Nous n'avons pas essayé le plafond de 4 GB avec une limite de réponse plus courte, ni une version compressée du modèle.
Sur InferenceKey : la base et son jumeau modifié sur une carte de 24 GB, prêts en 7 minutes
Une seule carte de 24 GB a accueilli la base et son jumeau modifié en même temps, chacun avec un peu moins de la moitié de la carte, avec 16,9 GiB utilisés au pic. Les deux étaient prêts 418 secondes après que nous les avons demandés, depuis une machine froide. Environ trois minutes sont parties dans l'installation de vLLM, et environ trois de plus dans le préchauffage du moteur lui-même. Une fois cette installation présente sur la machine, un nouveau moteur était prêt en environ une minute.
Notre API ne permet pas encore de changer certains réglages par requête, comme l'interrupteur de réflexion, donc nous les avons fixés sur le serveur pour tous les appelants.
Un problème que vous rencontrerez : une réponse du modèle de base diffusée en streaming à travers l'endpoint s'est arrêtée au bout de 152 secondes, sans erreur visible par notre client et sans marqueur de fin. Pour un client, une réponse coupée ressemble à une réponse terminée. Nous soupçonnons le délai de silence de deux minutes de la plateforme, qui enverrait une erreur que notre script d'exemple ignore, mais la cause n'est pas confirmée. D'ici là, vérifiez que chaque réponse en streaming indique qu'elle s'est bien terminée avant de vous y fier.
Faut-il l'utiliser ? Essayez-le si vous servez Qwen3.5-0.8B avec la réflexion activée
- Si vous servez déjà Qwen3.5-0.8B avec la réflexion activée et lui envoyez des maths : essayez le remplacement. Même taille, même licence, et il tourne sur le même moteur.
- Si vous voulez les meilleures maths d'un tout petit modèle : voyez-le comme une correction, pas comme une amélioration. Il fait ressortir ce que le modèle savait déjà, et il écrit toujours de longues réponses.
- Si vous dimensionnez un GPU : le résultat à 6 GB a été émulé sur une carte de 24 GB, pas sur une vraie carte de 6 GB ; voir la section sur la mémoire.
- Si vous faites tourner un autre petit modèle qui boucle : c'est une méthode publiée avec ses logs, pas un produit. Le résultat sur Gemma dit qu'elle n'aide que quand les boucles sont le problème.
Pour faire la même comparaison sur votre propre machine GPU, utilisez l'exemple du SDK pour la modification des poids de Qwen3.5-0.8B avec IK_WITH_BASELINE=1. Il lui faut une machine NVIDIA enregistrée (un worker) avec une carte de 24 GB et environ 15 GB de disque libre. Les clés d'accès et la build locale du SDK sont dans le pas à pas ci-dessous. Il supprime les deux workloads quand il a terminé.
Pour les ingénieurs
Crédits
- Équipe Qwen : Qwen/Qwen3.5-0.8B, Apache-2.0, y compris l'avertissement sur les boucles dans la page du modèle.
- Rikiya Takehi, Jayden Teoh (contribution égale), Alex Zhang, Omar Khattab, MIT CSAIL : la méthode, l'Expérience 8, le diff exact au bit près et
apply_edit.py, qui reconstruit la modification et en vérifie les hashes, et les logs. Billet de blog (2 novembre 2026), checkpoint, logs et diffs. Le modèle qui modifie s'appelle "GPT-6 Astra". - akhaliq, avec ML Intern sur HF Jobs (2026-11-02) : a reconstruit la modification sur CPU, en a vérifié les hashes et a construit le checkpoint Hugging Face et sa page ; la réexécution indépendante sur tout MATH-500 ; le Space de démo (publié d'abord sous
akhaliq/weight-space-programming-demo, Gradio sur ZeroGPU). - AI Search : là où nous l'avons repéré, vidéo 9RIK3A24ZxA, segment de 12:01 à 16:59.
- Vérification : le dépôt de logs des auteurs contient le diff exact par rapport à la base et
apply_edit.py, qui vérifie le sha256 de chaque tenseur reconstruit ; akhaliq s'en est servi pour reconstruire et vérifier le checkpoint. - Notre part : servir les deux sur une seule carte (nous n'avons pas recalculé les hashes des tenseurs ; le fichier a été servi tel que publié) via InferenceKey, la comparaison sur 50 problèmes, les prises à travers les endpoints, l'échelle de mémoire, l'exemple du SDK.
Le modèle et la modification
| Élément | Valeur |
|---|---|
| Dépôt modifié | RikiyaT/Qwen3.5-0.8B-weight-space-programming, sha d1671a178705bcab7644806d23c535517f35723b, Apache-2.0, un shard bf16 de 1 746 943 032 octets (1,75 GB, 1,63 GiB) |
| Dépôt de base | Qwen/Qwen3.5-0.8B, sha 2fc06364715b967f1860aea9cf38778875588b17, Apache-2.0, shard de 1 746 942 600 octets |
generation_config.json | fourni par aucun des deux dépôts |
| Architecture | Qwen3_5ForConditionalGeneration (version multimodale complète). Le billet a évalué un export texte seul ; les tenseurs du LM ont des hashes identiques et les prompts texte n'utilisent pas la tour de vision |
| Tenseurs modifiés | model.language_model.layers.15.mlp.down_proj.weight sha256 82e2d733ea64feaeb4af93a1e065641d3df98b494a8b7576ef2f52e90fe2ee53 ; model.language_model.layers.19.mlp.down_proj.weight sha256 8ef3c61bc36af113ad58e89dbb0a4a14dcba5a45cb750c15ab515c82ddd12eb2 (octets bf16 bruts) |
| Forme | chacun [1024, 3584] bf16, 64 colonnes modifiées, 131 072 poids touchés (0,016 %) |
Manifeste (exp8_math/runs/p50c/edit/manifest.json) | entrées modifiées 65 260 (couche 15) et 64 928 (couche 19), 130 188 au total (les entrées touchées qui retombent sur la même valeur bf16 ne sont pas comptées) ; changement relatif 0,106 et 0,081 |
| Reconstruction | exp8_math/code/apply_edit.py vérifie par sha256 chaque tenseur reconstruit contre le checkpoint évalué dans le billet |
| Licence des logs | la page dit CC BY 4.0 / MIT ; GitHub indique NOASSERTION |
Expérience 8 : Astra a fait remonter les boucles à une direction écrite par les MLP des couches 15 et 19, et l'a soustraite de 64 colonnes de sortie de down_proj dans chacune. Harnais : un kernel Python sur les poids (pas de GPU pour Astra), des problèmes d'entraînement (7 469 problèmes d'entraînement GSM8K et 7 275 MATH, pas des jeux de test), un budget de 10, 25 ou 50 passes avant (une passe : jusqu'à 512 problèmes résolus ou 1 024 textes lus). Évaluation : réflexion activée, jusqu'à 32 768 tokens, température 0,6, top-p 0,95, top-k 20, presence penalty 1,5. MATH-500 fait la moyenne de 4 échantillons, GSM8K et IFEval de 2.
Chiffres des auteurs (non reproduits par nous, sauf MATH-500 sur 50 problèmes)
| MATH-500 | GSM8K | IFEval | Limite de tokens atteinte | |
|---|---|---|---|---|
| Base | 7,9 | 13,8 | 21,0 | 93,0 % |
| Modifié, 10 passes | 12,3 | 25,7 | 49,0 | 87,2 % |
| Modifié, 25 passes | 14,1 | 25,1 | 39,9 | 86,4 % |
| Modifié, 50 passes (le checkpoint publié) | 48,1 | 67,1 | 62,3 | 33,1 % |
Gemma 3 270M : base 6,8 % sur MATH-500, modifié 7,0 / 7,6 / 7,7 / 7,0 % avec 5 / 10 / 25 / 50 passes, 8,5 % des réponses de base atteignent la limite.
Réexécution indépendante (akhaliq, 2026-11-02) : MATH-500 complet, 500 x 4 = 2 000 générations, 43 407 495 tokens, 3 059 s sur une H200, vLLM 0.33.0, transformers 5.20.2, math-verify 0.9.0, seed 0 : 51,0 % de bonnes réponses, 31,6 % à la limite, 14 190,9 tokens/s, moyenne de 21 704 tokens. Test rapide de la base, 25 problèmes x 4 : 5,0 % de bonnes réponses, 95 % à la limite, moyenne de 31 690 tokens.
La page du modèle n'indique pas de version minimale de vLLM. La réexécution a utilisé 0.33.0, et nous aussi. Aucune autre version n'a été testée.
Installation
- Une RTX 4090 24 GB sur InferenceKey Cloud (pilote 595.91.07, CUDA 13.2), les deux modèles sur la même carte.
- Manager InferenceKey local compilé depuis
origin/maineb1ee503, backendvllmintégré,vllm_version="0.33.0". La production n'a jamais été touchée. - Commande de service, par workload :
vllm serve <model> --dtype bfloat16 --max-model-len 34816 \
  --gpu-memory-utilization 0.45 \
  --default-chat-template-kwargs '{"enable_thinking": true}' \
  --override-generation-config '{"temperature": 0.6, "top_p": 0.95, "top_k": 20, "presence_penalty": 1.5}'
Utilisez --gpu-memory-utilization 0.90 quand le modèle modifié tourne seul. Le log de vLLM confirme la surcharge : "Default vLLM sampling parameters have been overridden ... {'presence_penalty': 1.5, 'temperature': 0.6, 'top_k': 20, 'top_p': 0.95}".
Pourquoi sur le serveur : à eb1ee503, le ChatSampling du manager (crates/shared/src/models.rs) transmet temperature, max_tokens, top_p, stop, presence_penalty, frequency_penalty et seed. top_k et chat_template_kwargs ne sont pas transmis, et le generate_text() du SDK n'a ni presence_penalty ni top_k.
Pas à pas avec l'exemple du SDK
Dossier : examples/qwen3-5-0-8b-weight-edit-math-vllm-private-nvidia (commit 7661793, plus 07215bb).
- Compilez le SDK en local avec maturin et installez le
requirements.txtde l'exemple. - Copiez
.env.exampleen.envet renseignez un tokenik_sdk_, une clé d'APIik_live_limitée à<project>/*, le slug du projet etIK_WORKER_ID(un worker NVIDIA enregistré avec environ 15 GB de disque libre). - Optionnel :
IK_WITH_BASELINE=1déploie le modèle de base à côté du modifié (0,45 de la carte chacun),IK_MAX_TOKENS(32 768 par défaut),IK_KEEP_ALIVE=1garde les workloads après l'exécution. python main.py. Il appelleensure()pour chaque workload,wait_until_ready(), envoie en streaming le problème MATH-500test/number_theory/572(diviseurs de 196, réponse 9) à chaque endpoint en HTTP simple, affiche les tokens, le temps et la réponse encadrée, et supprime les workloads sauf siIK_KEEP_ALIVE=1.- Pour un budget de 5 GB, ajoutez
--max-num-seqs 32à la commande (documenté dans l'exemple).
Délais
| Étape | Modifié | Base |
|---|---|---|
ensure() jusqu'à prêt, worker froid | 418,1 s | 418,2 s |
pip install vllm==0.33.0 | environ 3 min (partagé) | |
| Chargement des poids (pré-téléchargés) | 0,29 à 0,32 s | |
| Initialisation du moteur (profilage, cache KV, préchauffage) | 181,7 s | 186,0 s |
| dont torch.compile | 17,3 à 17,7 s | |
| CUDA graphs | 8 à 9 s | |
| Moteurs de l'échelle à chaud, un à la fois | 60 à 63 s (133 s pour l'échelon de 5 GB) |
MATH-500, 50 problèmes par modèle
Les 50 premiers identifiants de problèmes dans l'ordre du fichier de réexécution d'akhaliq eval/scores_edited_math500.json (sur le checkpoint HF), 1 échantillon, seed 0, maximum 32 768 nouveaux tokens, les 50 en vol par modèle, les deux modèles à la fois, requêtes envoyées directement aux deux serveurs vLLM lancés par la plateforme. Notées avec le mathqa.py des auteurs (dernier \boxed{} de toute la sortie) et math-verify 0.9.0 ; recalculées à partir des fichiers notés, identiques.
| Modifié | Base | |
|---|---|---|
| Justes | 31/50 (62 %) | 4/50 (8 %) |
| À 32 768 tokens | 10 (20 %) | 48 (96 %) |
| Terminées sans encadré | 3 | 0 |
| Tokens moyen / max | 20 444 / 32 768 | 31 832 / 32 768 |
| Tokens médians des réponses terminées | 17 477 (40 terminées) | 9 377 (2 terminées, toutes deux justes ; les 2 autres bonnes réponses ont été coupées à la limite après avoir encadré la bonne réponse) |
| Tokens totaux / temps réel | 1 022 176 en 986,7 s | 1 591 617 en 1 194,4 s |
| Tokens par bonne réponse | environ 33 000 | environ 398 000 |
| Par matière | algèbre 10/12, théorie des nombres 5/7, préalgèbre 4/7, précalcul 4/7, géométrie 3/5, algèbre intermédiaire 3/8, dénombrement 2/4 | préalgèbre 2/7, algèbre 2/12, autres 0 |
| Réexécution d'akhaliq | mêmes 50 : 54 % (moyenne sur 4 échantillons) ; notre juste/faux sur 1 échantillon concorde avec sa majorité sur 42/50 | test rapide de la base, 25 problèmes x 4 : 5 % (95 % coupées) |
Débit : une requête seule 300 à 380 tokens/s ; deux à la fois à travers les endpoints environ 175 tokens/s chacune ; 3 100 à 4 300 tokens/s par moteur au début avec 50 en cours, en baisse à mesure que le cache KV se remplissait. Agrégé sur l'exécution : environ 1 036 tokens/s pour le modifié contre 1 333 pour la base, pas une comparaison équitable : les deux moteurs ont démarré au même moment et le modifié a eu la moitié de la mémoire de travail, donc il a commencé à mettre en file d'attente plus tôt. Détails : cache KV réparti en 6,48 GiB (517 266 tokens) pour la base contre 3,32 GiB (265 098 tokens) pour le modifié avec le même réglage de 0,45, parce que les deux moteurs ont profilé la mémoire au même moment, donc le moteur modifié a mis des requêtes en file d'attente (99 % de KV, 22 en cours, 21 en attente à un moment). L'exécution complète des 100 problèmes (2,61 M tokens) a pris 1 194 s.
Problème 572 (diviseurs de 196)
- À travers les endpoints de la plateforme, les deux à la fois, enregistré : modifié
\boxed{9}en 14 518 tokens, 87 s. Base 32 768 tokens au bout de 138 s, pas de réponse, dernières lignes répétant "Wait, $14 \times 14 = 196$." - Exécution en batch : modifié 17 077 tokens, arrêté de lui-même, juste, environ 287 s avec 50 en vol. Base 32 768 tokens, coupée, énumérant "Let's check 3309. $3309 \times 2 = 6618$. No." en montant, environ 757 s. C'est l'image de la comparaison clé.
Mémoire GPU et échelle de VRAM
Poids de 1,63 GiB par modèle. Pic de la carte 17 282 MiB (16,9 GiB) avec les deux moteurs à 0,45, 100 % d'utilisation, 286 W. Moteur modifié seul à 0,45, au repos : 6 846 MiB.
Échelle : modèle modifié seul, même commande, --max-model-len 34816, 5 problèmes que le modèle modifié avait résolus dans le batch (572, 515, 807, 2584, 248) en vol, maximum 32 768. Chaque échelon sous 24 GB est un plafond fixé avec --gpu-memory-utilization sur la 4090, pas une vraie carte.
| GPU ou plafond | Config | Cache KV | Résultat | Réel ou émulé |
|---|---|---|---|---|
| RTX 4090 24 GB | les deux modèles, 0,45 chacun, 50 problèmes chacun | 6,48 / 3,32 GiB | 62 % contre 8 % justes, pic de 16,9 GiB | réel |
| Plafond de 8 GB | 0.333 | 4,3 GiB (343 186 tokens) | 5/5 justes, 25 à 96 s par réponse, la plus longue 31 606 tokens en 95,5 s | émulé |
| Plafond de 6 GB | 0.245 | 2,23 GiB (177 561 tokens) | 5/5 justes, sorties et temps identiques à 8 GB (95,7 s) | émulé |
| Plafond de 5 GB | 0.204, max_num_seqs par défaut 256 | échec : max_num_seqs (256) exceeds available Mamba cache blocks (202) | émulé | |
| Plafond de 5 GB | 0.204, --max-num-seqs 32 | 1,74 GiB (138 766 tokens) | 5/5 justes (textes différents, autres formes de batch), la plus longue 30 948 tokens en 97 s | émulé |
| Plafond de 4 GB | 0.163 | 0,29 GiB | échec : il faut 0,44 GiB de cache KV pour une requête de 34 816 tokens ; vLLM suggère un maximum de 22 304 tokens | émulé |
| Plafond de 3 GB | 0.122 | -0,66 GiB | échec : pas de mémoire disponible pour les blocs de cache | émulé |
Pas essayé : une vraie petite carte (rien sous 16 GB n'était disponible ce jour-là, la RTX 2000 Ada de 16 GB n'a pas été essayée), 4 GB avec un contexte plus court, fp8, plus de 50 requêtes simultanées, le chemin de vision. Les vraies cartes de 6 à 8 GB ont moins de bande passante mémoire : attendez-vous à ce qu'elles soient plus lentes que ces temps.
Problèmes restants
- Fin silencieuse d'une réponse de base en streaming (ouvert). À travers l'endpoint, pendant que le cache KV du moteur de base était saturé, le flux s'est fermé au bout de 152,3 s avec 3 286 caractères, sans
finish_reasonniusage. Cause non confirmée, SSE brut non capturé. Àeb1ee503, le chemin de streaming GPU du manager utiliseSTREAM_IDLE_TIMEOUT_MS = 120_000et, en cas de dépassement, émet un chunk{"error":{"code":"inference_timeout",...}}suivi de[DONE]. Leask()de l'exemple ne lit quechoicesetusage, donc un tel chunk serait ignoré en silence par le client ; l'exemple doit encore être corrigé pour le faire remonter. Vérifiez la présence d'une cléerroret d'unfinish_reasondans votre propre client. - pip en concurrence dans un même venv (ouvert). Deux workloads avec la même
vllm_versionont lancépip install vllm==0.33.0dans le même venv en même temps. Ça a marché ici. C'est une race condition. - Répartition inégale du KV (contournement). Deux moteurs qui démarrent ensemble sur une carte profilent la mémoire au même moment et le second voit moins de mémoire libre. Démarrez-les l'un après l'autre.
- 5 GB demande
--max-num-seqs 32(documenté dans l'exemple). - Le modèle : 20 % des réponses modifiées vont encore jusqu'à 32 768 tokens et 3 se sont terminées sans encadré. Une première exécution de l'exemple avec 16 384 tokens par défaut a coupé la réponse modifiée, donc la valeur par défaut est maintenant 32 768.
- Mineur :
min_disk_gb60 dans la requête de création du worker a été ignoré (100 GB attribués). Le premier démarrage de nats-proxy de la stack locale a échoué faute deJWT_SECRET. - Notation : le
mcqa.pydes auteurs n'est pas publié. Un stub a couvert un import utilisé seulement dans les statistiques de boucles ; le code de notation n'a pas été touché. - Non vérifié par nous : GSM8K, IFEval ; la mention, dans la vidéo d'AI Search, d'environ 44 % pour le modèle non modifié avec d'autres réglages (aucune source citée).
Vidéo de démo
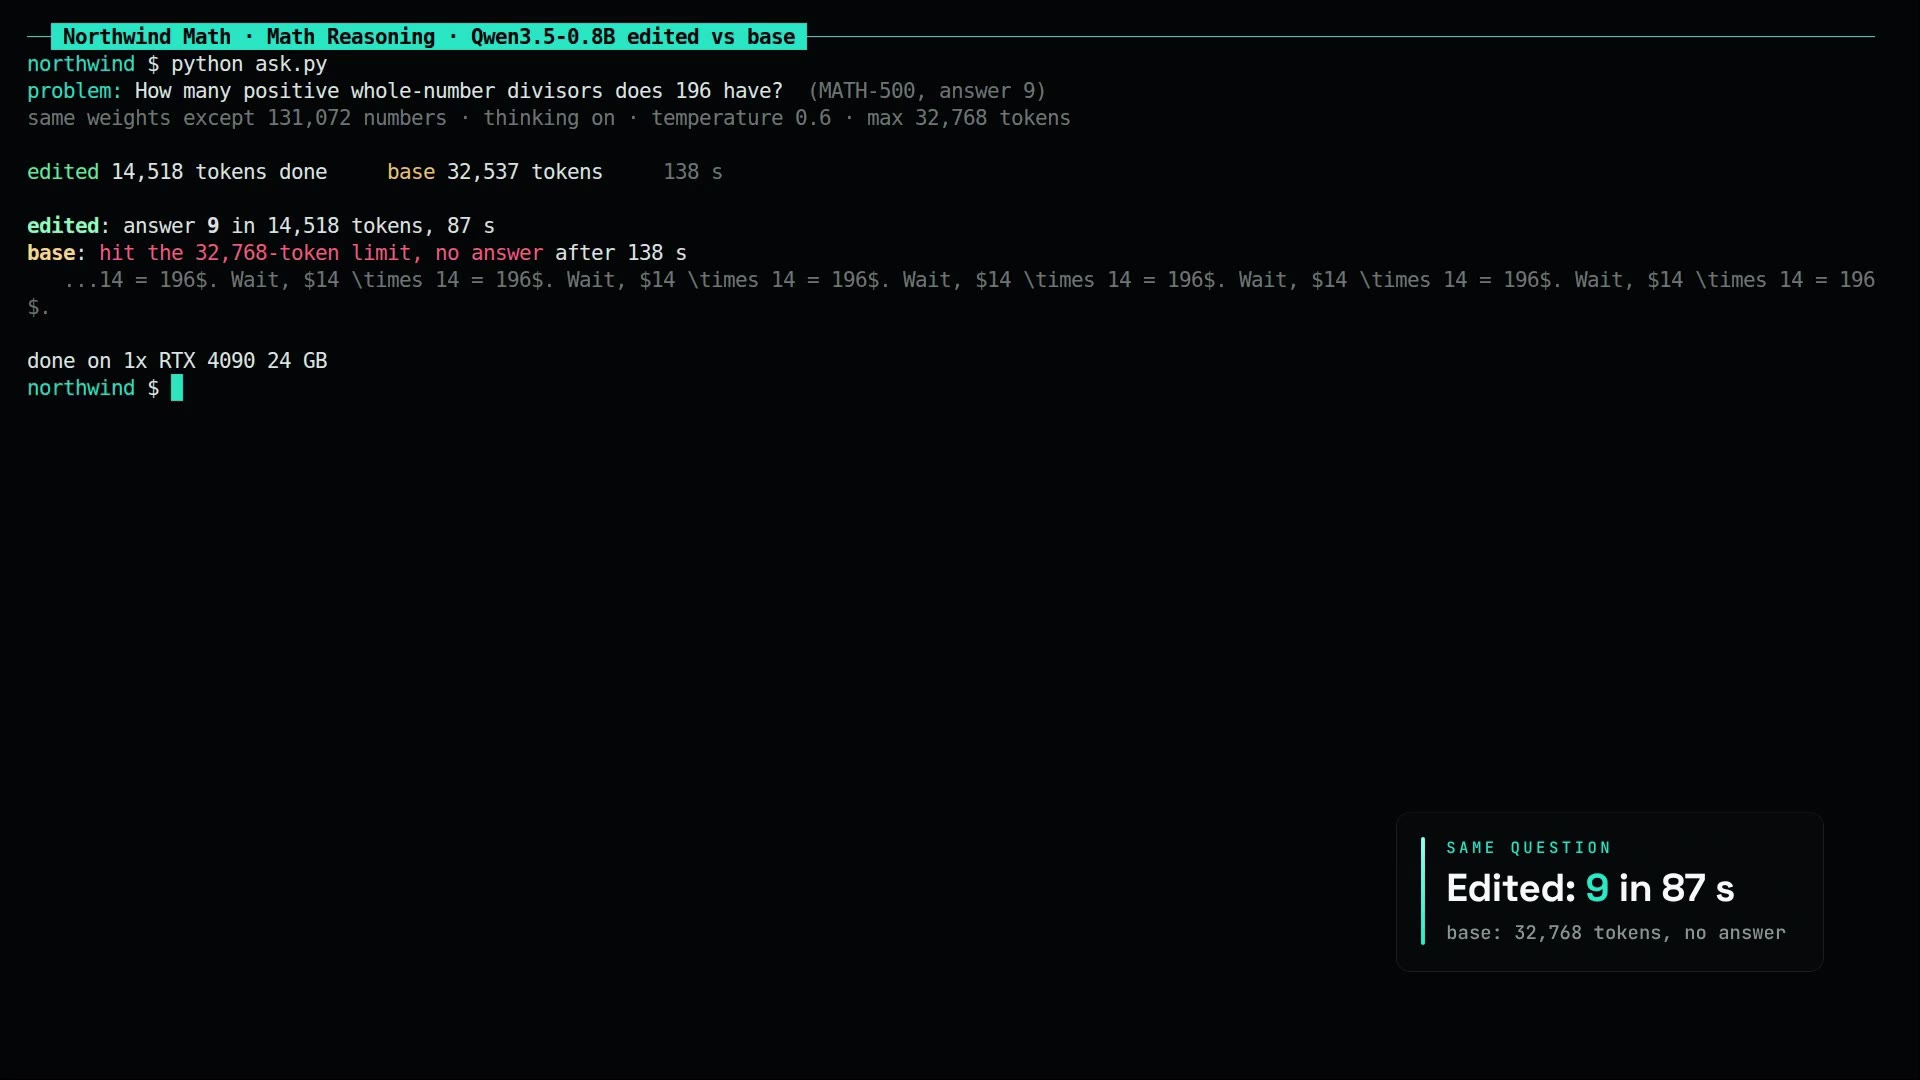
176,6 s, commentée : le blog des auteurs avec les crédits, l'avertissement de Qwen sur les boucles, les chiffres des auteurs et les nôtres, les deux modèles répondant à la question des diviseurs à travers les endpoints, et les plafonds mémoire.
Sources
- Blog : Sparks of Weight-Space Programming, Takehi, Teoh, Zhang, Khattab (MIT CSAIL), 2 novembre 2026.
- Checkpoint modifié et sa page, avec la réexécution et les hashes : RikiyaT/Qwen3.5-0.8B-weight-space-programming.
- Modèle de base et avertissement sur les boucles : Qwen/Qwen3.5-0.8B.
- Logs, diffs et
apply_edit.py: RikiyaT/lm_understand-logs. - Space de démo : ML-Intern-lab/weight-space-programming-demo (anciennement
akhaliq/weight-space-programming-demo). - Là où nous l'avons repéré : AI Search, 8 novembre 2026.
- Notre exemple : inferencekey-sdk, qwen3-5-0-8b-weight-edit-math-vllm-private-nvidia.