SenseNova Code2Video sur une RTX 4090 : un brouillon en 10 minutes, un trou dans chaque rangée, pas de film fini
Un modèle 27B qui fait des vidéos en écrivant du code, dans Claude Code sur une carte de 24 GB : un brouillon avec une erreur de mise en page, sans film fini.
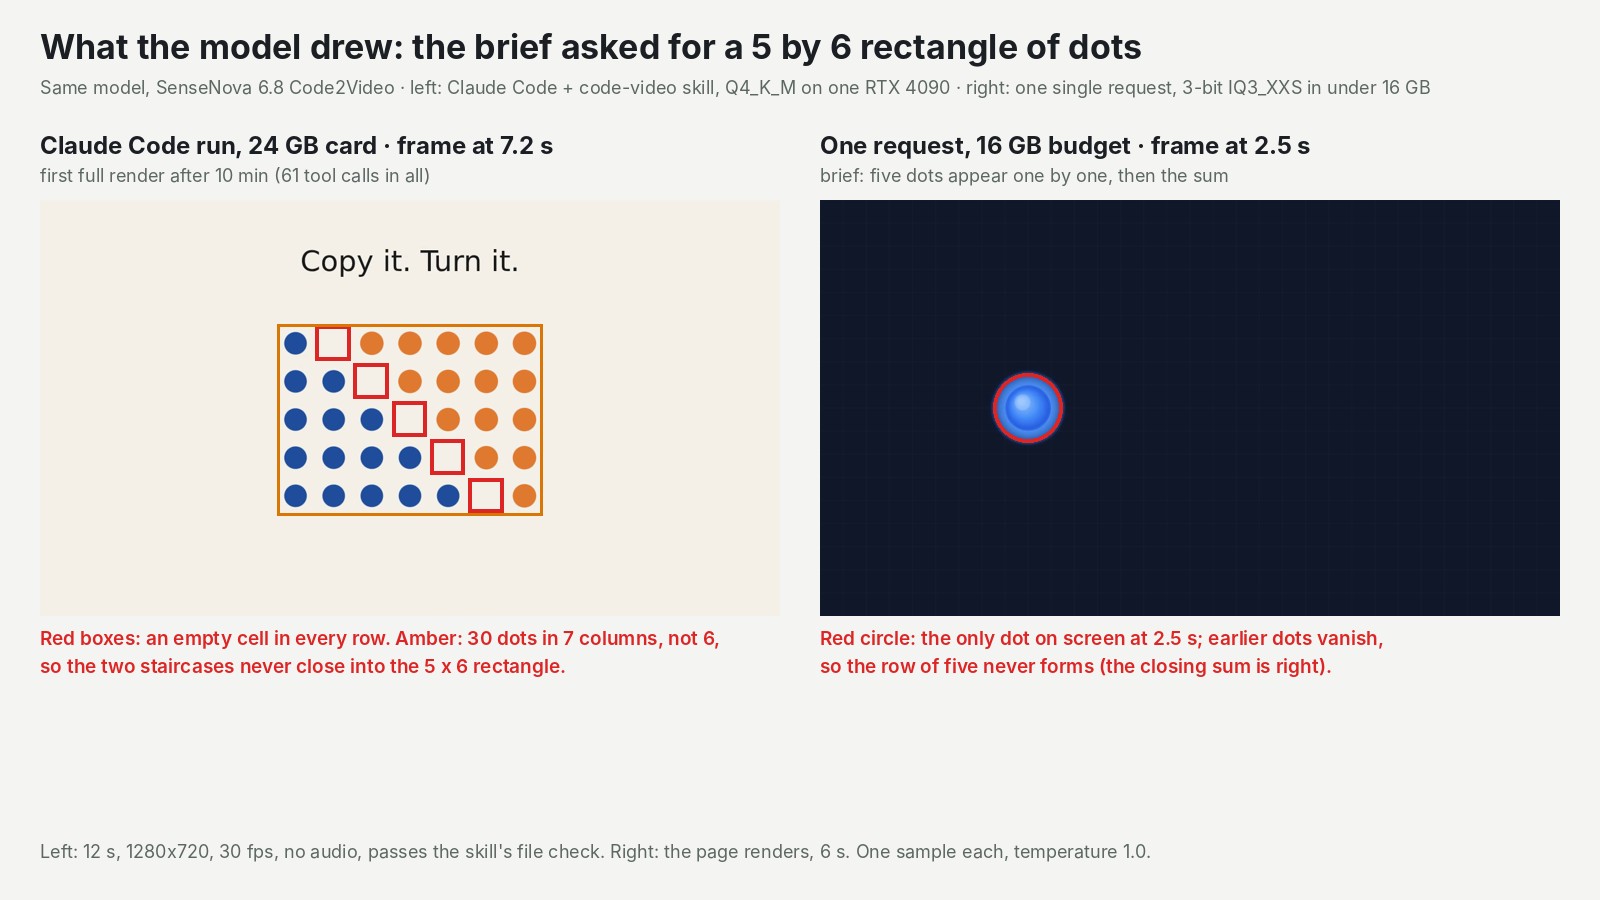
Pas besoin d'un modèle vidéo pour faire une vidéo explicative. Un modèle de texte peut écrire une page web qui dessine chaque image, en faire le rendu, regarder les images et corriger ce qu'il voit. C'est ce que fait SenseNova 6.8 Code2Video, le modèle ouvert de 27B de SenseTime. Piloté par Claude Code, il a tourné sur une seule RTX 4090 de 24 GB. Au bout de dix minutes, il avait un clip complet de 12 secondes qui passait son contrôle automatique de fichier. L'image était fausse : les points censés former un rectangle de 5 par 6 se sont retrouvés en 5 rangées de 7, avec un trou dans chaque rangée. Ensuite, sa mémoire de travail, tout ce qu'il avait lu et écrit, s'est remplie. Claude Code a passé 21 minutes à essayer de la résumer, a buté chaque fois sur notre limite de longueur de réponse, et n'a jamais terminé. Le modèle tient sur une seule carte de jeu, et notre exemple du SDK reproduit l'installation.
| Temps GPU sur une RTX 4090 | Premier rendu complet de 12 s | Plus petite copie dont la page s'affiche |
|---|---|---|
| Occupé à écrire pendant 32 des 40 minutes | Un brouillon, une erreur de mise en page | Une copie 3 bits plus petite a culminé à 13,7 GiB sur la 4090, sous les 16 GB (la page s'affiche avec un bug) |
Une vidéo faite de code : le modèle écrit un programme, en fait le rendu et relit les images
SenseNova 6.8 Code2Video ne peint pas de pixels. Ses auteurs le présentent comme "a lightweight open model for code-driven video creation" qui "builds and renders videos by generating executable code". Un clip est une page web où chaque instant correspond à exactement une image. Un navigateur sans fenêtre parcourt cette page image par image, et un outil vidéo standard assemble les images en MP4.
Par construction, chaque élément à l'écran est du code : vous pouvez changer une étiquette ou une couleur et refaire le rendu. Le texte sort orthographié exactement comme il a été écrit, parce qu'il est tapé, pas dessiné. Et le "modèle vidéo" est un modèle ordinaire de texte et d'image. Vous le servez avec les mêmes serveurs open source que vous utilisez déjà pour les modèles de chat.
SenseTime a publié le modèle sous licence ouverte, avec une skill Claude Code (un ensemble packagé d'instructions et de scripts) appelée code-video. La skill enseigne la boucle : planifier, écrire la page, rendre des images fixes et les regarder "at least twice". Puis rendre le film, lancer un contrôle de fichier et écrire une note de vérification. Son meilleur conseil tient en une ligne : "Get a rough full-length render early (even ugly), then improve it."
Ils ont aussi publié six exécutions de production complètes. Chaque film a demandé de 261 à 876 tours où le modèle écrit, exécute et vérifie, et de 37 à 99 images examinées. La page du modèle dit qu'il "sustains runs of more than 10 hours and more than 2,000 turns" ; nous ne l'avons pas vérifié. Les auteurs font tourner le modèle en taille réelle sur quatre GPU, avec une mémoire de travail cinq fois plus grande que la nôtre (512K tokens). Ils sont aussi francs : pas de benchmark, "clearly behind the strongest proprietary models on visual polish and long-horizon reliability", et pas d'images photoréalistes.
La question que nous avons apportée au test était donc plus modeste que la leur. Une copie compressée, trois fois plus petite, peut-elle terminer un clip court sur une seule carte de 24 GB, et en combien de tours et de minutes ? Nous n'avons trouvé aucune exécution publiée qui y réponde.
Notre test : un brief de 12 secondes, une carte de 24 GB, une limite de 40 minutes
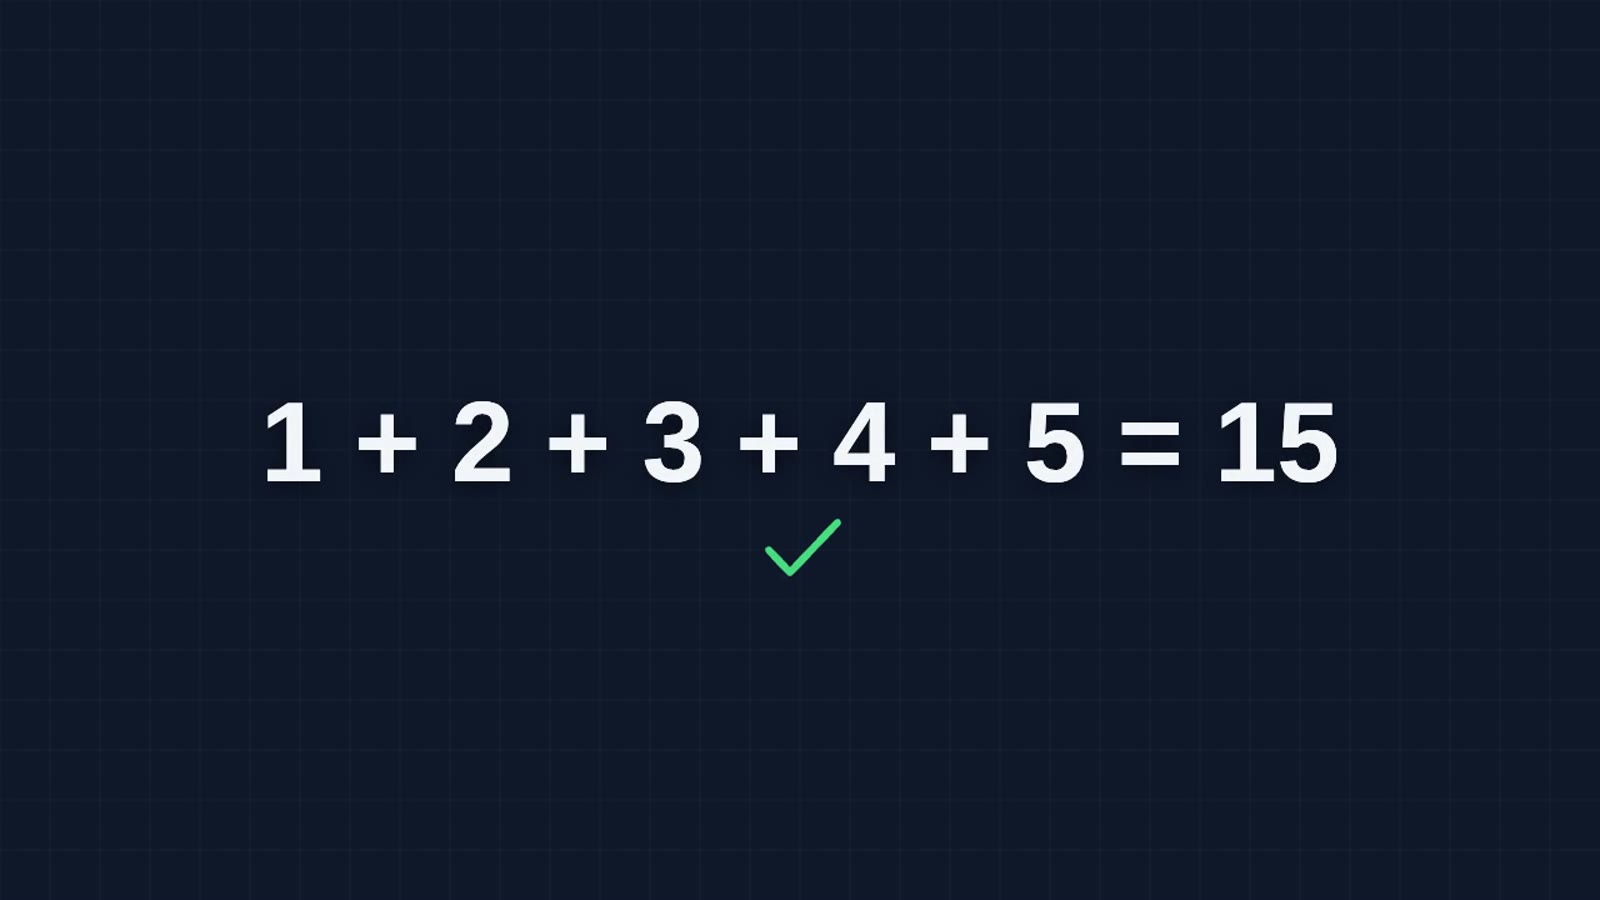
Le brief était une vidéo explicative muette de 12 secondes appelée "Half a Rectangle". Elle montre 1 + 2 + 3 + 4 + 5 = 15 sous la forme d'un escalier de points bleus. Puis elle copie l'escalier en orange, fait pivoter la copie et referme les deux en un rectangle de 5 par 6, soit 30 points. La moitié de 30, c'est 15. C'est un petit brief avec un seul fait qui doit être juste.
La première étape des auteurs consiste à développer une idée courte en un brief dense et détaillé avec un modèle généraliste puissant. Ils utilisent Claude Opus 5.5, et nous aussi, avec leur modèle de prompt. C'était le seul modèle fermé de notre chaîne. Le brief de 898 mots est ensuite passé à SenseNova dans Claude Code, qui tournait sans surveillance dans un environnement verrouillé, avec la skill inchangée. Chaque appel au modèle allait à la RTX 4090 de notre cloud.
Le modèle tournait à partir de la copie compressée de bartowski (4 bits, 17,2 GB) plus une partie vision de 0,93 GB, pour qu'il puisse voir ses images. Nous avons donné à Claude Code une mémoire de travail de 98 304 tokens au lieu des 512K des auteurs, une limite de 16 384 tokens par réponse au lieu de 64K, 120 tours et 40 minutes. Ces limites sont les nôtres, imposées par une seule carte et une seule matinée. Pas d'audio.
Un rendu brouillon complet, avec sept colonnes là où le brief en demandait six
Le modèle a lu la skill et le brief, et a écrit son plan à 5 minutes. Il a dessiné ses premières images fixes à 6 minutes. À 10 minutes, il avait les 12 secondes complètes rendues : 1280 par 720, 30 images par seconde, 360 images. C'était une seule tentative sur un seul brief, et les réponses du modèle varient volontairement : un second essai pourrait faire mieux ou moins bien.
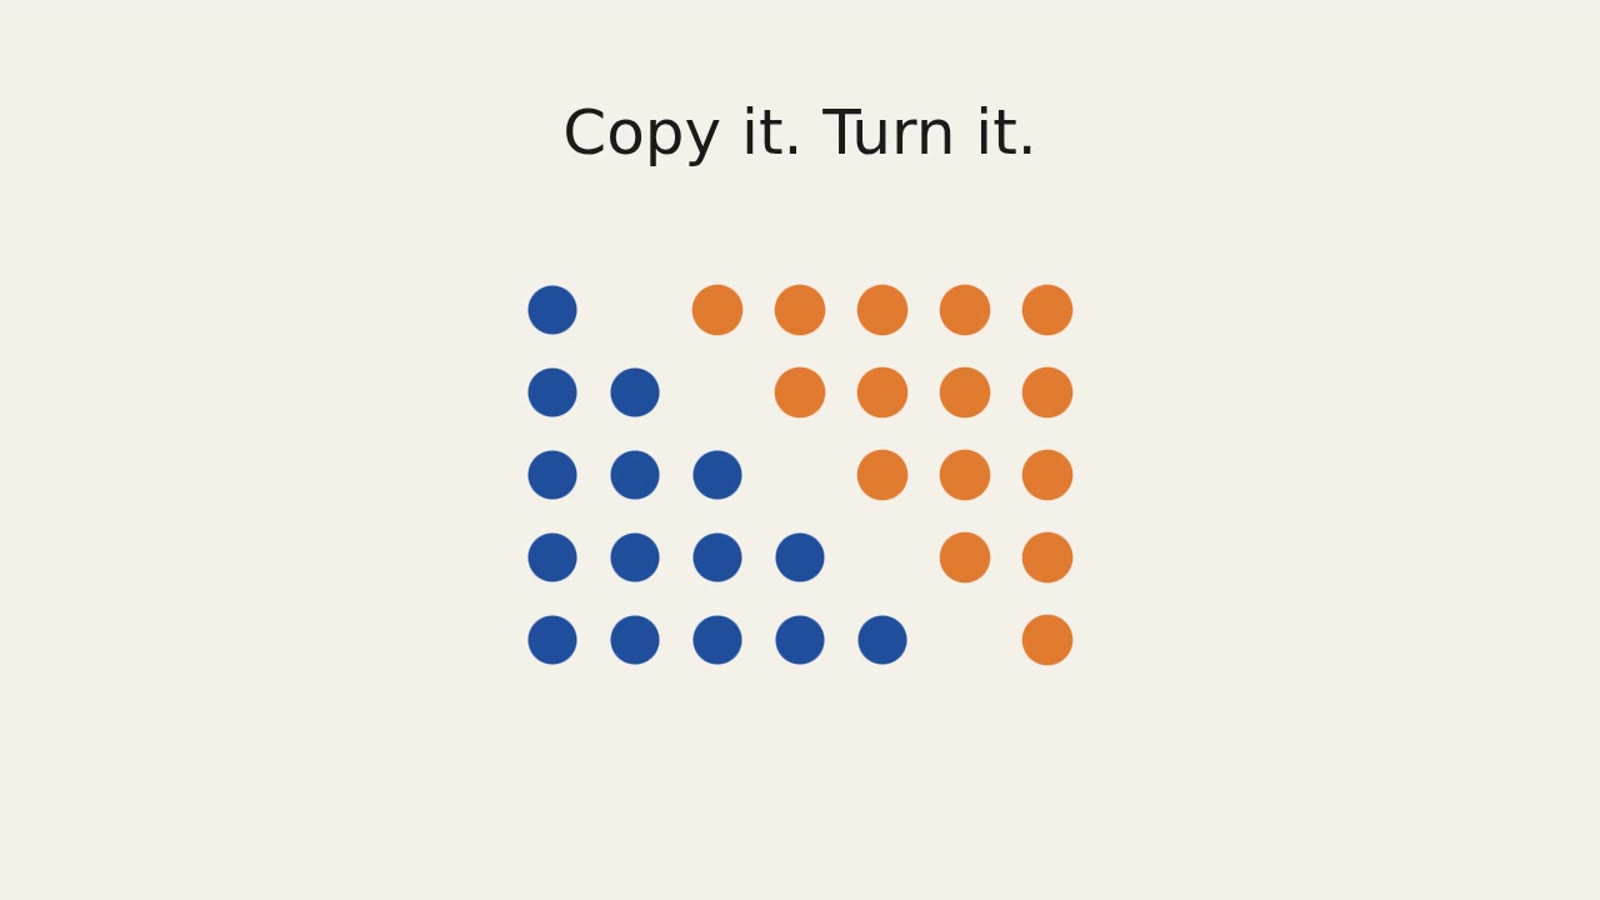
La boucle a fonctionné comme les auteurs la décrivent. Le modèle a lu 21 de ses propres images comme des images et a agi sur ce qu'il voyait. Il a vu les points orange atterrir dans le coin supérieur gauche, a remonté la cause jusqu'à un déplacement appliqué deux fois et l'a corrigé. Puis il a vu ses bandes de surlignage recouvrir les lignes de la grille et a corrigé l'ordre de dessin. Le mouvement est propre et chaque mot à l'écran est orthographié exactement comme dans le brief.
L'image enfreint pourtant le seul fait qui compte. Nous avons mesuré les centres des points à 7,2 secondes : 30 points en 7 colonnes sur 5 rangées, chaque rangée "bleu, une case vide, orange". La légende dit "5 rows × 6 columns = 30", et la grille de 6 colonnes dessinée derrière les points laisse la septième colonne de côté. Le contrôle de fichier est passé quand même. Il vérifie la résolution, la cadence et la durée, pas l'image.
Le coût, donc : un brouillon en 10 minutes ; l'exécution entière de 40 minutes a pris 61 appels d'outils et environ 78 000 tokens écrits, et on ne sait pas ce qu'aurait coûté un clip fini, puisque l'exécution ne s'est pas terminée.
Les 21 dernières minutes, Claude Code les a passées à résumer sa propre mémoire
Imaginez la mémoire de travail comme un bureau : chaque fichier lu, chaque image regardée et chaque ligne écrite y reste posé. Quand le bureau est plein à 80 %, Claude Code demande au modèle de résumer le travail fait jusque-là, vide le bureau et ne garde que le résumé.
Notre bureau contenait 98 304 tokens. Il s'est rempli après environ 19 minutes de travail. Claude Code a demandé un résumé trois fois. Chaque fois, le modèle a écrit jusqu'à atteindre la limite de 16 384 tokens d'une seule réponse, et le résumé n'est jamais revenu utilisable. Ces trois tentatives ont pris 21 minutes, jusqu'à ce que la limite de 40 minutes arrête tout, sans film final ni note de vérification.
Dans quatre des six exécutions des auteurs, Claude Code a vidé un bureau de 167K à 492K tokens, avec une limite de réponse de 64K. Les suspects probables sont nos réglages : la limite de réponse de 16 384 tokens, et le raisonnement caché du modèle, laissé activé, qui consomme cette limite. Nos logs ne disent pas lequel.
Quel GPU : 24 GB ont fait tourner l'agent, les copies plus petites n'ont répondu qu'à une requête
Nous avons fait tourner l'agent sur une vraie 4090 de 24 GB. Faute de carte de 16 GB en stock, nous avons testé des copies plus petites sur la 4090 en surveillant leur pic de mémoire. Chacune a reçu une seule requête courte pour une page d'animation de 6 secondes (limitée à 8 192 tokens, un brief plus petit que celui de l'agent) et une image de 15 points à décrire.
| Carte ou budget | Copie et mémoire de travail | Pic de mémoire de la carte | Vitesse | Résultat | Vraie carte ? |
|---|---|---|---|---|---|
| RTX 4090 24 GB | 4 bits, 98K tokens, exécution Claude Code | 20,9 GiB | 39 à 48 tokens/s | exécution Claude Code, voir plus haut | oui |
| RTX 4090 24 GB | 4 bits, 32K tokens, une requête | 18,8 GiB | 47,6 tokens/s | image juste, page jamais écrite : les 8 192 tokens sont partis dans le raisonnement caché | oui |
| Budget 16 GB | 3 bits, 32K tokens, une requête | 13,7 GiB | 63,5 tokens/s | image juste, la page s'affiche, mais un seul point est visible à la fois | non, exécuté sur la 4090 |
| Budget 12 GB | 2 bits, 16K tokens, une requête | 10,0 GiB | 78,7 tokens/s | image juste, page coupée à 8 192 tokens | non, exécuté sur la 4090 |
Un seul échantillon chacun ne dit pas grand-chose, et la requête 4 bits n'a écrit aucun code : il n'y a donc pas de comparaison à armes égales.
Sur InferenceKey : prêt en 25 secondes, correctif d'images pas encore déployé
Sur une machine neuve avec les fichiers sur disque, le modèle a répondu 25,2 secondes après notre demande, et Claude Code lui parle comme à l'API d'Anthropic. Brancher Claude Code sur la 4090 a demandé une URL, un nom de modèle et quelques réglages de contexte. De notre côté, il a fallu deux changements : un correctif pour les images, et un délai d'expiration des requêtes de 30 minutes, pour que les longues réponses ne soient pas coupées à 2 minutes. Rien n'a changé dans la skill des auteurs.
Le problème sur lequel vous tomberez : quand Claude Code envoyait une image, notre plateforme la supprimait ou la transmettait sous forme de texte. État : corrigé dans notre build de test, pas encore sur le service hébergé, où les images arrivent toujours à l'aveugle.
Cette exécution a utilisé une copie locale de la plateforme, pas le service hébergé. Les aspérités plus petites (un délai d'expiration, un redémarrage de machine, un nouvel essai d'envoi) sont dans l'annexe avec leur état.
Faut-il l'utiliser ? À essayer pour des brouillons courts sur une carte de 24 GB, si vous relisez chaque image
- Vous voulez des vidéos explicatives et du motion design avec un texte exact : ça vaut l'essai sur une carte de 24 GB.
- Vous avez besoin d'une image juste du premier coup : relisez vous-même chaque image.
- Vous voulez un film fini sans surveillance : comptez des heures et beaucoup plus de mémoire de travail, comme le font les auteurs. Notre exécution de 40 minutes ne s'est pas terminée.
- Vous avez une carte de 16 GB : la copie 3 bits tient sur le papier, n'a pas été testée comme agent, et son unique échantillon avait un bug.
Pour faire votre propre clip, lancez python main.py depuis l'exemple SenseNova Code2Video du SDK sur une carte de 24 GB louée sur notre cloud ; les étapes d'installation sont dans l'annexe, et son étape Claude Code ne verra les images qu'une fois le correctif d'images livré.
Pour les ingénieurs
Crédits
- SenseTime (équipe SenseNova) : le modèle (Apache-2.0), affiné à partir de Qwen3.8-27B selon sa page ; la page du modèle avec des recettes vLLM, SGLang et LightLLM ; six trajectoires de production publiées ; la skill
code-video, le modèle de prompt et les médias (le dépôt GitHub n'indique aucune licence). - L'équipe Qwen : le modèle de base que nomment les auteurs.
- bartowski : les quants GGUF que nous avons fait tourner (Q4_K_M, IQ3_XXS, IQ2_XXS, mmproj bf16), produits avec llama.cpp b11969 et une imatrix.
- Les mainteneurs de llama.cpp : la release b12167 avec l'archive précompilée CUDA 13.4, le support multimodal et le parsing des appels d'outils via
--jinja. - Anthropic : Claude Code, le harnais que recommandent les auteurs, et Claude Opus 5.5, qui a écrit notre brief dense à partir du modèle de prompt des auteurs.
- AI Search : là où nous l'avons repéré (vidéo d'actualité du 2026-11-01, chapitre à 39:53).
- Notre part : le déploiement via la plateforme, le correctif d'images dans notre traduction
/v1/messages, l'exécution de Claude Code en bac à sable, la vérification au pixel de sa sortie, l'échelle de mémoire, l'exemple du SDK et la vidéo de démo.
Modèle et fichiers
sensenova/SenseNova-6.8-Code2Video: sha0f99ab03, créé le 2026-10-24, dernière modification le 2026-11-03, sans accès restreint, Apache-2.0,pipeline_tagimage-text-to-text, langues en et zh. Publié fin octobre ; page mise à jour pour la dernière fois le 2026-11-03.- 27 356 728 560 paramètres en BF16 (12 shards, environ 54,7 GB).
Qwen3_5ForConditionalGeneration: 64 couches avecfull_attention_interval4 (16 couches à attention complète, 48 à attention linéaire), 4 têtes KV x head_dim 256, hidden 5120, tour de vision de profondeur 27, 1 couche MTP.max_position_embeddings262 144 avec un facteur yarn de 2,0 (d'où l'affirmation des 512K). - Configuration de génération : temperature 1,0, top_k 20, top_p 0,95, échantillonnage activé.
- GGUF de bartowski
0ef7c7e3: bf16 53,81 GB, Q8_0 28,67, Q6_K 23,62, Q5_K_M 20,68, Q4_K_M 17,20 (marqué par défaut), IQ3_XXS 12,08, IQ2_XXS 8,64 ; mmproj bf16 0,93 GB et f16. Autres quants de la communauté listés sur la page : OliviaRossi GSQ-RCO-GGUF, Abiray MTP-GGUF, BennyDaBall NVFP4-GGUF, Hayabala EXL3. - Binaire du backend : le llama.cpp précompilé pour NVIDIA, donc rien à compiler.
- Cache KV en q8_0 : 16 couches x 4 têtes x 256 x 2 x 1 B = 32 KiB par token, donc 96K font environ 3 GiB (conforme au pic mesuré) et 512K feraient environ 16 GiB.
- Réglages de harnais des auteurs :
CLAUDE_CODE_MAX_CONTEXT_TOKENS=524288,CLAUDE_AUTOCOMPACT_PCT_OVERRIDE=80, sortie maximale de 64K,--max-turns2000 ou plus, délai de 10 h ou plus. Sinon, Claude Code traite un modèle inconnu comme un modèle de 200K. La page HF indiqueCLAUDE_CODE_MAX_OUTPUT_TOKENS=64000, le README GitHub 65536. La page parle d'exécutions de plus de 2 000 tours ; la section sur les poids du README dit "over a thousand". Nous n'avons vérifié ni l'un ni l'autre. - Trajectoires des auteurs (
trajectories/all.openai.jsonl, réflexion activée) : fourier_light_painting 675 tours de l'assistant et 99 images examinées, forest_landslide 445 et 47, signal_noise_shape 713 et 51, cmyk_halftone 261 et 37, geometry_risograph 521 et 67, frame_form_flow 876 et 69. Compaction : fourier 2 fois à environ 492K vers 13-16K ; signal_noise_shape 1 fois à 491K vers 14K ; risograph 4 fois à environ 167-172K vers 10-15K ; frame_form_flow 7 fois à environ 167-173K vers 6-13K ; forest_landslide a utilisé 2 reprises ; cmyk_halftone ne franchit aucune limite de contexte. Les chiffres de 6-16K sont tout le contexte restant après compaction (postTokens), pas la longueur du résumé. - Environnement de la skill : Claude Code, Node.js 18+, Python 3, ffmpeg/ffprobe, polices, Playwright Chromium ;
requirements.txtnumpy, scipy, soundfile, librosa, edge-tts, faster-whisper. HEAD GitHub776ae798, un seul commit daté du 2026-10-26.
Installation
- GPU sur InferenceKey Cloud : une RTX 4090 24 GB (24 564 MiB, 450 W, compute capability 8.9, pilote 595.91.07).
- Backend : le backend
llamacppintégré avecINFERENCEKEY_LLAMACPP_TAG=b12167etINFERENCEKEY_LLAMACPP_ASSET=ubuntu-cuda-13.4-x64. Pourquoi llama.cpp : les recettes de la page sont vLLM, SGLang et LightLLM en BF16 avec un parallélisme de tenseurs de 4 et un contexte de 512K (environ 54,7 GB rien que pour les poids). Le GGUF de 17,2 GB est ce qui tient sur une seule carte grand public. - Un manager InferenceKey local compilé depuis notre branche main, avec le patch d'images. La production n'a jamais été touchée.
- Claude Code 2.1.322 headless dans un bac à sable Docker (Ubuntu 24.04, ffmpeg, Node 24, Playwright 1.56.1 Chromium, polices Noto et DejaVu,
--memory 8g --cpus 6), avec seulement le dossier de la tâche et un HOME vierge montés, la clé d'API passée par variable d'environnement. - Manifeste du worker :
INFERENCEKEY_BACKEND_REQUEST_TIMEOUT_SECS=1800(120 s par défaut) ; l'exécution n'a pas été essayée sans. - Réglages de Claude Code :
CLAUDE_CODE_MAX_CONTEXT_TOKENS=98304,CLAUDE_AUTOCOMPACT_PCT_OVERRIDE=80,CLAUDE_CODE_MAX_OUTPUT_TOKENS=16384,CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1, petit modèle réglé sur le même slug. Claude Code a affiché[claude-code:unrecognized_model], sans conséquence. - Brief : "Half a Rectangle", 12 s, 1280x720, 30 fps, muet, 898 mots, écrit par Claude Opus 5.5 à partir de
prompts/enhance_prompt.md. Prompt : le prompt d'étape 2 des auteurs plus une phrase indiquant la limite de 40 minutes.
La commande de lancement qu'exécute le backend :
INFERENCEKEY_LLAMACPP_TAG=b12167 \
INFERENCEKEY_LLAMACPP_ASSET=ubuntu-cuda-13.4-x64 \
llama-server \
  -hf bartowski/sensenova_SenseNova-6.8-Code2Video-GGUF \
  --hf-file sensenova_SenseNova-6.8-Code2Video-Q4_K_M.gguf \
  --mmproj-url <bf16 mmproj URL> \
  --alias sensenova-code2video -ngl 99 -fa on \
  -c 98304 -ctk q8_0 -ctv q8_0 \
  --jinja --reasoning-format deepseek \
  --temp 1.0 --top-k 20 --top-p 0.95 \
  -np 1 --cache-reuse 256
La chaîne COMMAND exacte, avec l'URL du mmproj, se trouve dans le main.py de l'exemple.
Pas à pas avec l'exemple du SDK
- Clonez inferencekey-sdk et ouvrez
examples/sensenova-code2video-27b-claude-code-llamacpp-private-nvidia(commitd352b7b5e83921cbc9fd28c4f0b9054ee9e2cb23). cp .env.example .envet renseignezINFERENCEKEY_SDK_TOKEN,INFERENCEKEY_API_KEY,INFERENCEKEY_PROJECTetIK_WORKER_ID(un worker NVIDIA privé de 24 GB). Optionnel :C2V_CONTEXT(98304),C2V_KV_TYPE(q8_0). Pour une carte de 16 GB :C2V_GGUF_FILE=sensenova_SenseNova-6.8-Code2Video-IQ3_XXS.ggufetC2V_CONTEXT=32768(non testé sur une vraie carte de 16 GB).pip install -r requirements.txtplus le binding Pythoninferencekeylocal compilé avec maturin (pas sur PyPI).IK_KEEP_ALIVE=1 python main.py:ensure()d'un workloadllamacppfixe épinglé à votre worker,wait_until_ready(3600), puis un seul appel/v1/messagesen streaming qui demande une pagewindow.seek(t)de 6 s ; enregistreoutputs/clip.htmletoutputs/answer.json. SansIK_KEEP_ALIVE=1, il appelledelete()à la fin.cp claude-settings.example.json claude-settings.jsonet mettez le slug de votre projet dansANTHROPIC_BASE_URL(https://cloud.inferencekey.com/endpoint/<project>/sensenova-code2video).ANTHROPIC_MODELdoit être le slug du workloadsensenova-code2video(oudefault), sinon l'endpoint renvoie 400.API_TIMEOUT_MSvaut 1800000.- Dans le dossier de la tâche, lancez
npm install playwright && npx playwright install chromium(lecapture.mjsde la skill charge Playwright depuis ce dossier, une installation globale ne suffit donc pas), mettez votre brief dense dans<task>/dense_prompt.md, puis lancez./run_claude_code.sh <task>. Il copie la skill des auteurs dans la tâche, puis exécuteclaude -p --settings ... --max-turns 150 --permission-mode acceptEdits --allowedTools "Bash,Read,Write,Edit,Glob,Grep,Skill"avec un délai de 60 minutes (C2V_MAX_TURNS,C2V_MINUTES). Lancez-le dans un dossier ou un conteneur isolé : l'agent exécute des commandes shell sans demander.
Le chemin en streaming de l'exemple n'a pas été exécuté de bout en bout avant la libération du GPU. La même forme de requête a fonctionné dans notre test d'images.
Délais
| Étape | Temps |
|---|---|
ensure() jusqu'à prêt, worker neuf | 25,2 s |
| Installation de l'archive llama.cpp | environ 1 s |
| Pré-téléchargement du GGUF et du mmproj (hors du chemin vers prêt) | 26 s et 3 s |
Du démarrage de Claude Code à SPEC.md | 5 min (07:08 UTC) |
| Premières images fixes | 07:09 à 07:12 |
Rendu complet de 12 s out/v1.mp4 | 10 min (07:13) |
| Mesure des centroïdes des points avec numpy et scipy | 07:14 à 07:16 ; 61e appel d'outil à 07:16:44 |
| Une longue requête | environ 07:17 à 07:21, libérée à 78 416 tokens |
| Trois requêtes de compaction | 07:21:50 à 07:42:40, chacune libérée à n_tokens 82 969 |
| Délai dépassé | 07:43:04 |
Décodage : 47,7 tokens/s à froid, 44,5 vers 30K, 39,4 vers 66K ; 78 039 tokens en 1 915 s (40,8 en moyenne) ; prefill de 75 s sur 44 requêtes, seulement 5 prefills au-delà de 8K tokens. Le décodage a représenté environ 96 % du temps GPU. Pic de VRAM de 21 425 MiB pendant l'exécution, 21 729 MiB sur toute la session GPU. Appels d'outils : Bash 29, Read 26 (21 images), Edit 4, Write 2. Le dernier événement du flux a le statut compacting.
Vérification de la sortie v1.mp4 : check_video.sh est passé (1280x720, 30,000 fps, 360 images, 12,000 s, h264 yuv420p, pas de piste audio, avertissement sur un arrêt sur image final volontaire de 2,1 s). À t = 7,2 s, 30 centres de points en 7 colonnes (x de 441 à 837, pas de 66 px) sur 5 rangées (y de 247 à 512), chaque rangée avec k bleus, une case vide, 6-k orange. À t = 11,5 s, "30 ÷ 2 = 15" est lisible mais le guide de 6 colonnes manque la septième colonne. Tout le texte à l'écran correspond au brief. Les propres notes du modèle pendant l'exécution : "B's final placement is off (dots land top-left), the settle term double-counts the translation", puis une correction de l'ordre de dessin des bandes de la grille, et vers la fin de l'exécution "My snap origin was wrong (rows start at y=247, cols at x=441). Redo:".
Échelle de VRAM
Les échelons 2 à 4 ont tourné directement sur llama-server b12167 sur la 4090, avec un cache KV q8_0 et le mmproj bf16 sur le GPU. Chacun a reçu le brief de page de 6 s de l'exemple (193 tokens de prompt, 8 192 tokens de sortie au maximum) et un PNG de 15 points avec une question à froid. Pic relevé par nvidia-smi toutes les 0,5 s. Ce brief est plus petit que celui de l'exécution Claude Code : les échelons ne sont donc pas comparables à armes égales avec elle.
| GPU ou budget | Configuration | Pic de VRAM | Temps par sortie | Sortie correcte | Réel ou émulé |
|---|---|---|---|---|---|
| RTX 4090 24 GB | Q4_K_M + mmproj bf16, ctx 98 304 q8_0, Claude Code via l'endpoint | 21 425 MiB | 39,4 à 47,7 tok/s ; rendu complet à 10 min | non : 5x7 avec des trous, blocage à la compaction, pas de final.mp4 en 40 min | réel |
| RTX 4090 24 GB | Q4_K_M + mmproj, 32K q8_0 | 19 233 MiB | 47,6 tok/s ; brief 172,5 s ; image 7,7 s | image juste ; brief : 8 192 tokens de réflexion, pas de réponse (finish length) | réel |
| Budget 16 GB | IQ3_XXS + mmproj, 32K q8_0 | 13 994 MiB | 63,5 tok/s ; brief 4 375 tokens en 69,2 s ; image 4,3 s | image juste ; la page s'affiche (180 images) mais un seul point visible à la fois ; somme finale juste | émulé sur la 4090 |
| Budget 12 GB | IQ2_XXS + mmproj, 16K q8_0 | 10 252 MiB | 78,7 tok/s ; brief 104,4 s ; image 11,3 s | image juste ; page coupée à 8 192 tokens (html incomplet) | émulé sur la 4090 |
Nous avons essayé une vraie carte de 16 GB et toutes les options étaient en rupture de stock (RTX 2000 Ada, RTX 5080, RTX A4000, RTX 4080 et 4080 SUPER, RTX 4000 Ada). On ne sait pas si 13 994 MiB laissent assez de marge sur une vraie carte de 16 GB avec le surcoût du pilote.
Non essayé : une vraie carte de 16 ou 12 GB ; Claude Code sur les fichiers plus petits ; des contextes au-delà de 96K ; la réflexion désactivée (--chat-template-kwargs) ; une limite de sortie plus grande ou un autre réglage de compaction ; la recette BF16 des auteurs sur vLLM avec un parallélisme de tenseurs de 4 ; l'audio.
Problèmes restants
/v1/messagessupprimait les images (crates/manager/src/api/openai.rs,anthropic_message_to_openai) : les blocsimageétaient ignorés et les tableauxtool_resultconvertis en chaîne, si bien qu'un PNG lu par Claude Code arrivait au modèle comme du texte base64. Correctif local : les blocs d'image deviennent des partsimage_urlOpenAI ; les images des résultats d'outils sont rattachées au message utilisateur suivant. Vérification en direct : 200, streaming, 601 tokens en entrée / 291 en sortie, 6,8 s, lecture correcte. Un test unitaire a été ajouté mais pas compilé (disque plein). Ouvert jusqu'au déploiement sur le service hébergé.- Les appels sans streaming meurent à 120 s. Le premier appel sans streaming a renvoyé 503 après le délai du backend du worker, avec llama-server à 5 599 tokens de réflexion. Corrigé pour l'exécution avec
INFERENCEKEY_BACKEND_REQUEST_TIMEOUT_SECS=1800; l'exemple utilise désormais le streaming. - Un redémarrage du worker n'a pas repris le llama-server en cours. Le second llama-server s'est arrêté faute de VRAM ; environ 1,5 minute perdue jusqu'à ce que le watchdog relance le workload. Ouvert.
- L'envoi du binaire du worker a expiré sur la première machine (SFTP, latence élevée) et le manager l'a arrêtée au bout de 2,18 minutes. Un nouvel essai limité à l'UE a fait l'envoi en 8 s. Connu, ouvert.
- Compaction à 98K : trois résumés sont allés jusqu'à la limite de 16 384 tokens ; les logs ne disent pas pourquoi. Remèdes non testés : un contexte plus grand, une limite de sortie plus grande, la réflexion désactivée.
- Mineur : llama.cpp désactive
cache_reuseen multimodal ; le cache de préfixe normal a quand même fonctionné.
Vidéo de démo
La démo commentée de 203 secondes : d'abord les films des auteurs (crédités à SenseNova), la page de leur modèle, les tours par film et la taille des fichiers, puis notre déploiement sur la RTX 4090, une relecture des 61 appels d'outils et de la compaction, notre clip, la comparaison clé et l'échelle de mémoire.
Sources
- sensenova/SenseNova-6.8-Code2Video (page du modèle, config, configuration de génération, sections déploiement et harnais).
- OpenSenseNova/SenseNova-6.8-Code2Video (skill, scripts, modèle de prompt, limites).
- Trajectoires de production.
- bartowski/sensenova_SenseNova-6.8-Code2Video-GGUF.
- AI Search, 2026-11-01, chapitre "SenseNova Code2Video" à 39:53.
- Exemple du SDK.
- Notre test précédent d'un autre modèle de SenseTime, SenseNova-Loop-9B.