NitroFusion2 sur une seule carte : une image 1024px en 0,78 s, une pancarte juste en deux étapes
Une étape : 0,78 s de GPU sur une RTX 4090 ; deux étapes : 1,32 s ; 4 s sur une vraie carte de 16 GB. Une seule étape fait plus de fautes.
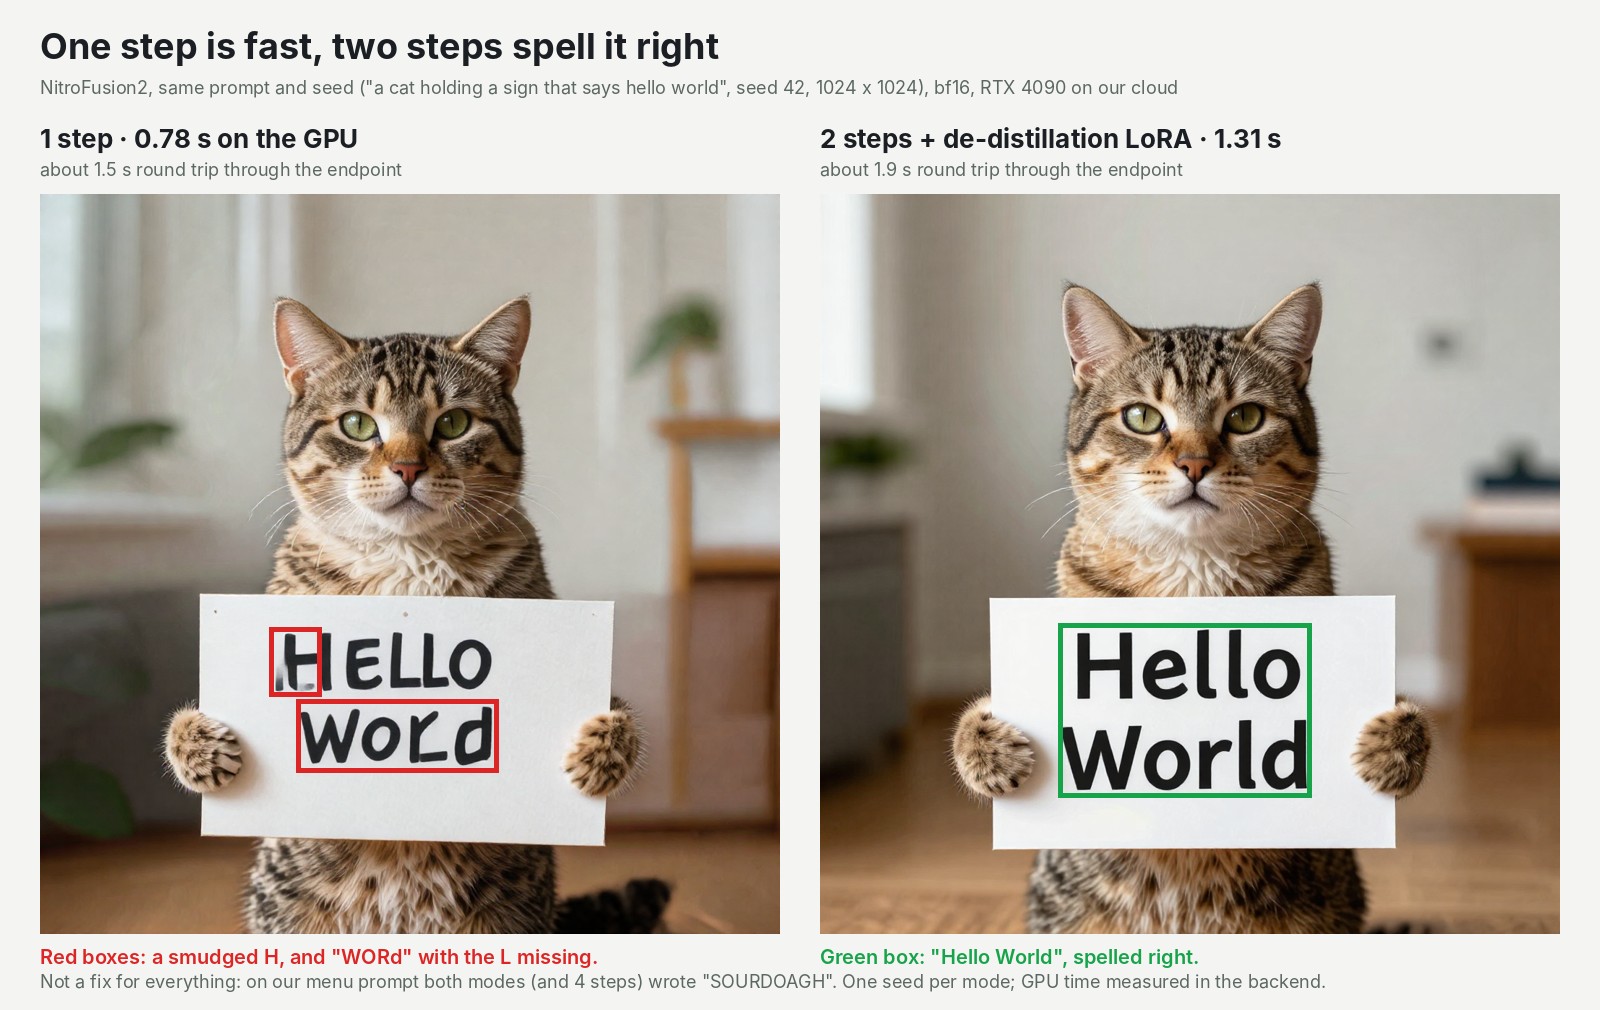
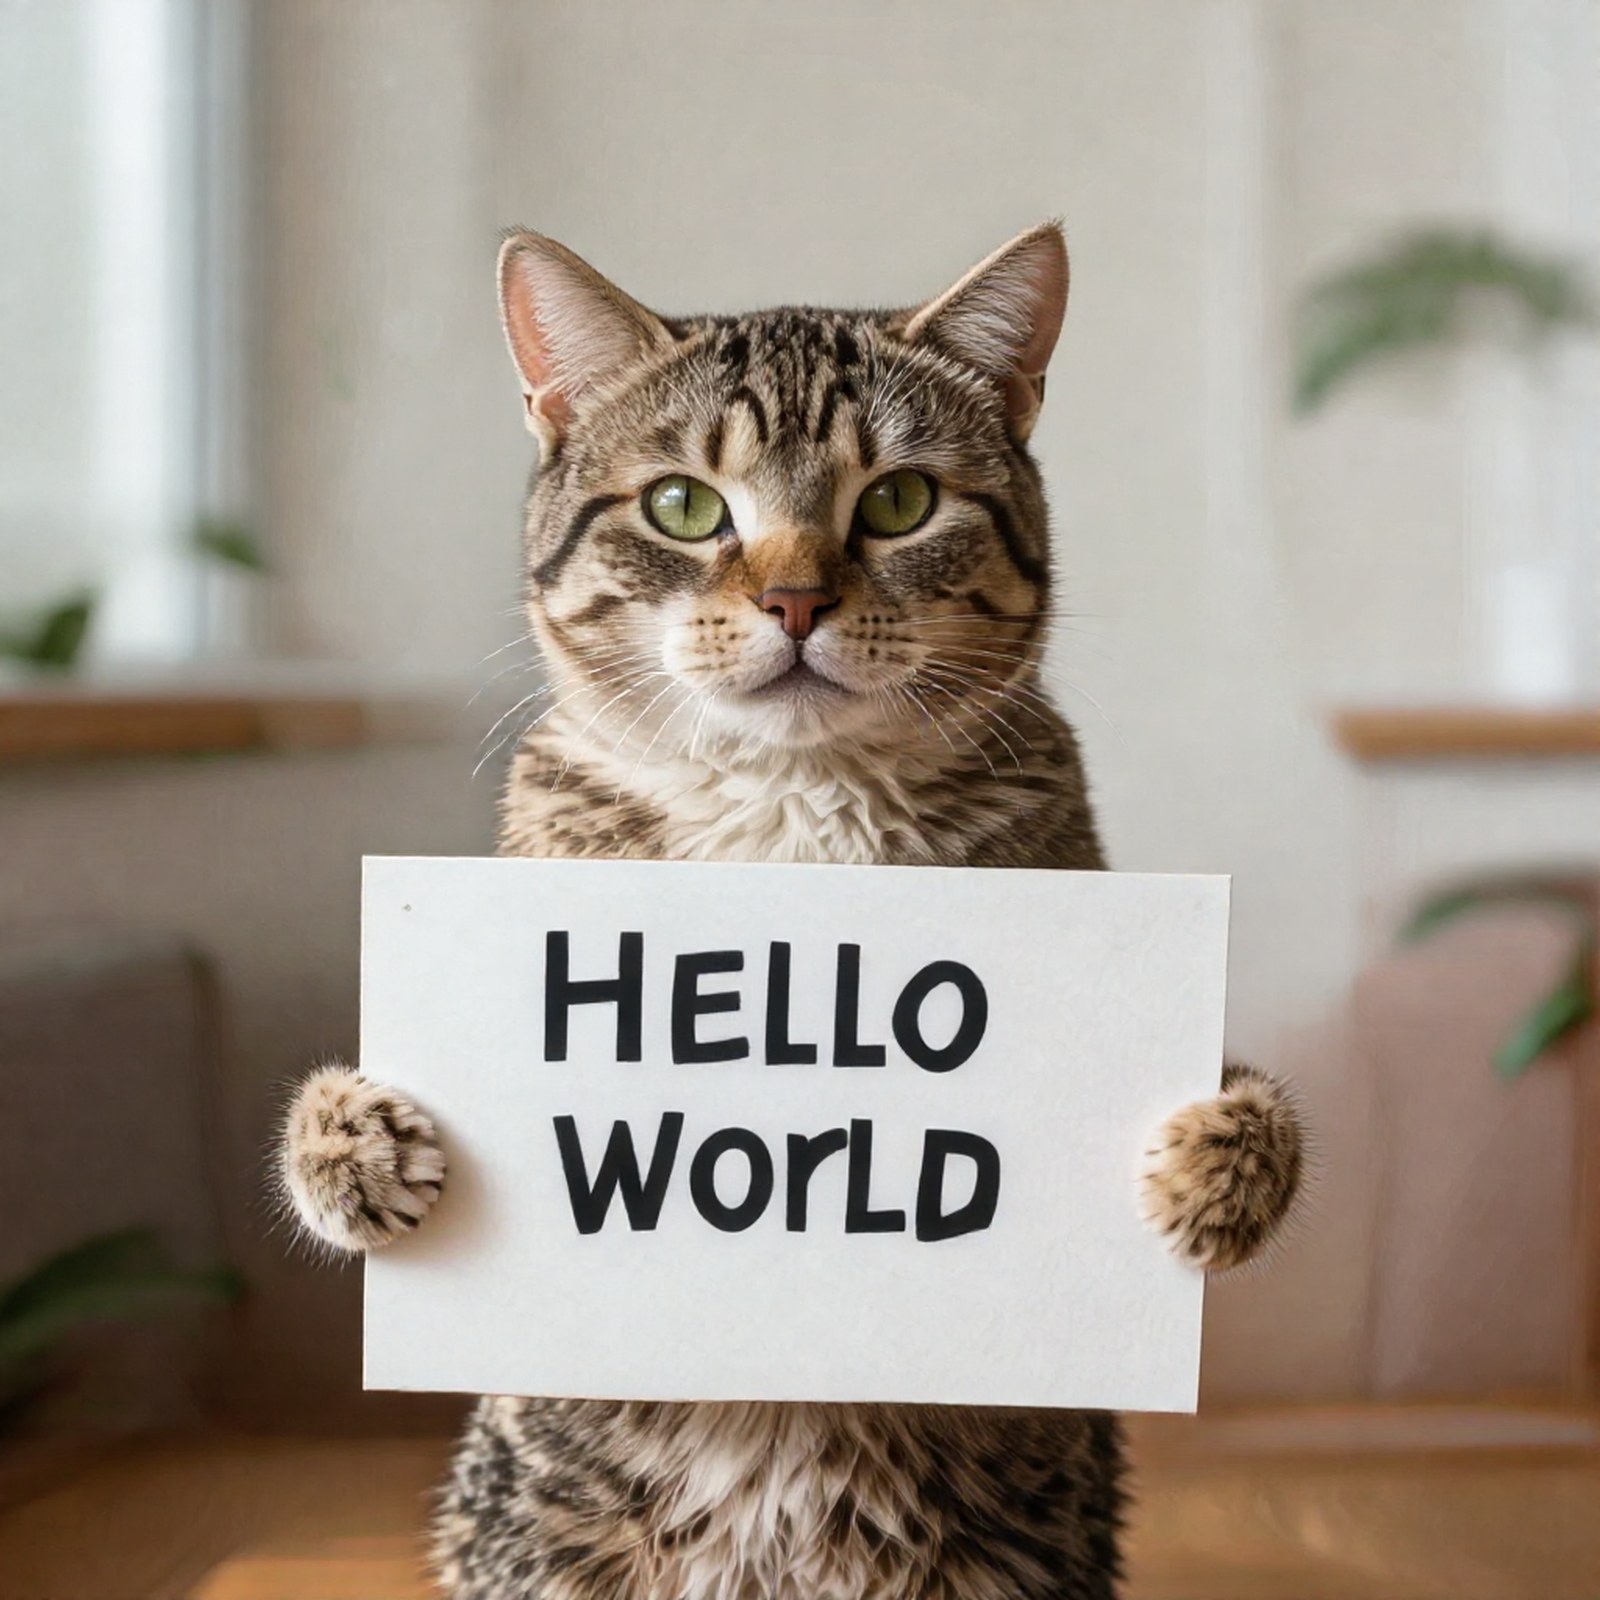
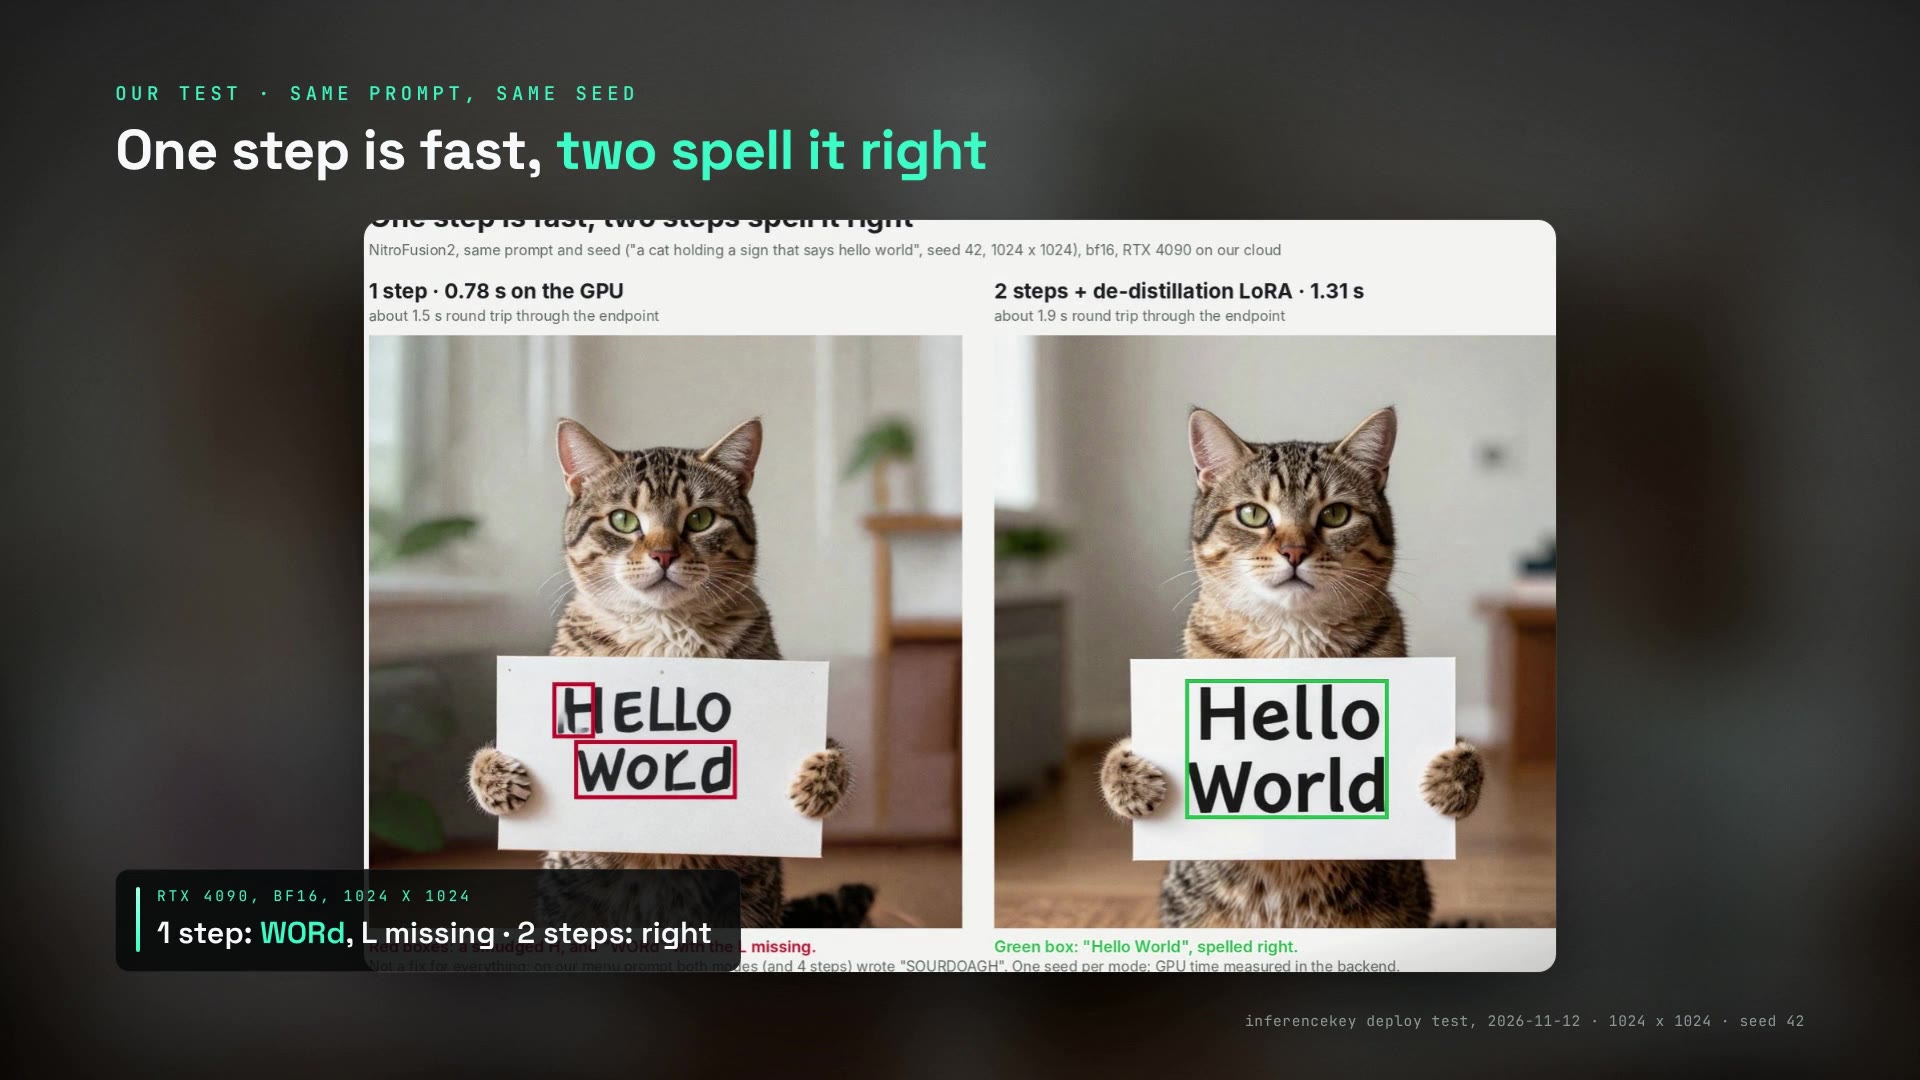
Un chat tient une pancarte en carton où l'on lit "HELLO WORd". NitroFusion2 l'a dessinée en une étape, en 0,78 seconde de temps GPU, sur une RTX 4090 de notre cloud. En deux étapes, avec le même prompt et le même point de départ aléatoire (la seed), il a fallu 1,31 seconde, et la pancarte disait "Hello World". Cette paire résume le compromis en miniature.
NitroFusion2 est une copie plus rapide du modèle ouvert Z-Image-Turbo : une ou deux passes par image au lieu de huit. Nous avons chronométré NitroFusion2 contre lui-même, pas contre l'original à huit étapes. Avec une requête à la fois, une seule carte renvoie environ 40 grandes images par minute via l'API en une étape. Avec la copie compressée de 5 GB des auteurs, il tourne aussi sur une vraie carte de 16 GB, à environ 4 secondes par image. Sur votre propre GPU, la vitesse est réglée : ce qu'il vous reste à décider, c'est quelles images peuvent vivre avec une faute de frappe. Notre exemple du SDK le déploie comme API sur votre propre carte.
| 1024 x 1024, une image à la fois | Une étape | Deux étapes (recette des auteurs) |
|---|---|---|
| Temps GPU, RTX 4090, fichier complet de 12,3 GB | 0,78 à 0,82 s | 1,32 à 1,33 s |
| La pancarte, seed 42 | "HELLO WORd" | "Hello World" |
| Vraie carte de 16 GB, copie de 5 GB | environ 4,0 s | environ 7,3 s |
Deux passes au lieu de huit : un élève entraîné à sauter le travail
NitroFusion2 est rapide parce qu'il a été entraîné à finir l'image plus tôt. Un modèle d'image comme celui-ci part d'un bruit aléatoire et le nettoie en plusieurs passes. À chaque passe, une "étape", tout le réseau de 6,2 milliards de paramètres parcourt l'image une fois. Z-Image-Turbo, publié par le laboratoire Tongyi-MAI sous Apache-2.0, en fait huit.
Dar-Yen Chen et Yi-Zhe Song, du groupe SketchX de l'Université du Surrey, ont entraîné une version élève qui le fait en une ou deux. Un élève rapide apprend à arriver là où arrive le professeur lent. Imaginez un musicien de studio qui apprend à jouer d'une traite la partie finale du producteur, construite en huit overdubs.
Leur article, publié le 3 novembre, concentre l'entraînement sur les mots du prompt.
Les chiffres des auteurs eux-mêmes annoncent ce que nous avons vu. Sur un test de texte long écrit dans des images, une étape obtient 43 sur 100. Z-Image-Turbo à huit étapes obtient 92, et NitroFusion2 à deux étapes 76. Sur la fidélité de l'image au prompt, une étape égale ou dépasse huit. L'article le dit sans détour : il reste "a substantial gap" sur le rendu du texte. Ce sont leurs benchmarks. Nous ne les avons pas relancés.
Pour deux étapes, les auteurs recommandent un petit module complémentaire de 0,38 GB. Il fait de la première étape un mélange à moitié Z-Image-Turbo pour retirer certains défauts, puis l'élève termine seul. Tout est sous Apache-2.0 : les poids et le code. La page du modèle fournit aussi des copies compressées, de 2,0 GB à 7,2 GB, à côté de la version complète de 12,3 GB. Nous l'avons repéré dans la vidéo d'actualité d'AI Search du 8 novembre.
Une étape coûte 0,78 seconde de temps GPU, deux en coûtent 1,32
Chaque étape supplémentaire ajoute un peu plus d'une demi-seconde. L'article ne donne que des nombres d'étapes, alors nous avons chronométré. Nous avons servi NitroFusion2 comme API sur une RTX 4090 de notre cloud et demandé des images de 1024 x 1024, une à la fois, toutes avec la seed 42. La carte que nous avons obtenue était la version 48 GB de la 4090 ; nous avons donc limité la mémoire du modèle pour qu'il se comporte comme sur la carte courante de 24 GB. Nous n'avons testé ni Z-Image-Turbo à huit étapes ni plusieurs utilisateurs à la fois : c'est NitroFusion2 contre lui-même.
| Étapes | Temps GPU | Aller-retour via l'API |
|---|---|---|
| 1 | 0,78 à 0,82 s | 1,45 à 1,50 s |
| 2 | 1,32 à 1,33 s | 1,95 à 2,00 s |
| 4 | 2,42 s | 3,08 s |
L'aller-retour comprend l'envoi de la requête, l'encodage du PNG et son retour par le réseau. Il ajoute environ deux tiers de seconde : en une étape, la tuyauterie coûte presque autant que le dessin.
Via l'API, une étape donne environ 40 images par minute, deux étapes environ 30. Pour une seule personne, cela fait un nouvel aperçu toutes les secondes et demie environ. Deux étapes, c'est une courte pause. Quatre étapes, le maximum que le modèle accepte, prennent environ trois fois plus de temps qu'une, et sur le prompt du menu, quatre étapes ont encore écrit "SOURDOAGH".
Les gros titres survivent à une étape, les petits caractères à aucune
Le résultat dépend de la taille du texte. Les gros mots sont sortis justes en une étape. Les petits caractères sont restés faibles à tous les nombres d'étapes essayés.
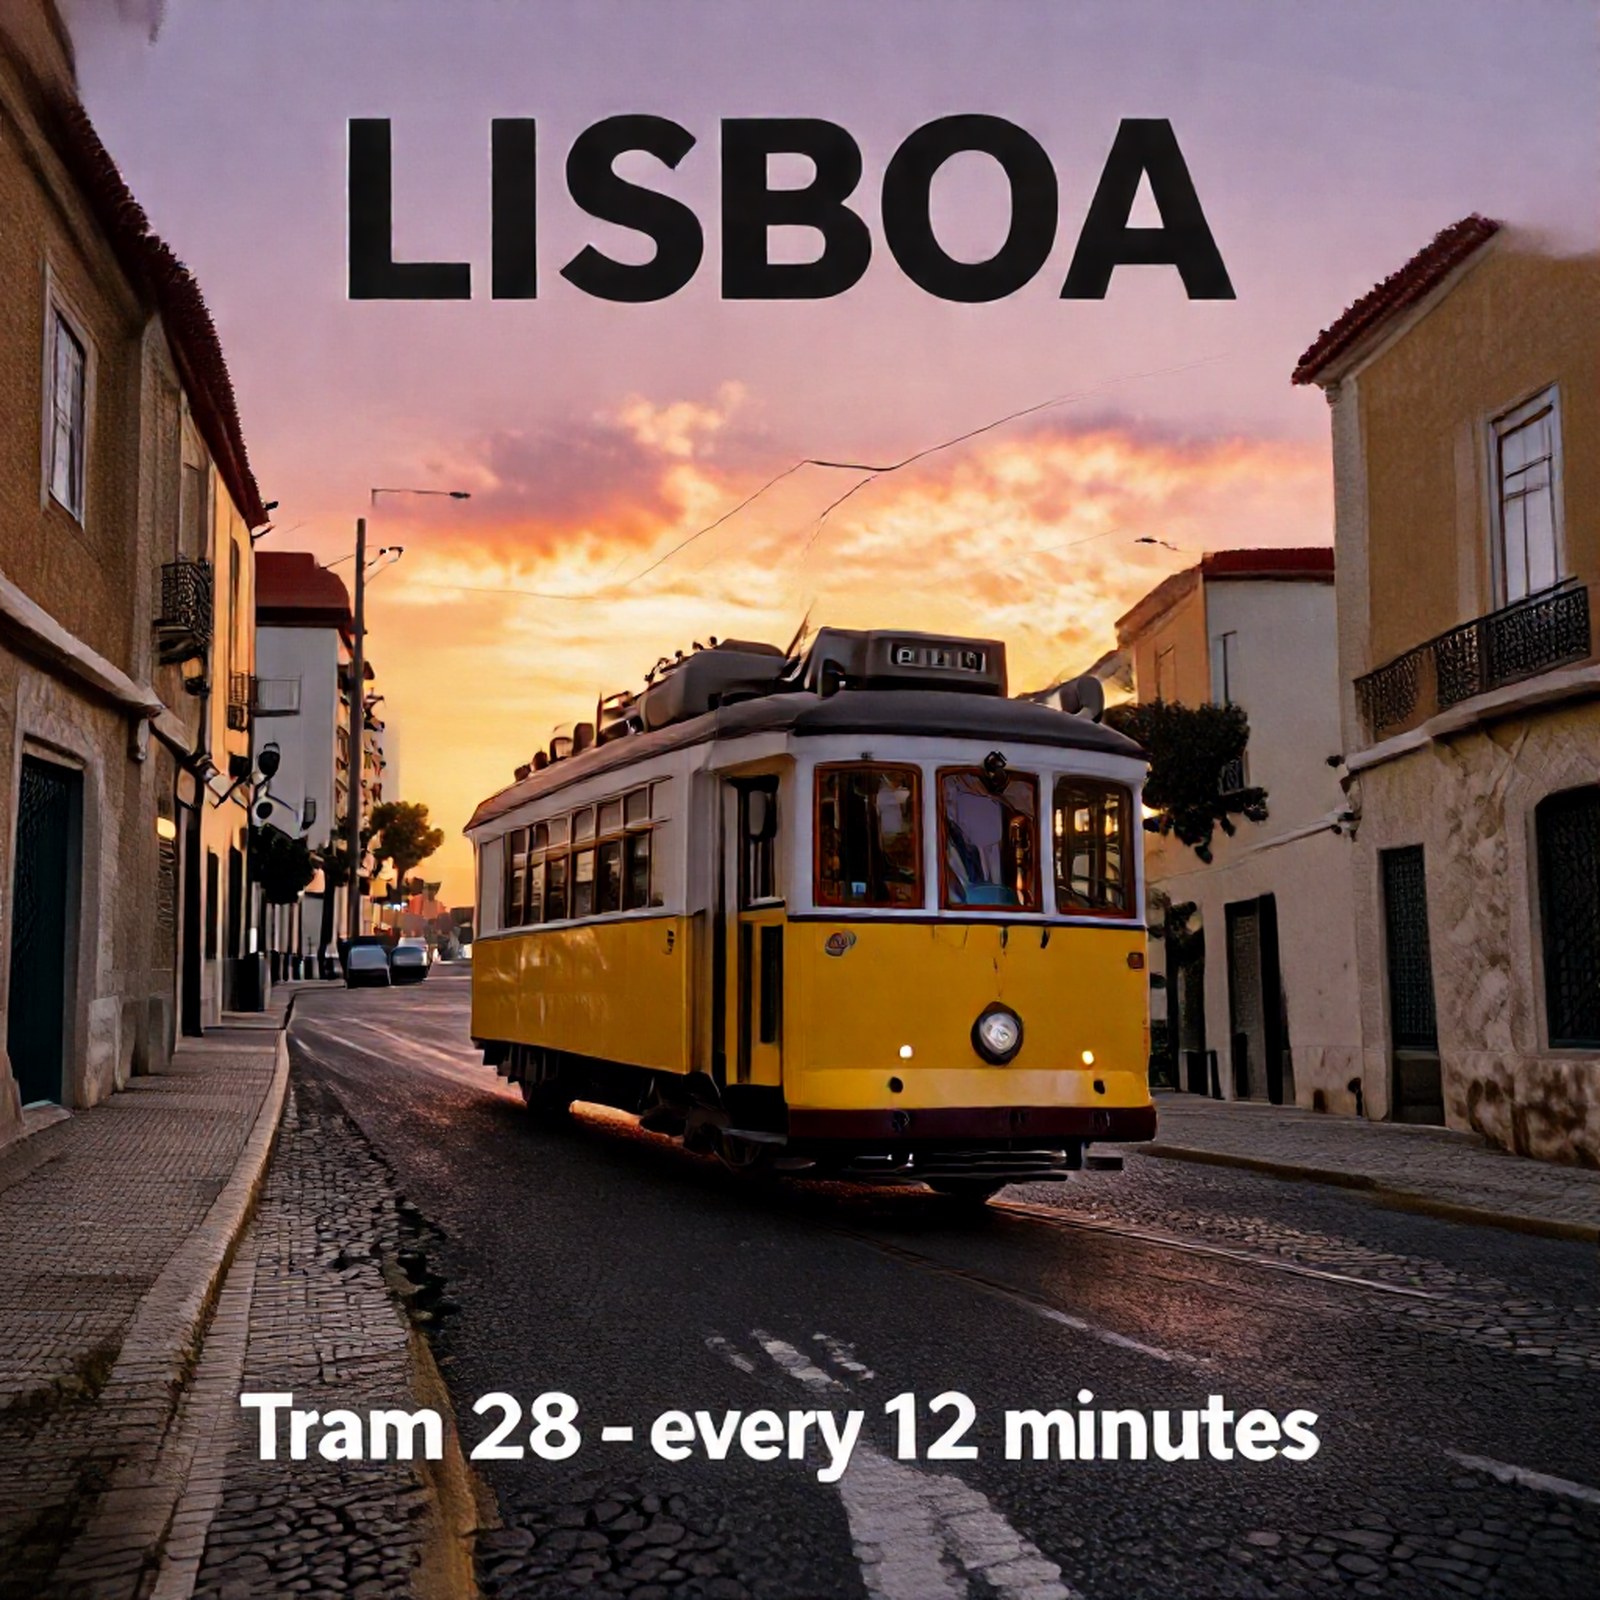
L'affiche du tram a eu "LISBOA" et "Tram 28 - every 12 minutes" justes en une étape, en deux étapes, et sur la carte de 16 GB. Le prompt de portrait des auteurs est sorti propre en une et deux étapes.
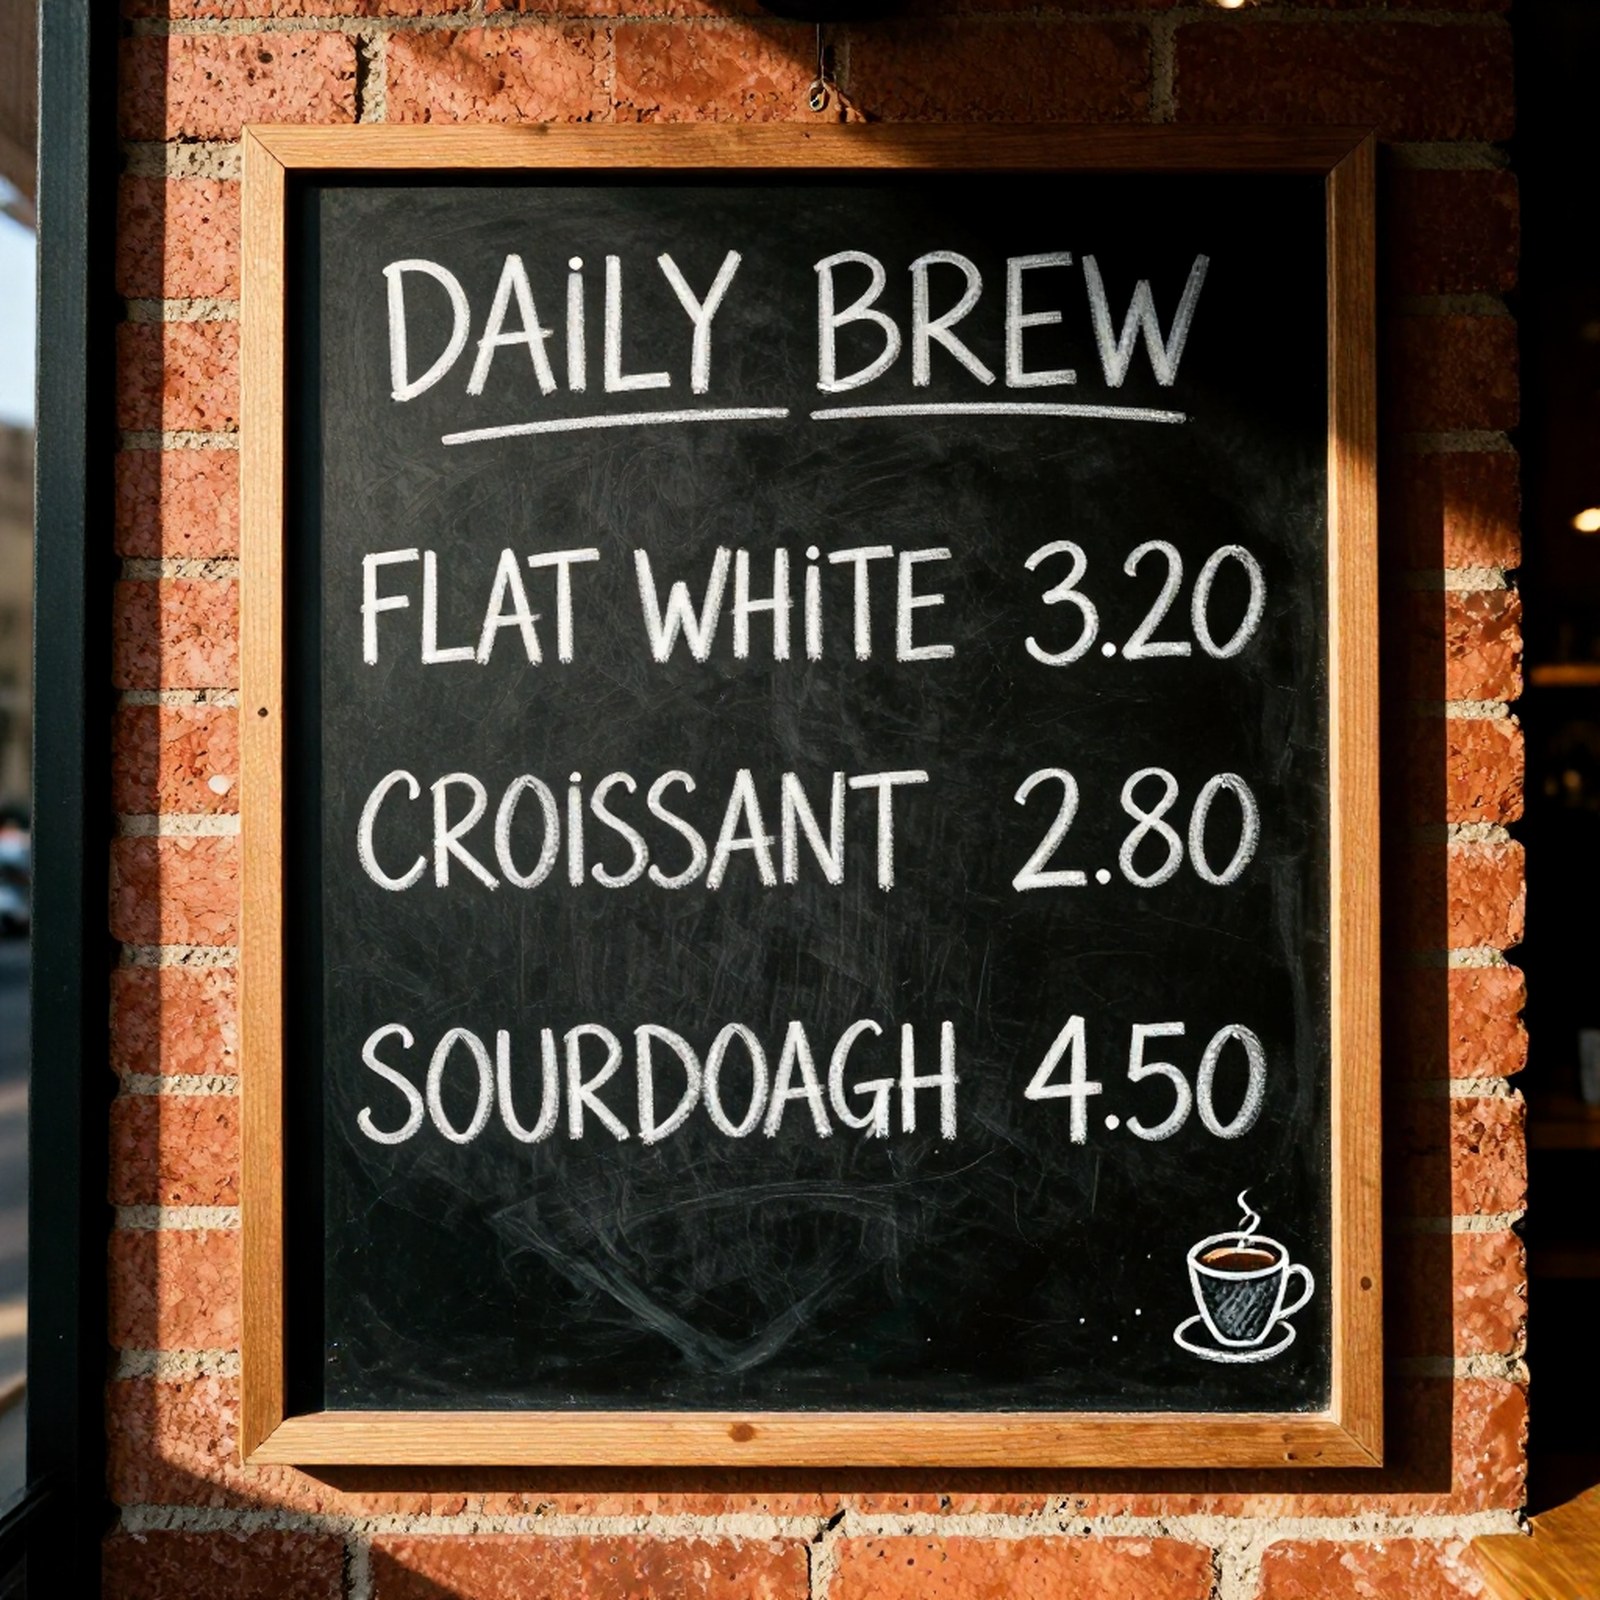
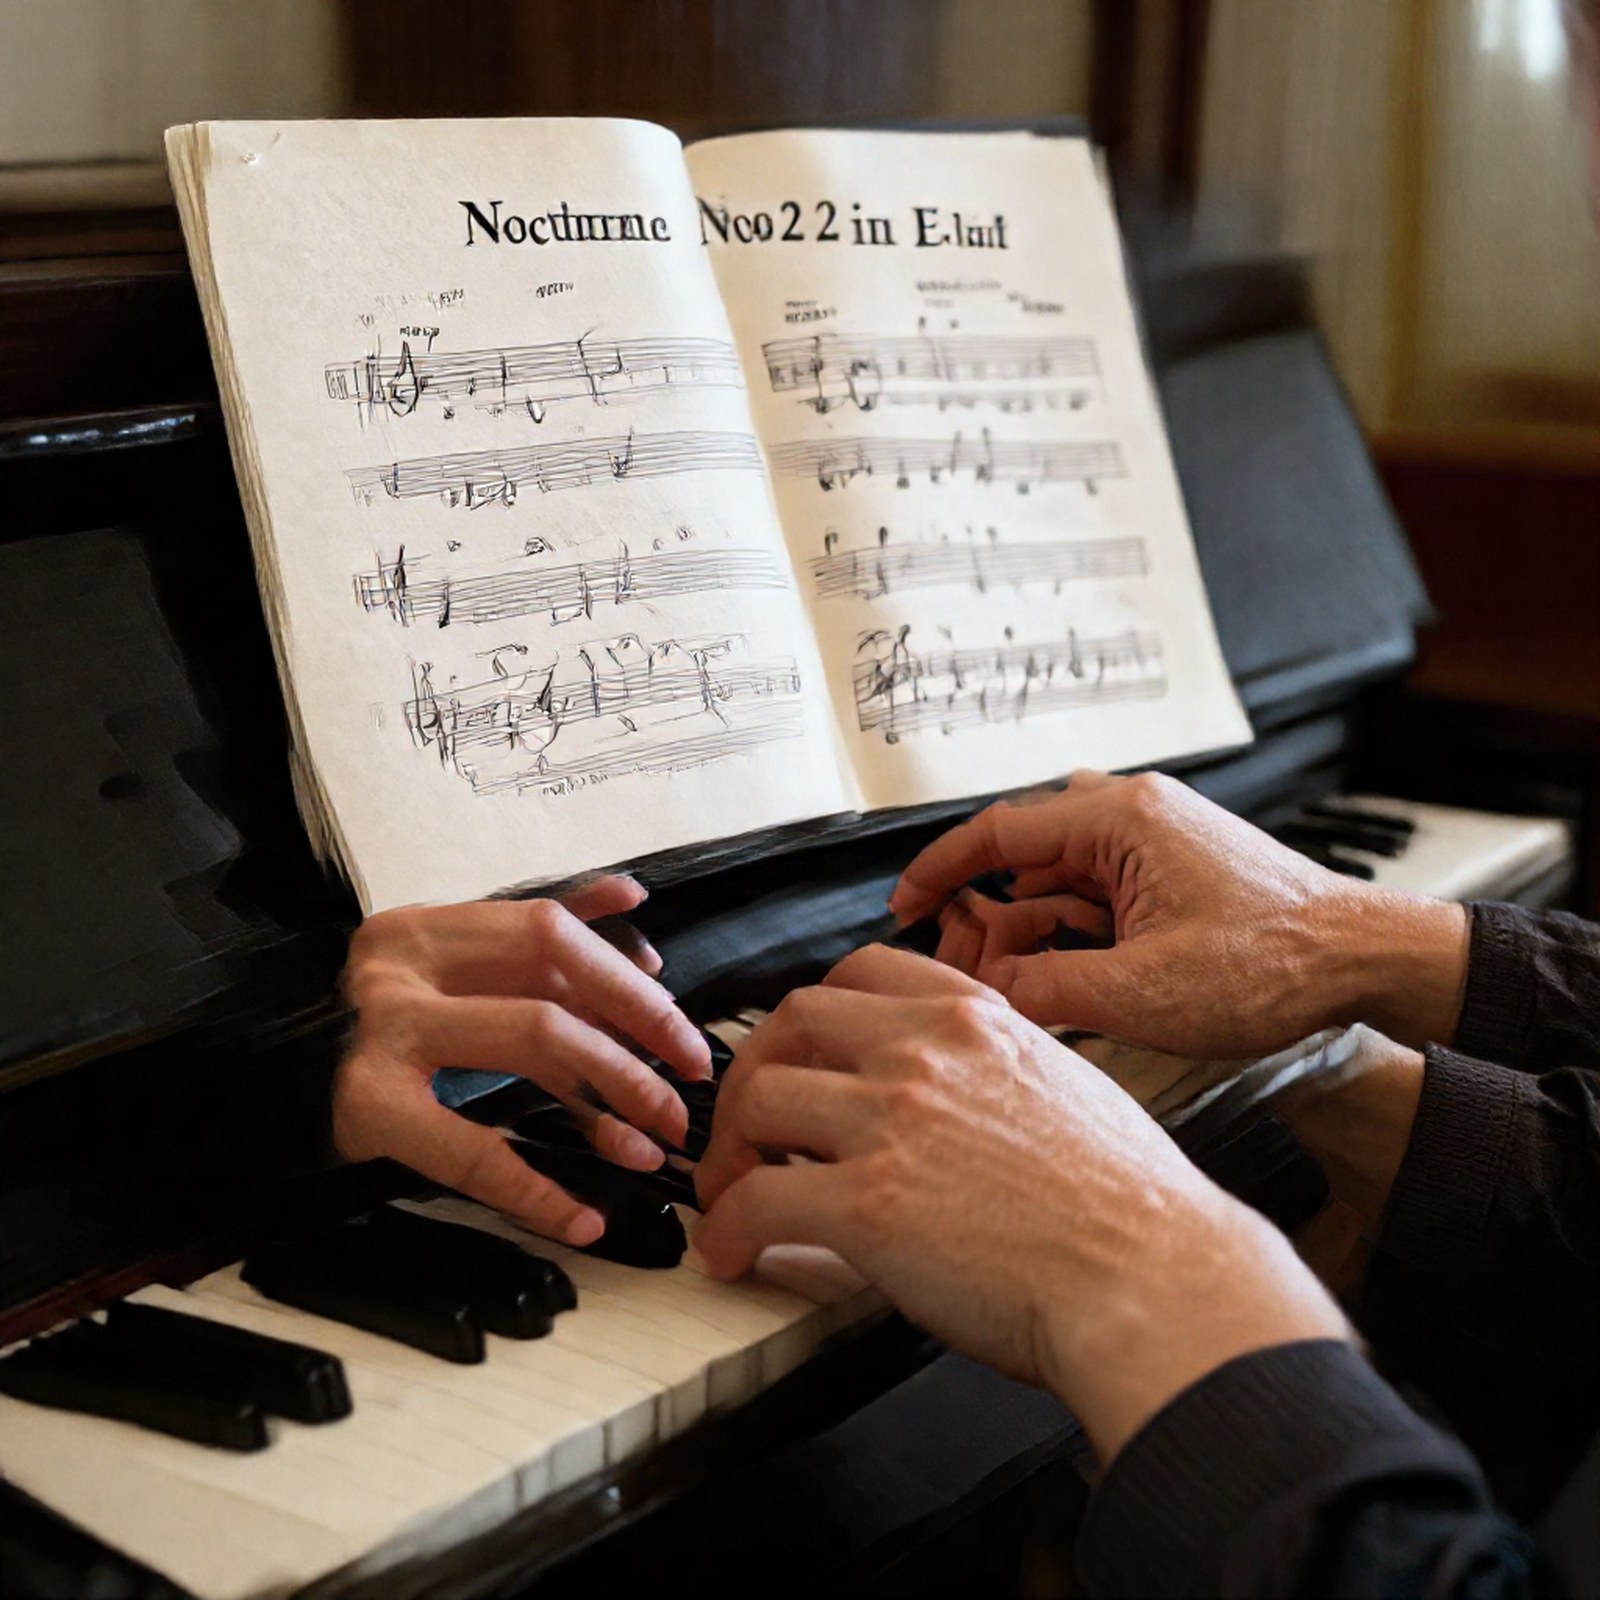
Le menu de café montre la limite. Il demandait "FLAT WHITE 3.20 / CROISSANT 2.80 / SOURDOUGH 4.50". Sur la 4090, tous les modes essayés ont écrit "SOURDOAGH" : une étape, deux étapes, quatre étapes, et deux étapes sans le module complémentaire. Les prix et les autres mots étaient justes. Sur la carte de 16 GB, une étape a aussi écrit "CROSSANT". Sur la partition, le petit titre "Nocturne No. 2 in E-flat" était illisible en une étape et encore imparfait en deux.
Une précaution sur les seeds. La même seed donne des pixels différents sur un autre GPU. Sur la carte de 16 GB, la pancarte en une étape est sortie juste, "HELLO WORLD". Une seed par prompt, c'est un contrôle de comportement, pas un benchmark. Retenez la tendance : un texte court et grand passe en général en une étape, une deuxième étape corrige certaines erreurs, et un texte petit ou long doit être vérifié à chaque fois.
Quel GPU : une vraie carte de 16 GB fonctionne avec la copie de 5 GB, à 4 secondes par image
La plus petite vraie carte qui a fonctionné est une RTX 2000 Ada de 16 GB, une petite carte de station de travail de 70 watts. Elle a fait tourner la copie de 5 GB avec tout gardé sur la carte, environ cinq fois plus lentement que la 4090. Il lui restait moins d'un demi-gigaoctet de mémoire libre. Sur la 4090 bridée, la copie de 5 GB prenait environ 1 seconde : l'essentiel des 4 secondes sur la petite carte vient donc de la puce plus lente.
Pourquoi pas simplement le fichier de 12,3 GB sur une carte de 16 GB ? Le fichier de 12,3 GB n'est qu'une partie de la charge. Le lecteur de texte de Z-Image-Turbo (la partie qui lit le prompt) ajoute environ 8 GB, si bien que la configuration avec le fichier complet de 12,3 GB a culminé à environ 23 GB. Il faut une carte de 24 GB pour tout garder sur le GPU. Déplacer des parties vers la mémoire système entre deux utilisations permet de faire tourner le fichier complet sous une limite de 16 GB, mais à 14 à 19 secondes par image. La copie plus grande de 7,2 GB des auteurs n'a pas tenu non plus : sous une limite de 16 GB, elle a manqué de mémoire dès la première image. Avec le lecteur de texte sur la carte, c'est la copie de 5 GB qui laisse de la place.
| Carte ou budget mémoire | Configuration | Temps par image (1 étape, 2 étapes) | Vraie carte ? |
|---|---|---|---|
| RTX 2000 Ada 16 GB | copie de 5 GB, tout sur la carte | 4,0 s, 7,3 s | oui |
| Budget 16 GB | fichier complet de 12,3 GB, parties déplacées vers la mémoire système entre deux utilisations | 14 à 19 s | non, une limite sur la 4090 |
| Budget 12 GB | copie de 5 GB, parties déplacées vers la mémoire système entre deux utilisations | 7,5 à 10,5 s | non, une limite sur la 4090 |
Un budget de 8 GB échoue : le lecteur de texte seul fait environ 8 GB, il ne reste donc rien pour le reste. Nous n'avions pas de vraie carte de 12 GB, et nous n'avons essayé ni les copies plus petites de 2 GB à 4 GB ni un lecteur de texte plus petit pour les cartes de 8 GB.
Sur InferenceKey : prêt en 67 secondes, et deux réglages à changer
Une machine GPU neuve sur la plateforme était prête à servir 67 secondes après la demande. Ces 67 secondes couvrent l'installation Python (28 s), le téléchargement d'environ 20 GB de poids (33,8 s) et le chargement (4,4 s). Elle ne télécharge que ce qu'utilise NitroFusion2 et saute les 24,6 GB de Z-Image-Turbo qu'il remplace. Sur la carte de 16 GB, le même chemin a pris 76 secondes.
Rien d'intégré ne sert ce modèle, alors nous avons écrit un petit fichier Python qui indique à la plateforme comment le charger et répondre aux requêtes. Il suit les réglages des auteurs, y compris le module complémentaire à demi-intensité sur la première étape. La plateforme elle-même n'a eu besoin d'aucune modification. C'était une copie locale de notre stack, pas le service hébergé.
Le problème sur lequel vous tomberez : le testeur d'images du tableau de bord démarre à 20 étapes et à un guidage (la force avec laquelle il pousse vers le prompt) de 4,5, ce qui ne convient pas à ce modèle. NitroFusion2 refuse 20 étapes avec une erreur : il n'accepte que 1 à 4. Réglez les étapes sur 1 ou 2 et le guidage sur 0, et le testeur a renvoyé l'affiche en une étape en environ 1,1 seconde. Statut : documenté dans le README de l'exemple, les valeurs par défaut du testeur sont inchangées.
Faut-il l'utiliser ? Une étape pour les aperçus, deux pour tout ce qui contient des mots
- Aperçus, miniatures, brouillons en direct : une étape, moins d'une seconde de temps GPU.
- Images avec un texte court et grand livrées à des clients : deux étapes, et vérifiez-les.
- Menus, étiquettes, prix, petits caractères : ni l'un ni l'autre. Ajoutez le texte vous-même par-dessus, ou essayez Z-Image-Turbo à huit étapes.
- Une carte de 16 GB : la copie de 5 GB, et dites à l'exemple de tout garder sur la carte, sinon il se rabat sur un chemin beaucoup plus lent.
- Une carte de 8 GB : pas avec cette configuration.
Pour produire les images de la pancarte et du menu sur votre propre carte, lancez l'exemple NitroFusion2 du SDK. Il lui faut une carte NVIDIA de 24 GB, ou de 16 GB avec la copie de 5 GB, et environ 27 GB de disque (32 GB avec la copie de 5 GB).
Pour les ingénieurs
Crédits
- Dar-Yen Chen et Yi-Zhe Song (SketchX, CVSSP, Université du Surrey ; Turing Elite Research Labs) : NitroFusion2, l'article "NitroFusion2: Bringing Adversarial Loss to the Text Stream of Multimodal Diffusion Transformers" (arXiv 2611.05648, CC BY 4.0), les poids (Apache-2.0), la LoRA de dé-distillation (le module complémentaire de 0,38 GB), les fichiers GGUF, le code et
inference.py(Apache-2.0), quatre workflows ComfyUI et la page du projet. Il s'appuie sur NitroFusion (Dar-Yen Chen, Hmrishav Bandyopadhyay, Kai Zou et Yi-Zhe Song, CVPR 2025). - Tongyi-MAI : Z-Image-Turbo (Apache-2.0), dont le pipeline réutilise l'encodeur de texte, le tokenizer, le VAE et le scheduler.
- Les mainteneurs de diffusers :
ZImagePipeline, le chargeur de LoRA Z-Image et le chargement GGUF en fichier unique dans diffusers 0.42.1. - PedroMarinhoDev : des builds ComfyUI communautaires int8, W6A8 et W4A8 (non testés par nous).
- AI Search : là où nous l'avons repéré (2026-11-08 AI NEWS, chapitre à 03:50).
- Notre part : le backend personnalisé, le déploiement via la plateforme, les chronométrages, l'échelle de mémoire, les contrôles de qualité, l'exemple du SDK et la vidéo de démo.
Modèle et fichiers
ChenDY/NitroFusion2: sha62d1a7000af9c46a0c4348d936bd7670ff33c1b9, créé le 2026-10-27, dernière modification le 2026-11-08, sans accès restreint, apache-2.0, bibliothèque diffusers, pipeline text-to-image, modèle de baseTongyi-MAI/Z-Image-Turbo. Publication indiquée sur la page : 2026-11-03.- Transformer :
ZImageTransformer2DModelde diffusers, 6 154 908 736 paramètres (la Table 1 de l'article dit 6B, comme Z-Image-Turbo). Bf16 en 3 shards : 4 986 858 288 + 4 986 868 776 + 2 336 146 728 B (12,31 GB). Fichier uniquenf2-bf16.safetensors12 309 866 400 B.nf2-BF16.ggufetnf2-F16.gguf12 311 939 136 B chacun. - Niveaux GGUF (GB) : Q2_K_4XS 2,04, Q2_K_3XS 2,30, Q2_K_2XS 2,70, Q2_K_XS 3,00, Q2_K_S 3,30, Q2_K_M 3,60, Q2_K_L 4,01, Q3_K_S 4,36, Q3_K_M 4,56, Q3_K_L 4,60, Q4_0 4,59, Q4_K_S 4,79, Q4_1 4,85, Q4_K_M 5,07, Q5_0 5,26, Q5_K_S 5,29, Q5_1 5,53, Q5_K_M 5,58, Q6_K 6,10, Q8_0 7,22.
nf2-dedistill-lora.safetensors: 381 553 336 B.- Z-Image-Turbo sha
f332072a: encodeur de texte Qwen3 en 3 shards (environ 8,05 GB), VAE 167 666 902 B, son propre transformer d'environ 24,6 GB (F32), que notre backend ne télécharge pas. Sa page revendique une latence inférieure à la seconde sur une H800 et une place sur les appareils grand public de 16 GB. L'exemple diffusers de sa page utilisenum_inference_steps=9("This actually results in 8 DiT forwards") etguidance_scale=0.0. - Recette des auteurs (
inference.py, identique sur la branche main GitHub) : étapes 1 à 4 uniquement, décalage du scheduler {1: 3.0, 2: 6.0, 3: 8.0, 4: 9.0}, sigmas1 - i/steps, guidage 0.0, échelles de LoRA {1: (0.0,), 2: (0.5, 0.0), 3: (0.5, 0.6, 0.0), 4: (0.5, 0.6, 0.7, 0.0)}, 1024 x 1024 et 2 étapes par défaut,pipe.enable_model_cpu_offload()dans__main__. - Méthode : Text-Stream Adversarial Distillation (des têtes de discriminateur sur les états intermédiaires des tokens de texte du MMDiT gelé) et Aspect-Cued Discrimination (le discriminateur est conditionné par des indices de typographie, d'objet, de style, d'arrière-plan, d'action et de mise en page).
- Entraînement selon l'article : 100k références synthétiques de Z-Image-Turbo à 12 étapes (EN/CN), légendes par Qwen3.5-35B-A3B, Adam lr 5e-5, batch 256, huit H100, 20 000 étapes (5 000 off-policy, 15 000 on-policy). Pas de code d'entraînement dans le dépôt.
- Limites indiquées par l'article : les scènes complexes restent difficiles, surtout en une étape ; une diversité d'échantillons plus faible (diversité OneIG sous les deux références en 1 et 2 étapes) ; un effet de bascule entre les indices ACD.
Table 1 de l'article (chiffres des auteurs, non reproduits par nous ; le texte l'appelle Table 2) :
| Modèle | NFE | LongText-EN | LongText-CN | GenEval | DPG-Bench | OneIG |
|---|---|---|---|---|---|---|
| NitroFusion2 | 1 | 43,34 | 47,78 | 75,86 | 86,48 | 47,63 |
| Z-Image-Turbo | 1 | 11,72 | 12,70 | 57,08 | 77,23 | 32,43 |
| TwinFlow | 1 | 29,18 | 36,85 | 66,34 | 85,17 | 42,20 |
| NitroFusion2 | 2 | 76,03 | 81,95 | 74,46 | 86,21 | 51,45 |
| Z-Image-Turbo | 2 | 72,89 | 78,48 | 76,53 | 85,78 | 50,94 |
| Z-Image-Turbo++ (6B+6B) | 2 | 89,88 | 91,62 | 75,70 | 85,86 | 52,50 |
| Z-Image-Turbo | 8 | 91,74 | 92,56 | 75,01 | 84,86 | 52,84 |
Installation et pourquoi
- GPU : une RTX 4090 sur InferenceKey Cloud. La carte a indiqué
NVIDIA GeForce RTX 4090, 49140 MiB(la variante 48 GB), donc le workload principal a tourné avecNF2_VRAM_LIMIT_GIB=23.4pour tenir lieu de carte de 24 GB. Aucune carte standard de 24 GB n'a été utilisée. Le pipeline bf16 a besoin d'environ 22 GiB résidents, d'où un budget de 24 GB comme référence. Ensuite une vraie RTX 2000 Ada 16 GB (16 380 MiB, 70 W) pour le contrôle sur petite carte. - Backend : un nouveau backend Python personnalisé,
NitroFusion2Backend0.1.0 (paquet de 5 600 B), surZImagePipelinede diffusers 0.42.1, avec le transformer NitroFusion2 et la LoRA comme adaptateurdedistill. Versions épinglées : torch 2.14.1, transformers 5.21.0, accelerate 1.15.0, peft 0.21.2, gguf 0.19.0. Pourquoi un backend personnalisé : aucun backend intégré ne sert le pipeline Z-Image. Pourquoi diffusers : c'est le chemin des auteurs eux-mêmes, et la 0.42.1 a le pipeline, le chargeur de LoRA et le GGUF en fichier unique pour ce transformer. - Modes mémoire (
NF2_MEMORY_MODE) :gpu(tout résident),model(enable_model_cpu_offload, le défaut du script des auteurs),sequential. Le défautautochoisitgpuseulement avec au moins 23 GiB libres, sinonmodel. Sur une carte de 16 GB, réglez explicitementNF2_TRANSFORMER=nf2-Q4_K_M.ggufetNF2_MEMORY_MODE=gpu, sinonautose rabat sur l'offload et vous perdez le chemin à 4 s. - Stack : un manager InferenceKey local, nats-proxy et un worker compilés depuis main
97aec23e. La production n'a jamais été touchée. - Champs de la requête (style images OpenAI) :
prompt(obligatoire),size("1024x1024", côtés de 256 à 2048, multiples de 16),seed,stepsounum_inference_steps(1 à 4, 2 par défaut),dedistill(true par défaut),output_format(png,jpeg,webp). Le guidage vaut toujours 0. La réponse ajouteseconds,encode_seconds,vae_seconds,vram_peak_gibetmemory_mode. Endpoint :POST /endpoint/<project>/nitrofusion2/v1/images/generations.
Pas à pas avec l'exemple du SDK
L'exemple correspond au commit 1ca451bd sur main de inferencekey-sdk : backend.py, publish.py, main.py, requirements.txt, README.md, .env.example.
cp .env.example .env    # INFERENCEKEY_SDK_TOKEN, INFERENCEKEY_API_KEY,
                        # INFERENCEKEY_PROJECT, IK_WORKER_ID (read by main.py)
# publish.py does not read .env: export these two in the shell
export INFERENCEKEY_TENANT_ID=<tenant-id>
export INFERENCEKEY_USER_TOKEN=<dashboard-session-token>
python publish.py       # packages backend.py into dist/ and uploads it to your tenant
IK_KEEP_ALIVE=1 python main.py
Sans INFERENCEKEY_TENANT_ID et INFERENCEKEY_USER_TOKEN, publish.py se contente de construire dist/*.tar.gz, affiche "upload the package from Dashboard -> Custom backends instead" et sort avec le code 0. Dans ce cas, envoyez le fichier depuis Dashboard -> Custom backends avant de lancer main.py, sinon ensure() n'a aucun backend à déployer.
Pour une carte de 16 GB, ajoutez à .env avant main.py :
NF2_TRANSFORMER=nf2-Q4_K_M.gguf
NF2_MEMORY_MODE=gpu
main.py appelle ensure() pour un workload fixe sur IK_WORKER_ID avec ready_timeout_secs: 2400, request_timeout_secs: 600 et l'environnement NF2_*, attend avec wait_until_ready(2400), puis fait trois appels en 1024 x 1024 avec la seed 42 : la pancarte en 1 étape, le menu en 1 étape et le menu en 2 étapes. Il supprime le workload à la sortie, sauf avec IK_KEEP_ALIVE=1. Disque : environ 21 GB de poids (26 GB avec le fichier Q4_K_M en plus) plus un venv de 5,5 GB.
Une seule requête :
curl -s https://<api-host>/endpoint/<project>/nitrofusion2/v1/images/generations \
  -H "Authorization: Bearer $INFERENCEKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"prompt": "a cat holding a sign that says hello world",
       "size": "1024x1024", "steps": 2, "seed": 42}'
Mesures complètes
Délai jusqu'à prêt :
- RTX 4090 : "ready after 67 s" côté SDK. Venv 28 s (CPython 3.12.3), puis
download 33.8s, load 4.4s, transformer bf16, memory mode gpu (budget 23.4 GiB), weights in VRAM 19.5 GiB. Cache HF d'environ 20 GB. - RTX 2000 Ada : "ready after 76 s".
download 28.4s, load 23.0s, transformer nf2-Q4_K_M.gguf, memory mode gpu (budget 15.5 GiB), weights in VRAM 12.7 GiB.
Par requête, 1024 x 1024, seed 42, une à la fois. Temps GPU mesuré dans le backend avec cuda.synchronize, aller-retour depuis le client HTTP jusqu'au manager local.
| Carte / config | Cas | GPU s | Aller-retour s | Encodeur de texte s | VAE s | Pic torch GiB |
|---|---|---|---|---|---|---|
| 4090 bf16 | pancarte, 1 étape, premier appel | 1,72 | 3,43 | 0,638 | 0,379 | 21,86 |
| 4090 bf16 | menu, 1 étape, x6 | 0,780 à 0,816 | 1,45 à 1,50 | 0,05 à 0,064 | 0,149 | 21,86 |
| 4090 bf16 | menu, 2 étapes, x6 | 1,318 à 1,330 | 1,95 à 2,00 | environ 0,055 | 0,149 | 21,86 |
| 4090 bf16 | pancarte/portrait/affiche/mains, 2 étapes | 1,312 à 1,326 | 1,90 à 1,99 | 0,149 | 21,86 | |
| 4090 bf16 | portrait/affiche/mains, 1 étape | 0,783 | 1,47 à 1,52 | 0,149 à 0,15 | 21,86 | |
| 4090 bf16 | menu, 2 étapes, sans LoRA | 1,341 | 2,01 | 21,86 | ||
| 4090 bf16 | menu, 4 étapes | 2,419 | 3,08 | 21,86 | ||
| RTX 2000 Ada, Q4_K_M | 1 étape (x5) | 3,98 à 4,33 (5,16 au premier) | 4,66 à 4,91 (7,06 au premier) | 0,21 à 0,25 | 0,57 à 0,60 | 15,11 |
| RTX 2000 Ada, Q4_K_M | 2 étapes (x5) | 7,19 à 7,42 | 7,83 à 8,32 | environ 0,21 | 0,57 à 0,74 | 15,11 |
Dérivé de ces chiffres, requêtes uniques, sans batching : environ 1,2 à 1,3 image par seconde de temps GPU en 1 étape (0,67 à 0,69 en aller-retour) et environ 0,75 en 2 étapes (0,50 à 0,51 en aller-retour). Le testeur d'images du tableau de bord a affiché "ok · 1098 ms" pour l'affiche en 1 étape.
Échelle de VRAM. Les échelons émulés ont tourné dans un processus séparé sur la 4090 de 48 GB avec torch.cuda.set_per_process_memory_fraction, à côté du workload en service, donc leurs temps peuvent inclure un peu de contention. Chaque échelon a fait tourner la pancarte et le menu en 1 et 2 étapes, deux fois, seed 42.
| GPU ou limite | Configuration | Pic de VRAM | Temps par image | Sortie | Réel ou émulé |
|---|---|---|---|---|---|
| RTX 4090, limite 23,4 GiB | bf16, tout sur le GPU, via la plateforme | 21,86 GiB torch | 0,78-0,82 s (1), 1,32-1,33 s (2) | ok, référence | vraie carte sous limite |
| 15,2 GiB | bf16 + enable_model_cpu_offload | 12,30 GiB / 13 122 MiB | 14,2-19,4 s | ok, mêmes images | émulé |
| 15,2 GiB | GGUF Q8_0, tout sur le GPU | CUDA out of memory. Tried to allocate 80.00 MiB ... 15.20 GiB allowed à la première requête (installation 37,3 s) | émulé | ||
| 15,2 GiB | GGUF Q4_K_M, tout sur le GPU | 15,11 GiB / 16 008 MiB | 0,95-1,03 s (1), 1,64-1,71 s (2) | ok, même texte qu'en bf16 | émulé |
| RTX 2000 Ada 16 GB | GGUF Q4_K_M, tout sur le GPU, via la plateforme | 15,11 GiB / 15 948 MiB carte | 3,98-4,33 s (1), 7,19-7,42 s (2) | ok | réel |
| 11,2 GiB | Q4_K_M + offload du modèle | 7,69 GiB / 8 366 MiB | 7,5-10,5 s | ok, même texte | émulé |
| 7,2 GiB | Q4_K_M + offload du modèle | Tried to allocate 48.00 MiB ... 7.20 GiB allowed (l'encodeur de texte bf16 seul fait environ 7,5 GiB) | émulé | ||
| 7,2 GiB | Q4_K_M + offload séquentiel | échec à l'installation : KeyError: None | émulé |
Non essayé : un encodeur de texte quantifié ou sur CPU pour 8 GB ; des résolutions autres que 1024 ; les builds ComfyUI communautaires int8, W6A8 et W4A8 ; des tailles de batch au-dessus de 1 et la concurrence ; de vraies cartes de 12 GB et des cartes standard de 24 GB (aucune carte de 10 à 12 GB n'était disponible) ; les niveaux GGUF Q2, Q3, Q5 et Q6 ; Q8_0 avec offload ou sur une carte de 24 GB ; Z-Image-Turbo à 8 étapes.
Notes de qualité (une seed par cas, pas un benchmark)
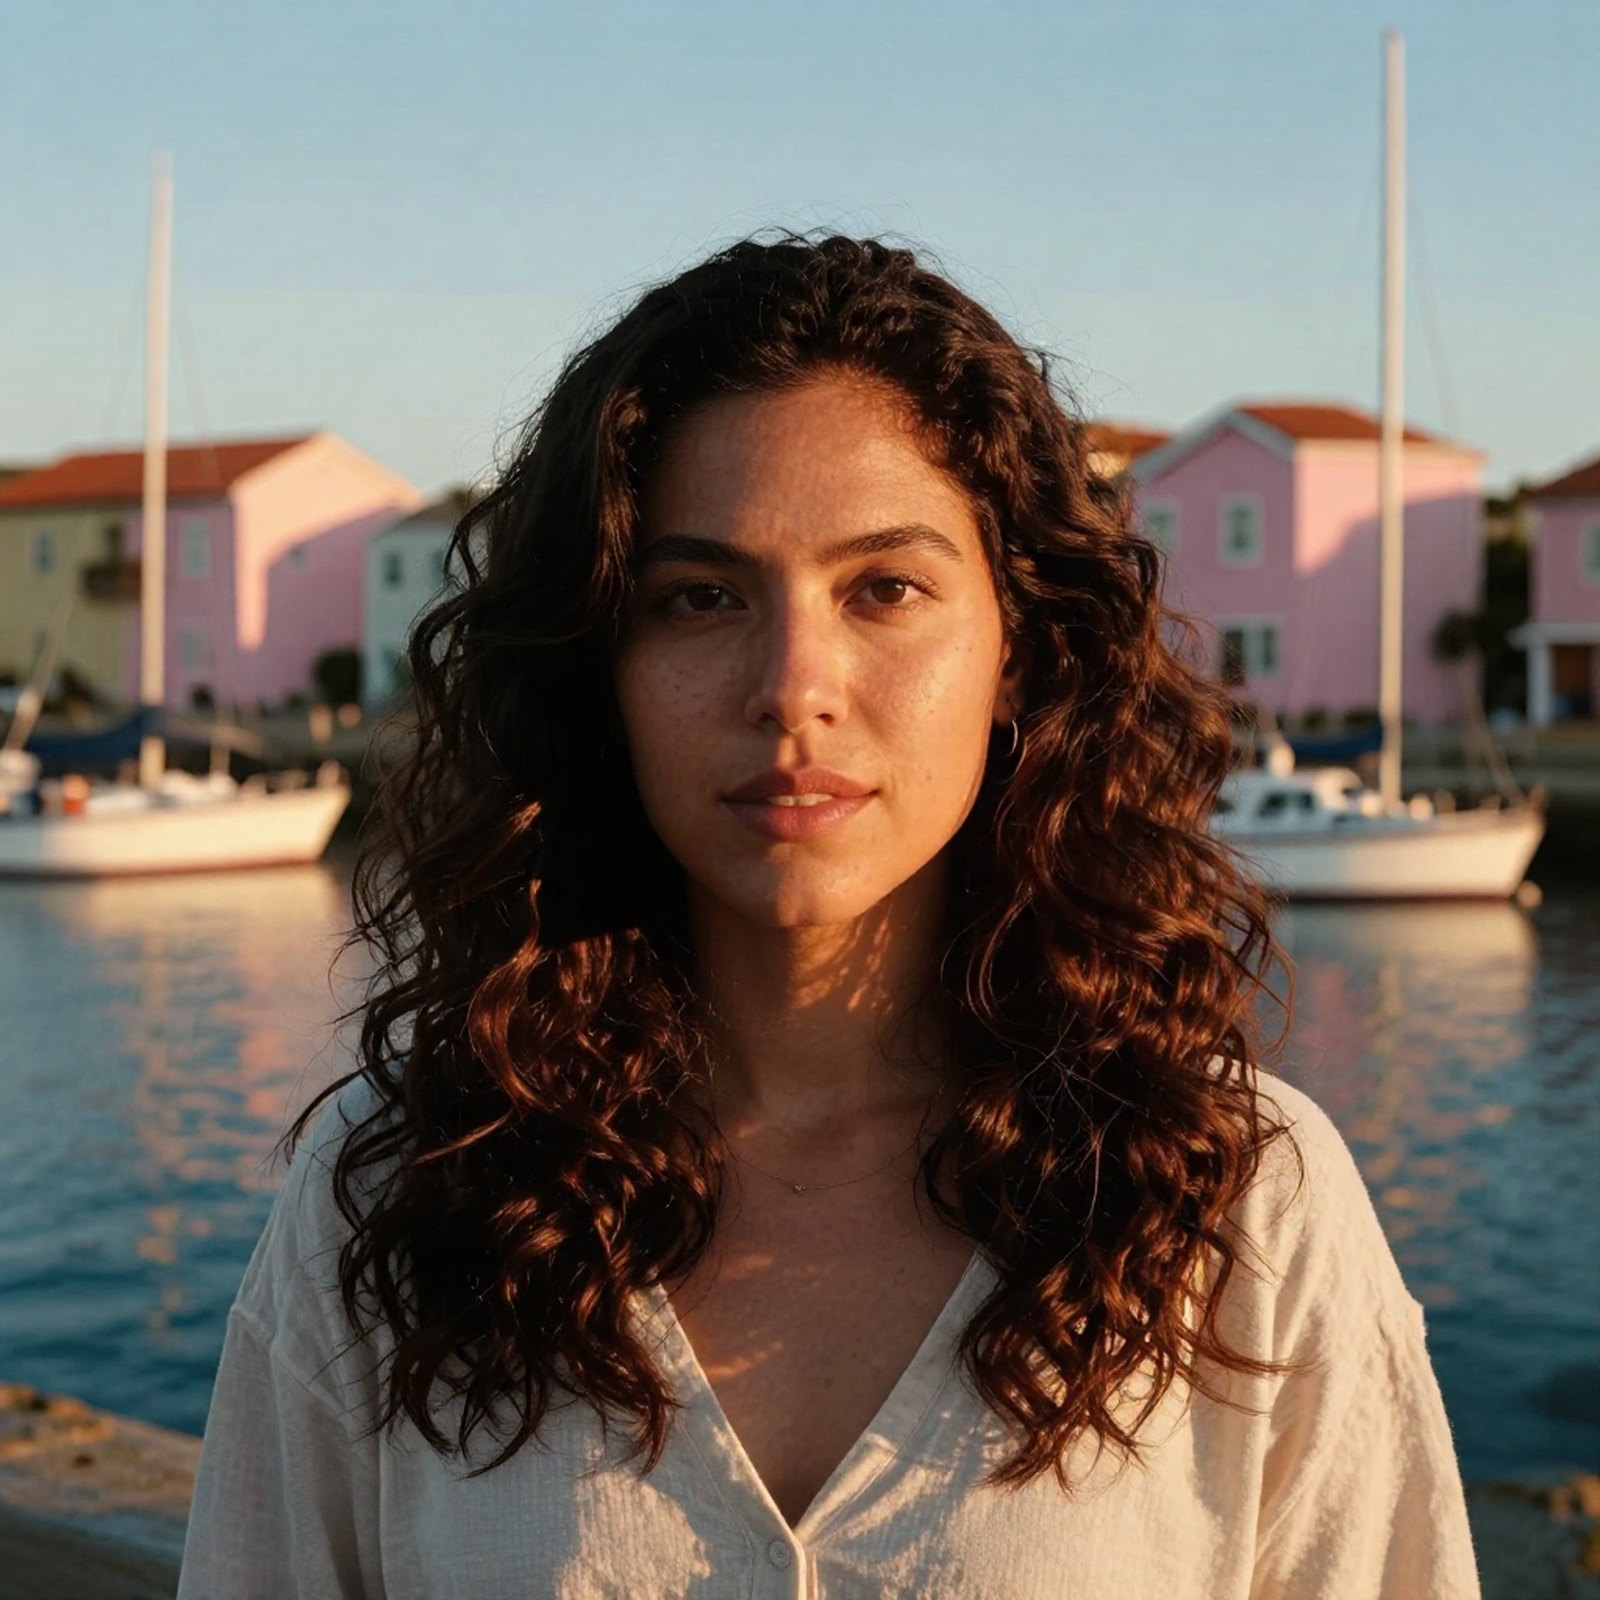
Prompts : la pancarte du chat et le portrait des auteurs, plus quatre des nôtres (un menu de café sur ardoise, une affiche du tram de Lisbonne, une partition sur un piano, une paire de mains).
- Pancarte (prompt des auteurs "a cat holding a sign that says hello world") : 4090 en 1 étape "HELLO WORd" (L manquant, d minuscule, H baveux), en 2 étapes "Hello World". Les échelons Q4 sur la 4090 ont donné le même texte que le bf16. RTX 2000 Ada Q4 : 1 étape "HELLO WORLD", 2 étapes juste.
- Menu ("FLAT WHITE 3.20 / CROISSANT 2.80 / SOURDOUGH 4.50") : "SOURDOAGH" en 1, 2 et 4 étapes et en 2 sans LoRA sur la 4090. RTX 2000 Ada en 1 étape : "CROSSANT" et un "0" parasite sous 4.50 ; en 2 étapes "SOURDOAGH".
- Affiche : "LISBOA" et "Tram 28 - every 12 minutes" justes en 1 et 2 étapes et sur la carte de 16 GB.
- Piano : titre "Nocturne No. 2 in E-flat" illisible en 1 étape, encore imparfait en 2. Mains plausibles.
- Portrait (prompt des auteurs) : propre en 1 et 2 étapes.
Vidéo de démo
Une présentation commentée de 3 minutes : ce qu'est NitroFusion2 (avec la page du projet des auteurs, leurs figures et leur Table 1, crédités), le panneau qui génère en 1 et 2 étapes, et l'échelle de mémoire.
Problèmes restants
- La 4090 était une variante de 48 GB. Le résultat à 24 GB est une limite (
NF2_VRAM_LIMIT_GIB=23.4), pas une carte standard de 24 GB. Statut : signalé, non retesté sur une carte de 24 GB. - Les valeurs par défaut du testeur d'images (20 étapes, guidage 4,5) renvoient 400
NitroFusion2 is distilled for 1 to 4 steps. Statut : documenté dans le README, valeurs par défaut de la plateforme inchangées. - Q8_0 ne tient pas dans 16 GB avec l'encodeur de texte bf16 résident. Statut : utiliser Q4_K_M.
- 8 GB échoue : OOM avec l'offload du modèle,
KeyError: Noneavec l'offload séquentiel et un transformer GGUF. Statut : ouvert, non essayé avec un encodeur de texte plus petit. - Erreurs de texte en une étape, et une faute ("SOURDOAGH") à tous les nombres d'étapes. Statut : comportement du modèle, conforme au retard sur le rendu du texte que reconnaît l'article.
- Mineur : notre premier SQL d'amorçage pour le tenant de test local a touché le tenant par défaut amorcé ; corrigé avant le redémarrage du manager, sans effet sur le test. Un
RuntimeWarningsans conséquence à propos deinferencekey.backend.servedanssys.modulesapparaît dans le stderr du backend.
Sources
- Page du modèle : https://huggingface.co/ChenDY/NitroFusion2
- Code et
inference.py: https://github.com/ChenDarYen/NitroFusion2 - Article : https://arxiv.org/abs/2611.05648
- Page du projet : https://chendaryen.github.io/NitroFusion2.github.io/
- Modèle de base : https://huggingface.co/Tongyi-MAI/Z-Image-Turbo
- Là où nous l'avons repéré : https://www.youtube.com/watch?v=9RIK3A24ZxA (AI Search, 2026-11-08, à 03:50)
- Exemple du SDK : https://github.com/inferencekey/inferencekey-sdk/tree/main/examples/nitrofusion2-text2image-custom-backend-private-nvidia