NitroFusion2 auf einer Karte: ein 1024-px-Bild in 0,78 s, ein korrektes Schild in zwei Schritten
Ein Schritt: 0,78 s GPU-Zeit auf einer RTX 4090, zwei Schritte 1,32 s, 4 s auf einer echten 16-GB-Karte. Mit einem Schritt gibt es mehr Tippfehler.
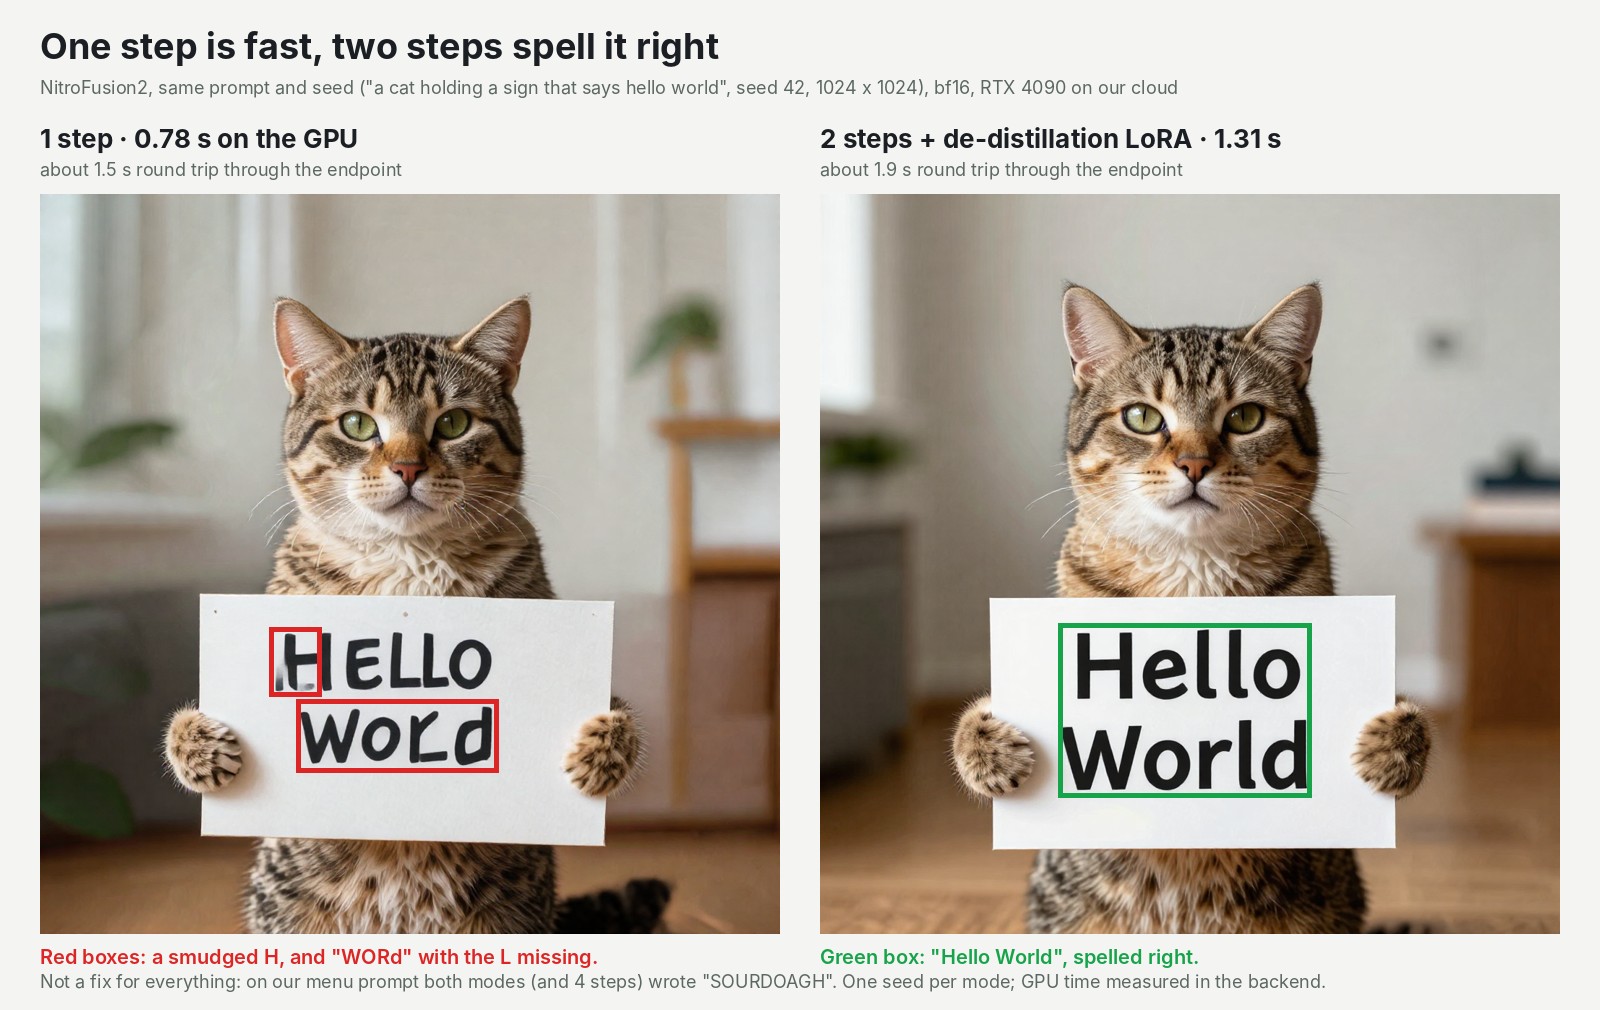
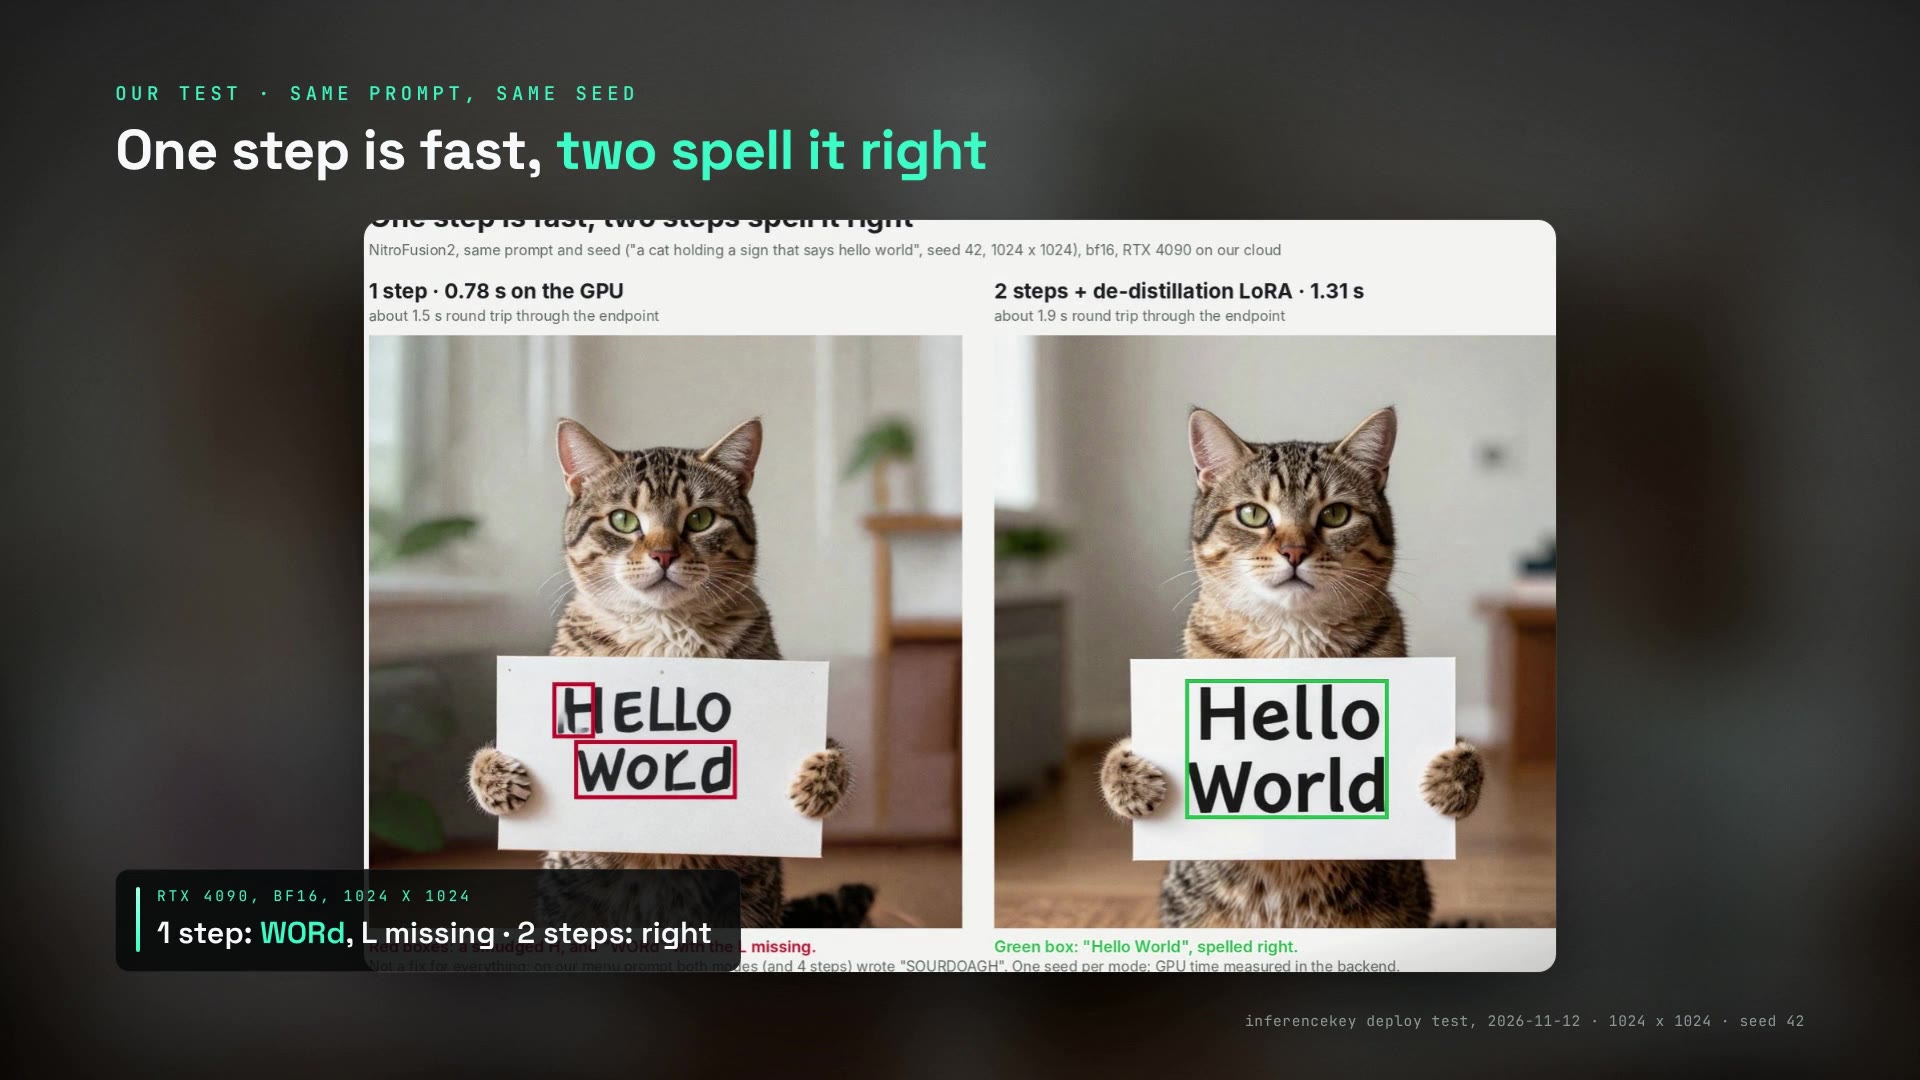
Eine Katze hält ein Pappschild mit der Aufschrift „HELLO WORd“. NitroFusion2 hat es in einem Schritt gezeichnet, in 0,78 Sekunden GPU-Zeit, auf einer RTX 4090 in unserer Cloud. Mit zwei Schritten brauchten derselbe Prompt und derselbe zufällige Startpunkt (der Seed) 1,31 Sekunden, und auf dem Schild stand „Hello World“. Dieses Paar zeigt den Kompromiss im Kleinen.
NitroFusion2 ist eine schnellere Kopie des offenen Z-Image-Turbo: ein oder zwei Durchläufe pro Bild statt acht. Wir haben NitroFusion2 gegen sich selbst gemessen, nicht gegen das Original mit acht Schritten. Wenn eine Anfrage nach der anderen bedient wird, liefert eine Karte über die API etwa 40 große Bilder pro Minute bei einem Schritt. Mit der komprimierten 5-GB-Kopie der Autoren läuft es auch auf einer echten 16-GB-Karte, mit etwa 4 Sekunden pro Bild. Auf deiner eigenen GPU ist die Geschwindigkeit also geklärt, entscheiden musst du, welche Bilder einen Tippfehler vertragen. Unser SDK-Beispiel stellt es als API auf deiner eigenen Karte bereit.
| 1024 x 1024, ein Bild nach dem anderen | Ein Schritt | Zwei Schritte (Rezept der Autoren) |
|---|---|---|
| GPU-Zeit, RTX 4090, volle 12,3-GB-Datei | 0,78 bis 0,82 s | 1,32 bis 1,33 s |
| Das Schild, Seed 42 | „HELLO WORd“ | „Hello World“ |
| Echte 16-GB-Karte, 5-GB-Kopie | etwa 4,0 s | etwa 7,3 s |
Zwei Durchläufe statt acht: ein Schüler, der gelernt hat, Arbeit zu überspringen
NitroFusion2 ist schnell, weil es darauf trainiert wurde, das Bild früh fertigzustellen. Ein Bildmodell wie dieses startet mit zufälligem Rauschen und räumt es in Durchläufen auf. Jeder Durchlauf, ein „Schritt“, schickt das ganze Netz mit 6,2 Milliarden Parametern einmal über das Bild. Z-Image-Turbo, vom Labor Tongyi-MAI unter Apache-2.0 veröffentlicht, macht acht davon.
Dar-Yen Chen und Yi-Zhe Song von der SketchX-Gruppe der University of Surrey haben eine Schülerversion trainiert, die das in einem oder zwei schafft. Ein schneller Schüler lernt, dort zu landen, wo der langsame Lehrer landet. Stell dir einen Studiomusiker vor, der lernt, die fertige Spur des Produzenten, über acht Overdubs aufgebaut, in einem Durchgang am Stück einzuspielen.
Ihr Paper, veröffentlicht am 3. November, richtet das Training auf die Wörter des Prompts aus.
Die eigenen Zahlen der Autoren sagen voraus, was wir gesehen haben. In einem Test für langen Text, der in Bilder geschrieben wird, erreicht ein Schritt 43 von 100 Punkten. Z-Image-Turbo mit acht Schritten erreicht 92, NitroFusion2 mit zwei Schritten 76. Darin, wie genau das Bild dem Prompt folgt, hält ein Schritt mit acht mit oder schlägt sie. Das Paper sagt es offen: Beim Rendern von Text bleibt „a substantial gap“. Das sind ihre Benchmarks. Wir haben sie nicht wiederholt.
Für zwei Schritte empfehlen die Autoren einen kleinen Zusatz von 0,38 GB. Er macht den ersten Schritt zur Hälfte zu Z-Image-Turbo, um einige Fehler zu beseitigen, danach macht der Schüler allein weiter. Alles steht unter Apache-2.0: die Gewichte und der Code. Die Model Card liefert neben der vollen Version mit 12,3 GB auch komprimierte Kopien von 2,0 GB bis 7,2 GB. Entdeckt haben wir es im News-Video von AI Search vom 8. November.
Ein Schritt kostet 0,78 Sekunden GPU-Zeit, zwei kosten 1,32
Jeder zusätzliche Schritt kostet etwas mehr als eine halbe Sekunde. Das Paper nennt nur Schrittzahlen, also haben wir selbst gemessen. Wir haben NitroFusion2 als API auf einer RTX 4090 in unserer Cloud bereitgestellt und Bilder mit 1024 x 1024 angefordert, eines nach dem anderen, alle mit Seed 42. Die Karte, die wir bekamen, war die 48-GB-Version der 4090, also haben wir den Speicher des Modells begrenzt, damit es sich wie die übliche 24-GB-Karte verhält. Z-Image-Turbo mit acht Schritten und mehrere gleichzeitige Nutzer haben wir nicht getestet: Hier tritt NitroFusion2 gegen sich selbst an.
| Schritte | GPU-Zeit | Hin und zurück über die API |
|---|---|---|
| 1 | 0,78 bis 0,82 s | 1,45 bis 1,50 s |
| 2 | 1,32 bis 1,33 s | 1,95 bis 2,00 s |
| 4 | 2,42 s | 3,08 s |
Hin und zurück umfasst das Senden der Anfrage, das Kodieren des PNG und die Rückübertragung über das Netz. Das kostet etwa zwei Drittel einer Sekunde, bei einem Schritt kostet die Infrastruktur also fast so viel wie das Zeichnen.
Über die API bekommst du mit einem Schritt etwa 40 Bilder pro Minute, mit zwei Schritten etwa 30. Für eine Person heißt das: etwa alle anderthalb Sekunden eine neue Vorschau. Zwei Schritte fühlen sich wie eine kurze Pause an. Vier Schritte, das Maximum, das das Modell annimmt, dauern etwa dreimal so lange wie einer, und beim Speisekarten-Prompt schrieben auch vier Schritte noch „SOURDOAGH“.
Große Überschriften überstehen einen Schritt, Kleingedrucktes übersteht keinen der beiden
Das Ergebnis hängt von der Größe des Texts ab. Große Wörter kamen in einem Schritt richtig heraus. Kleingedrucktes blieb bei jeder Schrittzahl schwach, die wir ausprobiert haben.
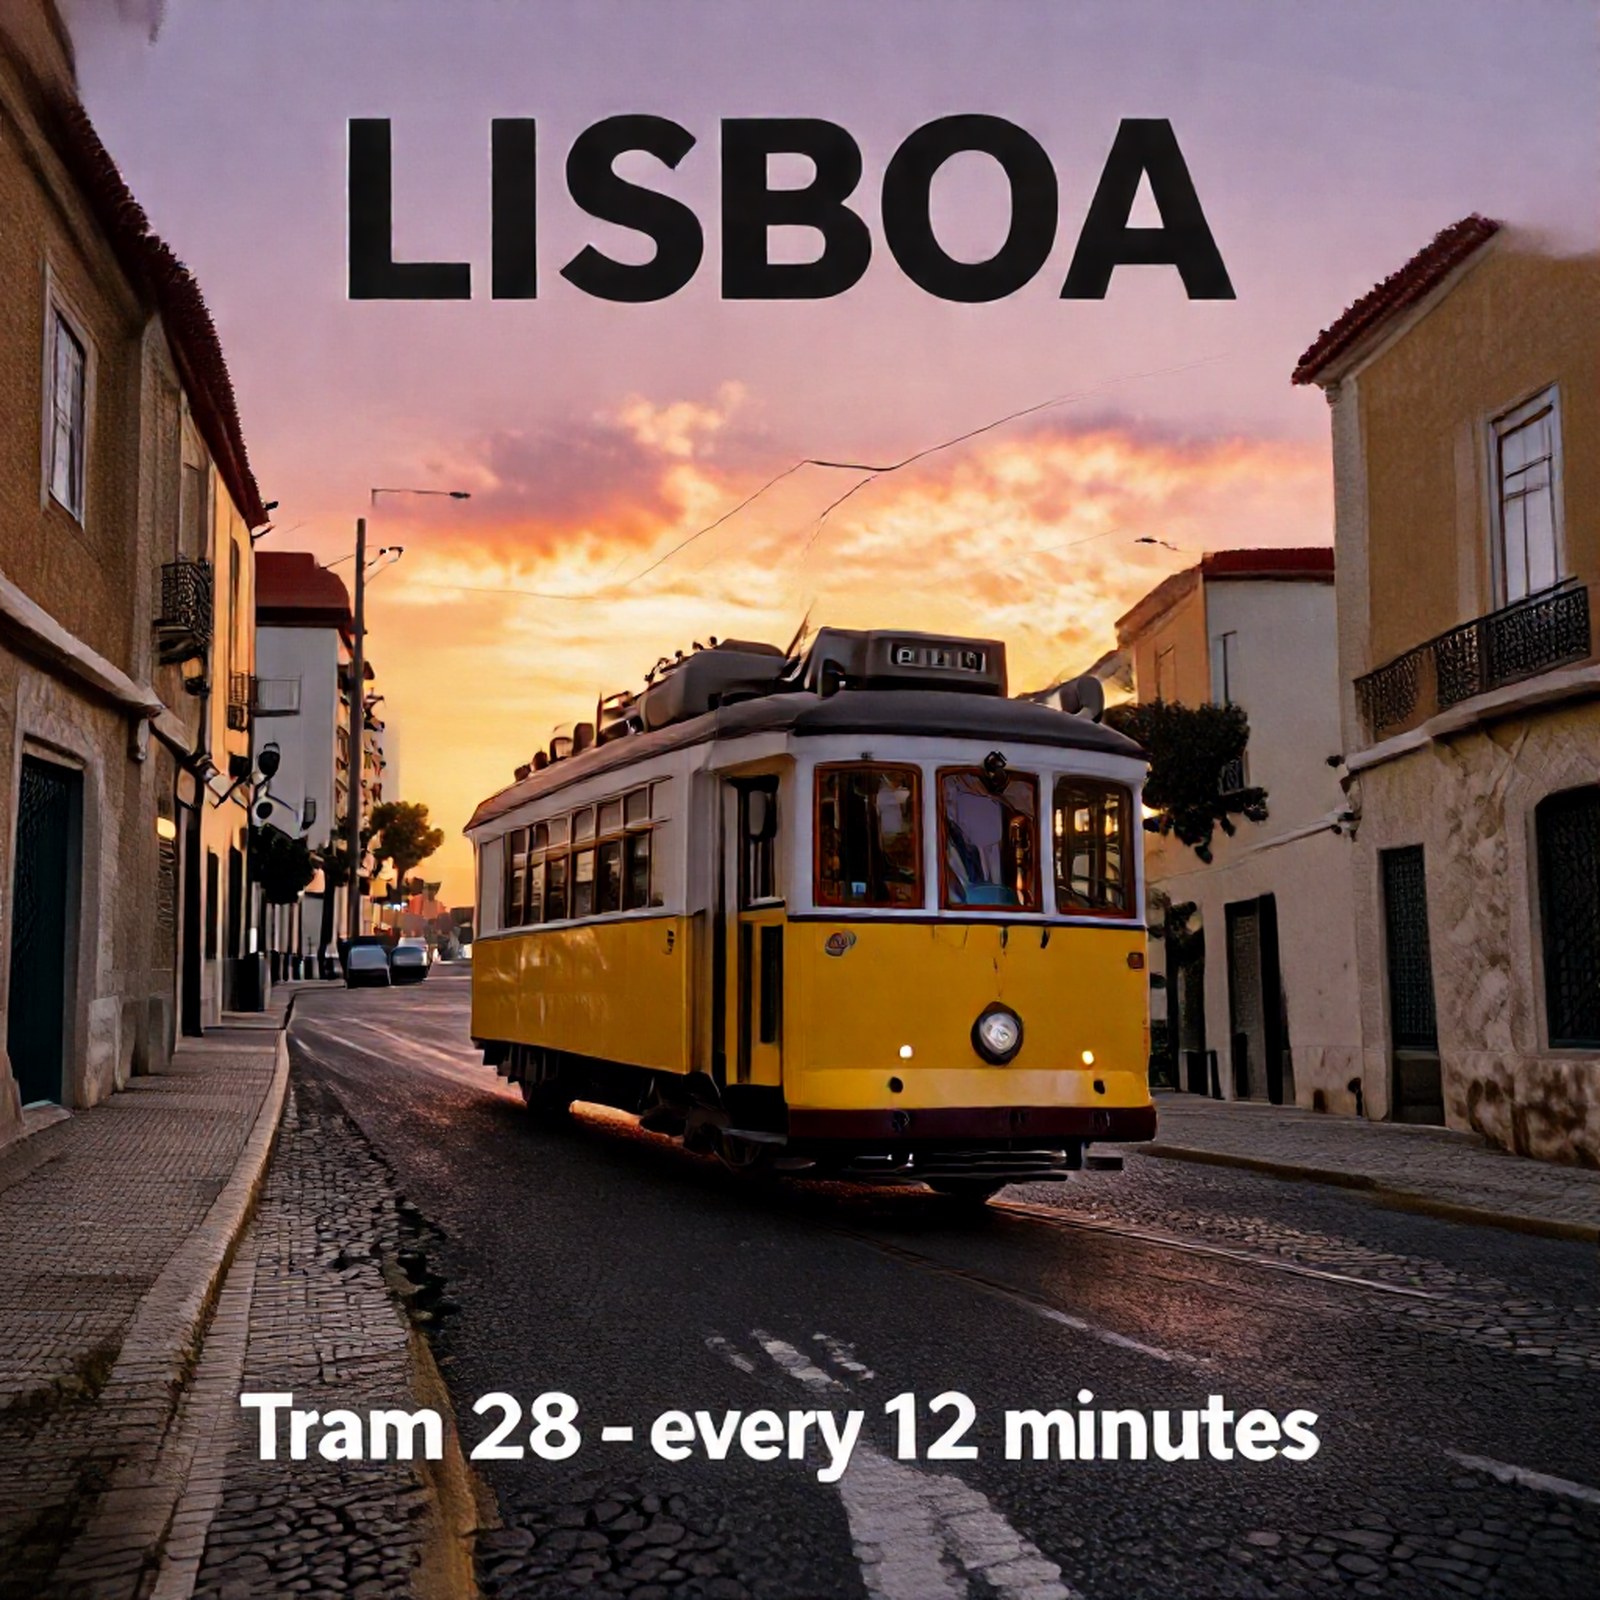
Das Straßenbahnplakat hatte „LISBOA“ und „Tram 28 - every 12 minutes“ richtig, mit einem Schritt, mit zwei Schritten und auf der 16-GB-Karte. Der Porträt-Prompt der Autoren kam mit einem und zwei Schritten sauber heraus.
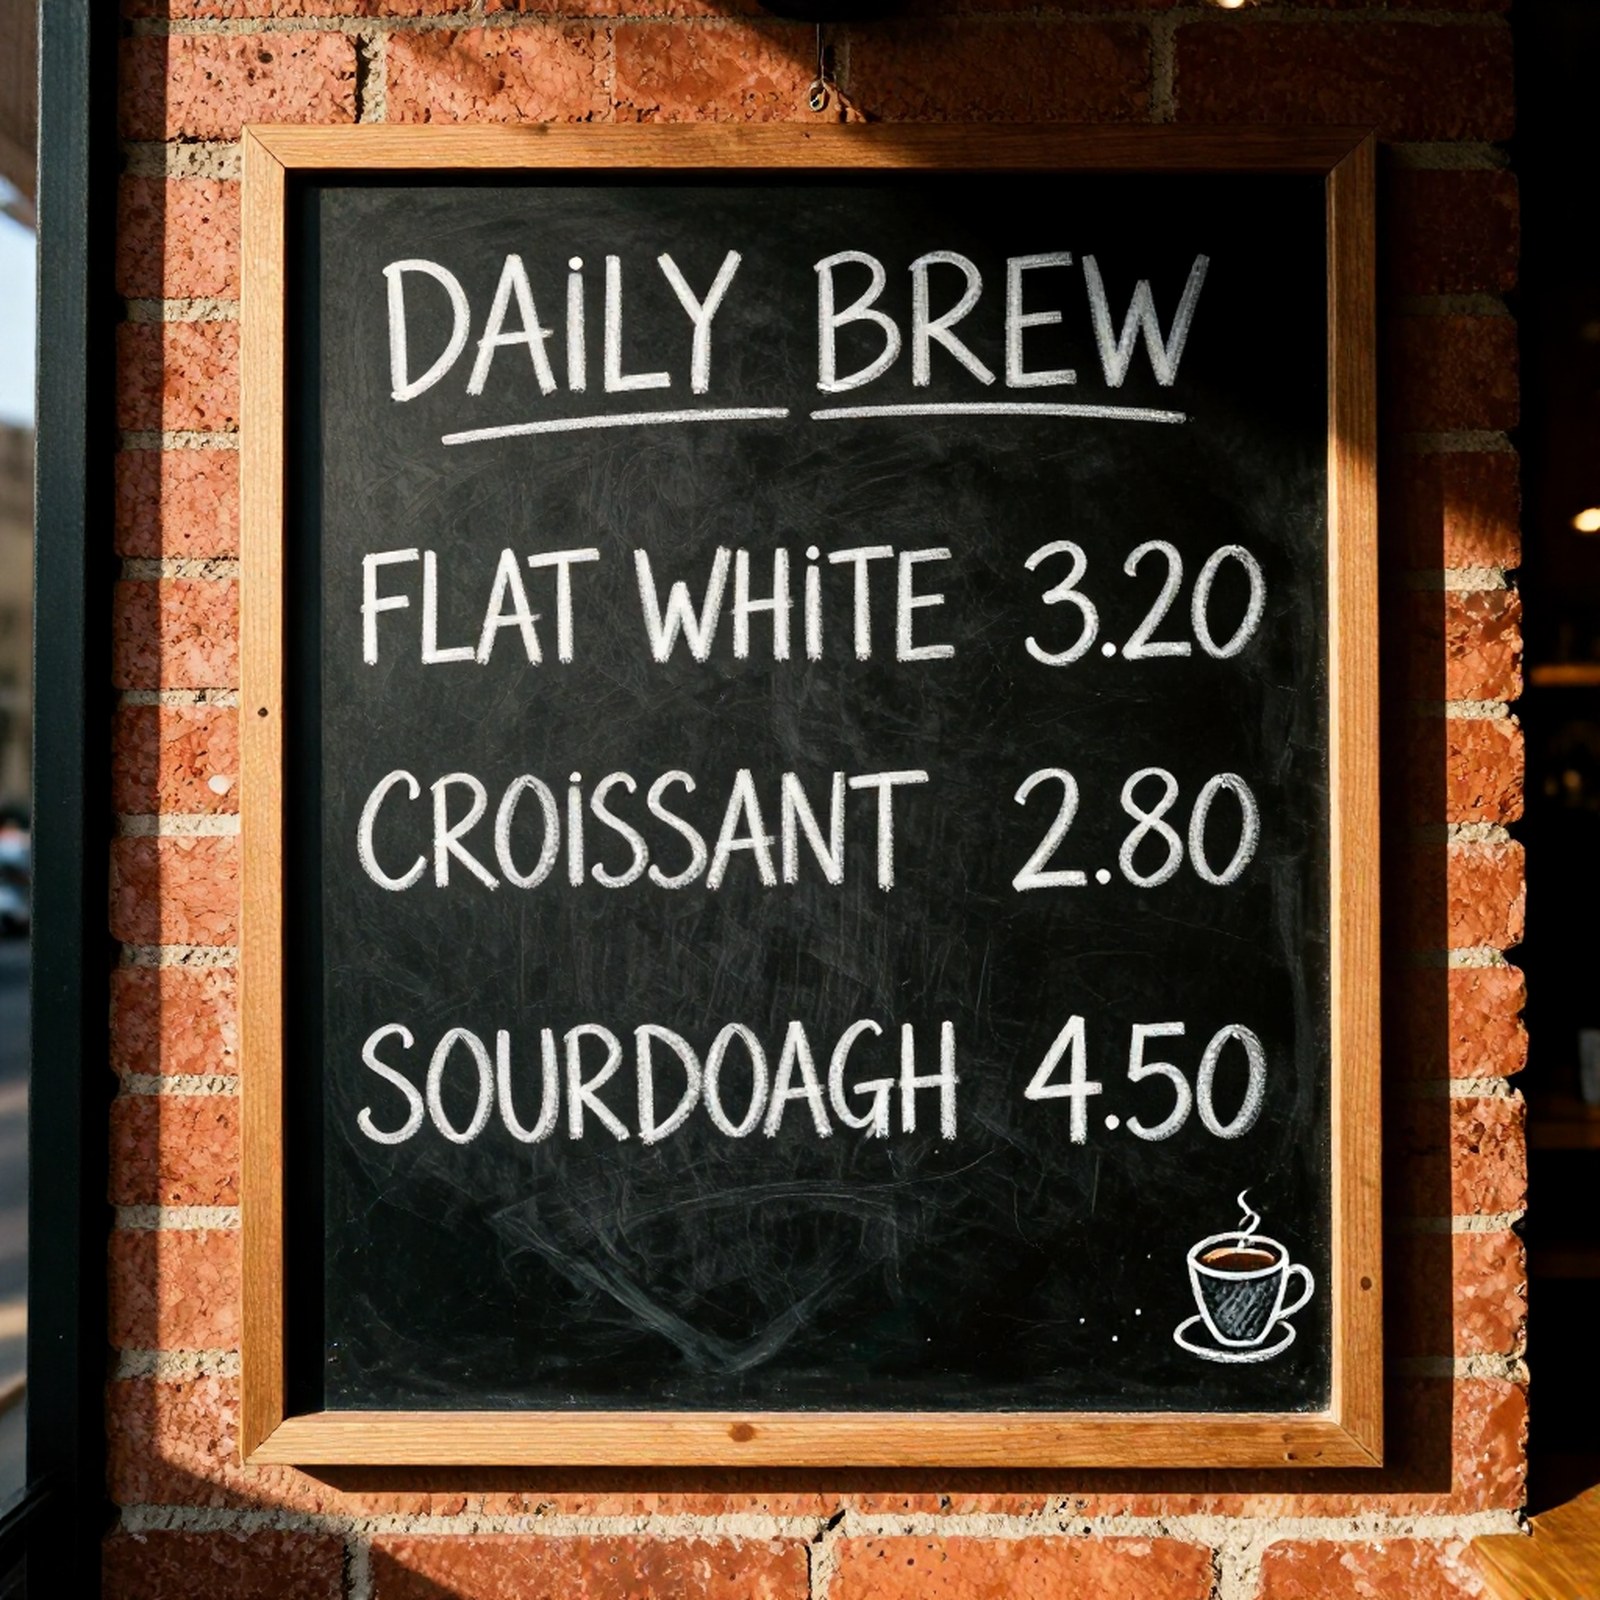
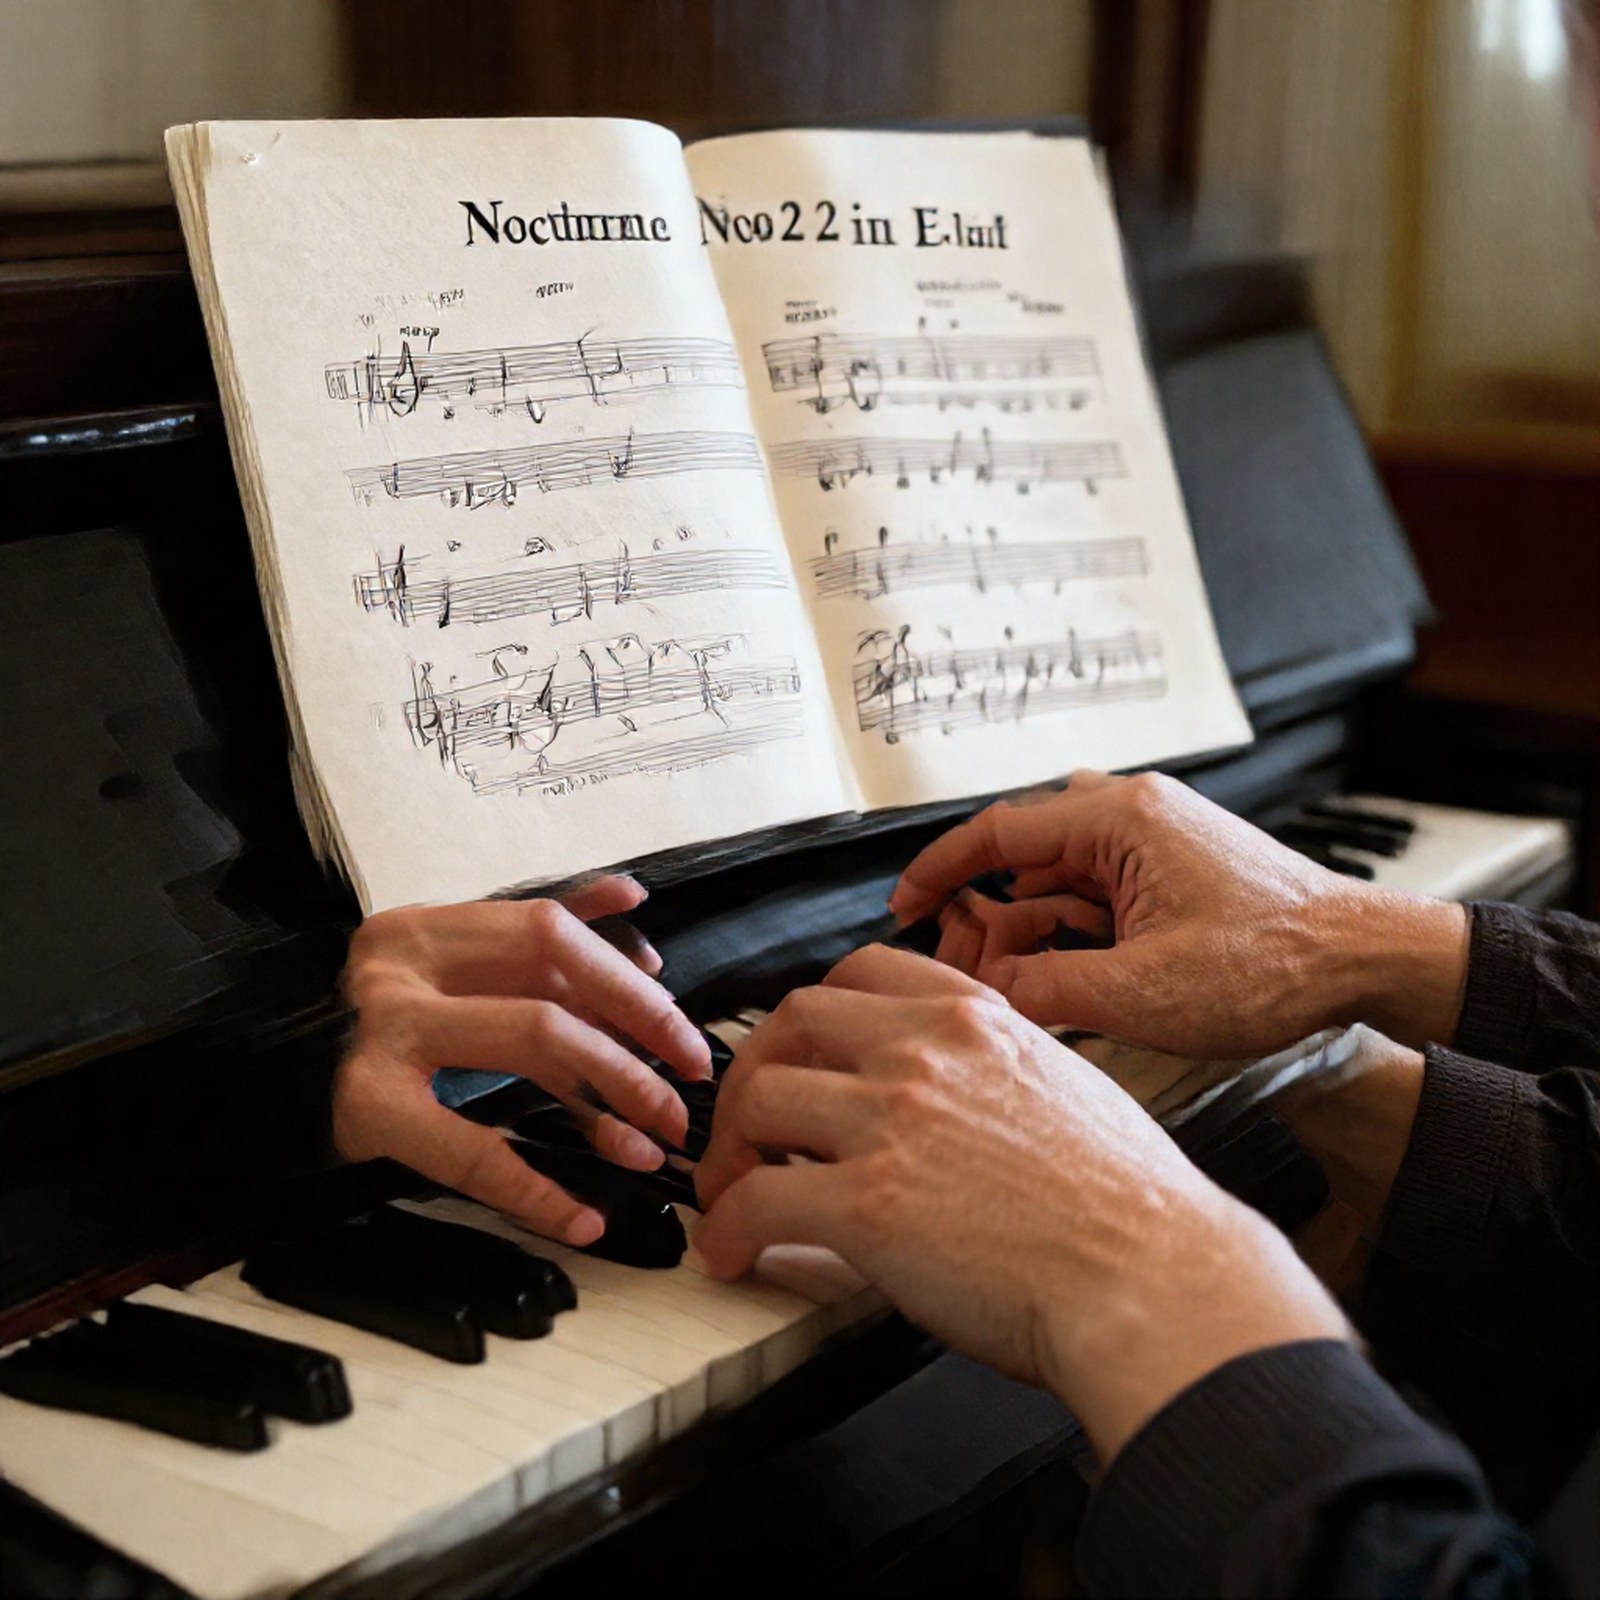
Die Café-Speisekarte zeigt die Grenze. Verlangt war „FLAT WHITE 3.20 / CROISSANT 2.80 / SOURDOUGH 4.50“. Auf der 4090 schrieb jeder Modus, den wir probiert haben, „SOURDOAGH“: ein Schritt, zwei Schritte, vier Schritte und zwei Schritte ohne den Zusatz. Die Preise und die anderen Wörter stimmten dabei. Auf der 16-GB-Karte schrieb ein Schritt außerdem „CROSSANT“. Auf den Noten war der kleine Titel „Nocturne No. 2 in E-flat“ mit einem Schritt verstümmelt und mit zwei immer noch nicht fehlerfrei.
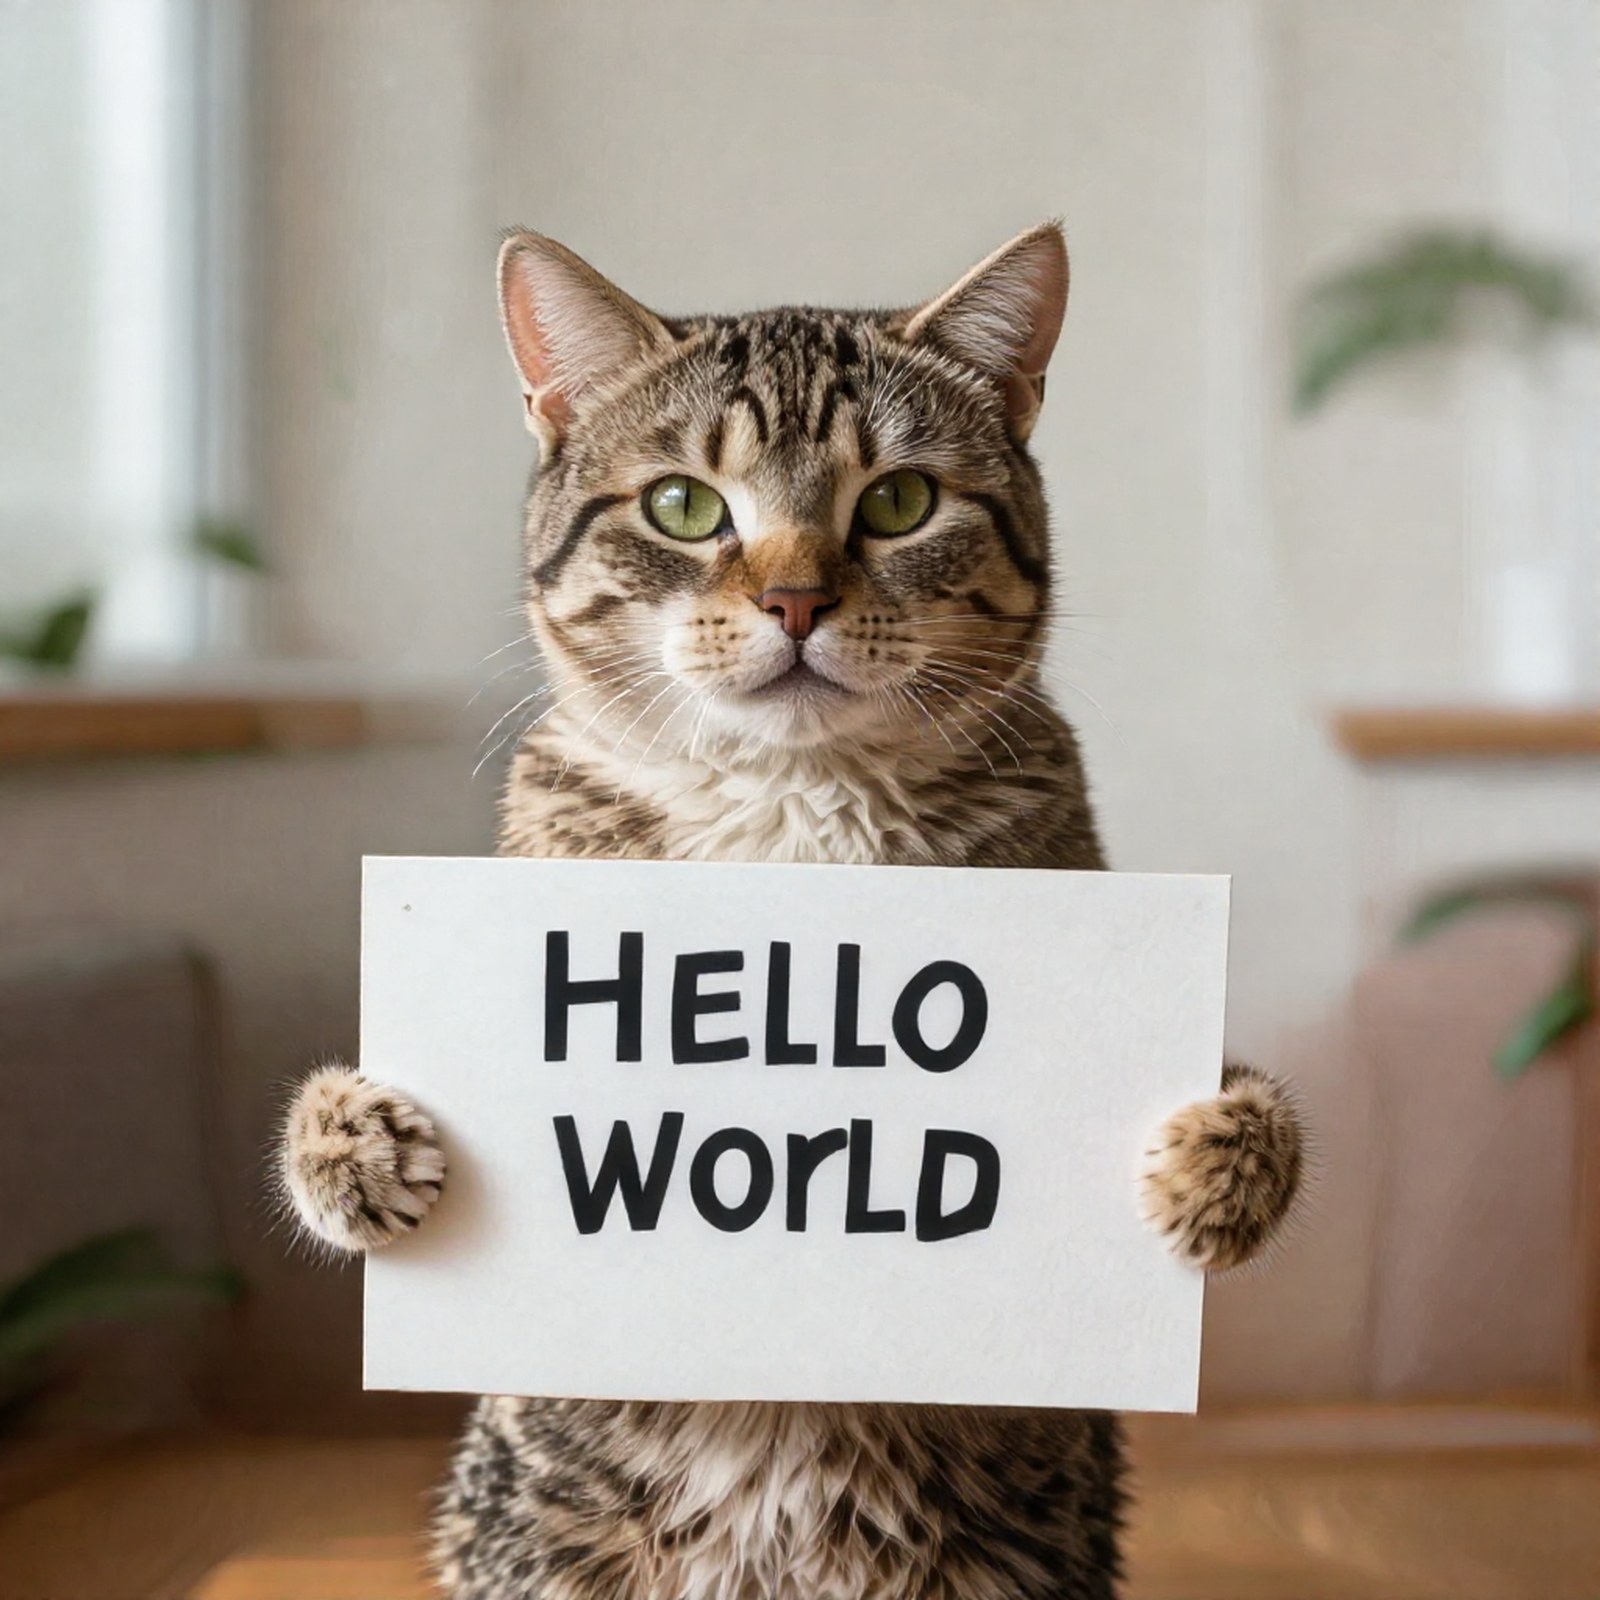
Ein Hinweis zu Seeds. Derselbe Seed ergibt auf einer anderen GPU andere Pixel. Auf der 16-GB-Karte kam das Schild mit einem Schritt richtig heraus, „HELLO WORLD“. Ein Seed pro Prompt ist ein Verhaltenstest, kein Benchmark. Achte auf das Muster: Kurzer, großer Text ist mit einem Schritt meist in Ordnung, ein zweiter Schritt behebt einige Fehler, und kleiner oder langer Text muss jedes Mal geprüft werden.
Welche GPU: Eine echte 16-GB-Karte funktioniert mit der 5-GB-Kopie, bei 4 Sekunden pro Bild
Die kleinste echte Karte, die funktioniert hat, war eine RTX 2000 Ada mit 16 GB, eine kleine Workstation-Karte mit 70 Watt. Sie lief mit der 5-GB-Kopie, alles auf der Karte, ungefähr fünfmal langsamer als die 4090. Von ihrem Speicher blieb weniger als ein halbes Gigabyte frei. Auf der begrenzten 4090 brauchte die 5-GB-Kopie etwa 1 Sekunde, der Großteil der 4 Sekunden auf der kleinen Karte kommt also vom langsameren Chip.
Warum nicht einfach die 12,3-GB-Datei auf einer 16-GB-Karte? Die 12,3-GB-Datei ist nur ein Teil der Last. Der Textleser von Z-Image-Turbo (der Teil, der den Prompt liest) bringt etwa 8 GB dazu, also lag das Setup mit der vollen 12,3-GB-Datei in der Spitze bei etwa 23 GB. Um auf der GPU zu bleiben, braucht das eine 24-GB-Karte. Wenn Teile zwischen den Einsätzen in den Arbeitsspeicher wandern, läuft die volle Datei auch unter einer 16-GB-Grenze, aber mit 14 bis 19 Sekunden pro Bild. Die größere 7,2-GB-Kopie der Autoren passte auch nicht: Unter einer 16-GB-Grenze ging ihr beim ersten Bild der Speicher aus. Mit dem Textleser auf der Karte ist die 5-GB-Kopie diejenige, die Platz lässt.
| Karte oder Speicherbudget | Setup | Zeit pro Bild (1 Schritt, 2 Schritte) | Echte Karte? |
|---|---|---|---|
| RTX 2000 Ada 16 GB | 5-GB-Kopie, alles auf der Karte | 4,0 s, 7,3 s | ja |
| 16-GB-Budget | volle 12,3-GB-Datei, Teile wandern zwischen den Einsätzen in den Arbeitsspeicher | 14 bis 19 s | nein, eine Grenze auf der 4090 |
| 12-GB-Budget | 5-GB-Kopie, Teile wandern zwischen den Einsätzen in den Arbeitsspeicher | 7,5 bis 10,5 s | nein, eine Grenze auf der 4090 |
Ein 8-GB-Budget scheitert: Der Textleser allein hat etwa 8 GB, für den Rest bleibt nichts übrig. Eine echte 12-GB-Karte hatten wir nicht, und die kleineren Kopien mit 2 GB bis 4 GB oder einen kleineren Textleser für 8-GB-Karten haben wir nicht ausprobiert.
Auf InferenceKey: bereit in 67 Sekunden, und zwei Einstellungen zum Ändern
Eine frische GPU-Maschine auf der Plattform war 67 Sekunden, nachdem wir sie angefordert hatten, bereit. Diese 67 Sekunden umfassen das Python-Setup (28 s), den Download von etwa 20 GB Gewichten (33,8 s) und das Laden (4,4 s). Heruntergeladen wird nur, was NitroFusion2 nutzt, die 24,6 GB von Z-Image-Turbo, die es ersetzt, fallen weg. Auf der 16-GB-Karte brauchte derselbe Weg 76 Sekunden.
Kein eingebautes Backend bedient dieses Modell, also haben wir eine kleine Python-Datei geschrieben, die der Plattform sagt, wie sie es lädt und Anfragen beantwortet. Sie folgt den Einstellungen der Autoren, einschließlich des Zusatzes mit halber Stärke im ersten Schritt. Die Plattform selbst brauchte keine Änderung. Das war eine lokale Kopie unseres Stacks, nicht der gehostete Dienst.
Das Problem, auf das du stoßen wirst: Der Bildtester im Dashboard startet mit 20 Schritten und einer Guidance (wie stark er zum Prompt hin drückt) von 4,5, falsch für dieses Modell. NitroFusion2 lehnt 20 Schritte mit einem Fehler ab: Es nimmt nur 1 bis 4 an. Mit Schritten auf 1 oder 2 und Guidance auf 0 beantwortete der Tester das Plakat mit einem Schritt in etwa 1,1 Sekunden. Status: im README des Beispiels dokumentiert, die Standardwerte des Testers sind unverändert.
Solltest du es nutzen? Ein Schritt für Vorschauen, zwei für alles mit Wörtern
- Vorschauen, Thumbnails, Live-Entwürfe: ein Schritt, unter einer Sekunde GPU-Zeit.
- Bilder mit kurzem, großem Text, die an Kunden gehen: zwei Schritte, und prüf sie.
- Speisekarten, Etiketten, Preise, Kleingedrucktes: keins von beiden. Setz den Text selbst darüber oder probier das Z-Image-Turbo mit acht Schritten.
- Eine 16-GB-Karte: die 5-GB-Kopie, und sag dem Beispiel, dass es alles auf der Karte halten soll, sonst fällt es auf einen viel langsameren Weg zurück.
- Eine 8-GB-Karte: nicht mit diesem Setup.
Um die Schild- und Speisekartenbilder auf deiner eigenen Karte zu erzeugen, starte das NitroFusion2-SDK-Beispiel. Es braucht eine NVIDIA-Karte mit 24 GB, oder 16 GB mit der 5-GB-Kopie, und etwa 27 GB Festplatte (32 GB mit der 5-GB-Kopie).
Für Ingenieure
Credits
- Dar-Yen Chen und Yi-Zhe Song (SketchX, CVSSP, University of Surrey; Turing Elite Research Labs): NitroFusion2, das Paper „NitroFusion2: Bringing Adversarial Loss to the Text Stream of Multimodal Diffusion Transformers“ (arXiv 2611.05648, CC BY 4.0), die Gewichte (Apache-2.0), die De-Distillation-LoRA (der Zusatz mit 0,38 GB), die GGUF-Dateien, der Code und
inference.py(Apache-2.0), vier ComfyUI-Workflows und die Projektseite. Es baut auf NitroFusion auf (Dar-Yen Chen, Hmrishav Bandyopadhyay, Kai Zou und Yi-Zhe Song, CVPR 2025). - Tongyi-MAI: Z-Image-Turbo (Apache-2.0), dessen Text-Encoder, Tokenizer, VAE und Scheduler die Pipeline wiederverwendet.
- Die Maintainer von diffusers:
ZImagePipeline, der Z-Image-LoRA-Loader und das Laden einzelner GGUF-Dateien in diffusers 0.42.1. - PedroMarinhoDev: Community-Builds für ComfyUI in int8, W6A8 und W4A8 (von uns nicht getestet).
- AI Search: wo wir es entdeckt haben (2026-11-08 AI NEWS, Kapitel bei 03:50).
- Unser Teil: das Custom Backend, das Deployment über die Plattform, die Zeitmessungen, die Speicherleiter, die Qualitätsprüfungen, das SDK-Beispiel und das Demovideo.
Modell und Dateien
ChenDY/NitroFusion2: sha62d1a7000af9c46a0c4348d936bd7670ff33c1b9, erstellt am 2026-10-27, zuletzt geändert am 2026-11-08, nicht gated, apache-2.0, Library diffusers, Pipeline text-to-image, BasismodellTongyi-MAI/Z-Image-Turbo. Release laut Card: 2026-11-03.- Transformer: diffusers
ZImageTransformer2DModel, 6.154.908.736 Parameter (Tabelle 1 des Papers sagt 6B, wie bei Z-Image-Turbo). Bf16 in 3 Shards: 4.986.858.288 + 4.986.868.776 + 2.336.146.728 B (12,31 GB). Einzeldateinf2-bf16.safetensors12.309.866.400 B.nf2-BF16.ggufundnf2-F16.ggufje 12.311.939.136 B. - GGUF-Stufen (GB): Q2_K_4XS 2,04, Q2_K_3XS 2,30, Q2_K_2XS 2,70, Q2_K_XS 3,00, Q2_K_S 3,30, Q2_K_M 3,60, Q2_K_L 4,01, Q3_K_S 4,36, Q3_K_M 4,56, Q3_K_L 4,60, Q4_0 4,59, Q4_K_S 4,79, Q4_1 4,85, Q4_K_M 5,07, Q5_0 5,26, Q5_K_S 5,29, Q5_1 5,53, Q5_K_M 5,58, Q6_K 6,10, Q8_0 7,22.
nf2-dedistill-lora.safetensors: 381.553.336 B.- Z-Image-Turbo sha
f332072a: Qwen3-Text-Encoder in 3 Shards (etwa 8,05 GB), VAE 167.666.902 B, sein eigener Transformer etwa 24,6 GB (F32), den unser Backend nicht herunterlädt. Seine Card verspricht Latenz unter einer Sekunde auf einer H800 und dass es auf Consumer-Geräte mit 16 GB passt. Das diffusers-Beispiel seiner Card nutztnum_inference_steps=9(„This actually results in 8 DiT forwards“) undguidance_scale=0.0. - Rezept der Autoren (
inference.py, identisch auf GitHub main): nur Schritte 1 bis 4, Scheduler-Shift {1: 3.0, 2: 6.0, 3: 8.0, 4: 9.0}, Sigmas1 - i/steps, Guidance 0,0, LoRA-Skalen {1: (0.0,), 2: (0.5, 0.0), 3: (0.5, 0.6, 0.0), 4: (0.5, 0.6, 0.7, 0.0)}, Standard 1024 x 1024 und 2 Schritte,pipe.enable_model_cpu_offload()in__main__. - Methode: Text-Stream Adversarial Distillation (Diskriminator-Köpfe auf Zwischenzuständen der Text-Tokens des eingefrorenen MMDiT) und Aspect-Cued Discrimination (der Diskriminator wird auf Hinweise zu Typografie, Objekt, Stil, Hintergrund, Handlung und Layout konditioniert).
- Training laut Paper: 100k synthetische Referenzen aus Z-Image-Turbo mit 12 Schritten (EN/CN), Bildbeschreibungen von Qwen3.5-35B-A3B, Adam lr 5e-5, Batch 256, acht H100, 20.000 Schritte (5.000 off-policy, 15.000 on-policy). Kein Trainingscode im Repo.
- Einschränkungen laut Paper: Komplexe Szenen bleiben schwierig, vor allem mit einem Schritt; geringere Vielfalt der Samples (OneIG-Diversität unter beiden Baselines bei 1 und 2 Schritten); ein Wippeneffekt zwischen den ACD-Hinweisen.
Tabelle 1 des Papers (Zahlen der Autoren, von uns nicht reproduziert; im Text heißt sie Tabelle 2):
| Modell | NFE | LongText-EN | LongText-CN | GenEval | DPG-Bench | OneIG |
|---|---|---|---|---|---|---|
| NitroFusion2 | 1 | 43,34 | 47,78 | 75,86 | 86,48 | 47,63 |
| Z-Image-Turbo | 1 | 11,72 | 12,70 | 57,08 | 77,23 | 32,43 |
| TwinFlow | 1 | 29,18 | 36,85 | 66,34 | 85,17 | 42,20 |
| NitroFusion2 | 2 | 76,03 | 81,95 | 74,46 | 86,21 | 51,45 |
| Z-Image-Turbo | 2 | 72,89 | 78,48 | 76,53 | 85,78 | 50,94 |
| Z-Image-Turbo++ (6B+6B) | 2 | 89,88 | 91,62 | 75,70 | 85,86 | 52,50 |
| Z-Image-Turbo | 8 | 91,74 | 92,56 | 75,01 | 84,86 | 52,84 |
Setup und Begründung
- GPU: eine RTX 4090 auf InferenceKey Cloud. Die Karte meldete
NVIDIA GeForce RTX 4090, 49140 MiB(die 48-GB-Variante), also lief der Haupt-Workload mitNF2_VRAM_LIMIT_GIB=23.4, um eine 24-GB-Karte nachzubilden. Eine normale 24-GB-Karte kam nicht zum Einsatz. Die bf16-Pipeline braucht resident etwa 22 GiB, deshalb ist die Referenz ein 24-GB-Budget. Danach eine echte RTX 2000 Ada 16 GB (16.380 MiB, 70 W) für die Prüfung mit der kleinen Karte. - Backend: ein neues Custom-Python-Backend,
NitroFusion2Backend0.1.0 (Paket 5.600 B), auf diffusers 0.42.1ZImagePipeline, mit dem NitroFusion2-Transformer und der LoRA als Adapterdedistill. Versionen: torch 2.14.1, transformers 5.21.0, accelerate 1.15.0, peft 0.21.2, gguf 0.19.0. Warum custom: Kein eingebautes Backend bedient die Z-Image-Pipeline. Warum diffusers: Es ist der Weg der Autoren selbst, und 0.42.1 hat die Pipeline, den LoRA-Loader und Einzeldatei-GGUF für diesen Transformer. - Speichermodi (
NF2_MEMORY_MODE):gpu(alles resident),model(enable_model_cpu_offload, der Standard im Skript der Autoren),sequential. Der Standardautowähltgpunur bei mindestens 23 GiB frei, sonstmodel. Auf einer 16-GB-Karte setzNF2_TRANSFORMER=nf2-Q4_K_M.ggufundNF2_MEMORY_MODE=gpuexplizit, sonst fälltautoauf Offload zurück und du verlierst den 4-s-Weg. - Stack: ein lokaler InferenceKey-Manager, nats-proxy und Worker, gebaut aus main
97aec23e. Produktion wurde nie angefasst. - Anfragefelder (im Stil der OpenAI-Images-API):
prompt(Pflicht),size("1024x1024", Seiten 256 bis 2048, Vielfache von 16),seed,stepsodernum_inference_steps(1 bis 4, Standard 2),dedistill(Standard true),output_format(png,jpeg,webp). Guidance ist immer 0. Die Antwort enthält zusätzlichseconds,encode_seconds,vae_seconds,vram_peak_gibundmemory_mode. Endpoint:POST /endpoint/<project>/nitrofusion2/v1/images/generations.
Schritt für Schritt mit dem SDK-Beispiel
Das Beispiel ist Commit 1ca451bd auf inferencekey-sdk main: backend.py, publish.py, main.py, requirements.txt, README.md, .env.example.
cp .env.example .env    # INFERENCEKEY_SDK_TOKEN, INFERENCEKEY_API_KEY,
                        # INFERENCEKEY_PROJECT, IK_WORKER_ID (read by main.py)
# publish.py does not read .env: export these two in the shell
export INFERENCEKEY_TENANT_ID=<tenant-id>
export INFERENCEKEY_USER_TOKEN=<dashboard-session-token>
python publish.py       # packages backend.py into dist/ and uploads it to your tenant
IK_KEEP_ALIVE=1 python main.py
Ohne INFERENCEKEY_TENANT_ID und INFERENCEKEY_USER_TOKEN baut publish.py nur dist/*.tar.gz, gibt „upload the package from Dashboard -> Custom backends instead“ aus und beendet sich mit 0. In diesem Fall lad die Datei unter Dashboard -> Custom backends hoch, bevor du main.py startest, sonst hat ensure() kein Backend zum Deployen.
Für eine 16-GB-Karte ergänze vor main.py in .env:
NF2_TRANSFORMER=nf2-Q4_K_M.gguf
NF2_MEMORY_MODE=gpu
main.py ruft ensure() für einen festen Workload auf IK_WORKER_ID auf, mit ready_timeout_secs: 2400, request_timeout_secs: 600 und der NF2_*-Umgebung, wartet mit wait_until_ready(2400) und macht dann drei Aufrufe mit 1024 x 1024 und Seed 42: das Schild mit 1 Schritt, die Speisekarte mit 1 Schritt und die Speisekarte mit 2 Schritten. Beim Beenden löscht es den Workload, außer bei IK_KEEP_ALIVE=1. Festplatte: etwa 21 GB Gewichte (26 GB, wenn die Q4_K_M-Datei dazukommt) plus ein venv mit 5,5 GB.
Eine einzelne Anfrage:
curl -s https://<api-host>/endpoint/<project>/nitrofusion2/v1/images/generations \
  -H "Authorization: Bearer $INFERENCEKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"prompt": "a cat holding a sign that says hello world",
       "size": "1024x1024", "steps": 2, "seed": 42}'
Alle Messungen
Zeit bis bereit:
- RTX 4090: „ready after 67 s“ laut SDK. Venv 28 s (CPython 3.12.3), dann
download 33.8s, load 4.4s, transformer bf16, memory mode gpu (budget 23.4 GiB), weights in VRAM 19.5 GiB. HF-Cache etwa 20 GB. - RTX 2000 Ada: „ready after 76 s“.
download 28.4s, load 23.0s, transformer nf2-Q4_K_M.gguf, memory mode gpu (budget 15.5 GiB), weights in VRAM 12.7 GiB.
Pro Anfrage, 1024 x 1024, Seed 42, eine nach der anderen. GPU-Zeit im Backend mit cuda.synchronize gemessen, Hin und zurück vom HTTP-Client zum lokalen Manager.
| Karte / Konfiguration | Fall | GPU s | Hin und zurück s | Text-Encoder s | VAE s | Torch-Spitze GiB |
|---|---|---|---|---|---|---|
| 4090 bf16 | Schild, 1 Schritt, erster Aufruf | 1,72 | 3,43 | 0,638 | 0,379 | 21,86 |
| 4090 bf16 | Speisekarte, 1 Schritt, x6 | 0,780 bis 0,816 | 1,45 bis 1,50 | 0,05 bis 0,064 | 0,149 | 21,86 |
| 4090 bf16 | Speisekarte, 2 Schritte, x6 | 1,318 bis 1,330 | 1,95 bis 2,00 | etwa 0,055 | 0,149 | 21,86 |
| 4090 bf16 | Schild/Porträt/Plakat/Hände, 2 Schritte | 1,312 bis 1,326 | 1,90 bis 1,99 | 0,149 | 21,86 | |
| 4090 bf16 | Porträt/Plakat/Hände, 1 Schritt | 0,783 | 1,47 bis 1,52 | 0,149 bis 0,15 | 21,86 | |
| 4090 bf16 | Speisekarte, 2 Schritte, ohne LoRA | 1,341 | 2,01 | 21,86 | ||
| 4090 bf16 | Speisekarte, 4 Schritte | 2,419 | 3,08 | 21,86 | ||
| RTX 2000 Ada, Q4_K_M | 1 Schritt (x5) | 3,98 bis 4,33 (5,16 beim ersten) | 4,66 bis 4,91 (7,06 beim ersten) | 0,21 bis 0,25 | 0,57 bis 0,60 | 15,11 |
| RTX 2000 Ada, Q4_K_M | 2 Schritte (x5) | 7,19 bis 7,42 | 7,83 bis 8,32 | etwa 0,21 | 0,57 bis 0,74 | 15,11 |
Daraus abgeleitet, einzelne Anfragen, kein Batching: etwa 1,2 bis 1,3 Bilder pro Sekunde GPU-Zeit bei 1 Schritt (0,67 bis 0,69 nach Hin und zurück) und etwa 0,75 bei 2 Schritten (0,50 bis 0,51 nach Hin und zurück). Der Bildtester im Dashboard zeigte „ok · 1098 ms“ für das Plakat mit 1 Schritt.
VRAM-Leiter. Die emulierten Stufen liefen in einem separaten Prozess auf der 48-GB-4090 mit torch.cuda.set_per_process_memory_fraction, neben dem laufenden Workload, ihre Zeiten können also etwas Konkurrenz um Ressourcen enthalten. Jede Stufe lief mit Schild und Speisekarte bei 1 und 2 Schritten, zweimal, Seed 42.
| GPU oder Grenze | Konfiguration | Spitzen-VRAM | Zeit pro Bild | Ausgabe | Echt oder emuliert |
|---|---|---|---|---|---|
| RTX 4090, Grenze 23,4 GiB | bf16, alles auf der GPU, über die Plattform | 21,86 GiB torch | 0,78-0,82 s (1), 1,32-1,33 s (2) | ok, Referenz | echte Karte mit Grenze |
| 15,2 GiB | bf16 + enable_model_cpu_offload | 12,30 GiB / 13.122 MiB | 14,2-19,4 s | ok, gleiche Bilder | emuliert |
| 15,2 GiB | Q8_0 GGUF, alles auf der GPU | CUDA out of memory. Tried to allocate 80.00 MiB ... 15.20 GiB allowed bei der ersten Anfrage (Setup 37,3 s) | emuliert | ||
| 15,2 GiB | Q4_K_M GGUF, alles auf der GPU | 15,11 GiB / 16.008 MiB | 0,95-1,03 s (1), 1,64-1,71 s (2) | ok, gleicher Text wie bf16 | emuliert |
| RTX 2000 Ada 16 GB | Q4_K_M GGUF, alles auf der GPU, über die Plattform | 15,11 GiB / 15.948 MiB Karte | 3,98-4,33 s (1), 7,19-7,42 s (2) | ok | echt |
| 11,2 GiB | Q4_K_M + Model-Offload | 7,69 GiB / 8.366 MiB | 7,5-10,5 s | ok, gleicher Text | emuliert |
| 7,2 GiB | Q4_K_M + Model-Offload | Tried to allocate 48.00 MiB ... 7.20 GiB allowed (bf16-Text-Encoder allein etwa 7,5 GiB) | emuliert | ||
| 7,2 GiB | Q4_K_M + sequenzielles Offload | Setup gescheitert: KeyError: None | emuliert |
Nicht probiert: ein quantisierter Text-Encoder oder einer auf der CPU für 8 GB; andere Auflösungen als 1024; die Community-Builds für ComfyUI in int8, W6A8 und W4A8; Batchgrößen über 1 und Parallelität; echte 12-GB- und normale 24-GB-Karten (keine Karte mit 10 bis 12 GB war verfügbar); die GGUF-Stufen Q2, Q3, Q5 und Q6; Q8_0 mit Offload oder auf einer 24-GB-Karte; Z-Image-Turbo mit 8 Schritten.
Qualitätsnotizen (ein Seed pro Fall, kein Benchmark)
Prompts: das Katzenschild und das Porträt der Autoren, dazu vier eigene (eine Café-Speisekarte auf einer Kreidetafel, ein Lissabonner Straßenbahnplakat, Noten auf einem Klavier, ein Paar Hände).
- Schild (Prompt der Autoren „a cat holding a sign that says hello world“): 4090 mit 1 Schritt „HELLO WORd“ (L fehlt, kleines d, verschmiertes H), mit 2 Schritten „Hello World“. Die Q4-Stufen auf der 4090 lieferten denselben Text wie bf16. RTX 2000 Ada Q4: 1 Schritt „HELLO WORLD“, 2 Schritte richtig.
- Speisekarte („FLAT WHITE 3.20 / CROISSANT 2.80 / SOURDOUGH 4.50“): „SOURDOAGH“ bei 1, 2 und 4 Schritten und bei 2 ohne LoRA auf der 4090. RTX 2000 Ada mit 1 Schritt: „CROSSANT“ und eine verirrte „0“ unter 4.50; mit 2 Schritten „SOURDOAGH“.
- Plakat: „LISBOA“ und „Tram 28 - every 12 minutes“ richtig bei 1 und 2 Schritten und auf der 16-GB-Karte.
- Klavier: Titel „Nocturne No. 2 in E-flat“ bei 1 Schritt verstümmelt, bei 2 immer noch nicht fehlerfrei. Hände plausibel.
- Porträt (Prompt der Autoren): sauber bei 1 und 2 Schritten.
Demovideo
Ein 3-minütiger Rundgang mit Sprecher: was NitroFusion2 ist (mit Projektseite, Abbildungen und Tabelle 1 der Autoren, mit Quellenangabe), das Panel beim Generieren mit 1 und 2 Schritten und die Speicherleiter.
Offene Probleme
- Die 4090 war eine 48-GB-Variante. Das 24-GB-Ergebnis ist eine Grenze (
NF2_VRAM_LIMIT_GIB=23.4), keine normale 24-GB-Karte. Status: benannt, nicht auf einer 24-GB-Karte erneut getestet. - Standardwerte des Bildtesters (20 Schritte, Guidance 4,5) liefern 400
NitroFusion2 is distilled for 1 to 4 steps. Status: im README dokumentiert, Standardwerte der Plattform unverändert. - Q8_0 passt nicht in 16 GB, wenn der bf16-Text-Encoder resident ist. Status: Q4_K_M nutzen.
- 8 GB scheitern: OOM mit Model-Offload,
KeyError: Nonemit sequenziellem Offload und einem GGUF-Transformer. Status: offen, mit einem kleineren Text-Encoder nicht probiert. - Textfehler bei einem Schritt, und ein Schreibfehler („SOURDOAGH“) bei jeder Schrittzahl. Status: Verhalten des Modells, passt zur Lücke beim Text-Rendering, die das Paper selbst nennt.
- Kleinigkeit: Unser erstes Seeding-SQL für den lokalen Test-Tenant traf den vorab angelegten Standard-Tenant; vor dem Neustart des Managers korrigiert, ohne Auswirkung auf den Test. Im stderr des Backends erscheint eine harmlose
RuntimeWarningzuinferencekey.backend.serveinsys.modules.
Quellen
- Model Card: https://huggingface.co/ChenDY/NitroFusion2
- Code und
inference.py: https://github.com/ChenDarYen/NitroFusion2 - Paper: https://arxiv.org/abs/2611.05648
- Projektseite: https://chendaryen.github.io/NitroFusion2.github.io/
- Basismodell: https://huggingface.co/Tongyi-MAI/Z-Image-Turbo
- Wo wir es entdeckt haben: https://www.youtube.com/watch?v=9RIK3A24ZxA (AI Search, 2026-11-08, bei 03:50)
- SDK-Beispiel: https://github.com/inferencekey/inferencekey-sdk/tree/main/examples/nitrofusion2-text2image-custom-backend-private-nvidia