Der MTP-Kopf von Mellum2.1: 1,11x schneller bei einer Anfrage, 1,45x bei acht, und das Modell läuft in 8 Bit auf einer RTX 5080 mit 16 GB
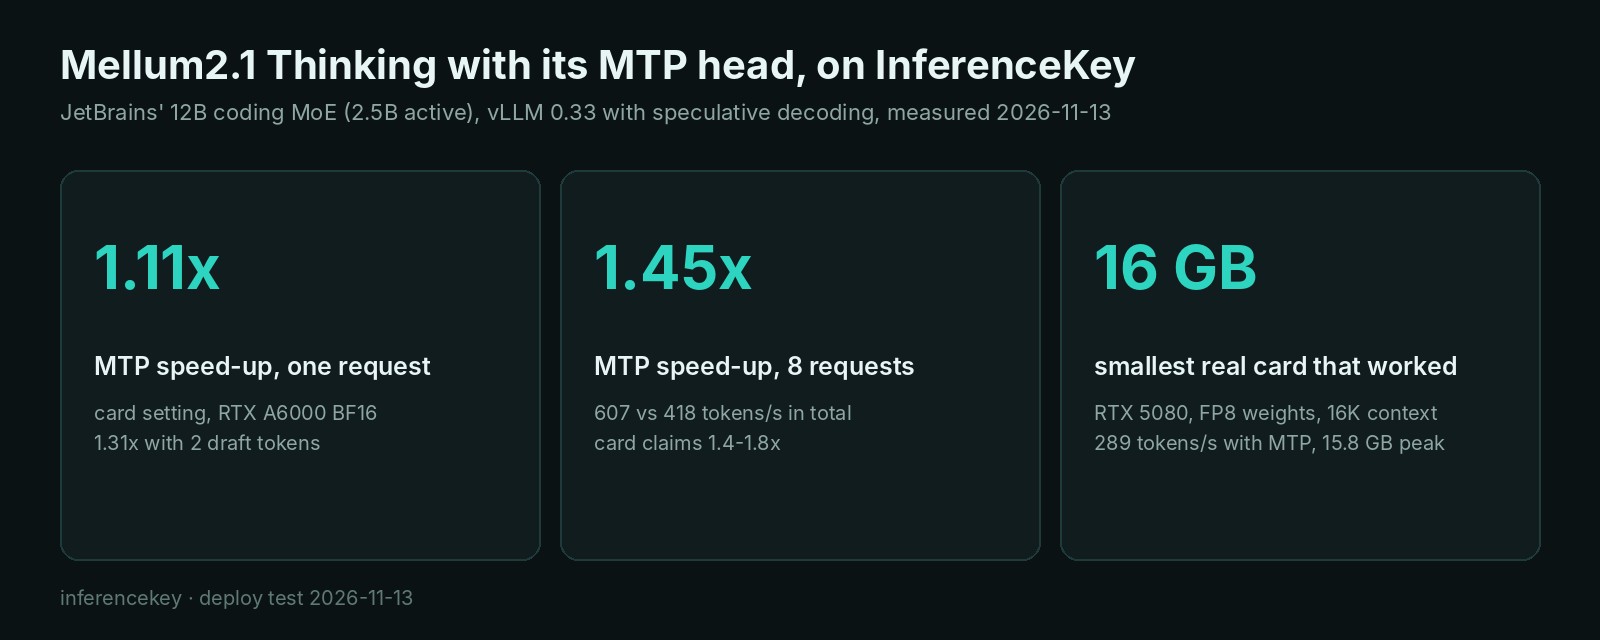
JetBrains verspricht für den MTP-Kopf von Mellum2.1 1,4 bis 1,8x. Wir maßen 1,11x bei einer Anfrage, 1,45x bei acht; in 8 Bit läuft es auf einer 16-GB-RTX 5080.
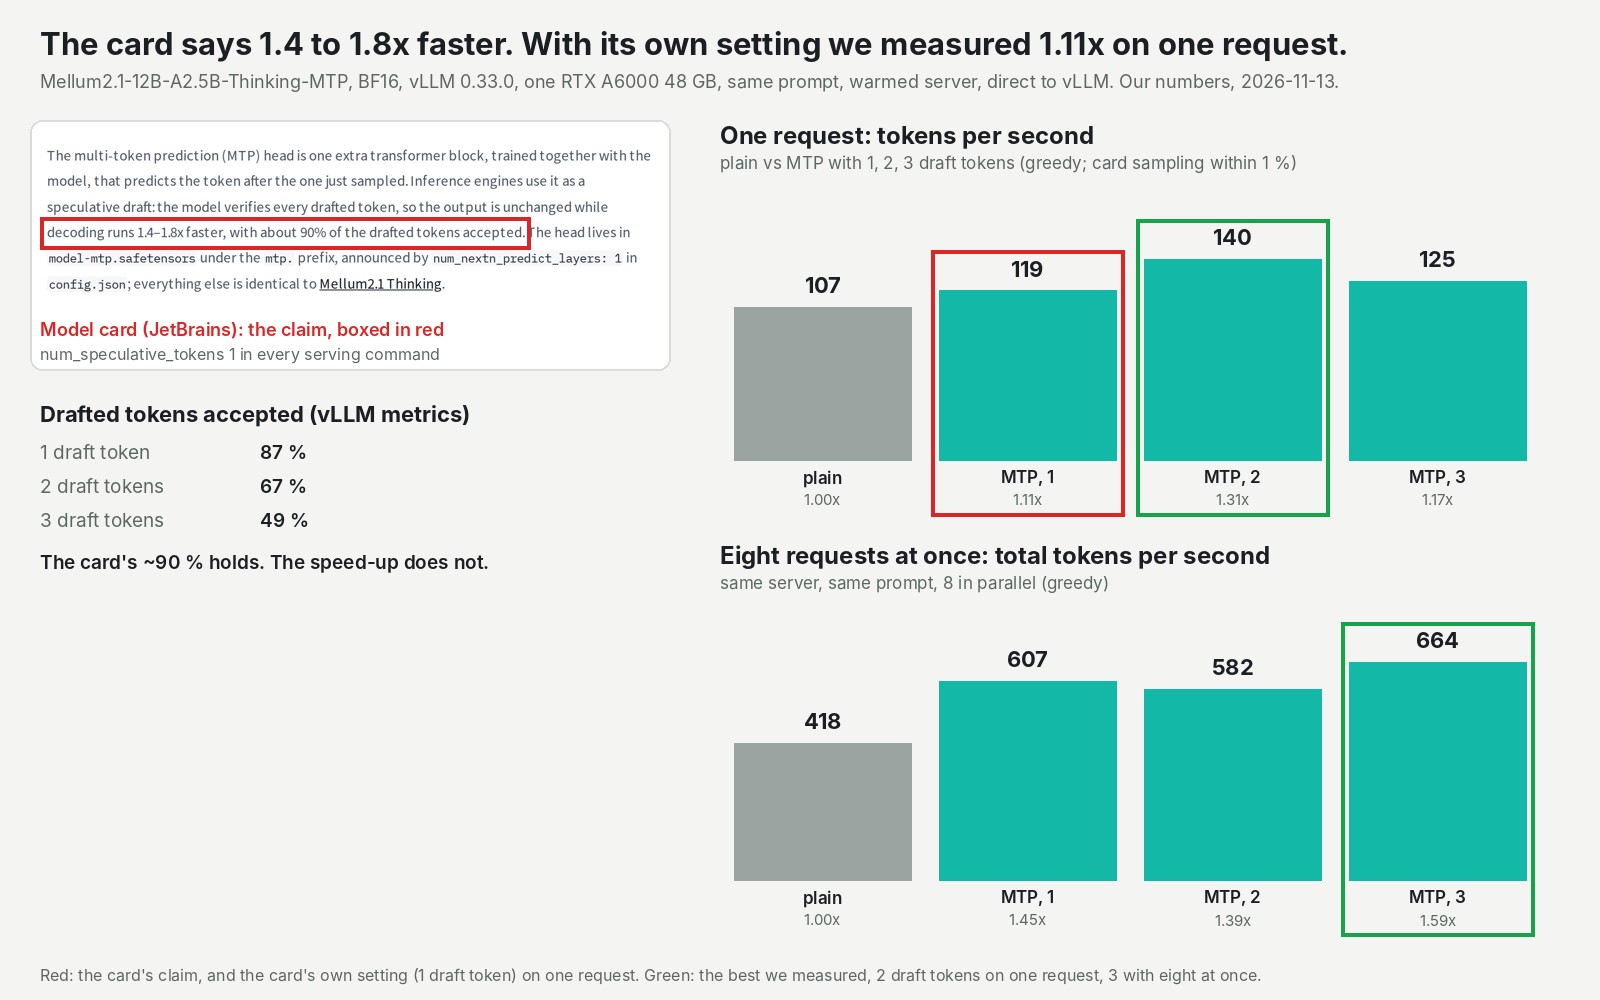
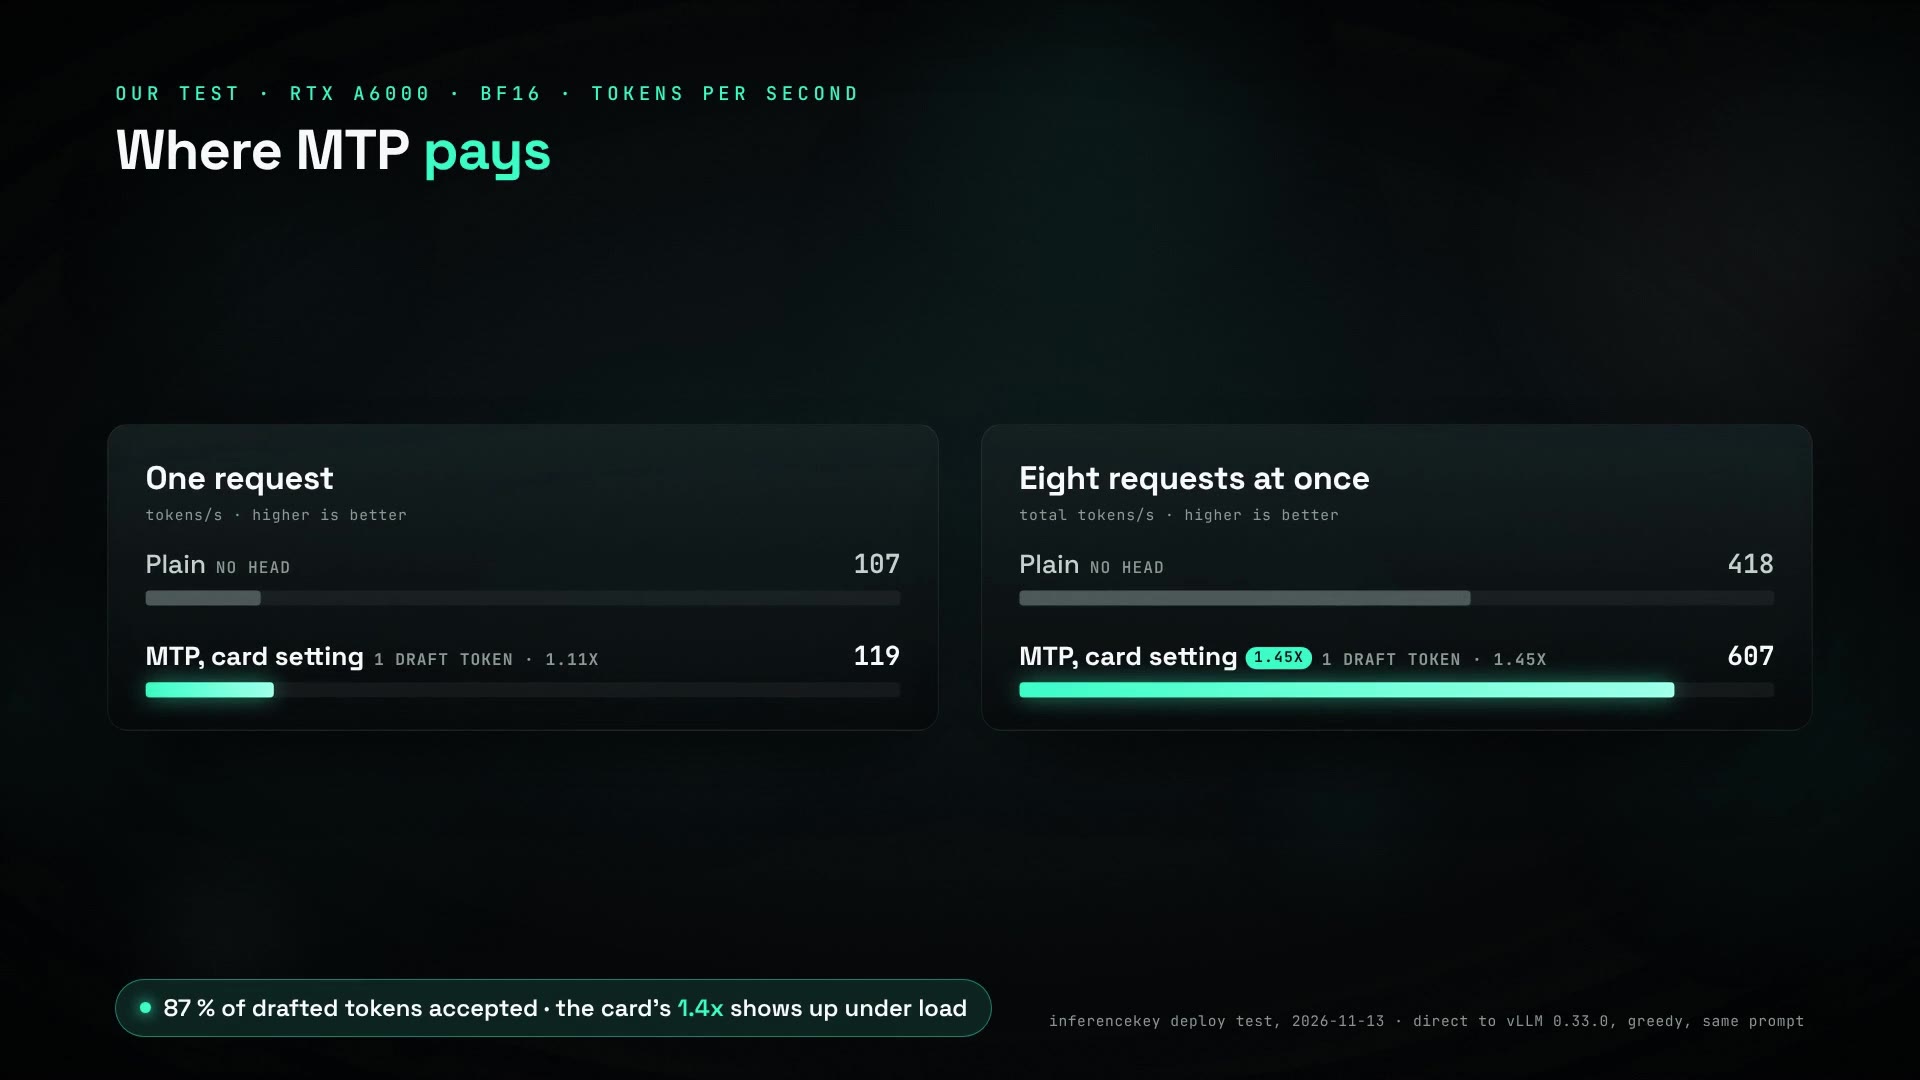
Die Vorhersagen lagen 87 von 100 Mal richtig, und trotzdem schrieb das Modell nur 11 % schneller. Das haben wir gemessen, als wir den kleinen Rater eingeschaltet haben, den JetBrains mit Mellum2.1 ausliefert, seinem offenen Coding-Modell. Die Modellseite von JetBrains verspricht 1,4- bis 1,8-mal schnelleres Schreiben bei gleicher Ausgabe. Mit der von JetBrains empfohlenen Einstellung stieg eine einzelne Anfrage auf einer RTX A6000 mit 48 GB in unserer Cloud von 107 auf 119 Tokens (Wortstücke) pro Sekunde. Mit acht Anfragen gleichzeitig, direkt auf dem vLLM-Server gemessen, lag der Gewinn bei 1,45x, also innerhalb der Spanne von JetBrains; über unseren Endpoint bekommst du heute die 1,11x einer einzelnen Anfrage. Wenn du eigene GPUs betreibst: Der Rater hat sich bei acht gleichzeitigen Anfragen weit mehr gelohnt als bei einer. In einer komprimierten 8-Bit-Kopie, halb so groß wie die veröffentlichte, läuft das Modell außerdem auf einer echten RTX 5080 mit 16 GB.
Ein zusätzlicher Block rät das nächste Wort, und das Modell prüft jeden Tipp
Der Rater ist ein kleiner Zusatzteil des Modells, der das Wort nach dem gerade geschriebenen rät. Das volle Modell prüft dann den Tipp. Stimmt es zu, behält es zwei Wörter für ungefähr den Preis eines Schritts. Wenn nicht, verwirft es den Tipp und macht weiter. JetBrains nennt diesen Teil den Kopf (Head).
Stell dir eine Bandkollegin vor, die kurz vor dem Wechsel den nächsten Akkord ansagt. Meistens nickt der Bassist nur und spielt ihn, statt ihn selbst herauszuhören. Die Ansage kostet fast nichts. Das Nicken kostet trotzdem einen Schlag, und dieser Schlag entscheidet, wie viel Zeit die Band spart.
Das ist das Versprechen auf der Modellseite von JetBrains. Das Modell „verifies every drafted token, so the output is unchanged“, während das Schreiben 1,4- bis 1,8-mal schneller läuft und etwa 90 % der Tipps akzeptiert werden. Der Haken ist das Prüfen. Es kostet ebenfalls Zeit, und JetBrains sagt nicht, auf welcher GPU und mit wie vielen Anfragen diese Spanne gemessen wurde.
Mellum2.1 Thinking ist das offene Modell von JetBrains für Code und Reasoning. Es ist ein kleines Modell, bei dem nur 2,5B seiner 12B Parameter an jedem Wort arbeiten. JetBrains hat es im September veröffentlicht und geschrieben, der Draft-Kopf sei „coming soon“. Der Kopf kam am 30. Oktober als separater Download. Laut JetBrains ist das Modell selbst unverändert. Der Kopf bringt eine Datei mit 0,86 GB und eine Zeile Konfiguration mit.
Ein Flag war die einzige Änderung, auf zwei echten GPUs und mit fünf Prompts
Den Kopf schaltet ein zusätzliches Flag ein, und das war das Einzige, was wir zwischen den Läufen geändert haben. Wir haben das Modell mit vLLM 0.33 bereitgestellt, der Open-Source-Serving-Software, die JetBrains empfiehlt. Ohne das Flag ignoriert der Server den Kopf und fährt das Modell ohne ihn.
Die Haupt-GPU war eine RTX A6000 mit 48 GB in unserer Cloud, die das Modell in voller Größe fuhr, so wie es veröffentlicht ist. Wir haben dieselben fünf Prompts mit und ohne Kopf geschickt: die eigene „Finde den Bug“-Frage von JetBrains, eine Coding-Aufgabe, eine Matheaufgabe, eine Erklärung und einen Tool-Aufruf. Danach haben wir unsere Plattform umgangen und auf dem Server selbst gemessen, mit einer Anfrage und mit acht gleichzeitig, mit einem, zwei und drei Tipps pro Schritt. Eine zweite Maschine, eine echte RTX 5080 mit 16 GB, hat gezeigt, wie klein die GPU sein darf.
Die Grenzen, einmal zusammengefasst: Es sind unsere Prompts, nicht die Tests der Autoren, und kein Dokument war lang genug, um die volle Gesprächslänge des Modells von 131.072 Tokens zu füllen. Jede Einstellung lief einmal, mit kurzen Antworten, kleine Unterschiede sind also Rauschen. Wir haben bis zu acht gleichzeitige Anfragen getestet, nicht mehr. vLLM fährt Mellum über generischen Code, nicht über Code, der für dieses Modell geschrieben wurde, und eine native Version könnte diese Zahlen ändern. Die Ergebnisse für 32 GB und 24 GB stammen aus einer Begrenzung des Speichers der A6000, nicht von echten GPUs dieser Größe.
Eine Anfrage: 1,11x mit der Einstellung von JetBrains, 1,31x mit zwei Tipps
Mit der Einstellung von JetBrains, einem Tipp pro Schritt, stieg eine einzelne Anfrage auf der A6000 von 106,8 auf 118,9 Tokens pro Sekunde. Das sind 1,11x, deutlich unter der versprochenen Untergrenze von 1,4x.
Im Alltag heißt das: Eine Coding-Antwort von etwa 600 Tokens brauchte über unseren Endpoint 5,9 Sekunden ohne Kopf und 4,9 Sekunden mit ihm. Bei einer langen Antwort sparst du eine Sekunde. In einem Chatfenster merkst du das nicht, und ein Agent, der fünfzig solcher Aufrufe macht, spart weniger als eine Minute.
Die Tipps waren nicht das Problem. Laut den eigenen Zählern von vLLM wurden 87,2 % davon akzeptiert, nah an den 90 % von JetBrains. Das Modell rät gut, und das Prüfen frisst den Großteil des Gewinns. Unsere beste Erklärung, nicht gemessen: vLLM hat noch keinen optimierten Code für Mellum. Und ein Modell, das pro Wort so leicht ist, ist so schnell, dass das Prüfen ungefähr so viel kostet, wie es spart.
Zwei Tipps pro Schritt schnitten besser ab: 140,2 Tokens pro Sekunde, 1,31x. Nur zwei von drei trafen (66,6 %), aber jeder Treffer sparte zwei Schritte. Drei Tipps: Etwa die Hälfte traf (48,6 %), 124,8 Tokens pro Sekunde. Bei einer Anfrage gewannen zwei Tipps. Die vLLM-Dokumentation empfiehlt, mit einem Tipp anzufangen. Probier einen und zwei mit deinem eigenen Traffic aus.
Acht Anfragen gleichzeitig: 1,45x, innerhalb der Spanne von JetBrains
Mit acht Anfragen gleichzeitig auf der A6000 war dieselbe Arbeit in etwa zwei Dritteln der Zeit fertig: 607,3 Tokens pro Sekunde gegen 418,4, also 1,45x, direkt auf dem vLLM-Server gemessen; über unseren Endpoint bekommst du heute die 1,11x einer einzelnen Anfrage. Das widerspricht dem üblichen Muster, nach dem Speculative Decoding weniger bringt, je mehr Anfragen sich stapeln; wir haben es einmal gemessen und können es nicht erklären.
Mit einem, zwei und drei Tipps lagen acht gleichzeitige Anfragen zwischen 1,39x und 1,66x, es lohnt sich also bei jeder dieser Einstellungen. Zwischen zwei und drei Tipps gab es keinen klaren Gewinner.
Der Kopf kostet weniger als ein Gigabyte Gewichte, bezahlt mit Platz für Gespräche
Der Kopf braucht auf der A6000 weniger als ein Gigabyte (0,80 GiB) zusätzlich. vLLM hält den gesamten Speicherverbrauch der GPU fest, also zeigen sich die Kosten an anderer Stelle.
Der Server führt einen Notizblock über jedes laufende Gespräch, damit er es nicht bei jedem Wort neu lesen muss. Der Speicher, den das Modell nicht braucht, geht an diesen Notizblock. Mit eingeschaltetem Kopf schrumpfte der Notizblock der A6000 von 1.122.580 Tokens auf 1.027.634, etwa 8,5 % weniger. Das reicht immer noch für fast acht Gespräche in der vollen Modelllänge von 131.072 Tokens. Auf einer 48-GB-GPU ist der Kopf nahezu gratis.
Auf einer 16-GB-GPU ist er das nicht. Auf der RTX 5080 aus dem nächsten Abschnitt ging der Notizblock von 52.400 Tokens auf 29.019 zurück: Platz für drei volle Gespräche mit 16.384 Tokens wurde zu Platz für eines. Diese Zahl solltest du abwägen, bevor du den Kopf auf einer kleinen GPU einschaltest.
Welche GPU: 16 GB haben gereicht, auf einer echten RTX 5080 mit 8-Bit-Gewichten
Die kleinste GPU, die funktioniert hat, war eine echte RTX 5080 mit 16 GB. Wir haben vLLM eine komprimierte Kopie laden lassen, halb so groß wie die veröffentlichte (8 Bit), mit Gesprächen von bis zu 16.384 Tokens. Sie schrieb 217,2 Tokens pro Sekunde ohne Kopf, 288,7 mit einem Tipp (1,33x) und 291,2 mit zwei. In der Spitze nutzte sie 97 % ihres Speichers und lieferte jede Antwort richtig. Das schlägt die A6000 in voller Größe. Wahrscheinliche Gründe, nicht gemessen: Sie ist eine neuere GPU, und kleinere Gewichte bedeuten weniger zu lesen pro Wort.
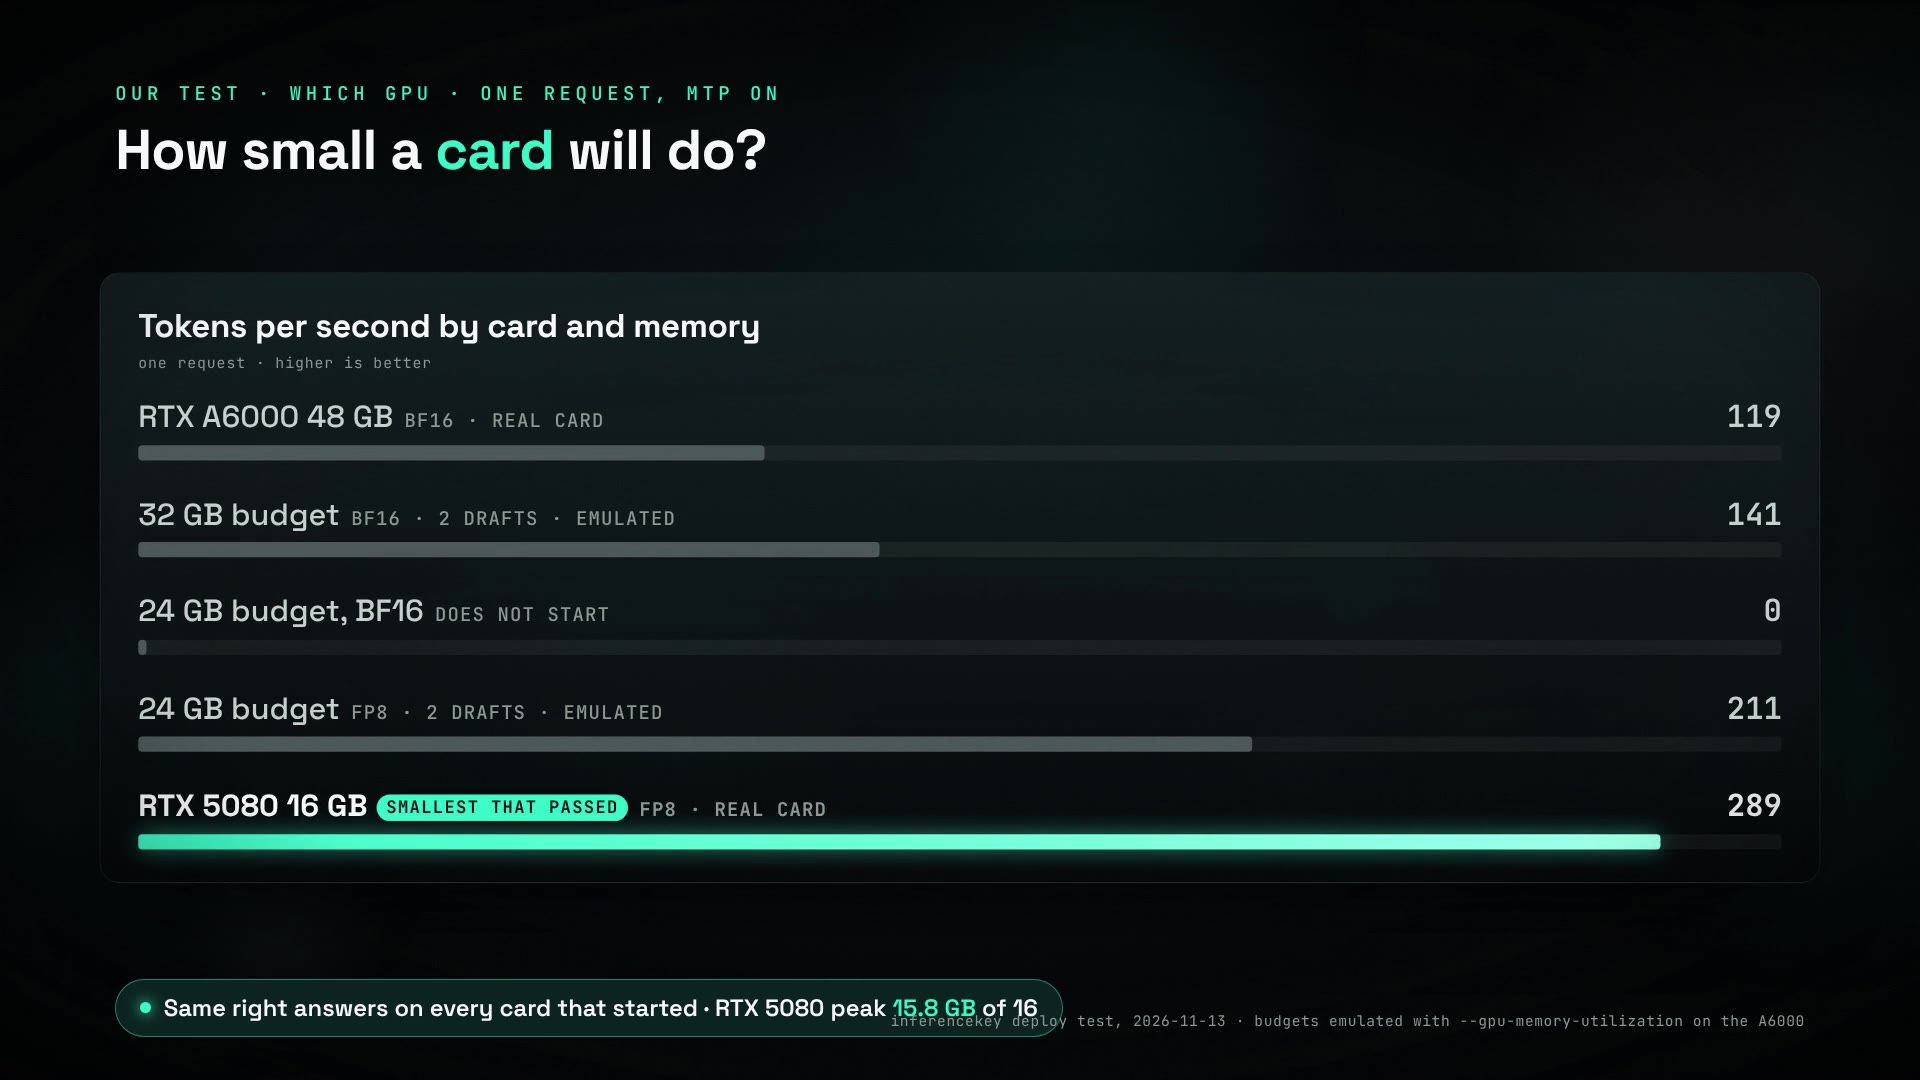
Du brauchst keine 48 GB; das war nur unsere Haupt-Test-GPU. In voller Größe startete das Modell mit der 24-GB-Begrenzung nicht: Die Gewichte allein belegen 23,47 GiB und lassen keinen Platz für den Notizblock.
Gleiche Antworten in der Qualität, nicht Byte für Byte
Jeder Lauf lieferte richtige Antworten, mit Kopf und ohne. Das Modell fand den Bug im Beispiel von JetBrains jedes Mal. Seine Funktion zum Zusammenführen von Intervallen bestand unsere vier Prüfungen in allen 13 Ausgaben, die wir getestet haben. Die Matheaufgabe beantwortete es in jedem Lauf mit 400. Seine Tool-Aufrufe kamen korrekt formatiert zurück.
„Output is unchanged“ galt nicht Byte für Byte. Mit der Anweisung, immer das wahrscheinlichste Wort zu wählen, lieferten zwei Läufe desselben Prompts auf demselben Server Antworten mit 369 und 810 Tokens. Das passierte auch ohne Kopf (380 und 829). Die vLLM-Dokumentation sagt das auch: Die Rundung der GPU und die Zahl der gemeinsam laufenden Anfragen können die genauen Wörter ändern. Wenn deine Tests die Modellausgabe Byte für Byte vergleichen, brechen sie mit oder ohne Kopf. Vergleich stattdessen das Ergebnis.
Auf InferenceKey: Eine Einstellung schaltet den Kopf um, und eine kalte GPU war in 8 Minuten bereit
Eine Einstellung im SDK-Beispiel schaltet den Kopf ein oder aus, und der Server startet in 101 Sekunden neu. Eine kalte Maschine brauchte 488,9 Sekunden, etwa 8 Minuten, von unserer Anfrage bis zur Antwortbereitschaft. Etwa vier dieser Minuten gingen für die Installation von vLLM 0.33 drauf und drei dafür, dass vLLM seine Engine aufwärmt.
Wir haben vLLM 0.33.0 in unserem Standard-Setup gewählt und den Befehl von JetBrains wie in unserem Test ausgeführt. Nichts musste gebaut oder gepatcht werden. Die RTX 5080 brauchte 20 Minuten, das meiste davon für langsame Paket-Downloads auf dieser Maschine.
Das Problem, auf das du stoßen wirst: Unsere Plattform gibt jedem Modell immer nur eine Anfrage auf einmal weiter. Acht Anfragen über unseren Endpoint stehen Schlange, deshalb wurde der Gewinn von 1,45x oben auf dem Server selbst gemessen, nicht über die Plattform. Über unseren Endpoint bekommst du heute den Gewinn einer einzelnen Anfrage. Status: offen auf unserer Seite.
Dieser Lauf nutzte eine lokale Kopie der Plattform mit demselben Worker, nicht den gehosteten Dienst.
Solltest du ihn einschalten? Ja auf einer geteilten GPU, und teste zwei Tipps
- Eine GPU, die sich ein Team oder mehrere Agents teilen: Schalte ihn ein; über InferenceKey siehst du den Gewinn, sobald der Worker parallele Anfragen schickt (offen auf unserer Seite).
- Ein Entwickler, eine Anfrage nach der anderen: Stell zwei Tipps pro Schritt ein und miss nach.
- Eine 16-GB-GPU: Nutze 8-Bit-Gewichte und rechne mit weniger Platz für parallele Gespräche. Belegt auf einer neueren RTX 5080; ältere 16-GB-GPUs können beim Laden scheitern.
- Eine 24-GB-GPU: 8-Bit-Gewichte funktionierten unter einer emulierten 24-GB-Begrenzung.
- Tests, die die Ausgabe Byte für Byte vergleichen: Vergleich Ergebnisse, nicht Bytes.
Um den Kopf auf deiner eigenen GPU ein- und auszuschalten, führ python main.py und danach MELLUM_MTP=0 python main.py aus dem Mellum2.1-MTP-SDK-Beispiel aus. Es braucht einen privaten NVIDIA-Worker mit 48 GB (32 GB bestanden nur unter einer emulierten Begrenzung) oder 16 GB mit MELLUM_FP8=1 MELLUM_CONTEXT=16384, dazu ein SDK-Token und einen API-Key. Über unseren Endpoint zeigt es den Gewinn einer einzelnen Anfrage, und am Ende löscht es das Deployment.
Für Ingenieure
Credits
- JetBrains: das Modell, mit seinem MTP-Kopf trainiert, unter Apache-2.0; das MTP-Repository mit dem Kopf in
model-mtp.safetensors, das Basis-Release Thinking, das GGUF-Repository mit MTP-Draft-Dateien, die Serving-Rezepte, der Quickstart-Prompt, den wir ausgeführt haben, und die Benchmark-Tabelle. - Das vLLM-Projekt: MTP Speculative Decoding (
--speculative-config '{"method": "mtp", ...}'), die Spec-Decode-Metriken, aus denen wir die Akzeptanz gelesen haben, Online-FP8-Quantisierung und das Transformers-Modeling-Backend, das Mellum und seinen Draft in 0.33.0 bereitstellt (TransformersMoEForCausalLM,TransformersMoEForMTP). - Hugging Face Transformers: der Modeling-Code, den das Backend ausführt; 5.20 ist die erste Version, die den Kopf lädt, statt ihn zu überspringen.
- pmttyji auf r/LocalLLaMA: wo wir es entdeckt haben (Post vom 2026-11-02).
- Unser Teil: das Deployment über die Plattform, die Läufe ohne Kopf gegen MTP auf derselben GPU, der Sweep über 1/2/3 Tokens und Nebenläufigkeit, die Speicherbilanz des Kopfs, die VRAM-Leiter auf zwei echten GPUs plus emulierten Begrenzungen, das SDK-Beispiel und das Demovideo.
Modell und Dateien
JetBrains/Mellum2.1-12B-A2.5B-Thinking-MTP: shad55846102dd1c047e95d4841070f88290227c3b7, erstellt 2026-10-30T17:20:32Z, zuletzt geändert 2026-10-30T18:12:02Z, nicht gated, Apache-2.0, 17 Likes und 1.302 Downloads am 2026-11-13. Fünf BF16-Shards mit 24,30 GB plusmodel-mtp.safetensorsmit 856.767.160 Bytes, insgesamt 25,17 GB.- Basis
JetBrains/Mellum2.1-12B-A2.5B-Thinking: sha92ddae9f, erstellt 2026-09-20, zuletzt geändert 2026-10-07. Seine Model Card führte GGUF-Builds und den MTP-Kopf als „coming soon“. - GGUF-Repo: sha
4159d684, zuletzt geändert 2026-10-22, BF16, MXFP4_MOE, Q4_K_M, Q6_K und Q8_0 plus Draft-GGUFs inmtp/in denselben Quants. Nicht getestet. - Architektur: 12B gesamt, 2,5B aktiv, 28 Layer (21 mit Sliding Window 1.024 und 7 mit Full Attention), hidden 2304, 64 Experten mit 8 aktiven, GQA 32 Q / 4 KV Heads, head_dim 128, Vokabular 98.304, Kontext 131.072 (YaRN-Faktor 16 auf den Full-Attention-Layern),
num_nextn_predict_layers: 1. BasismodellJetBrains/Mellum2-12B-A2.5B-Base. - Anforderungen laut Model Card: vLLM 0.33 oder neuer mit transformers 5.20 oder neuer. „vLLM releases up to 0.32 refuse the checkpoint“; transformers vor 5.20 überspringt die Tensoren des Kopfs mit einer Warnung. Weitere Wege laut Model Card, nicht getestet:
use_mtp=Truein transformersgenerateund llama.cpp mit--spec-type draft-mtp --spec-draft-n-max 1. - Sampling im Quickstart der Model Card: temperature 0.6, top_p 0.95, top_k 20, max_tokens 81920.
- Die Model Card nennt weder GPU noch Batchgröße noch Präzision hinter ihrer Spanne von 1,4 bis 1,8x.
Benchmarks der Autoren (nicht reproduziert)
| Benchmark | Mellum2.1 | Mellum2 Thinking | Gemma 4 E4B | Qwen3.5 9B |
|---|---|---|---|---|
| LiveCodeBench v6 | 82,0 | 69,4 | 69,4 | 75,4 |
| SWE-bench Verified | 47,0 | 2,0 | 23,0 | 50,0 |
| SWE-bench Pro | 28,0 | 0,0 | 4,0 | 38,0 |
| Terminal-Bench 2.1 | 17,4 | 0,6 | 3,4 | 21,7 |
| AIME 25/26 | 83,3 | 60,1 | 45,0 | 86,7 |
| GPQA Diamond | 64,6 | 51,0 | 53,1 | 77,8 |
| BFCL v4 | 62,3 | 49,6 | 52,5 | 58,5 |
Außerdem auf der Model Card für Mellum2.1: HumanEval+ 91,5, MBPP+ 79,4, IFEval 90,6, HarmBench 8,5 (niedriger ist besser). Die agentischen Läufe nutzten den Harness Pi v0.73.1.
Setup
- GPUs in der InferenceKey Cloud: RTX A6000 48 GB (46.068 MiB, Compute Capability 8.6, Treiber 595.91.07) für die Hauptläufe, ohne Kopf und mit MTP, BF16; RTX 5080 16 GB (16.303 MiB, Compute Capability 12.0, Treiber 580.178.04) für die Stufe mit einer echten kleinen Karte, FP8. Eine RTX A4000 (Ampere, 16 GB) war nicht verfügbar, FP8 auf einer echten 16-GB-Ampere-Karte ist also ungetestet.
- Backend: das eingebaute
vllm-Backend mitvllm_version="0.33.0"in der Workload-Spezifikation, das torch 2.14.0 und transformers 5.20.x installiert. vLLM 0.33.0 ordnetMellumForCausalLMdem Transformers-Modeling-Backend zu; eine native Mellum-Implementierung in vLLM gibt es noch nicht. Warum vLLM: Es ist das Hauptrezept der Model Card. - Ein lokaler InferenceKey-Manager, den die Worker über Tunnel erreichten. Produktion nie angefasst. Gewichte vorab auf die Container-Disk jedes Workers heruntergeladen (36 s auf der A6000).
- Messungen: ein Sweep pro Einstellung, keine Wiederholungen; fünf Prompts x 2 über den Endpoint (greedy, Streaming); Sweeps über Nebenläufigkeit und Draft-Tiefe direkt gegen vLLM auf dem Worker nach dem Aufwärmen; Akzeptanz aus den Zählern
vllm:spec_decode_*; VRAM ausnvidia-smi, jede Sekunde abgefragt.
Schritt für Schritt mit dem SDK-Beispiel
- Klon inferencekey-sdk und öffne
examples/mellum21-12b-a2-5b-mtp-vllm-private-nvidia(Commit0a5188e70d0c32c95c9e36a17dcb75078102e48f). cp .env.example .envund trag das SDK-Token (ik_sdk_, Workload lesen und schreiben), einenik_live_-API-Key, der den Workload erlaubt, das Projekt undIK_WORKER_IDein: einen privaten NVIDIA-Worker mit CUDA-13-Treiber (580 oder neuer), 32 GB für BF16 oder 16 GB mit FP8.pip install -r requirements.txtplus der lokale SDK-Build mit maturin (das SDK ist nicht auf PyPI).python main.py. Es führtensure()für einen festenvllm-Workload (Slugmellum21-thinking,vllm_version="0.33.0") auf deinem Worker aus, wartet bis zu 2.400 s, stellt die Quickstart-Frage der Model Card mitgenerate_text(), streamt einemerge_intervals-Aufgabe mit Zeit bis zum ersten Token und Tokens pro Sekunde, fährt eineget_weather-Agent-Schleife mit bis zu 4 Runden, schreibtoutputs/answers-<mtp|plain>.jsonund ruftdelete()auf, außer beiIK_KEEP_ALIVE=1.- Varianten:
MELLUM_MTP=0 python main.pyfür das Modell ohne Kopf;MELLUM_FP8=1 MELLUM_CONTEXT=16384 MELLUM_SPEC_TOKENS=2 python main.pyfür eine 16-GB-Karte. Weitere Einstellungen:MELLUM_SPEC_TOKENS(Standard 1, die der Model Card),MELLUM_CONTEXT(131072),MELLUM_GPU_UTIL(0.90).
Der Befehl, den das Backend ausführt (MTP an, Einstellung der Model Card):
vllm serve JetBrains/Mellum2.1-12B-A2.5B-Thinking-MTP \
  --max-model-len 131072 --gpu-memory-utilization 0.90 --max-num-seqs 16 \
  --reasoning-parser qwen3 \
  --enable-auto-tool-choice --tool-call-parser hermes \
  --speculative-config '{"method": "mtp", "num_speculative_tokens": 1}'
Für das Modell ohne Kopf lass --speculative-config weg. Für die Stufe mit der RTX 5080 ergänze --quantization fp8, setz --max-model-len 16384 und num_speculative_tokens auf 1 oder 2. Das Beispiel schickt nur temperature und top_p; ein Codekommentar sagt, dass top_k=20 der Model Card nicht durch den Endpoint kommt (nicht gegen den Manager-Code geprüft).
Zeiten
| Schritt | Zeit |
|---|---|
A6000 kalt, ensure() bis bereit | 488,9 s |
| davon Installation von vLLM 0.33.0 | etwa 4 min |
| Vorab-Download der Gewichte | 36 s |
| Laden der Gewichte (23,47 GiB) | 12,3 s |
| torch.compile | 35,5 s |
| Engine-Init (Profiling, KV-Cache, Aufwärmen) | 179,65 s |
| Neustart der A6000 mit MTP aus | 101,2 s (Engine-Init 47,2 s) |
| Direkte Stufen, warme Caches | 66 bis 126 s |
RTX 5080, ensure() bis bereit | 1.207,1 s (etwa 14 min pip-Downloads mit wenigen hundert kB/s auf diesem Host; Laden 19,7 s; Engine-Init 260,0 s) |
Zeit bis zum ersten Token über den Endpoint: 0,23 bis 0,29 s in jedem Fall.
Geschwindigkeit über den Endpoint (A6000, BF16, greedy, Streaming)
| Prompt | Ohne Kopf: Tokens / s / tok/s | MTP 1 Draft: Tokens / s / tok/s |
|---|---|---|
| Bug aus dem Quickstart der Model Card (x2) | 381 / 3,69 / 110,2 | 372 / 3,24 / 123,5 |
merge_intervals (x2) | 619 / 5,91 / 109,1 | 603 / 4,90 / 129,6 |
| n^2+1 durch 5 teilbar, n <= 1000 | 380 und 829 / 3,74 und 7,90 / 110,3 und 108,2 | 369 und 810 / 3,16 und 6,77 / 127,0 und 124,3 |
| Erklärung Hash Map | 792 und 881 / 7,55 und 8,45 / 108,3 und 107,6 | 940 und 718 / 8,06 und 6,19 / 120,4 und 120,7 |
| Lissabon oder Oslo (Tools) | 280 / 2,78 / 109,7, zwei parallele Aufrufe | 244 / 2,16 / 126,7, nur Lissabon |
Akzeptanz während dieses Benchmarks auf dem MTP-Workload: 3365/3767 = 89,3 %.
Geschwindigkeit direkt gegen vLLM (warm)
| A6000, BF16, 131.072 Kontext, util 0.90 | 1 Anfrage greedy | 1 Anfrage Sampling der Model Card | 8 gleichzeitig greedy | 8 gleichzeitig Sampling der Model Card | Akzeptiert |
|---|---|---|---|---|---|
| Ohne Kopf | 106,8 | 105,7 | 418,4 | 316,4 | |
| MTP, 1 Draft (Model Card) | 118,9 (1,11x) | 118,6 (1,12x) | 607,3 (1,45x) | 462,1 (1,46x) | 87,2 % (8396/9623) |
| MTP, 2 Drafts | 140,2 (1,31x) | 138,9 (1,31x) | 581,8 (1,39x) | 525,9 (1,66x) | 66,6 % (9931/14906) |
| MTP, 3 Drafts | 124,8 (1,17x) | 125,5 (1,19x) | 663,5 (1,59x) | 478,5 (1,51x) | 48,6 % (10070/20709) |
| RTX 5080, FP8, 16.384 Kontext, util 0.90 | 1 Anfrage greedy | 1 Anfrage Sampling der Model Card | 8 gleichzeitig greedy | 8 gleichzeitig Sampling der Model Card | Akzeptiert |
|---|---|---|---|---|---|
| Ohne Kopf | 217,2 | 212,4 | 896,7 | 468,1 (nicht vergleichbar: 3 von 8 liefen 64 s, 30.205 Tokens, bei einem KV von 52.400 Tokens) | |
| MTP, 1 Draft | 288,7 (1,33x) | 279,7 (1,32x) | 1.276,5 (1,42x) | 966,1 | 87,7 % (10443/11913) |
| MTP, 2 Drafts | 291,2 (1,34x) | 283,9 | 1.297,4 (1,45x) | 1.212,0 | 68,6 % (14209/20726, gesamter Traffic) |
Über den Endpoint auf der RTX 5080 mit MTP 2: 298 bis 344 tok/s.
Bei acht gleichzeitigen Anfragen lagen mit Greedy Decoding drei Drafts vorn und mit dem Sampling der Model Card zwei; jeweils ein Lauf.
Was der MTP-Kopf an Speicher kostet
| Karte, Präzision | Gewichte ohne Kopf / MTP | KV-Cache ohne Kopf | KV-Cache MTP 1 | Spitze ohne Kopf / MTP |
|---|---|---|---|---|
| RTX A6000, BF16, util 0.90 | 22,67 / 23,47 GiB (+0,80) | 16,75 GiB = 1.122.580 Tokens | 15,87 GiB = 1.027.634 Tokens (-8,5 %); 16,0 GiB = 1.036.154 in der direkten Stufe | 41.017 / 41.147 MiB |
| RTX 5080, FP8, util 0.90, 16.384 Kontext | 11,74 / 12,14 GiB (+0,40) | 1,36 GiB = 52.400 Tokens | 0,87 GiB = 29.019 Tokens (-45 %); 25.967 mit MTP 2 | 14.364 / 15.832 MiB |
Die Spitze wird durch --gpu-memory-utilization festgelegt, deshalb zeigen sich die Kosten des Kopfs auf der A6000 als verlorener KV-Platz, nicht als höhere Spitze. Der höchste einzelne Messwert der A6000 lag bei 41.280 MiB, während des MTP-Workloads. vLLM warnte außerdem Add 6 padding layers, may waste at most 27.27% KV cache memory.
VRAM-Leiter
| GPU oder Begrenzung | Konfiguration | VRAM-Spitze | Geschwindigkeit (1 Anfrage) | Ausgabe OK | Echt oder emuliert |
|---|---|---|---|---|---|
| RTX A6000 48 GB | BF16, 131.072, ohne Kopf | 41.017 MiB | 106,8 tok/s | ja | echt |
| RTX A6000 48 GB | BF16, 131.072, MTP 1 (Model Card) | 41.147 MiB | 118,9 tok/s | ja | echt |
| RTX A6000 48 GB | BF16, 131.072, MTP 2 | 41.033 MiB | 140,2 tok/s | ja | echt |
| RTX A6000 48 GB | BF16, 131.072, MTP 3 | 41.049 MiB | 124,8 tok/s | ja | echt |
| Begrenzung 32 GB (util 0.71) | BF16, 32.768, MTP 2 | 32.391 MiB (KV 7,34 GiB, 337.838 Tokens) | 140,6 tok/s | ja | emuliert |
| Begrenzung 24 GB (util 0.52) | BF16, 16.384, MTP 2 | keine | keine | nein: ValueError: No available memory for the cache blocks (BF16-Gewichte 23,47 GiB) | emuliert |
| Begrenzung 24 GB (util 0.52) | FP8 online, 32.768, MTP 2 | 23.779 MiB (Gewichte 12,18 GiB, KV 10,08 GiB, 463.944 Tokens) | 211,4 tok/s | ja | emuliert |
| Begrenzung 16 GB (util 0.345) | FP8 online, 16.384, MTP 2 | 15.819 MiB im Betrieb, 21.917 MiB Lastspitze beim Laden (Marlin, reines Gewichts-FP8 auf Ampere) | 209,3 tok/s | ja | emuliert |
| RTX 5080 16 GB | FP8, 16.384, ohne Kopf | 14.364 MiB | 217,2 tok/s | ja | echt |
| RTX 5080 16 GB | FP8, 16.384, MTP 1 | 15.832 MiB von 16.303 | 288,7 tok/s | ja | echt |
| RTX 5080 16 GB | FP8, 16.384, MTP 2 (SDK-Beispiel über den Endpoint) | 15.832 MiB von 16.303 | 291,2 tok/s direkt; 303,3 tok/s bei der Code-Aufgabe des Beispiels | ja | echt |
Nicht ausprobiert: 12 GB (die FP8-Gewichte allein belegen 12,18 GiB), der Weg über GGUF und llama.cpp, FP8 auf einer echten 24-GB-Karte (3090/4090), BF16 auf einer echten 32-GB-Karte, mehr als 16K Kontext bei 16 GB, ein langer Prompt, der das volle Fenster von 131.072 nutzt, transformers use_mtp=True und die Benchmarks der Autoren. Die FP8-Qualität haben wir nur mit unseren fünf Prompts geprüft.
Qualitätsprüfungen
- Quickstart der Model Card (
def mean(xs): return sum(xs) / len(xs) - 1): Bug in jedem Lauf und auf jeder Stufe gefunden. merge_intervals: 13 von 13 geprüften Ausgaben bestanden 4 Asserts.- Mathe (n^2+1 durch 5 teilbar, n <= 1000): 400 in jedem Lauf.
- Tools: gültige Aufrufe im hermes-Format in jedem Lauf.
- Läufe des SDK-Beispiels: A6000 mit MTP, Code-Aufgabe 510 Tokens in 4,36 s, 126,1 tok/s, TTFT 0,32 s; A6000 ohne Kopf, 474 Tokens, 109,4 tok/s; RTX 5080 FP8 MTP 2, 700 Tokens in 2,47 s, 303,3 tok/s.
Offene Probleme
- Beschleunigung bei einer Anfrage unter der Spanne der Model Card auf der A6000 in BF16. 1,11x mit einem Draft-Token, obwohl 87,2 % akzeptiert werden. Hypothese, nicht bewiesen: das generische Transformers-Modeling-Backend plus die vLLM-Meldung
Using default MoE config. Performance might be sub-optimal!, und ein Verifikationsschritt, der bei einem MoE mit 2,5B aktiven Parametern fast so viel kostet, wie er spart. Zwei Draft-Tokens bringen 1,31x. Offen upstream: noch keine native Mellum-Implementierung in vLLM. - Ein Job nach dem anderen pro Workload auf dem Worker (
max_in_flight slots=1). Parallele Anfragen über den Endpoint stehen Schlange, deshalb wurden die Zahlen zur Nebenläufigkeit direkt gegen vLLM gemessen. Offen auf unserer Seite. - Greedy-Ausgaben zwischen Läufen nicht Byte für Byte identisch, mit und ohne MTP (MTP: Mathe 369 gegen 810 Tokens, Hash Map 940 gegen 718; ohne Kopf: 380 gegen 829, 792 gegen 881). Die Antworten blieben richtig. Laut vLLM-Dokumentation erwartet: Speculative Decoding ist verlustfrei „up to the precision limits of hardware numerics“, und die Batchgröße kann Logprobs und Ausgabewahrscheinlichkeiten verschieben.
- Tool Calling schwankte zwischen Läufen. Auf der A6000 in BF16 mit MTP rief das Modell die Tools mit einer Stadt pro Runde auf (Lissabon, dann Oslo); ohne MTP machte es zwei parallele
get_weather-Aufrufe, ebenso Lauf 3 auf der RTX 5080 (FP8, MTP 2). Clients brauchen eine Agent-Schleife. Die erste Version unseres Beispiels erlaubte eine Runde und lieferte eine leere Schlussantwort. Behoben: Das Beispiel läuft bis zu 4 Runden. - Die erste Anfrage mit Sampling nach einem Neustart ist langsam: Triton kompiliert
_gumbel_sample_kernelund andere per JIT, 52,4 tok/s, danach 105,8. Vor dem Messen aufwärmen. - Online-FP8 auf Ampere lädt über eine Spitze: 21.917 MiB für etwa 3 s unter der 16-GB-Begrenzung. Eine echte 16-GB-Ampere-Karte kann beim Laden scheitern. Die RTX 5080 (natives FP8) zeigte das nicht.
- vLLM-Warnungen: KV-Padding (
may waste at most 27.27% KV cache memory), Standard-MoE-Konfiguration undmax_num_scheduled_tokens is set to 2048 based on the speculative decoding settings. - Langsame Paket-Downloads auf dem Host der RTX 5080: etwa 14 der 20 Minuten bis zur Bereitschaft.
Demovideo
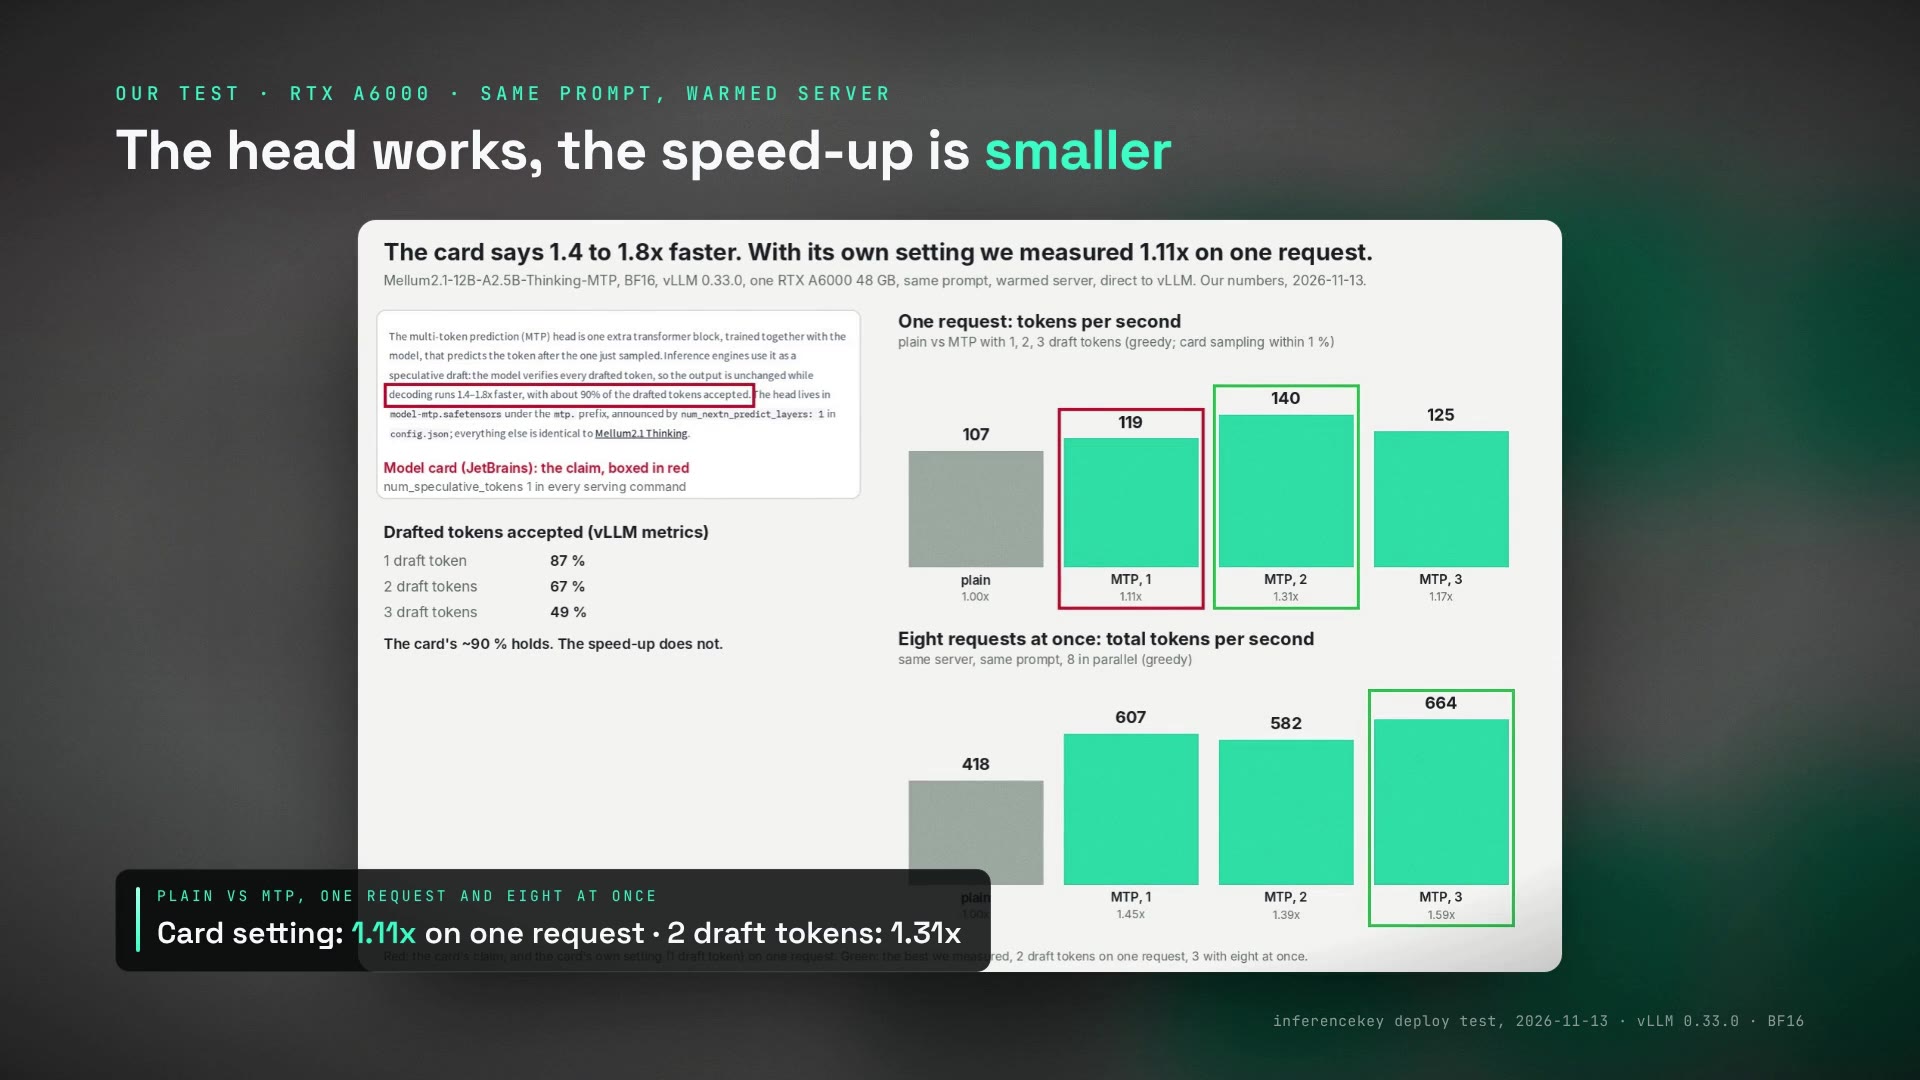
Die kommentierte Demo von 165 Sekunden: was Mellum2.1 ist (die Model Card, der MTP-Absatz, die Benchmarks der Autoren und ein Vergleich auf Terminal-Bench 2.1 mit GPT-5.6 Sol und Claude Mythos 5 aus dem BenchLM-Spiegel des Vals-Leaderboards (abgerufen am 2026-11-08, nicht erneut geprüft), mit einem anderen Harness als dem der Autoren), das Deployment im Panel auf der RTX A6000 mit eingeschaltetem Kopf (eine Coding-Aufgabe mit 128 Tokens pro Sekunde, 640 Tokens in 5,1 s, und die Tool-Schleife, Lissabon, dann Oslo, in 4,9 s), der Kernvergleich ohne Kopf gegen MTP und die GPU-Leiter. Mit englischen Untertiteln.
Quellen
- JetBrains/Mellum2.1-12B-A2.5B-Thinking-MTP (Model Card, Konfiguration, MTP-Kopf).
- JetBrains/Mellum2.1-12B-A2.5B-Thinking (Basis-Release).
- JetBrains/Mellum2.1-12B-A2.5B-Thinking-GGUF (nicht getestet).
- vLLM-Dokumentation zu Speculative Decoding, abgerufen am 2026-11-13 (leitet auf die Seiten zu Speculative Decoding und MTP weiter).
- Post von pmttyji auf r/LocalLLaMA, 2026-11-02 (wo wir es entdeckt haben).
- SDK-Beispiel, Commit
0a5188e70d0c32c95c9e36a17dcb75078102e48f.