La tête MTP de Mellum2.1 : 1,11x plus rapide sur une requête, 1,45x sur huit, et le modèle tourne en 8 bits sur une RTX 5080 de 16 GB
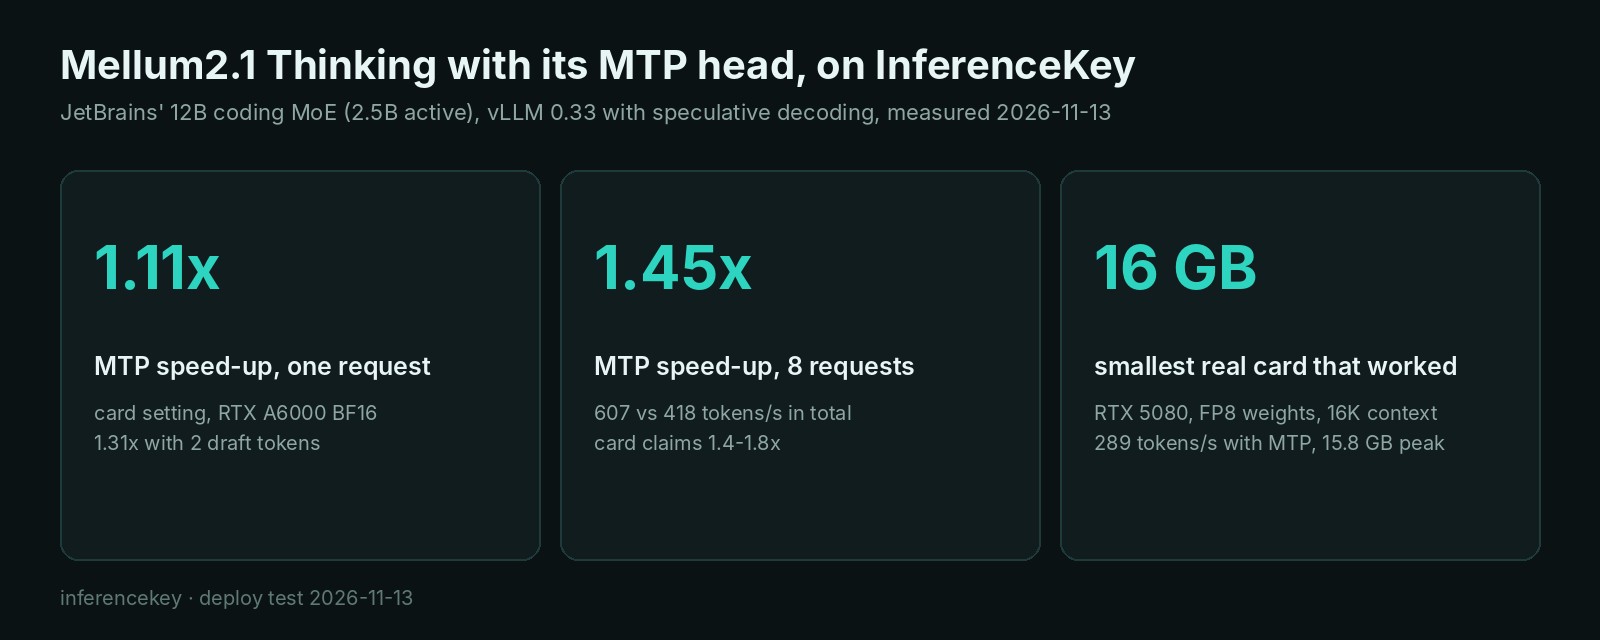
JetBrains promet 1,4 à 1,8x avec la tête MTP de Mellum2.1. Mesuré : 1,11x sur une requête, 1,45x sur huit, et en 8 bits sur une RTX 5080 de 16 GB.
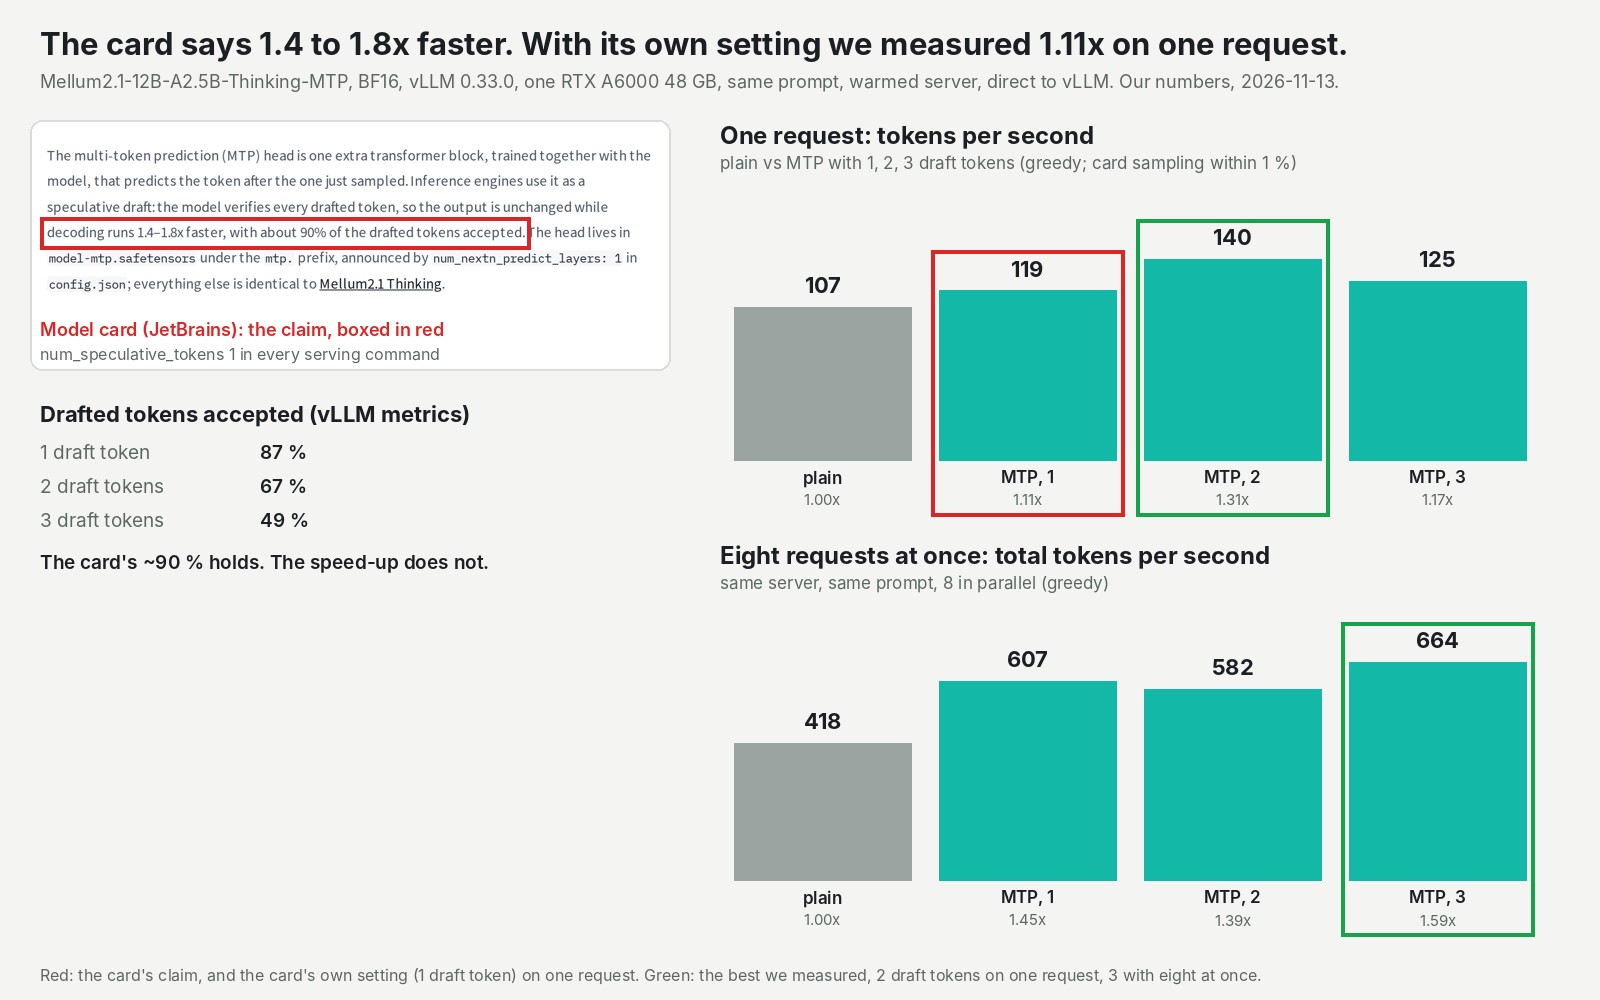
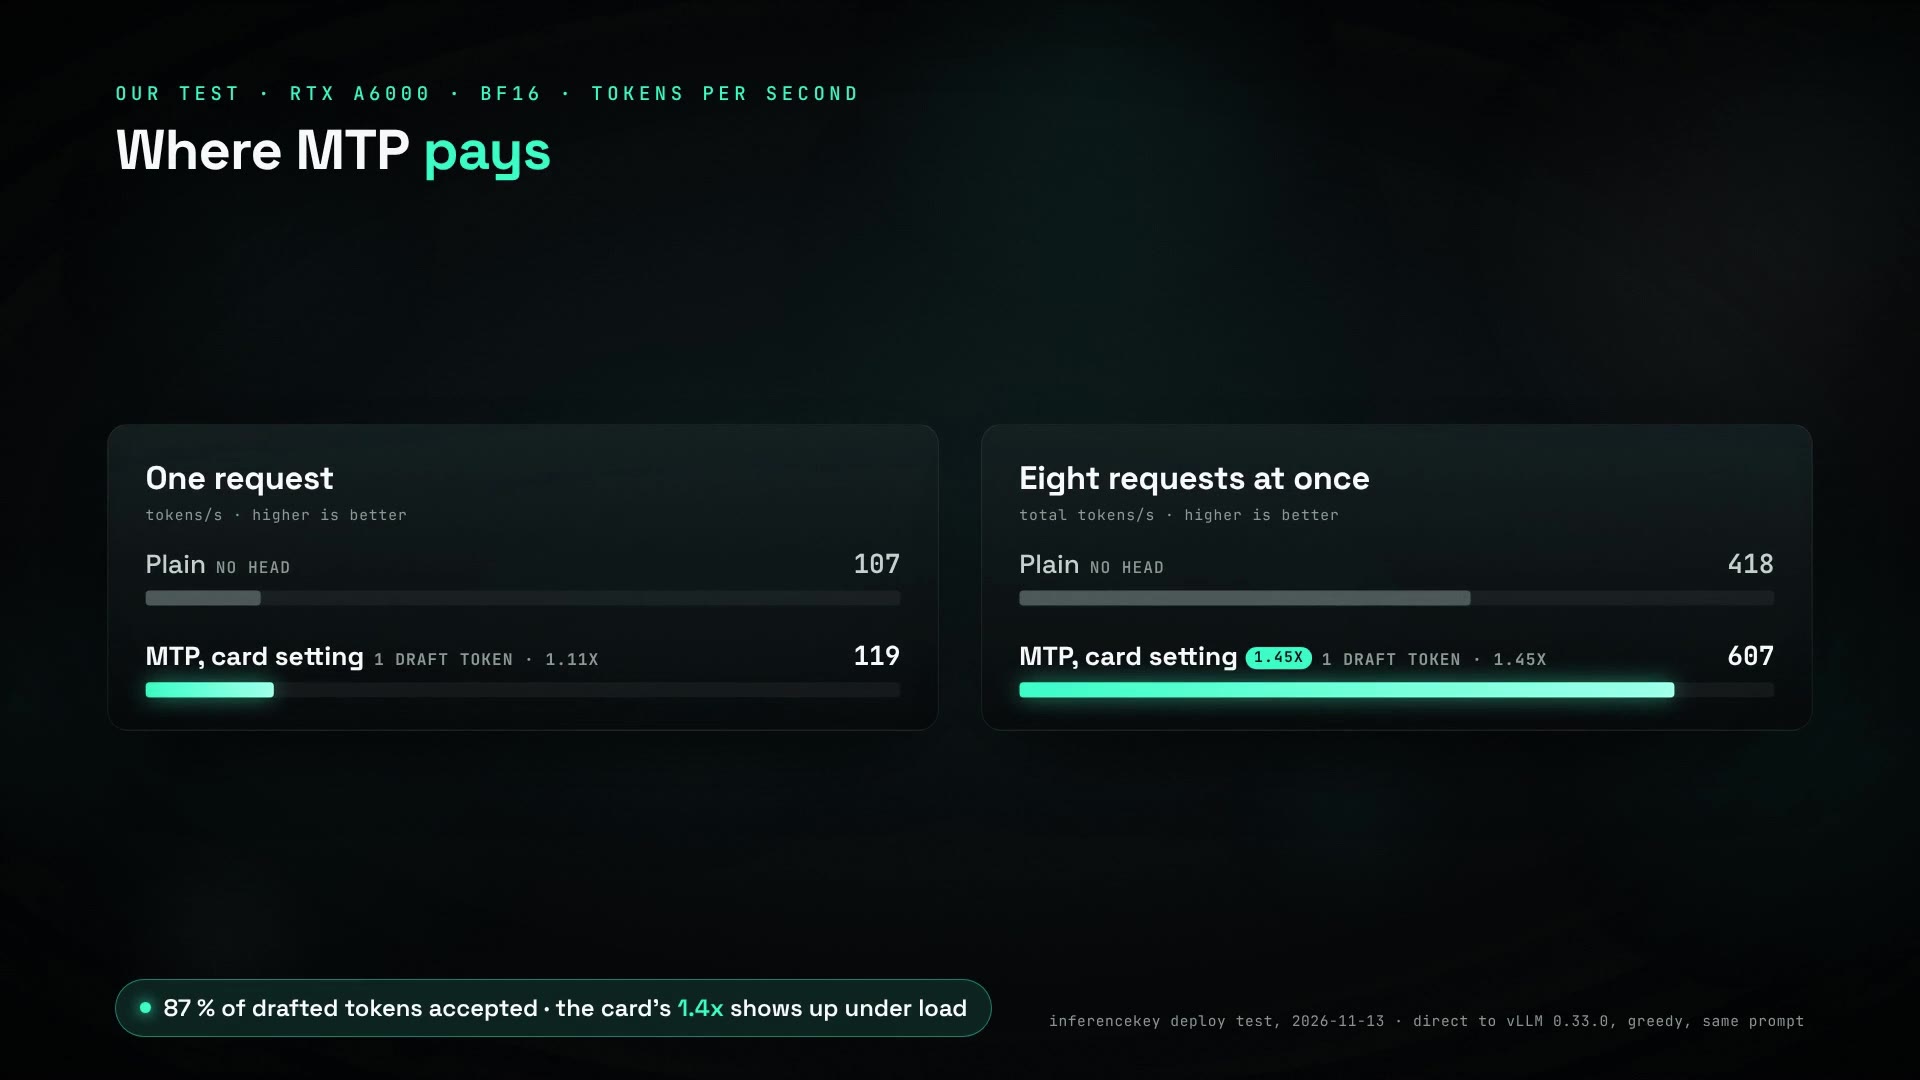
Les propositions étaient justes 87 fois sur 100, et le modèle n'a pourtant écrit que 11 % plus vite. C'est ce que nous avons mesuré en activant le petit bloc devineur que JetBrains livre avec Mellum2.1, son modèle ouvert pour le code. La page du modèle de JetBrains promet une écriture 1,4 à 1,8 fois plus rapide, avec la même sortie. Avec le réglage recommandé par JetBrains, une requête sur une RTX A6000 de 48 GB de notre cloud est passée de 107 à 119 tokens (des morceaux de mots) par seconde. Avec huit requêtes à la fois, mesuré directement sur le serveur vLLM, le gain était de 1,45x, dans la fourchette de JetBrains ; via notre endpoint, vous obtenez aujourd'hui le 1,11x d'une seule requête. Si vous faites tourner vos propres GPU, le devineur a rapporté bien plus avec huit requêtes à la fois qu'avec une seule. Dans une copie compressée en 8 bits, moitié moins lourde que la version publiée, le modèle tourne aussi sur une vraie RTX 5080 de 16 GB.
Un bloc en plus devine le mot suivant, et le modèle vérifie chaque proposition
Le devineur est une petite partie ajoutée au modèle, qui devine le mot qui suit celui qui vient d'être écrit. Le modèle complet vérifie ensuite la proposition. S'il est d'accord, il garde deux mots pour à peu près le prix d'une étape. Sinon, il jette la proposition et continue. JetBrains appelle cette partie la tête.
Imaginez un membre du groupe qui annonce l'accord suivant juste avant le changement. La plupart du temps, le bassiste se contente d'acquiescer et de le jouer, au lieu de le chercher lui-même. L'annonce ne coûte presque rien. Le hochement de tête prend quand même un temps, et c'est ce temps qui décide de ce que le groupe gagne.
Voilà la promesse de la page du modèle de JetBrains. Le modèle "verifies every drafted token, so the output is unchanged", tandis que l'écriture va 1,4 à 1,8 fois plus vite, avec environ 90 % des propositions acceptées. Le piège, c'est la vérification. Elle prend du temps elle aussi, et JetBrains ne dit pas sur quel GPU ni avec combien de requêtes il a mesuré cette fourchette.
Mellum2.1 Thinking est le modèle ouvert de JetBrains pour le code et le raisonnement. C'est un petit modèle où seuls 2,5B de ses 12B de paramètres travaillent sur chaque mot. JetBrains l'a publié en septembre en écrivant que la tête de proposition arrivait "coming soon". La tête est arrivée le 30 octobre, en téléchargement séparé. JetBrains dit que le modèle lui-même n'a pas changé. La tête ajoute un fichier de 0,86 GB et une ligne de configuration.
Un seul flag changé, sur deux vrais GPU et cinq prompts
Activer la tête, c'est un flag de plus, et c'est la seule chose que nous avons changée entre les essais. Nous avons servi le modèle avec vLLM 0.33, le logiciel de service open source que JetBrains recommande. Sans le flag, le serveur ignore la tête et fait tourner le modèle seul.
Le GPU principal était une RTX A6000 de 48 GB sur notre cloud, avec le modèle en taille réelle, tel que publié. Nous avons envoyé les cinq mêmes prompts avec et sans la tête : la question "trouve le bug" de JetBrains, une tâche de code, un problème de maths, une explication et un appel d'outil. Puis nous avons contourné notre plateforme pour mesurer sur le serveur lui-même, une requête et huit à la fois, avec une, deux et trois propositions par étape. Une seconde machine, une vraie RTX 5080 de 16 GB, a montré jusqu'où on peut descendre en GPU.
Les limites, une fois pour toutes : nos prompts, pas les tests des auteurs, et aucun document assez long pour remplir toute la longueur de conversation du modèle, 131 072 tokens. Chaque réglage n'a tourné qu'une fois, sur des réponses courtes : considérez les petits écarts comme du bruit. Nous avons testé jusqu'à huit requêtes à la fois, pas plus. vLLM fait tourner Mellum avec du code générique, pas du code écrit pour ce modèle, et une version native pourrait changer ces chiffres. Les résultats à 32 GB et 24 GB viennent d'une limite imposée à la mémoire de l'A6000, pas de vrais GPU de cette taille.
Une requête : 1,11x avec le réglage de JetBrains, 1,31x avec deux propositions
Avec le réglage de JetBrains, une proposition par étape, une seule requête est passée de 106,8 à 118,9 tokens par seconde sur l'A6000. Cela fait 1,11x, bien en dessous du plancher promis de 1,4x.
Concrètement, une réponse de code d'environ 600 tokens a pris 5,9 secondes sans la tête et 4,9 secondes avec, via notre endpoint. Vous gagnez une seconde sur une longue réponse. Vous ne le sentirez pas dans une fenêtre de chat, et un agent qui fait cinquante appels de ce genre gagne moins d'une minute.
Le problème ne venait pas des propositions. Les compteurs de vLLM lui-même indiquent que 87,2 % ont été acceptées, près des 90 % de JetBrains. Le modèle devine bien, et la vérification mange l'essentiel du gain. Notre meilleure explication, non mesurée : vLLM n'a pas encore de code optimisé pour Mellum. Et un modèle aussi léger par mot est si rapide que vérifier coûte à peu près autant que ce que cela fait gagner.
Deux propositions par étape ont fait mieux : 140,2 tokens par seconde, 1,31x. Seules deux sur trois ont été acceptées (66,6 %), mais chaque réussite économisait deux étapes. Trois propositions : environ la moitié acceptées (48,6 %), 124,8 tokens par seconde. Deux propositions l'ont emporté pour une requête. La documentation de vLLM conseille de commencer avec une proposition. Essayez une et deux sur votre propre trafic.
Huit requêtes à la fois : 1,45x, dans la fourchette de JetBrains
Avec huit requêtes à la fois sur l'A6000, le même travail s'est terminé en environ deux tiers du temps : 607,3 tokens par seconde contre 418,4, soit 1,45x, mesuré directement sur le serveur vLLM ; via notre endpoint, vous obtenez aujourd'hui le 1,11x d'une seule requête. C'est l'inverse du schéma habituel, où le décodage spéculatif gagne moins à mesure que les requêtes s'accumulent ; nous ne l'avons mesuré qu'une fois et ne savons pas l'expliquer.
Avec une, deux et trois propositions, huit requêtes à la fois ont donné entre 1,39x et 1,66x : n'importe lequel de ces réglages est rentable. Il n'y a pas eu de gagnant constant entre deux et trois propositions.
La tête coûte moins d'un gigaoctet de poids, payé en place pour les conversations
La tête ajoute moins d'un gigaoctet (0,80 GiB) sur l'A6000. vLLM garde fixe l'utilisation totale de la mémoire du GPU, donc le coût apparaît ailleurs.
Le serveur tient un bloc-notes de chaque conversation en cours, pour ne pas la relire à chaque mot. Toute la mémoire que le modèle n'utilise pas va à ce bloc-notes. Avec la tête activée, le bloc-notes de l'A6000 est passé de 1 122 580 tokens à 1 027 634, environ 8,5 % de moins. Cela tient encore presque huit conversations à la longueur maximale du modèle, 131 072 tokens. Sur un GPU de 48 GB, la tête est presque gratuite.
Sur un GPU de 16 GB, elle ne l'est pas. Sur la RTX 5080 de la section suivante, le bloc-notes est passé de 52 400 tokens à 29 019 : la place pour trois conversations complètes de 16 384 tokens est tombée à une. C'est le chiffre à peser avant d'activer la tête sur un petit GPU.
Quel GPU : 16 GB ont suffi, sur une vraie RTX 5080 avec des poids en 8 bits
Le plus petit GPU qui a fonctionné est une vraie RTX 5080 de 16 GB. Nous avons fait charger à vLLM une copie compressée, moitié moins lourde que la version publiée (8 bits), avec des conversations jusqu'à 16 384 tokens. Elle a écrit 217,2 tokens par seconde sans la tête, 288,7 avec une proposition (1,33x) et 291,2 avec deux. Elle a utilisé 97 % de sa mémoire au pic et a donné toutes les bonnes réponses. C'est mieux que l'A6000 en taille réelle. Raisons probables, non mesurées : c'est un GPU plus récent, et des poids plus petits veulent dire moins de données à lire par mot.
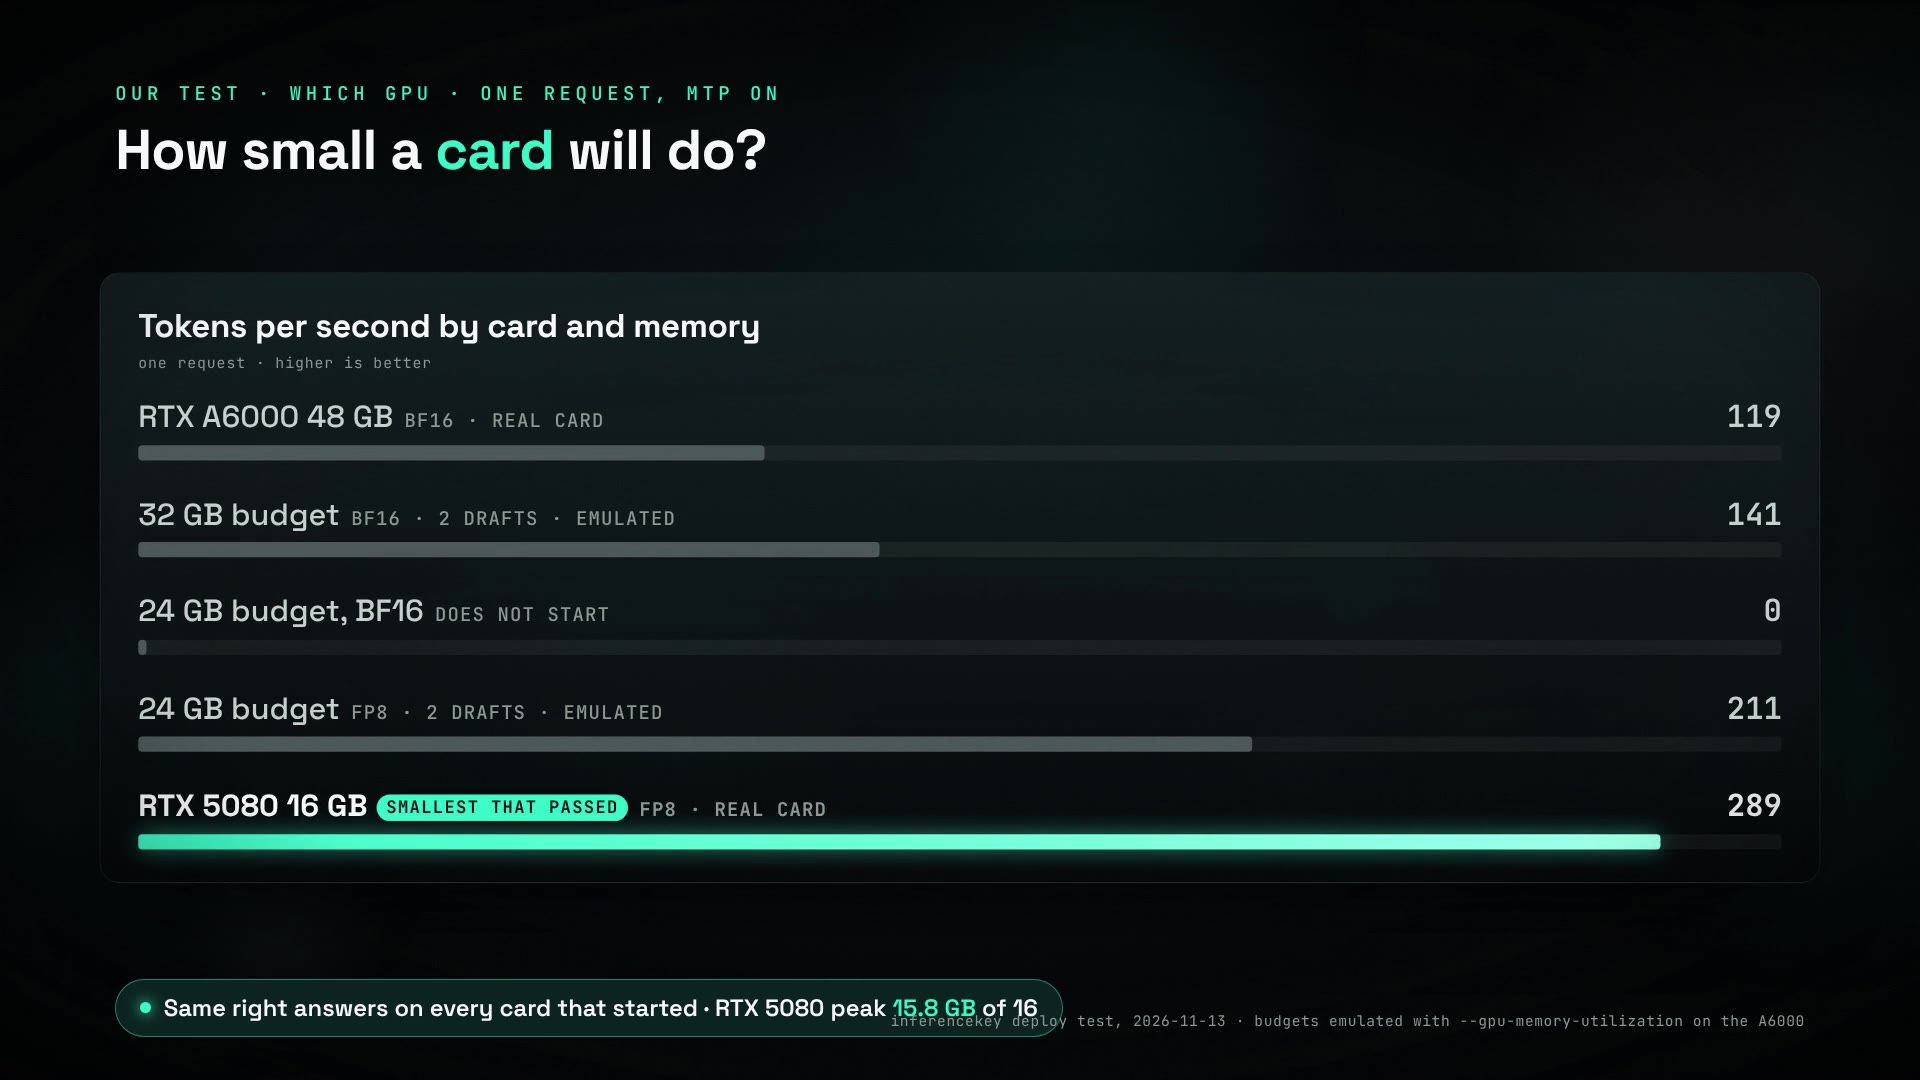
Vous n'avez pas besoin de 48 GB ; c'était juste notre GPU de test principal. En taille réelle, la limite de 24 GB n'a pas démarré : les poids seuls prennent 23,47 GiB et ne laissent aucune place pour le bloc-notes.
Les mêmes réponses en qualité, pas octet pour octet
Chaque essai a donné de bonnes réponses, avec la tête et sans. Le modèle a trouvé le bug de l'exemple de JetBrains à chaque fois. Sa fonction de fusion d'intervalles a passé nos quatre vérifications dans les 13 sorties testées. Il a répondu 400 au problème de maths à chaque essai. Ses appels d'outils sont revenus bien formés.
"Output is unchanged" ne s'est pas vérifié octet pour octet. Avec le modèle réglé pour toujours choisir le mot le plus probable, deux essais du même prompt sur le même serveur ont donné des réponses de 369 et 810 tokens. C'est arrivé aussi sans la tête (380 et 829). La documentation de vLLM le dit : les arrondis du GPU, et le nombre de requêtes traitées ensemble, peuvent changer les mots exacts. Si vos tests comparent la sortie du modèle octet pour octet, ils casseront avec ou sans la tête. Comparez plutôt le résultat.
Sur InferenceKey : un réglage active la tête, et un GPU à froid était prêt en 8 minutes
Un réglage de l'exemple du SDK active ou désactive la tête, et le serveur redémarre en 101 secondes. Une machine à froid a mis 488,9 secondes, environ 8 minutes, entre notre demande et le moment où elle était prête à répondre. Environ quatre de ces minutes sont allées à l'installation de vLLM 0.33 et trois au préchauffage du moteur de vLLM.
Nous avons choisi vLLM 0.33.0 dans notre configuration standard et lancé la commande de JetBrains comme dans notre test. Rien n'a eu besoin d'être compilé ni corrigé. La RTX 5080 a pris 20 minutes, surtout à cause de téléchargements de paquets lents sur cette machine.
Le problème que vous rencontrerez : notre plateforme passe une seule requête à la fois à chaque modèle. Huit requêtes via notre endpoint font la queue, donc le gain de 1,45x ci-dessus a été mesuré sur le serveur lui-même, pas via la plateforme. Via notre endpoint, vous obtenez aujourd'hui le gain d'une seule requête. Statut : ouvert de notre côté.
Cet essai a utilisé une copie locale de la plateforme avec le même worker, pas le service hébergé.
Faut-il l'activer ? Oui sur un GPU partagé, et testez deux propositions
- Un GPU partagé par une équipe ou par plusieurs agents : activez-la ; via InferenceKey, vous verrez le gain quand le worker enverra des requêtes en parallèle (ouvert de notre côté).
- Un développeur, une requête à la fois : réglez deux propositions par étape et mesurez.
- Un GPU de 16 GB : utilisez des poids en 8 bits et attendez-vous à moins de place pour les conversations en parallèle. Prouvé sur une RTX 5080 récente ; des GPU de 16 GB plus anciens peuvent échouer au chargement.
- Un GPU de 24 GB : les poids en 8 bits ont fonctionné sous une limite émulée de 24 GB.
- Des tests qui comparent la sortie octet pour octet : comparez les résultats, pas les octets.
Pour activer et désactiver la tête sur votre propre GPU, lancez python main.py puis MELLUM_MTP=0 python main.py depuis l'exemple du SDK Mellum2.1 MTP. Il faut un worker NVIDIA privé de 48 GB (32 GB n'ont passé que sous une limite émulée), ou de 16 GB avec MELLUM_FP8=1 MELLUM_CONTEXT=16384, plus un token SDK et une clé d'API. Via notre endpoint, il montre le gain d'une seule requête, et il supprime le déploiement quand il a fini.
Pour les ingénieurs
Crédits
- JetBrains : le modèle, entraîné avec sa tête MTP, sous Apache-2.0 ; le dépôt MTP avec la tête dans
model-mtp.safetensors, la version Thinking de base, le dépôt GGUF avec les fichiers de proposition MTP, les recettes de service, le prompt du Quickstart que nous avons lancé et le tableau de benchmarks. - Le projet vLLM : le décodage spéculatif MTP (
--speculative-config '{"method": "mtp", ...}'), les métriques de spec-decode dont nous avons tiré l'acceptation, la quantification FP8 en ligne, et le backend de modélisation Transformers qui sert Mellum et sa tête de proposition dans la 0.33.0 (TransformersMoEForCausalLM,TransformersMoEForMTP). - Hugging Face Transformers : le code de modélisation que le backend exécute ; la 5.20 est la première version qui charge la tête au lieu de l'ignorer.
- pmttyji sur r/LocalLLaMA : là où nous l'avons repéré (post du 2026-11-02).
- Notre part : le déploiement via la plateforme, les essais sans tête contre MTP sur le même GPU, le balayage à 1/2/3 tokens et en concurrence, le bilan mémoire de la tête, l'échelle de VRAM sur deux vrais GPU plus des limites émulées, l'exemple du SDK et la vidéo de démo.
Modèle et fichiers
JetBrains/Mellum2.1-12B-A2.5B-Thinking-MTP: shad55846102dd1c047e95d4841070f88290227c3b7, créé le 2026-10-30T17:20:32Z, modifié pour la dernière fois le 2026-10-30T18:12:02Z, sans accès restreint, Apache-2.0, 17 likes et 1 302 téléchargements au 2026-11-13. Cinq shards BF16 de 24,30 GB plusmodel-mtp.safetensorsde 856 767 160 octets, 25,17 GB en tout.- Base
JetBrains/Mellum2.1-12B-A2.5B-Thinking: sha92ddae9f, créé le 2026-09-20, modifié pour la dernière fois le 2026-10-07. Sa fiche annonçait les builds GGUF et la tête MTP comme "coming soon". - Dépôt GGUF : sha
4159d684, modifié pour la dernière fois le 2026-10-22, BF16, MXFP4_MOE, Q4_K_M, Q6_K et Q8_0 plus des GGUF de propositionmtp/dans les mêmes quantifications. Non testé. - Architecture : 12B au total, 2,5B actifs, 28 couches (21 en fenêtre glissante de 1 024 et 7 en attention complète), hidden 2304, 64 experts dont 8 actifs, GQA 32 têtes Q / 4 têtes KV, head_dim 128, vocabulaire de 98 304, contexte de 131 072 (YaRN facteur 16 sur les couches d'attention complète),
num_nextn_predict_layers: 1. Modèle de baseJetBrains/Mellum2-12B-A2.5B-Base. - Prérequis de la fiche : vLLM 0.33 ou plus récent avec transformers 5.20 ou plus récent. "vLLM releases up to 0.32 refuse the checkpoint" ; transformers avant la 5.20 ignore les tenseurs de la tête avec un avertissement. Autres voies sur la fiche, non testées :
use_mtp=Truedansgeneratede transformers, et llama.cpp avec--spec-type draft-mtp --spec-draft-n-max 1. - Échantillonnage du Quickstart de la fiche : temperature 0.6, top_p 0.95, top_k 20, max_tokens 81920.
- La fiche n'indique ni le GPU, ni la taille de batch, ni la précision derrière sa fourchette de 1,4 à 1,8x.
Benchmarks des auteurs (non reproduits)
| Benchmark | Mellum2.1 | Mellum2 Thinking | Gemma 4 E4B | Qwen3.5 9B |
|---|---|---|---|---|
| LiveCodeBench v6 | 82,0 | 69,4 | 69,4 | 75,4 |
| SWE-bench Verified | 47,0 | 2,0 | 23,0 | 50,0 |
| SWE-bench Pro | 28,0 | 0,0 | 4,0 | 38,0 |
| Terminal-Bench 2.1 | 17,4 | 0,6 | 3,4 | 21,7 |
| AIME 25/26 | 83,3 | 60,1 | 45,0 | 86,7 |
| GPQA Diamond | 64,6 | 51,0 | 53,1 | 77,8 |
| BFCL v4 | 62,3 | 49,6 | 52,5 | 58,5 |
Aussi sur la fiche pour Mellum2.1 : HumanEval+ 91,5, MBPP+ 79,4, IFEval 90,6, HarmBench 8,5 (plus bas, c'est mieux). Les essais agentiques ont utilisé le harnais Pi v0.73.1.
Configuration
- GPU sur InferenceKey Cloud : RTX A6000 48 GB (46 068 MiB, compute capability 8.6, driver 595.91.07) pour les essais principaux, sans tête et MTP, en BF16 ; RTX 5080 16 GB (16 303 MiB, compute capability 12.0, driver 580.178.04) pour l'échelon réel de petite carte, en FP8. Aucune RTX A4000 (Ampere, 16 GB) n'était disponible, donc le FP8 sur une vraie carte Ampere de 16 GB n'est pas testé.
- Backend : le backend intégré
vllmavecvllm_version="0.33.0"dans la spec du workload, qui installe torch 2.14.0 et transformers 5.20.x. vLLM 0.33.0 associeMellumForCausalLMau backend de modélisation Transformers ; il n'existe pas encore d'implémentation native de Mellum dans vLLM. Pourquoi vLLM : c'est la recette principale de la fiche. - Un manager InferenceKey local, que les workers joignent par des tunnels. La production n'a jamais été touchée. Poids pré-téléchargés sur le disque du conteneur de chaque worker (36 s sur l'A6000).
- Mesures : un balayage par réglage, sans répétition ; cinq prompts x 2 via l'endpoint (greedy, en streaming) ; balayages de concurrence et de profondeur de proposition en direct sur vLLM sur le worker après préchauffage ; acceptation tirée des compteurs
vllm:spec_decode_*; VRAM d'aprèsnvidia-smiéchantillonné chaque seconde.
Pas à pas avec l'exemple du SDK
- Clonez inferencekey-sdk et ouvrez
examples/mellum21-12b-a2-5b-mtp-vllm-private-nvidia(commit0a5188e70d0c32c95c9e36a17dcb75078102e48f). cp .env.example .envet renseignez le token SDK (ik_sdk_, lecture et écriture des workloads), une clé d'APIik_live_qui autorise le workload, le projet etIK_WORKER_ID: un worker NVIDIA privé avec un driver CUDA 13 (580 ou plus récent), 32 GB pour le BF16 ou 16 GB avec le FP8.pip install -r requirements.txtplus le build local du SDK avec maturin (le SDK n'est pas sur PyPI).python main.py. Il fait unensure()d'un workloadvllmfixe (slugmellum21-thinking,vllm_version="0.33.0") sur votre worker, attend jusqu'à 2 400 s, pose la question du Quickstart de la fiche avecgenerate_text(), diffuse en streaming une tâchemerge_intervalsavec le délai jusqu'au premier token et les tokens par seconde, lance une boucle d'agentget_weatherde 4 tours au plus, écritoutputs/answers-<mtp|plain>.json, et appelledelete()sauf siIK_KEEP_ALIVE=1.- Variantes :
MELLUM_MTP=0 python main.pypour le modèle sans tête ;MELLUM_FP8=1 MELLUM_CONTEXT=16384 MELLUM_SPEC_TOKENS=2 python main.pypour une carte de 16 GB. Autres réglages :MELLUM_SPEC_TOKENS(1 par défaut, celui de la fiche),MELLUM_CONTEXT(131072),MELLUM_GPU_UTIL(0.90).
La commande que le backend exécute (MTP activé, réglage de la fiche) :
vllm serve JetBrains/Mellum2.1-12B-A2.5B-Thinking-MTP \
  --max-model-len 131072 --gpu-memory-utilization 0.90 --max-num-seqs 16 \
  --reasoning-parser qwen3 \
  --enable-auto-tool-choice --tool-call-parser hermes \
  --speculative-config '{"method": "mtp", "num_speculative_tokens": 1}'
Pour le modèle sans tête, retirez --speculative-config. Pour l'échelon RTX 5080, ajoutez --quantization fp8, réglez --max-model-len 16384 et num_speculative_tokens à 1 ou 2. L'exemple n'envoie que temperature et top_p ; un commentaire du code dit que le top_k=20 de la fiche ne peut pas passer par l'endpoint (non vérifié dans le code du manager).
Durées
| Étape | Durée |
|---|---|
A6000 à froid, de ensure() à prêt | 488,9 s |
| dont installation de vLLM 0.33.0 | environ 4 min |
| pré-téléchargement des poids | 36 s |
| chargement des poids (23,47 GiB) | 12,3 s |
| torch.compile | 35,5 s |
| initialisation du moteur (profilage, cache KV, préchauffage) | 179,65 s |
| redémarrage de l'A6000 avec MTP désactivé | 101,2 s (initialisation du moteur 47,2 s) |
| Échelons en direct, caches chauds | 66 à 126 s |
RTX 5080, de ensure() à prêt | 1 207,1 s (environ 14 min de téléchargements pip à quelques centaines de kB/s sur cette machine ; chargement 19,7 s ; initialisation du moteur 260,0 s) |
Délai jusqu'au premier token via l'endpoint : 0,23 à 0,29 s dans tous les cas.
Vitesse via l'endpoint (A6000, BF16, greedy, streaming)
| Prompt | Sans tête : tokens / s / tok/s | MTP 1 proposition : tokens / s / tok/s |
|---|---|---|
| Bug du Quickstart de la fiche (x2) | 381 / 3,69 / 110,2 | 372 / 3,24 / 123,5 |
merge_intervals (x2) | 619 / 5,91 / 109,1 | 603 / 4,90 / 129,6 |
| n^2+1 divisible par 5, n <= 1000 | 380 et 829 / 3,74 et 7,90 / 110,3 et 108,2 | 369 et 810 / 3,16 et 6,77 / 127,0 et 124,3 |
| Explication de la table de hachage | 792 et 881 / 7,55 et 8,45 / 108,3 et 107,6 | 940 et 718 / 8,06 et 6,19 / 120,4 et 120,7 |
| Lisbonne ou Oslo (outils) | 280 / 2,78 / 109,7, deux appels en parallèle | 244 / 2,16 / 126,7, Lisbonne seulement |
Acceptation pendant ce banc d'essai sur le workload MTP : 3365/3767 = 89,3 %.
Vitesse en direct sur vLLM (à chaud)
| A6000, BF16, contexte 131 072, util 0.90 | 1 req greedy | 1 req échantillonnage de la fiche | 8 à la fois greedy | 8 à la fois échantillonnage de la fiche | Acceptées |
|---|---|---|---|---|---|
| Sans tête | 106,8 | 105,7 | 418,4 | 316,4 | |
| MTP, 1 proposition (fiche) | 118,9 (1,11x) | 118,6 (1,12x) | 607,3 (1,45x) | 462,1 (1,46x) | 87,2 % (8396/9623) |
| MTP, 2 propositions | 140,2 (1,31x) | 138,9 (1,31x) | 581,8 (1,39x) | 525,9 (1,66x) | 66,6 % (9931/14906) |
| MTP, 3 propositions | 124,8 (1,17x) | 125,5 (1,19x) | 663,5 (1,59x) | 478,5 (1,51x) | 48,6 % (10070/20709) |
| RTX 5080, FP8, contexte 16 384, util 0.90 | 1 req greedy | 1 req échantillonnage de la fiche | 8 à la fois greedy | 8 à la fois échantillonnage de la fiche | Acceptées |
|---|---|---|---|---|---|
| Sans tête | 217,2 | 212,4 | 896,7 | 468,1 (non comparable : 3 sur 8 ont tourné 64 s, 30 205 tokens, sur un KV de 52 400 tokens) | |
| MTP, 1 proposition | 288,7 (1,33x) | 279,7 (1,32x) | 1 276,5 (1,42x) | 966,1 | 87,7 % (10443/11913) |
| MTP, 2 propositions | 291,2 (1,34x) | 283,9 | 1 297,4 (1,45x) | 1 212,0 | 68,6 % (14209/20726, tout le trafic) |
Via l'endpoint sur la RTX 5080 avec MTP 2 : 298 à 344 tok/s.
À huit à la fois, trois propositions sont arrivées en tête avec le décodage greedy, et deux avec l'échantillonnage de la fiche ; un seul essai pour chacun.
Ce que la tête MTP coûte en mémoire
| Carte, précision | Poids sans tête / MTP | Cache KV sans tête | Cache KV MTP 1 | Pic sans tête / MTP |
|---|---|---|---|---|
| RTX A6000, BF16, util 0.90 | 22,67 / 23,47 GiB (+0,80) | 16,75 GiB = 1 122 580 tokens | 15,87 GiB = 1 027 634 tokens (-8,5 %) ; 16,0 GiB = 1 036 154 sur l'échelon en direct | 41 017 / 41 147 MiB |
| RTX 5080, FP8, util 0.90, contexte 16 384 | 11,74 / 12,14 GiB (+0,40) | 1,36 GiB = 52 400 tokens | 0,87 GiB = 29 019 tokens (-45 %) ; 25 967 avec MTP 2 | 14 364 / 15 832 MiB |
Le pic est fixé par --gpu-memory-utilization : le coût de la tête se voit donc en KV perdu, pas en pic plus élevé sur l'A6000. L'échantillon le plus haut sur l'A6000 a été de 41 280 MiB, pendant le workload MTP. vLLM a aussi averti Add 6 padding layers, may waste at most 27.27% KV cache memory.
Échelle de VRAM
| GPU ou limite | Config | Pic de VRAM | Vitesse (1 requête) | Sortie correcte | Réel ou émulé |
|---|---|---|---|---|---|
| RTX A6000 48 GB | BF16, 131 072, sans tête | 41 017 MiB | 106,8 tok/s | oui | réel |
| RTX A6000 48 GB | BF16, 131 072, MTP 1 (fiche) | 41 147 MiB | 118,9 tok/s | oui | réel |
| RTX A6000 48 GB | BF16, 131 072, MTP 2 | 41 033 MiB | 140,2 tok/s | oui | réel |
| RTX A6000 48 GB | BF16, 131 072, MTP 3 | 41 049 MiB | 124,8 tok/s | oui | réel |
| Limite de 32 GB (util 0.71) | BF16, 32 768, MTP 2 | 32 391 MiB (KV 7,34 GiB, 337 838 tokens) | 140,6 tok/s | oui | émulé |
| Limite de 24 GB (util 0.52) | BF16, 16 384, MTP 2 | aucun | aucune | non : ValueError: No available memory for the cache blocks (poids BF16 de 23,47 GiB) | émulé |
| Limite de 24 GB (util 0.52) | FP8 en ligne, 32 768, MTP 2 | 23 779 MiB (poids 12,18 GiB, KV 10,08 GiB, 463 944 tokens) | 211,4 tok/s | oui | émulé |
| Limite de 16 GB (util 0.345) | FP8 en ligne, 16 384, MTP 2 | 15 819 MiB en service, pic transitoire de 21 917 MiB au chargement (FP8 Marlin, poids seuls, sur Ampere) | 209,3 tok/s | oui | émulé |
| RTX 5080 16 GB | FP8, 16 384, sans tête | 14 364 MiB | 217,2 tok/s | oui | réel |
| RTX 5080 16 GB | FP8, 16 384, MTP 1 | 15 832 MiB sur 16 303 | 288,7 tok/s | oui | réel |
| RTX 5080 16 GB | FP8, 16 384, MTP 2 (exemple du SDK via l'endpoint) | 15 832 MiB sur 16 303 | 291,2 tok/s en direct ; 303,3 tok/s sur la tâche de code de l'exemple | oui | réel |
Non essayé : 12 GB (les poids FP8 seuls font 12,18 GiB), la voie GGUF et llama.cpp, le FP8 sur une vraie carte de 24 GB (3090/4090), le BF16 sur une vraie carte de 32 GB, plus de 16K de contexte sur 16 GB, un long prompt qui remplit toute la fenêtre de 131 072, use_mtp=True de transformers, et les benchmarks des auteurs. La qualité en FP8 n'a été vérifiée que sur nos cinq prompts.
Vérifications de qualité
- Quickstart de la fiche (
def mean(xs): return sum(xs) / len(xs) - 1) : bug trouvé à chaque essai et à chaque échelon. merge_intervals: 13 sorties vérifiées sur 13 ont passé les 4 asserts.- Maths (n^2+1 divisible par 5, n <= 1000) : 400 à chaque essai.
- Outils : appels valides au format hermes à chaque essai.
- Essais de l'exemple du SDK : A6000 avec MTP, tâche de code de 510 tokens en 4,36 s, 126,1 tok/s, TTFT 0,32 s ; A6000 sans tête, 474 tokens, 109,4 tok/s ; RTX 5080 FP8 MTP 2, 700 tokens en 2,47 s, 303,3 tok/s.
Problèmes restants
- Accélération sur une seule requête en dessous de la fourchette de la fiche, sur l'A6000 en BF16. 1,11x avec un token proposé, alors que 87,2 % sont acceptés. Hypothèse, non prouvée : le backend de modélisation générique Transformers, plus le
Using default MoE config. Performance might be sub-optimal!de vLLM, et une étape de vérification qui coûte presque autant qu'elle fait gagner sur un MoE à 2,5B de paramètres actifs. Deux tokens proposés donnent 1,31x. Ouvert en amont : pas encore d'implémentation native de Mellum dans vLLM. - Un seul job à la fois par workload sur le worker (
max_in_flight slots=1). Les requêtes parallèles via l'endpoint font la queue, donc les chiffres de concurrence ont été mesurés en direct sur vLLM. Ouvert de notre côté. - Sorties greedy non identiques octet pour octet d'un essai à l'autre, avec et sans MTP (MTP : maths 369 contre 810 tokens, table de hachage 940 contre 718 ; sans tête : 380 contre 829, 792 contre 881). Les réponses sont restées justes. Attendu d'après la documentation de vLLM : le décodage spéculatif est sans perte "up to the precision limits of hardware numerics", et la taille de batch peut déplacer les logprobs et les probabilités de sortie.
- Les appels d'outils ont varié d'un essai à l'autre. Sur l'A6000 en BF16 avec MTP, le modèle a appelé les outils une ville par tour (Lisbonne, puis Oslo) ; sans MTP, il a fait deux appels
get_weatheren parallèle, tout comme l'essai 3 sur la RTX 5080 (FP8, MTP 2). Les clients ont besoin d'une boucle d'agent. La première version de notre exemple n'autorisait qu'un tour et renvoyait une réponse finale vide. Corrigé : l'exemple boucle jusqu'à 4 tours. - La première requête échantillonnée après un redémarrage est lente : Triton compile à la volée
_gumbel_sample_kernelet d'autres, 52,4 tok/s puis 105,8. Préchauffez avant de mesurer. - Le FP8 en ligne sur Ampere passe par un pic au chargement : 21 917 MiB pendant environ 3 s sous la limite de 16 GB. Une vraie carte Ampere de 16 GB peut échouer au chargement. La RTX 5080 (FP8 natif) ne l'a pas montré.
- Avertissements de vLLM : padding du KV (
may waste at most 27.27% KV cache memory), config MoE par défaut, etmax_num_scheduled_tokens is set to 2048 based on the speculative decoding settings. - Téléchargements de paquets lents sur la machine de la RTX 5080 : environ 14 de ses 20 minutes jusqu'à prêt.
Vidéo de démo
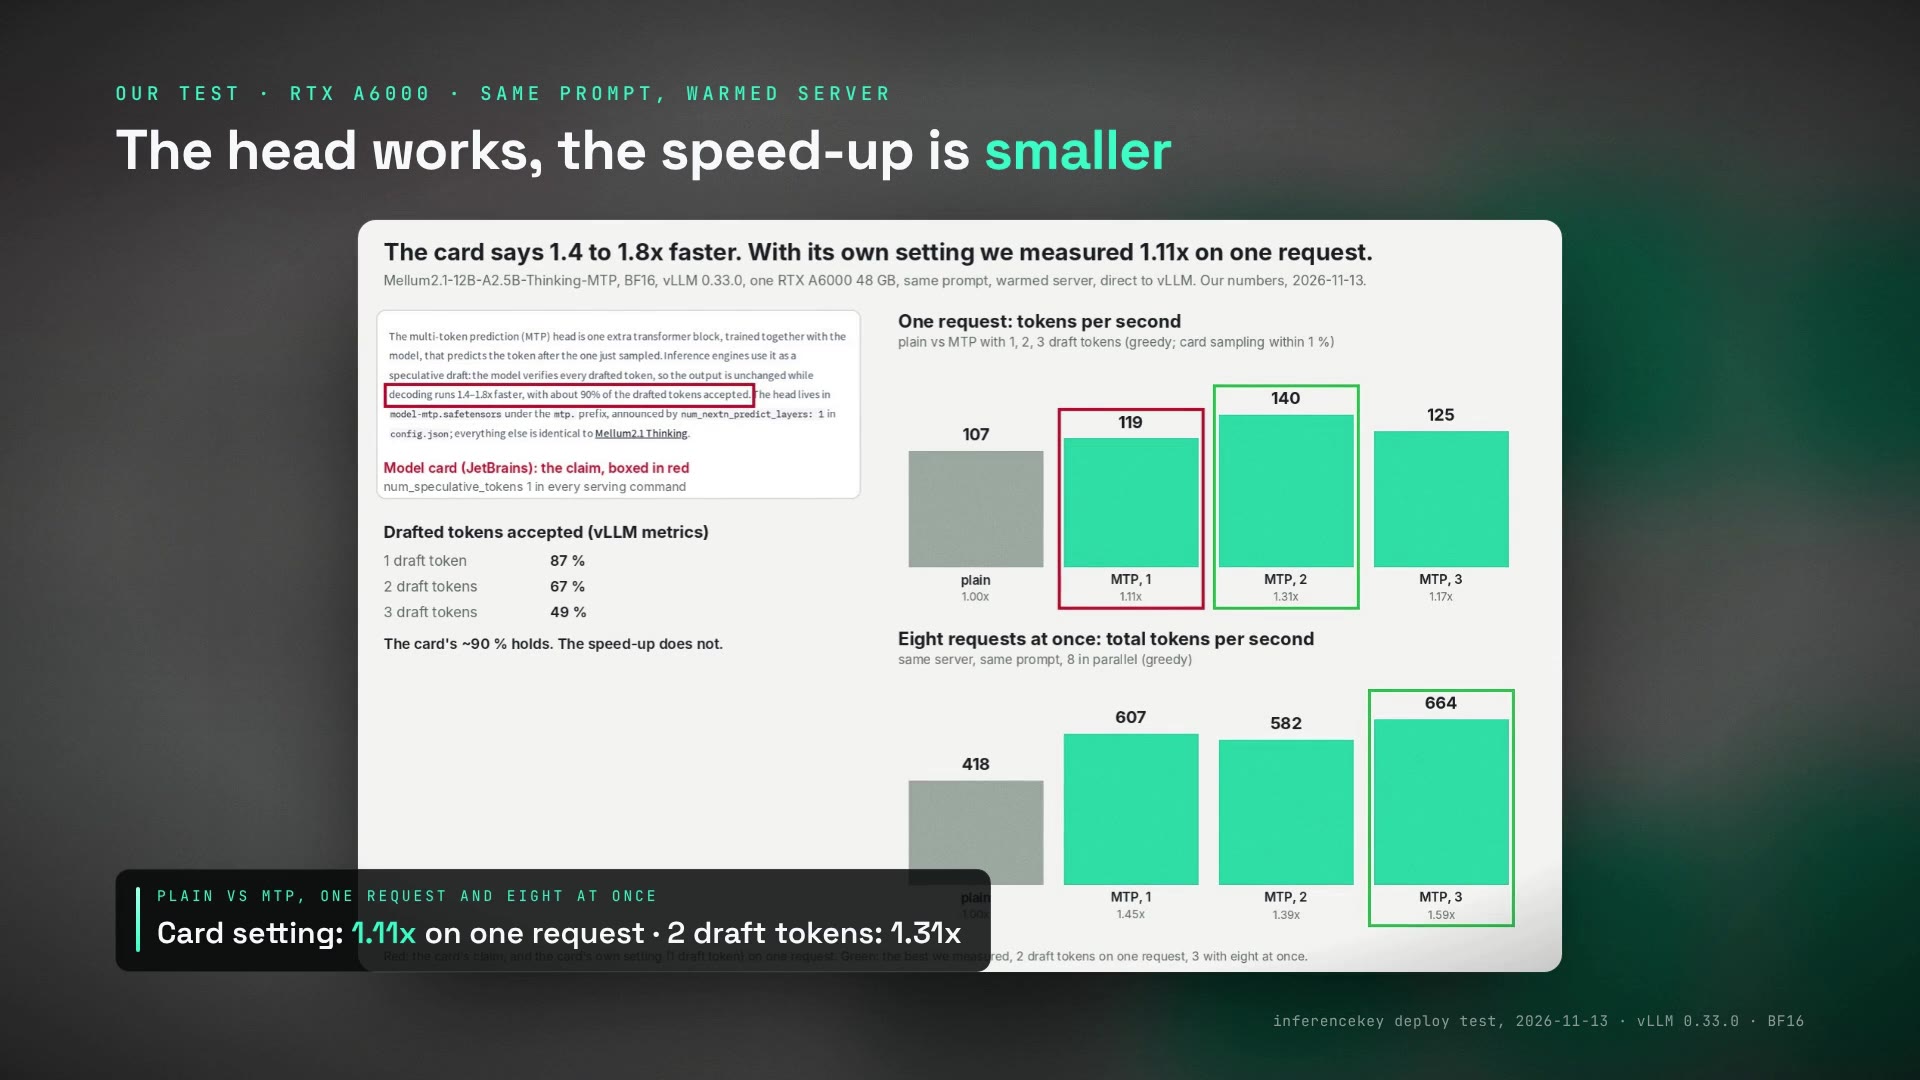
La démo commentée de 165 secondes : ce qu'est Mellum2.1 (la fiche du modèle, le paragraphe sur le MTP, les benchmarks des auteurs, et une comparaison sur Terminal-Bench 2.1 avec GPT-5.6 Sol et Claude Mythos 5, tirée de la copie que BenchLM fait du classement de Vals (récupérée le 2026-11-08, non revérifiée), avec un harnais différent de celui des auteurs), le déploiement dans le panneau sur la RTX A6000 avec la tête activée (une tâche de code à 128 tokens par seconde, 640 tokens en 5,1 s, et la boucle d'outils, Lisbonne puis Oslo, en 4,9 s), la comparaison clé, sans tête contre MTP, et l'échelle de GPU. Sous-titres en anglais inclus.
Sources
- JetBrains/Mellum2.1-12B-A2.5B-Thinking-MTP (fiche du modèle, config, tête MTP).
- JetBrains/Mellum2.1-12B-A2.5B-Thinking (version de base).
- JetBrains/Mellum2.1-12B-A2.5B-Thinking-GGUF (non testé).
- Documentation de vLLM sur le décodage spéculatif, consultée le 2026-11-13 (redirige vers les pages sur le décodage spéculatif et le MTP).
- Post de pmttyji sur r/LocalLLaMA, 2026-11-02 (là où nous l'avons repéré).
- Exemple du SDK, commit
0a5188e70d0c32c95c9e36a17dcb75078102e48f.