La cabeza MTP de Mellum2.1: 1,11x más rápida con una petición, 1,45x con ocho, y el modelo funciona en 8 bits en una RTX 5080 de 16 GB
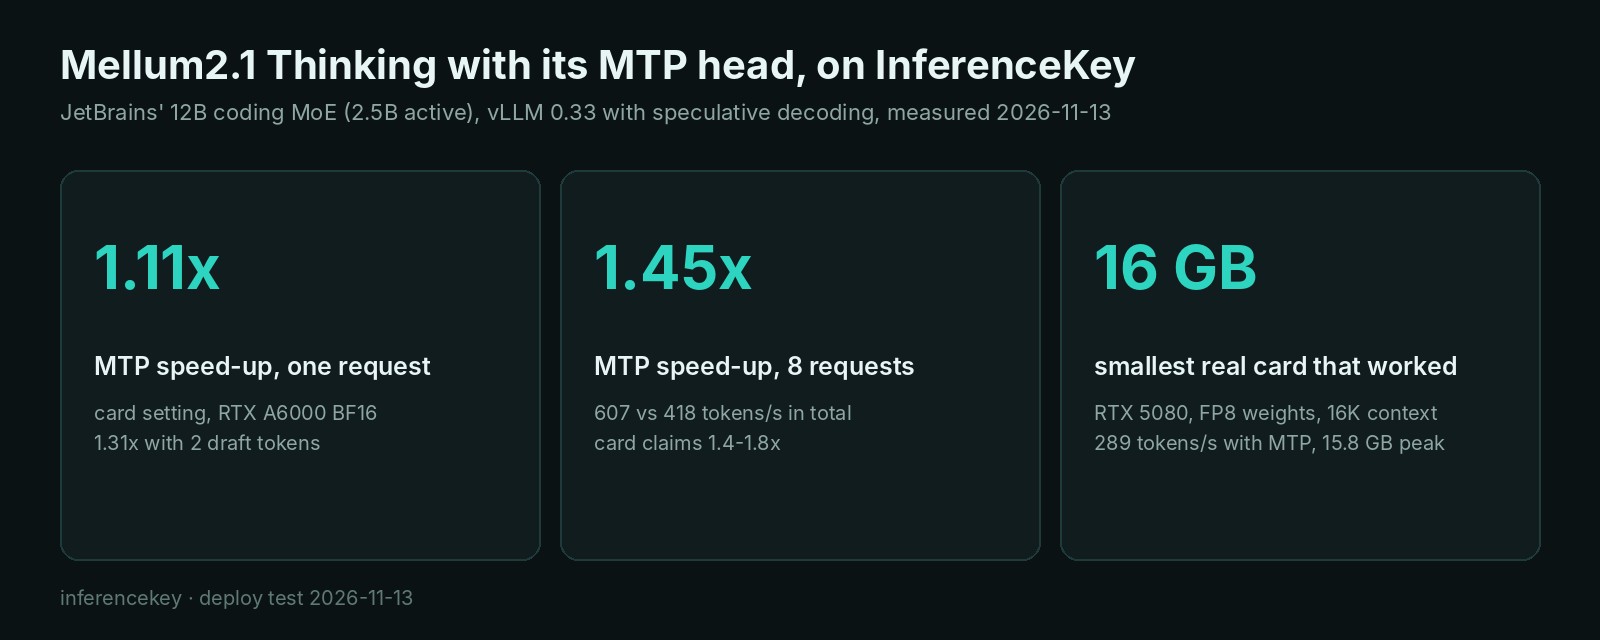
JetBrains promete de 1,4 a 1,8x con la cabeza MTP de Mellum2.1. Medimos 1,11x con una petición, 1,45x con ocho, y lo usamos en 8 bits en una RTX 5080.
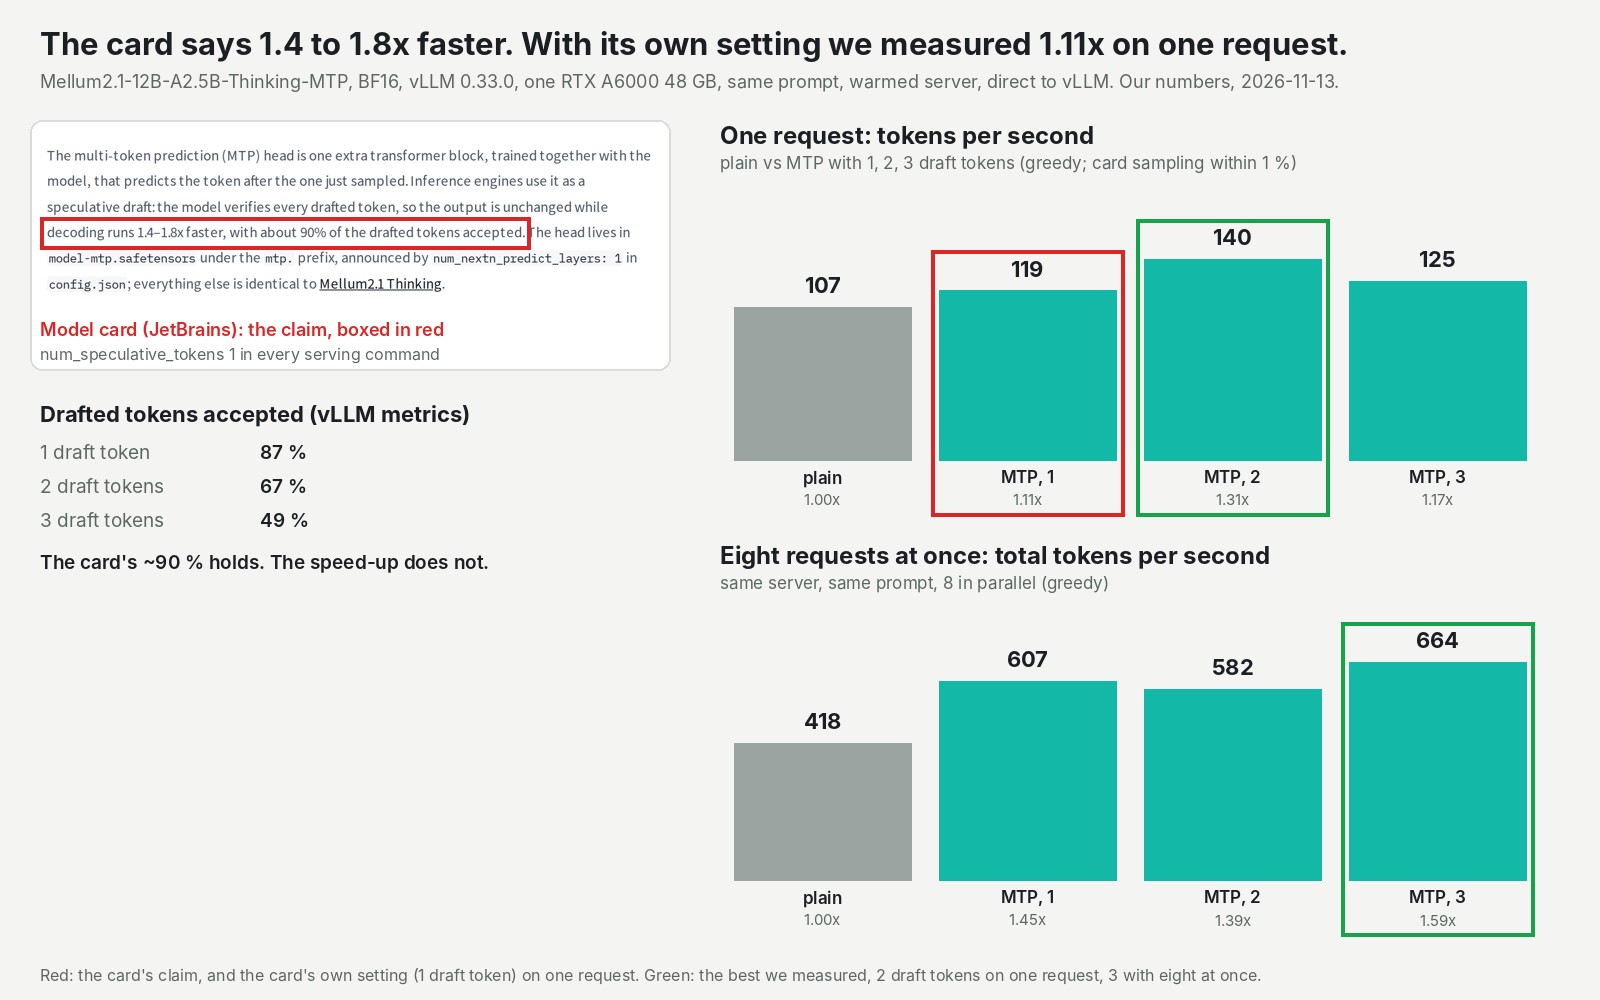
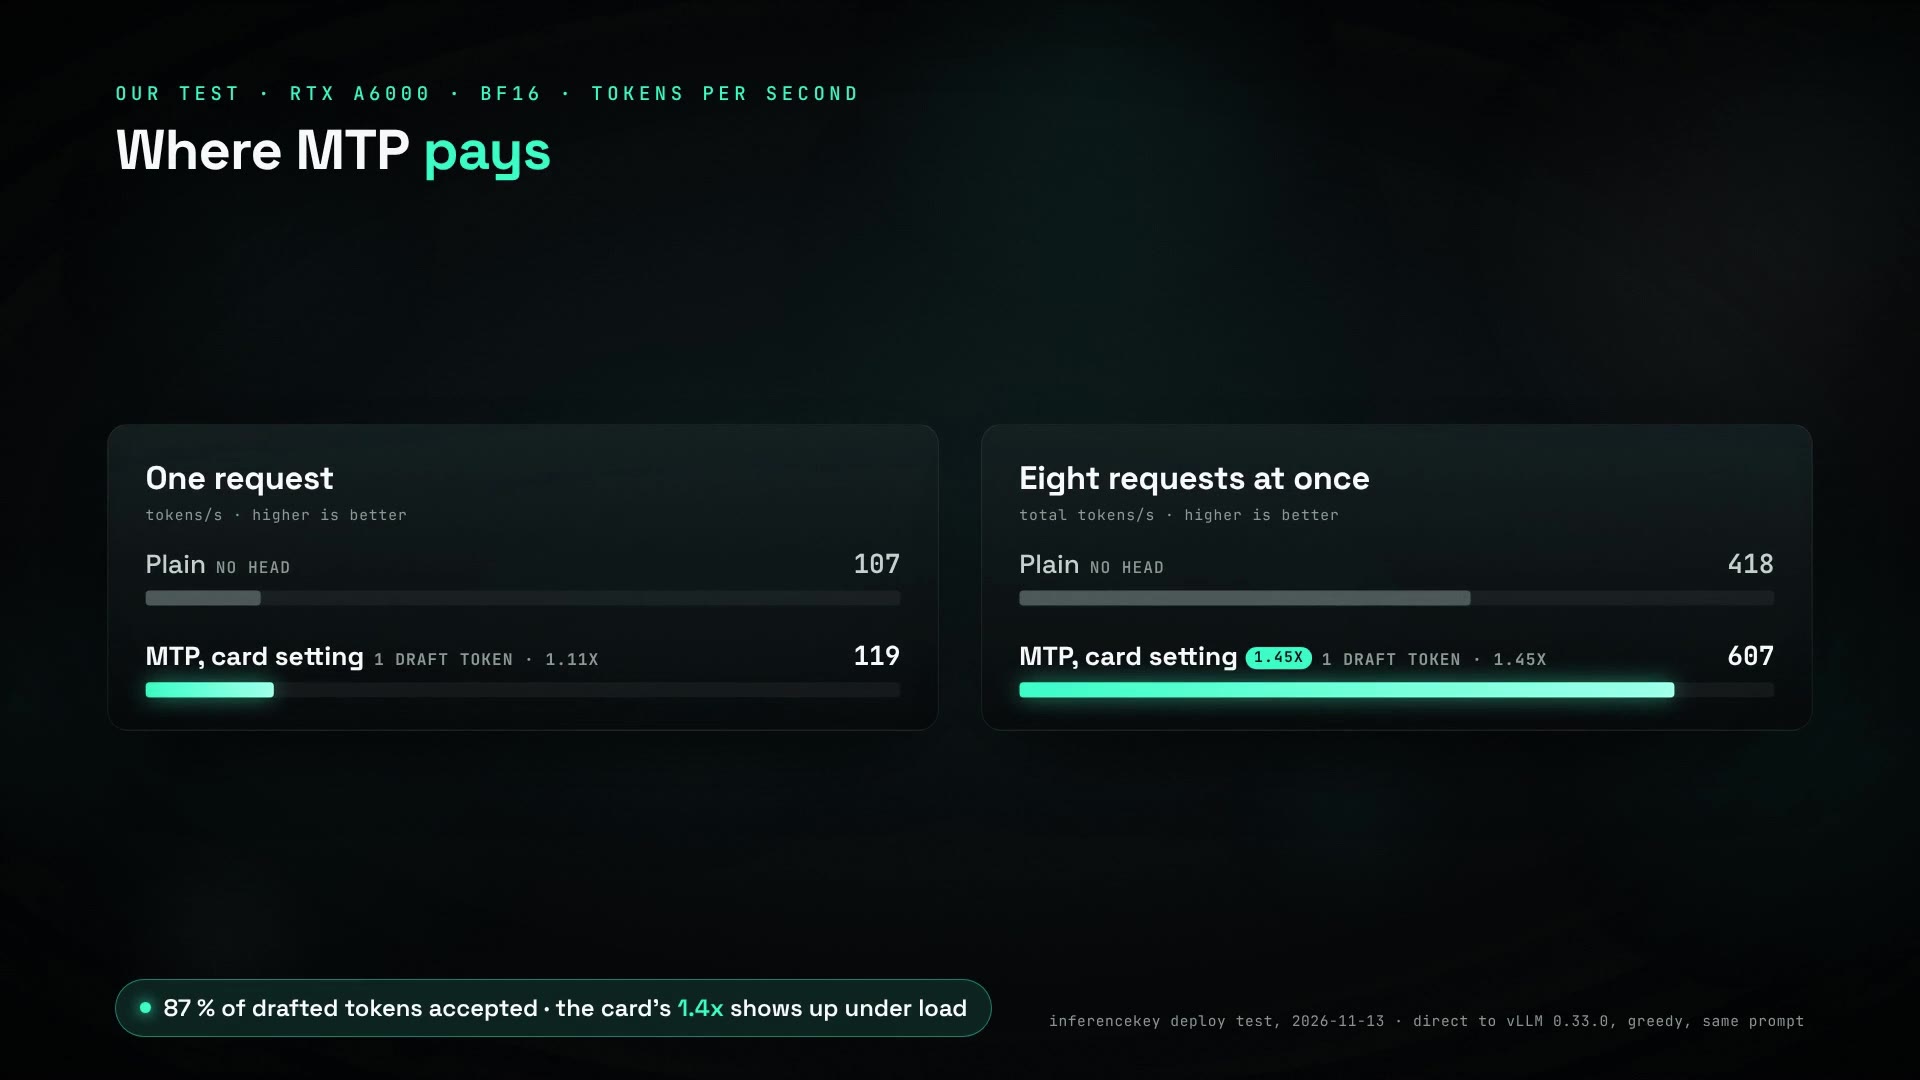
Acertó 87 de cada 100 veces, y aun así el modelo escribió solo un 11% más rápido. Eso medimos al activar el pequeño adivinador que JetBrains incluye con Mellum2.1, su modelo abierto para programar. La página del modelo de JetBrains promete escribir de 1,4 a 1,8 veces más rápido con el mismo resultado. Con el ajuste que recomienda JetBrains, una petición en una RTX A6000 de 48 GB de nuestra nube pasó de 107 a 119 tokens (trozos de palabras) por segundo. Con ocho peticiones a la vez, medido directamente en el servidor vLLM, la mejora fue de 1,45x, dentro del rango de JetBrains; a través de nuestro endpoint hoy obtienes el 1,11x de una petición. Si tienes tus propias GPU, el adivinador rindió mucho más con ocho peticiones a la vez que con una. En una copia comprimida de 8 bits, a la mitad de su tamaño publicado, el modelo también funciona en una RTX 5080 real de 16 GB.
Un bloque extra adivina la siguiente palabra, y el modelo comprueba cada intento
El adivinador es una pequeña parte extra del modelo que adivina la palabra que viene después de la que acaba de escribir. Luego el modelo completo comprueba el intento. Si está de acuerdo, se queda con dos palabras por aproximadamente el precio de un paso. Si no, descarta el intento y sigue. JetBrains llama a esta parte la cabeza (head).
Imagina a un compañero de banda que canta el siguiente acorde justo antes del cambio. Casi siempre el bajista solo asiente y lo toca, en lugar de sacarlo él. Cantarlo sale casi gratis. Asentir sigue costando un tiempo de compás, y ese tiempo decide cuánto ahorra la banda.
Esa es la promesa de la página del modelo de JetBrains. El modelo "verifies every drafted token, so the output is unchanged", mientras escribe de 1,4 a 1,8 veces más rápido, con cerca del 90% de los intentos aceptados. La pega está en la comprobación. También cuesta tiempo, y JetBrains no dice en qué GPU ni con cuántas peticiones midió ese rango.
Mellum2.1 Thinking es el modelo abierto de JetBrains para código y razonamiento. Es un modelo pequeño en el que solo 2.5B de sus 12B parámetros trabajan en cada palabra. JetBrains lo publicó en septiembre y escribió que la cabeza de borrador llegaría "coming soon". La cabeza llegó el 30 de octubre como descarga aparte. JetBrains dice que el modelo en sí no cambia. La cabeza añade un fichero de 0,86 GB y una línea de configuración.
Un flag fue el único cambio, en dos GPU reales y con cinco prompts
Activar la cabeza es un flag más, y fue lo único que cambiamos entre ejecuciones. Servimos el modelo con vLLM 0.33, el software de servicio de código abierto que recomienda JetBrains. Sin el flag, el servidor ignora la cabeza y ejecuta el modelo normal.
La GPU principal fue una RTX A6000 de 48 GB de nuestra nube, con el modelo a tamaño completo, tal como se publicó. Enviamos los mismos cinco prompts con y sin la cabeza: la pregunta de "encuentra el bug" de la propia JetBrains, una tarea de programación, un problema de matemáticas, una explicación y una llamada a una herramienta. Después nos saltamos nuestra plataforma y medimos en el propio servidor, con una petición y con ocho a la vez, con uno, dos y tres intentos por paso. Una segunda máquina, una RTX 5080 real de 16 GB, mostró con qué GPU tan pequeña basta.
Los límites, una sola vez: son nuestros prompts, no las pruebas de los autores, y ningún documento lo bastante largo para llenar la longitud de conversación completa del modelo, 131.072 tokens. Cada ajuste se ejecutó una vez, con respuestas cortas, así que trata las diferencias pequeñas como ruido. Probamos hasta ocho peticiones a la vez, no más. vLLM ejecuta Mellum con código genérico, no con código escrito para este modelo, y una versión nativa podría cambiar estas cifras. Los resultados de 32 GB y 24 GB salen de limitar la memoria de la A6000, no de GPU reales de ese tamaño.
Una petición: 1,11x con el ajuste de JetBrains, 1,31x con dos intentos
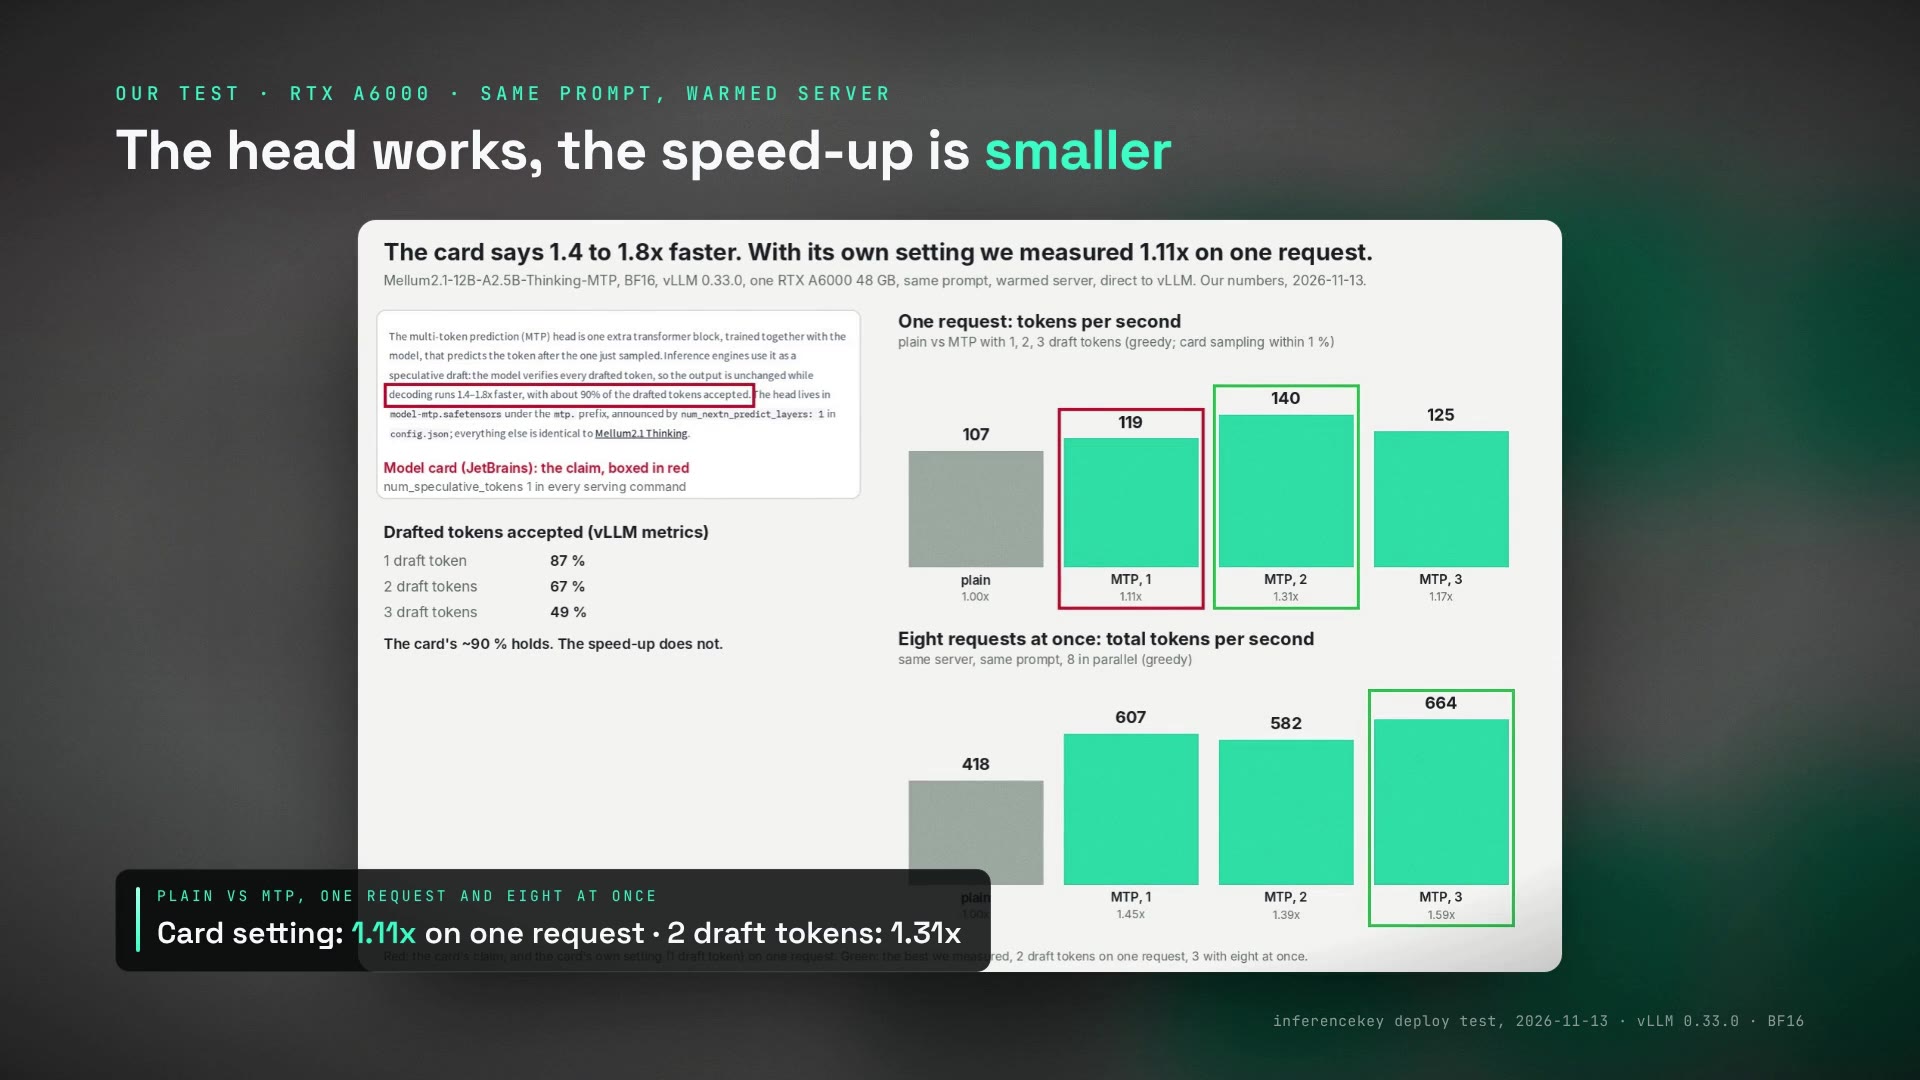
Con el ajuste de JetBrains de un intento por paso, una sola petición pasó de 106,8 a 118,9 tokens por segundo en la A6000. Eso es 1,11x, muy por debajo del suelo prometido de 1,4x.
En la práctica, una respuesta de programación de unos 600 tokens tardó 5,9 segundos sin la cabeza y 4,9 segundos con ella, a través de nuestro endpoint. Ahorras un segundo en una respuesta larga. No lo vas a notar en una ventana de chat, y un agente que haga cincuenta llamadas así ahorra menos de un minuto.
El problema no eran los intentos. Los contadores de vLLM dicen que se aceptó el 87,2%, cerca del 90% de JetBrains. El modelo adivina bien, y la comprobación se come casi toda la ganancia. Nuestra mejor explicación, sin medir: vLLM aún no tiene código optimizado para Mellum. Y un modelo tan ligero por palabra es tan rápido que comprobar cuesta casi lo mismo que lo que ahorra.
Dos intentos por paso fueron mejor: 140,2 tokens por segundo, 1,31x. Solo acertaron dos de cada tres (66,6%), pero cada acierto ahorró dos pasos. Con tres intentos acertó aproximadamente la mitad (48,6%), a 124,8 tokens por segundo. Para una petición ganaron dos intentos. La documentación de vLLM sugiere empezar con un intento. Prueba uno y dos con tu propio tráfico.
Ocho peticiones a la vez: 1,45x, dentro del rango de JetBrains
Con ocho peticiones a la vez en la A6000, el mismo trabajo terminó en unos dos tercios del tiempo: 607,3 tokens por segundo frente a 418,4, 1,45x, medido directamente en el servidor vLLM; a través de nuestro endpoint hoy obtienes el 1,11x de una petición. Va en contra del patrón habitual, en el que la decodificación especulativa gana menos a medida que se acumulan peticiones; lo medimos una vez y no sabemos explicarlo.
Con uno, dos y tres intentos, ocho a la vez quedó entre 1,39x y 1,66x, así que cualquiera sale a cuenta. No hubo un ganador claro entre dos y tres intentos.
La cabeza cuesta menos de un gigabyte de pesos, que se paga en espacio para conversaciones
La cabeza añade menos de un gigabyte (0,80 GiB) en la A6000. vLLM mantiene fijo el uso total de memoria de la GPU, así que el coste aparece en otro sitio.
El servidor guarda una libreta de cada conversación en curso, para no releerla en cada palabra. La memoria que no usa el modelo va a esa libreta. Con la cabeza activada, la libreta de la A6000 bajó de 1.122.580 tokens a 1.027.634, un 8,5% menos. Aun así caben casi ocho conversaciones a la longitud completa del modelo, 131.072 tokens. En una GPU de 48 GB la cabeza sale casi gratis.
En una GPU de 16 GB, no. En la RTX 5080 de la siguiente sección, la libreta pasó de 52.400 tokens a 29.019: el espacio para tres conversaciones completas de 16.384 tokens se quedó en una. Esa es la cifra que hay que sopesar antes de activar la cabeza en una GPU pequeña.
Qué GPU: bastaron 16 GB, en una RTX 5080 real con pesos de 8 bits
La GPU más pequeña que funcionó fue una RTX 5080 real de 16 GB. Hicimos que vLLM cargara una copia comprimida, a la mitad del tamaño publicado (8 bits), con conversaciones de hasta 16.384 tokens. Escribió 217,2 tokens por segundo sin la cabeza, 288,7 con un intento (1,33x) y 291,2 con dos. Usó el 97% de su memoria en el pico y acertó todas las respuestas. Eso supera a la A6000 a tamaño completo. Razones probables, sin medir: es una GPU más nueva, y unos pesos más pequeños implican menos que leer por palabra.
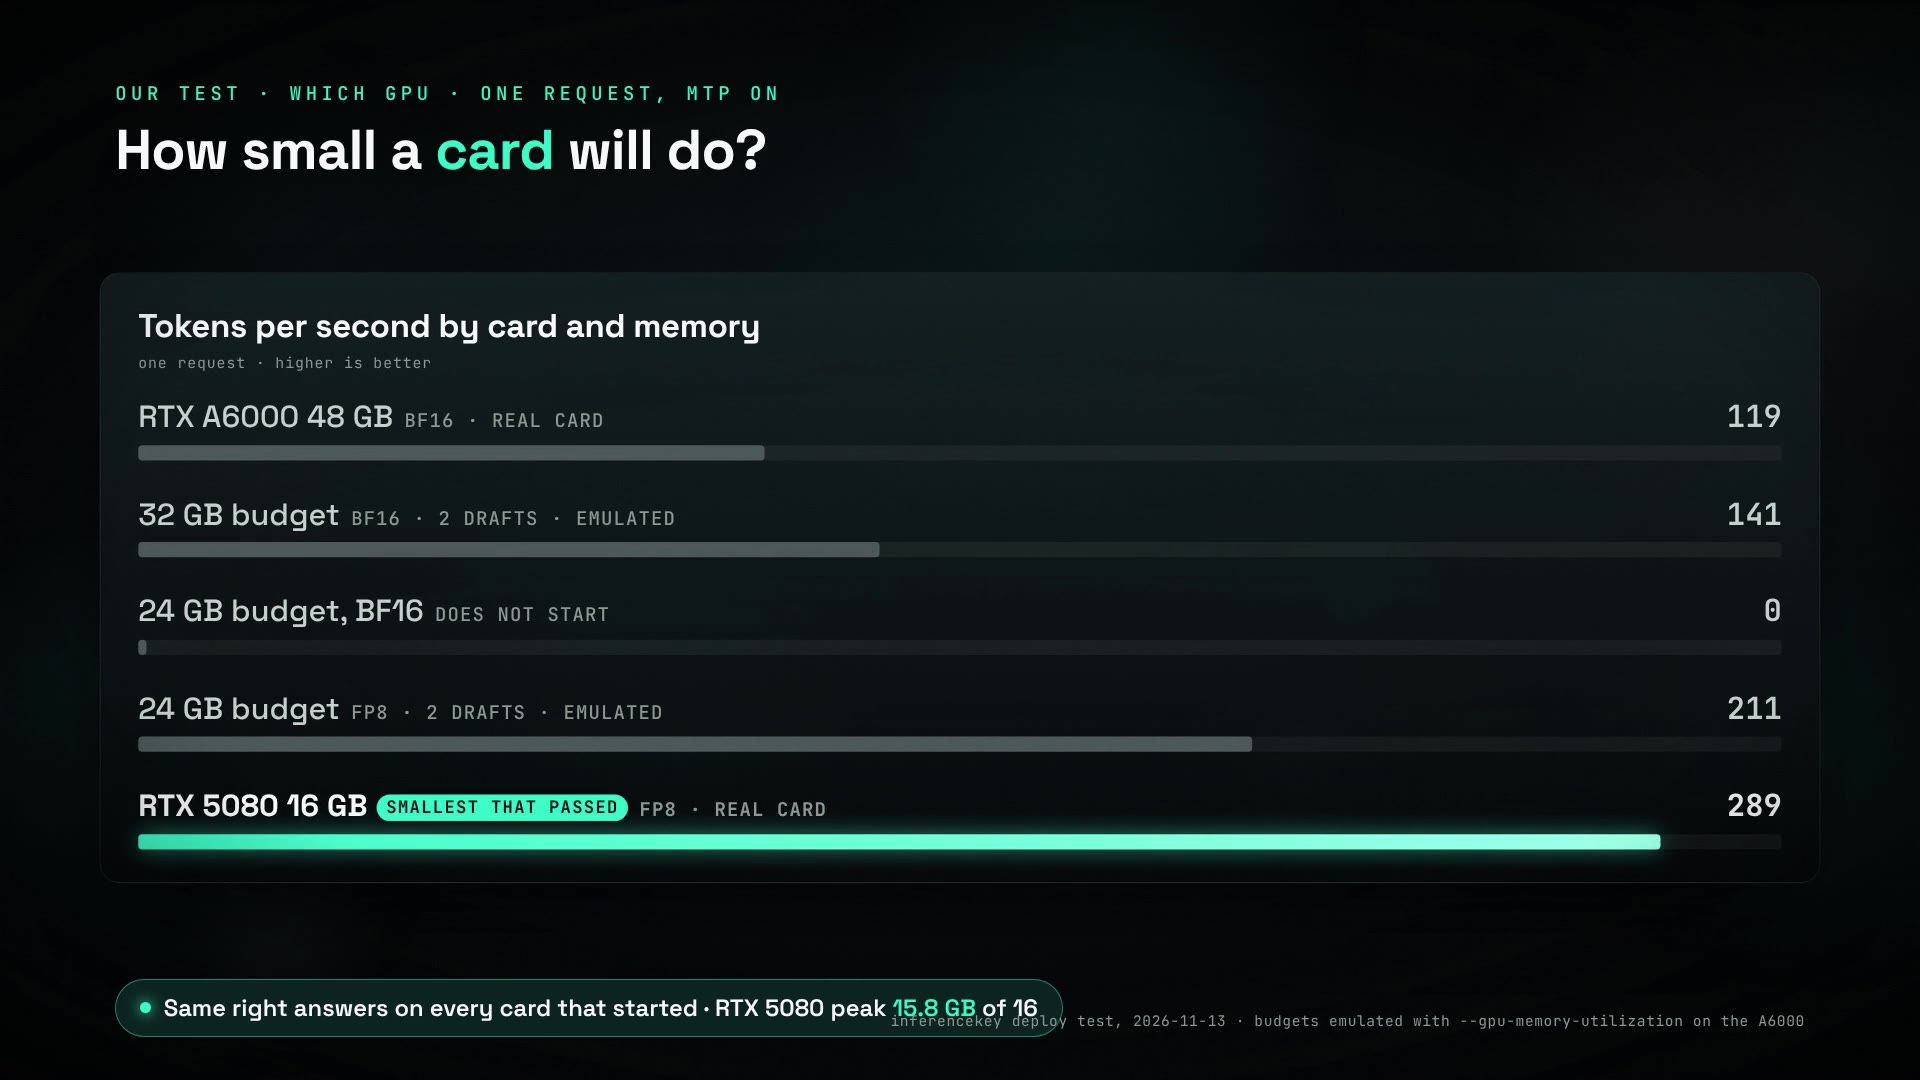
No necesitas 48 GB; esa era solo nuestra GPU principal de pruebas. A tamaño completo, el límite de 24 GB no arrancó: solo los pesos ocupan 23,47 GiB y no dejan sitio para la libreta.
Las mismas respuestas en calidad, no byte a byte
Todas las ejecuciones dieron respuestas correctas, con la cabeza y sin ella. El modelo encontró el bug del ejemplo de JetBrains siempre. Su función para fusionar intervalos pasó nuestras cuatro comprobaciones en las 13 salidas que probamos. Respondió 400 al problema de matemáticas en todas las ejecuciones. Sus llamadas a herramientas salieron bien formadas.
"Output is unchanged" no se cumplió byte a byte. Con el modelo configurado para elegir siempre su palabra más probable, dos ejecuciones del mismo prompt en el mismo servidor dieron respuestas de 369 y 810 tokens. También pasó sin la cabeza (380 y 829). La documentación de vLLM lo avisa: el redondeo de la GPU, y cuántas peticiones se ejecutan juntas, pueden cambiar las palabras exactas. Si tus tests comparan la salida del modelo byte a byte, fallarán con o sin la cabeza. Compara el resultado.
En InferenceKey: un ajuste activa la cabeza, y una GPU en frío estuvo lista en 8 minutos
Un ajuste del ejemplo del SDK activa o desactiva la cabeza, y el servidor se reinicia en 101 segundos. Una máquina en frío tardó 488,9 segundos, unos 8 minutos, desde nuestra petición hasta estar lista para responder. Unos cuatro de esos minutos se fueron en instalar vLLM 0.33 y tres en que vLLM calentara su motor.
Elegimos vLLM 0.33.0 en nuestra configuración estándar y ejecutamos el comando de JetBrains tal como en nuestra prueba. No hubo que compilar ni parchear nada. La RTX 5080 tardó 20 minutos, casi todo en descargas lentas de paquetes en esa máquina.
El problema con el que te vas a encontrar: nuestra plataforma pasa una petición cada vez a cada modelo. Ocho peticiones a través de nuestro endpoint esperan en cola, así que la mejora de 1,45x de arriba se midió en el propio servidor, no a través de la plataforma. A través de nuestro endpoint hoy obtienes la mejora de una petición. Estado: abierto por nuestra parte.
Esta prueba usó una copia local de la plataforma con el mismo worker, no el servicio alojado.
¿Deberías activarla? Sí en una GPU compartida, y prueba dos intentos
- Una GPU compartida por un equipo o por varios agentes: actívala; a través de InferenceKey verás la mejora cuando el worker envíe peticiones en paralelo (abierto por nuestra parte).
- Un desarrollador, una petición cada vez: pon dos intentos por paso y mide.
- Una GPU de 16 GB: usa pesos de 8 bits y cuenta con menos espacio para conversaciones en paralelo. Probado en una RTX 5080, más nueva; las GPU de 16 GB más antiguas pueden fallar al cargar.
- Una GPU de 24 GB: los pesos de 8 bits funcionaron con un límite emulado de 24 GB.
- Tests que comparan la salida byte a byte: compara resultados, no bytes.
Para activar y desactivar la cabeza en tu propia GPU, ejecuta python main.py y luego MELLUM_MTP=0 python main.py desde el ejemplo del SDK de Mellum2.1 MTP. Necesita un worker privado de NVIDIA con 48 GB (32 GB pasó solo con un límite emulado), o 16 GB con MELLUM_FP8=1 MELLUM_CONTEXT=16384, además de un token del SDK y una API key. A través de nuestro endpoint muestra la mejora de una petición, y borra el despliegue al terminar.
Para ingenieros
Créditos
- JetBrains: el modelo, entrenado con su cabeza MTP, con licencia Apache-2.0; el repositorio MTP con la cabeza en
model-mtp.safetensors, la versión base Thinking, el repositorio GGUF con ficheros de borrador MTP, las recetas de servicio, el prompt del Quickstart que ejecutamos y la tabla de benchmarks. - El proyecto vLLM: la decodificación especulativa MTP (
--speculative-config '{"method": "mtp", ...}'), las métricas de spec-decode de las que leímos la aceptación, la cuantización FP8 online y el backend de modelado de Transformers que sirve Mellum y su borrador en 0.33.0 (TransformersMoEForCausalLM,TransformersMoEForMTP). - Hugging Face Transformers: el código de modelado que ejecuta el backend; 5.20 es la primera versión que carga la cabeza en lugar de saltársela.
- pmttyji en r/LocalLLaMA: donde lo vimos (post del 2026-11-02).
- Nuestra parte: el despliegue a través de la plataforma, las ejecuciones sin cabeza frente a MTP en la misma GPU, el barrido de 1/2/3 tokens y de concurrencia, la contabilidad de memoria de la cabeza, la escalera de VRAM en dos GPU reales más límites emulados, el ejemplo del SDK y el vídeo de demo.
Modelo y ficheros
JetBrains/Mellum2.1-12B-A2.5B-Thinking-MTP: shad55846102dd1c047e95d4841070f88290227c3b7, creado el 2026-10-30T17:20:32Z, última modificación 2026-10-30T18:12:02Z, sin acceso restringido, Apache-2.0, 17 likes y 1302 descargas el 2026-11-13. Cinco shards BF16 de 24,30 GB másmodel-mtp.safetensorsde 856.767.160 bytes, 25,17 GB en total.- Base
JetBrains/Mellum2.1-12B-A2.5B-Thinking: sha92ddae9f, creado el 2026-09-20, última modificación 2026-10-07. Su ficha listaba las versiones GGUF y la cabeza MTP como "coming soon". - Repositorio GGUF: sha
4159d684, última modificación 2026-10-22, BF16, MXFP4_MOE, Q4_K_M, Q6_K y Q8_0 más GGUF de borrador enmtp/con las mismas cuantizaciones. Sin probar. - Arquitectura: 12B en total, 2.5B activos, 28 capas (21 de ventana deslizante de 1024 y 7 de atención completa), hidden 2304, 64 expertos con 8 activos, GQA 32 cabezas Q / 4 KV, head_dim 128, vocabulario de 98.304, contexto de 131.072 (YaRN factor 16 en las capas de atención completa),
num_nextn_predict_layers: 1. Modelo baseJetBrains/Mellum2-12B-A2.5B-Base. - Requisitos de la ficha: vLLM 0.33 o posterior con transformers 5.20 o posterior. "vLLM releases up to 0.32 refuse the checkpoint"; transformers anterior a 5.20 se salta los tensores de la cabeza con un aviso. Otras vías de la ficha, sin probar:
use_mtp=Trueengeneratede transformers, y llama.cpp con--spec-type draft-mtp --spec-draft-n-max 1. - Muestreo del Quickstart de la ficha: temperature 0.6, top_p 0.95, top_k 20, max_tokens 81920.
- La ficha no indica la GPU, el tamaño de lote ni la precisión detrás de su rango de 1,4 a 1,8x.
Benchmarks de los autores (no reproducidos)
| Benchmark | Mellum2.1 | Mellum2 Thinking | Gemma 4 E4B | Qwen3.5 9B |
|---|---|---|---|---|
| LiveCodeBench v6 | 82,0 | 69,4 | 69,4 | 75,4 |
| SWE-bench Verified | 47,0 | 2,0 | 23,0 | 50,0 |
| SWE-bench Pro | 28,0 | 0,0 | 4,0 | 38,0 |
| Terminal-Bench 2.1 | 17,4 | 0,6 | 3,4 | 21,7 |
| AIME 25/26 | 83,3 | 60,1 | 45,0 | 86,7 |
| GPQA Diamond | 64,6 | 51,0 | 53,1 | 77,8 |
| BFCL v4 | 62,3 | 49,6 | 52,5 | 58,5 |
También en la ficha para Mellum2.1: HumanEval+ 91,5, MBPP+ 79,4, IFEval 90,6, HarmBench 8,5 (menos es mejor). Las ejecuciones agénticas usaron el harness Pi v0.73.1.
Configuración
- GPU en InferenceKey Cloud: RTX A6000 48 GB (46.068 MiB, compute capability 8.6, driver 595.91.07) para las ejecuciones principales, sin cabeza y con MTP, en BF16; RTX 5080 16 GB (16.303 MiB, compute capability 12.0, driver 580.178.04) para el peldaño de tarjeta pequeña real, en FP8. No había una RTX A4000 (Ampere, 16 GB) disponible, así que FP8 en una tarjeta Ampere real de 16 GB está sin probar.
- Backend: el backend
vllmintegrado convllm_version="0.33.0"en la especificación del workload, que instala torch 2.14.0 y transformers 5.20.x. vLLM 0.33.0 asignaMellumForCausalLMal backend de modelado de Transformers; todavía no hay una implementación nativa de Mellum en vLLM. Por qué vLLM: es la receta principal de la ficha. - Un manager local de InferenceKey, al que los workers llegan a través de túneles. Producción sin tocar. Pesos descargados de antemano al disco del contenedor en cada worker (36 s en la A6000).
- Mediciones: un barrido por ajuste, sin repeticiones; cinco prompts x 2 a través del endpoint (greedy, streaming); barridos de concurrencia y de profundidad de borrador directos a vLLM en el worker tras el calentamiento; aceptación de los contadores
vllm:spec_decode_*; VRAM denvidia-smimuestreado cada segundo.
Paso a paso con el ejemplo del SDK
- Clona inferencekey-sdk y abre
examples/mellum21-12b-a2-5b-mtp-vllm-private-nvidia(commit0a5188e70d0c32c95c9e36a17dcb75078102e48f). cp .env.example .envy rellena el token del SDK (ik_sdk_, lectura y escritura de workloads), una API keyik_live_que permita el workload, el proyecto yIK_WORKER_ID: un worker privado de NVIDIA con driver CUDA 13 (580 o posterior), 32 GB para BF16 o 16 GB con FP8.pip install -r requirements.txtmás la compilación local del SDK con maturin (el SDK no está en PyPI).python main.py. Haceensure()de un workloadvllmfijo (slugmellum21-thinking,vllm_version="0.33.0") en tu worker, espera hasta 2400 s, hace la pregunta del Quickstart de la ficha congenerate_text(), recibe en streaming una tareamerge_intervalscon el tiempo hasta el primer token y los tokens por segundo, ejecuta un bucle de agenteget_weatherde hasta 4 turnos, escribeoutputs/answers-<mtp|plain>.jsony llama adelete()salvo queIK_KEEP_ALIVE=1.- Variantes:
MELLUM_MTP=0 python main.pypara el modelo sin cabeza;MELLUM_FP8=1 MELLUM_CONTEXT=16384 MELLUM_SPEC_TOKENS=2 python main.pypara una tarjeta de 16 GB. Otros ajustes:MELLUM_SPEC_TOKENS(por defecto 1, el de la ficha),MELLUM_CONTEXT(131072),MELLUM_GPU_UTIL(0.90).
El comando que ejecuta el backend (MTP activado, ajuste de la ficha):
vllm serve JetBrains/Mellum2.1-12B-A2.5B-Thinking-MTP \
  --max-model-len 131072 --gpu-memory-utilization 0.90 --max-num-seqs 16 \
  --reasoning-parser qwen3 \
  --enable-auto-tool-choice --tool-call-parser hermes \
  --speculative-config '{"method": "mtp", "num_speculative_tokens": 1}'
Para el modelo sin cabeza quita --speculative-config. Para el peldaño de la RTX 5080 añade --quantization fp8, pon --max-model-len 16384 y num_speculative_tokens a 1 o 2. El ejemplo solo envía temperature y top_p; un comentario del código dice que el top_k=20 de la ficha no puede viajar a través del endpoint (no comprobado contra el código del manager).
Tiempos
| Paso | Tiempo |
|---|---|
A6000 en frío, de ensure() a lista | 488,9 s |
| de ello, instalación de vLLM 0.33.0 | unos 4 min |
| descarga previa de pesos | 36 s |
| carga de pesos (23,47 GiB) | 12,3 s |
| torch.compile | 35,5 s |
| inicio del motor (perfilado, KV cache, calentamiento) | 179,65 s |
| reinicio de la A6000 con MTP desactivado | 101,2 s (inicio del motor 47,2 s) |
| Peldaños directos, cachés calientes | de 66 a 126 s |
RTX 5080, de ensure() a lista | 1207,1 s (unos 14 min de descargas de pip a unos cientos de kB/s en esa máquina; carga 19,7 s; inicio del motor 260,0 s) |
Tiempo hasta el primer token a través del endpoint: de 0,23 a 0,29 s en todos los casos.
Velocidad a través del endpoint (A6000, BF16, greedy, streaming)
| Prompt | Sin cabeza: tokens / s / tok/s | MTP 1 token propuesto: tokens / s / tok/s |
|---|---|---|
| Bug del Quickstart de la ficha (x2) | 381 / 3,69 / 110,2 | 372 / 3,24 / 123,5 |
merge_intervals (x2) | 619 / 5,91 / 109,1 | 603 / 4,90 / 129,6 |
| n^2+1 divisible por 5, n <= 1000 | 380 y 829 / 3,74 y 7,90 / 110,3 y 108,2 | 369 y 810 / 3,16 y 6,77 / 127,0 y 124,3 |
| Explicación de un hash map | 792 y 881 / 7,55 y 8,45 / 108,3 y 107,6 | 940 y 718 / 8,06 y 6,19 / 120,4 y 120,7 |
| Lisboa u Oslo (herramientas) | 280 / 2,78 / 109,7, dos llamadas en paralelo | 244 / 2,16 / 126,7, solo Lisboa |
Aceptación durante esta prueba en el workload MTP: 3365/3767 = 89,3%.
Velocidad directa a vLLM (en caliente)
| A6000, BF16, contexto 131.072, util 0.90 | 1 petición greedy | 1 petición muestreo de la ficha | 8 a la vez greedy | 8 a la vez muestreo de la ficha | Aceptados |
|---|---|---|---|---|---|
| Sin cabeza | 106,8 | 105,7 | 418,4 | 316,4 | |
| MTP, 1 token propuesto (ficha) | 118,9 (1,11x) | 118,6 (1,12x) | 607,3 (1,45x) | 462,1 (1,46x) | 87,2% (8396/9623) |
| MTP, 2 tokens propuestos | 140,2 (1,31x) | 138,9 (1,31x) | 581,8 (1,39x) | 525,9 (1,66x) | 66,6% (9931/14906) |
| MTP, 3 tokens propuestos | 124,8 (1,17x) | 125,5 (1,19x) | 663,5 (1,59x) | 478,5 (1,51x) | 48,6% (10070/20709) |
| RTX 5080, FP8, contexto 16.384, util 0.90 | 1 petición greedy | 1 petición muestreo de la ficha | 8 a la vez greedy | 8 a la vez muestreo de la ficha | Aceptados |
|---|---|---|---|---|---|
| Sin cabeza | 217,2 | 212,4 | 896,7 | 468,1 (no comparable: 3 de 8 duraron 64 s, 30.205 tokens, con una KV de 52.400 tokens) | |
| MTP, 1 token propuesto | 288,7 (1,33x) | 279,7 (1,32x) | 1276,5 (1,42x) | 966,1 | 87,7% (10443/11913) |
| MTP, 2 tokens propuestos | 291,2 (1,34x) | 283,9 | 1297,4 (1,45x) | 1212,0 | 68,6% (14209/20726, todo el tráfico) |
A través del endpoint en la RTX 5080 con MTP 2: de 298 a 344 tok/s.
Con ocho a la vez, tres tokens propuestos fueron en cabeza con decodificación greedy y dos con el muestreo de la ficha; una ejecución de cada.
Lo que cuesta la cabeza MTP en memoria
| Tarjeta, precisión | Pesos sin cabeza / MTP | KV cache sin cabeza | KV cache MTP 1 | Pico sin cabeza / MTP |
|---|---|---|---|---|
| RTX A6000, BF16, util 0.90 | 22,67 / 23,47 GiB (+0,80) | 16,75 GiB = 1.122.580 tokens | 15,87 GiB = 1.027.634 tokens (-8,5%); 16,0 GiB = 1.036.154 en el peldaño directo | 41.017 / 41.147 MiB |
| RTX 5080, FP8, util 0.90, contexto 16.384 | 11,74 / 12,14 GiB (+0,40) | 1,36 GiB = 52.400 tokens | 0,87 GiB = 29.019 tokens (-45%); 25.967 con MTP 2 | 14.364 / 15.832 MiB |
El pico lo fija --gpu-memory-utilization, así que el coste de la cabeza aparece como KV perdida, no como un pico más alto en la A6000. La muestra individual más alta de la A6000 fue de 41.280 MiB, durante el workload MTP. vLLM también avisó Add 6 padding layers, may waste at most 27.27% KV cache memory.
Escalera de VRAM
| GPU o límite | Configuración | VRAM pico | Velocidad (1 petición) | Salida correcta | Real o emulado |
|---|---|---|---|---|---|
| RTX A6000 48 GB | BF16, 131.072, sin cabeza | 41.017 MiB | 106,8 tok/s | sí | real |
| RTX A6000 48 GB | BF16, 131.072, MTP 1 (ficha) | 41.147 MiB | 118,9 tok/s | sí | real |
| RTX A6000 48 GB | BF16, 131.072, MTP 2 | 41.033 MiB | 140,2 tok/s | sí | real |
| RTX A6000 48 GB | BF16, 131.072, MTP 3 | 41.049 MiB | 124,8 tok/s | sí | real |
| Límite de 32 GB (util 0.71) | BF16, 32.768, MTP 2 | 32.391 MiB (KV 7,34 GiB, 337.838 tokens) | 140,6 tok/s | sí | emulado |
| Límite de 24 GB (util 0.52) | BF16, 16.384, MTP 2 | ninguno | ninguna | no: ValueError: No available memory for the cache blocks (pesos BF16 de 23,47 GiB) | emulado |
| Límite de 24 GB (util 0.52) | FP8 online, 32.768, MTP 2 | 23.779 MiB (pesos 12,18 GiB, KV 10,08 GiB, 463.944 tokens) | 211,4 tok/s | sí | emulado |
| Límite de 16 GB (util 0.345) | FP8 online, 16.384, MTP 2 | 15.819 MiB sirviendo, 21.917 MiB de pico transitorio al cargar (FP8 solo de pesos con Marlin en Ampere) | 209,3 tok/s | sí | emulado |
| RTX 5080 16 GB | FP8, 16.384, sin cabeza | 14.364 MiB | 217,2 tok/s | sí | real |
| RTX 5080 16 GB | FP8, 16.384, MTP 1 | 15.832 MiB de 16.303 | 288,7 tok/s | sí | real |
| RTX 5080 16 GB | FP8, 16.384, MTP 2 (ejemplo del SDK a través del endpoint) | 15.832 MiB de 16.303 | 291,2 tok/s directo; 303,3 tok/s en la tarea de código del ejemplo | sí | real |
Sin probar: 12 GB (solo los pesos FP8 ocupan 12,18 GiB), la vía GGUF y llama.cpp, FP8 en una tarjeta real de 24 GB (3090/4090), BF16 en una tarjeta real de 32 GB, más de 16K de contexto con 16 GB, un prompt largo que use la ventana completa de 131.072, use_mtp=True de transformers y los benchmarks de los autores. La calidad en FP8 se comprobó solo con nuestros cinco prompts.
Comprobaciones de calidad
- Quickstart de la ficha (
def mean(xs): return sum(xs) / len(xs) - 1): bug encontrado en todas las ejecuciones y peldaños. merge_intervals: las 13 de 13 salidas comprobadas pasaron 4 asserts.- Matemáticas (n^2+1 divisible por 5, n <= 1000): 400 en todas las ejecuciones.
- Herramientas: llamadas válidas en formato hermes en todas las ejecuciones.
- Ejecuciones del ejemplo del SDK: A6000 con MTP, tarea de código de 510 tokens en 4,36 s, 126,1 tok/s, TTFT 0,32 s; A6000 sin cabeza, 474 tokens, 109,4 tok/s; RTX 5080 FP8 MTP 2, 700 tokens en 2,47 s, 303,3 tok/s.
Problemas pendientes
- Aceleración con una petición por debajo del rango de la ficha en la A6000 en BF16. 1,11x con un token propuesto aunque se acepte el 87,2%. Hipótesis, sin demostrar: el backend genérico de modelado de Transformers más el aviso de vLLM
Using default MoE config. Performance might be sub-optimal!, y un paso de verificación que cuesta casi lo que ahorra en un MoE de 2.5B activos. Dos tokens propuestos dan 1,31x. Abierto en upstream: todavía no hay una implementación nativa de Mellum en vLLM. - Un trabajo cada vez por workload en el worker (
max_in_flight slots=1). Las peticiones en paralelo a través del endpoint hacen cola, así que las cifras de concurrencia se midieron directamente contra vLLM. Abierto por nuestra parte. - Las salidas greedy no son idénticas byte a byte entre ejecuciones, con y sin MTP (MTP: matemáticas 369 frente a 810 tokens, hash map 940 frente a 718; sin cabeza: 380 frente a 829, 792 frente a 881). Las respuestas siguieron siendo correctas. Esperable según la documentación de vLLM: la decodificación especulativa no pierde nada "up to the precision limits of hardware numerics", y el tamaño de lote puede mover los logprobs y las probabilidades de salida.
- Las llamadas a herramientas variaron entre ejecuciones. En la A6000 en BF16 con MTP el modelo llamó a las herramientas una ciudad por turno (Lisboa, luego Oslo); sin MTP hizo dos llamadas
get_weatheren paralelo, y lo mismo la ejecución 3 en la RTX 5080 (FP8, MTP 2). Los clientes necesitan un bucle de agente. La primera versión de nuestro ejemplo permitía una sola ronda y devolvía una respuesta final vacía. Corregido: el ejemplo itera hasta 4 turnos. - La primera petición con muestreo tras un reinicio es lenta: Triton compila JIT
_gumbel_sample_kernely otros, 52,4 tok/s y luego 105,8. Calienta antes de medir. - FP8 online en Ampere carga pasando por un pico: 21.917 MiB durante unos 3 s con el límite de 16 GB. Una tarjeta Ampere real de 16 GB puede fallar al cargar. La RTX 5080 (FP8 nativo) no lo mostró.
- Avisos de vLLM: relleno de KV (
may waste at most 27.27% KV cache memory), configuración MoE por defecto ymax_num_scheduled_tokens is set to 2048 based on the speculative decoding settings. - Descargas de paquetes lentas en la máquina de la RTX 5080: unos 14 de sus 20 minutos hasta estar lista.
Vídeo de demo
La demo narrada de 165 segundos: qué es Mellum2.1 (la ficha del modelo, el párrafo de MTP, los benchmarks de los autores y una comparación en Terminal-Bench 2.1 con GPT-5.6 Sol y Claude Mythos 5 tomada del espejo de BenchLM de la clasificación de Vals (consultado el 2026-11-08, sin volver a comprobar), con un harness distinto del de los autores), el despliegue en el panel en la RTX A6000 con la cabeza activada (una tarea de programación a 128 tokens por segundo, 640 tokens en 5,1 s, y el bucle de herramientas, Lisboa y luego Oslo, en 4,9 s), la comparación clave, sin cabeza frente a MTP, y la escalera de GPU. Incluye subtítulos en inglés.
Fuentes
- JetBrains/Mellum2.1-12B-A2.5B-Thinking-MTP (ficha del modelo, configuración, cabeza MTP).
- JetBrains/Mellum2.1-12B-A2.5B-Thinking (versión base).
- JetBrains/Mellum2.1-12B-A2.5B-Thinking-GGUF (sin probar).
- Documentación de decodificación especulativa de vLLM, consultada el 2026-11-13 (redirige a las páginas de decodificación especulativa y de MTP).
- Post de pmttyji en r/LocalLLaMA, 2026-11-02 (donde lo vimos).
- Ejemplo del SDK, commit
0a5188e70d0c32c95c9e36a17dcb75078102e48f.