NitroFusion2 en una sola tarjeta: una imagen de 1024 px en 0,78 s y un cartel correcto en dos pasos
Imágenes en un paso con 0,78 s de GPU en una RTX 4090, dos pasos en 1,32 s y 4 s en una tarjeta real de 16 GB. Un paso comete más erratas.
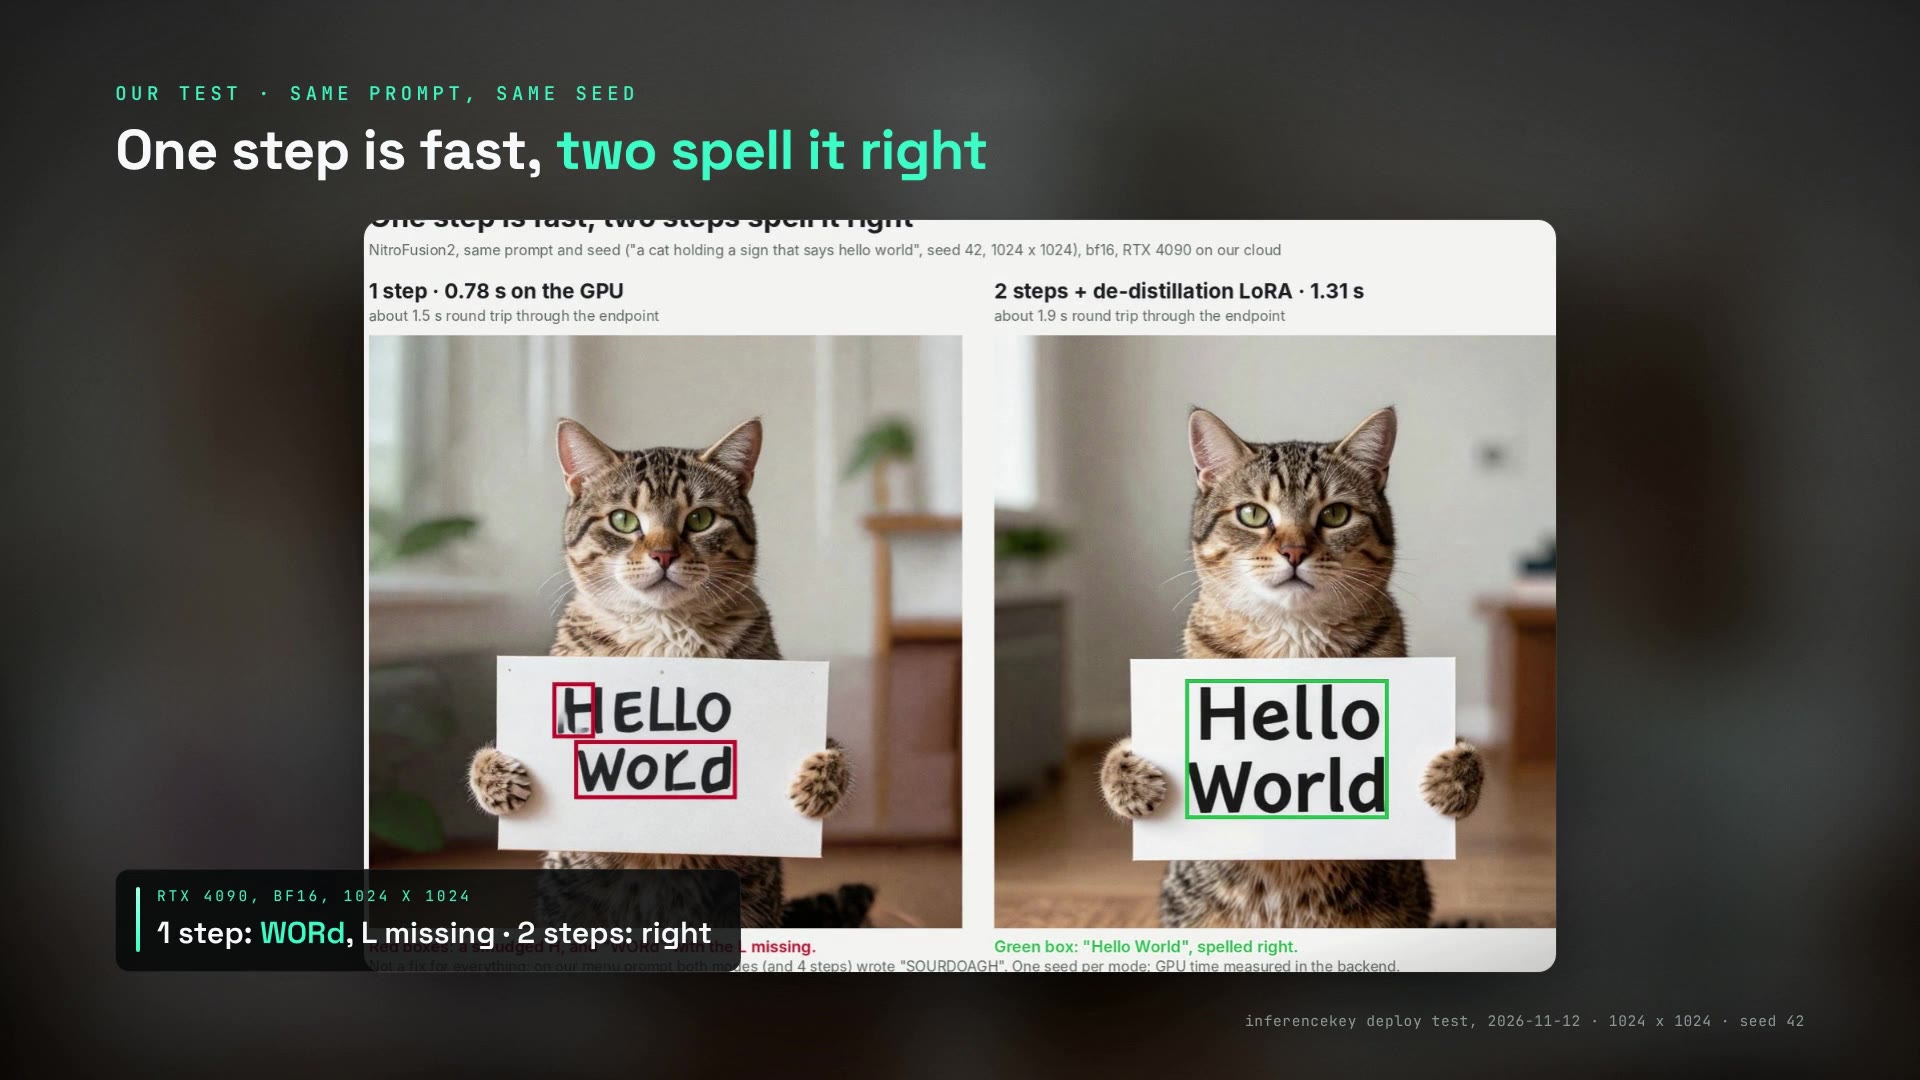
Un gato sostiene un cartel de cartón que dice "HELLO WORd". NitroFusion2 lo dibujó en un paso, en 0,78 segundos de tiempo de GPU, en una RTX 4090 de nuestra nube. Con dos pasos, el mismo prompt y el mismo punto de partida aleatorio (la semilla) tardaron 1,31 segundos, y el cartel decía "Hello World". Esa pareja resume el dilema.
NitroFusion2 es una copia más rápida del modelo abierto Z-Image-Turbo: una o dos pasadas por imagen en lugar de ocho. Comparamos NitroFusion2 consigo mismo, no con el original de ocho pasos. Atendiendo una petición cada vez, una sola tarjeta devuelve unas 40 imágenes grandes por minuto a través de la API con un paso. Con la copia comprimida de 5 GB de los autores también funciona en una tarjeta real de 16 GB, a unos 4 segundos por imagen. En tu propia GPU la velocidad no es el problema: lo que tienes que decidir es qué imágenes pueden permitirse una errata. Nuestro ejemplo del SDK lo despliega como API en tu propia tarjeta.
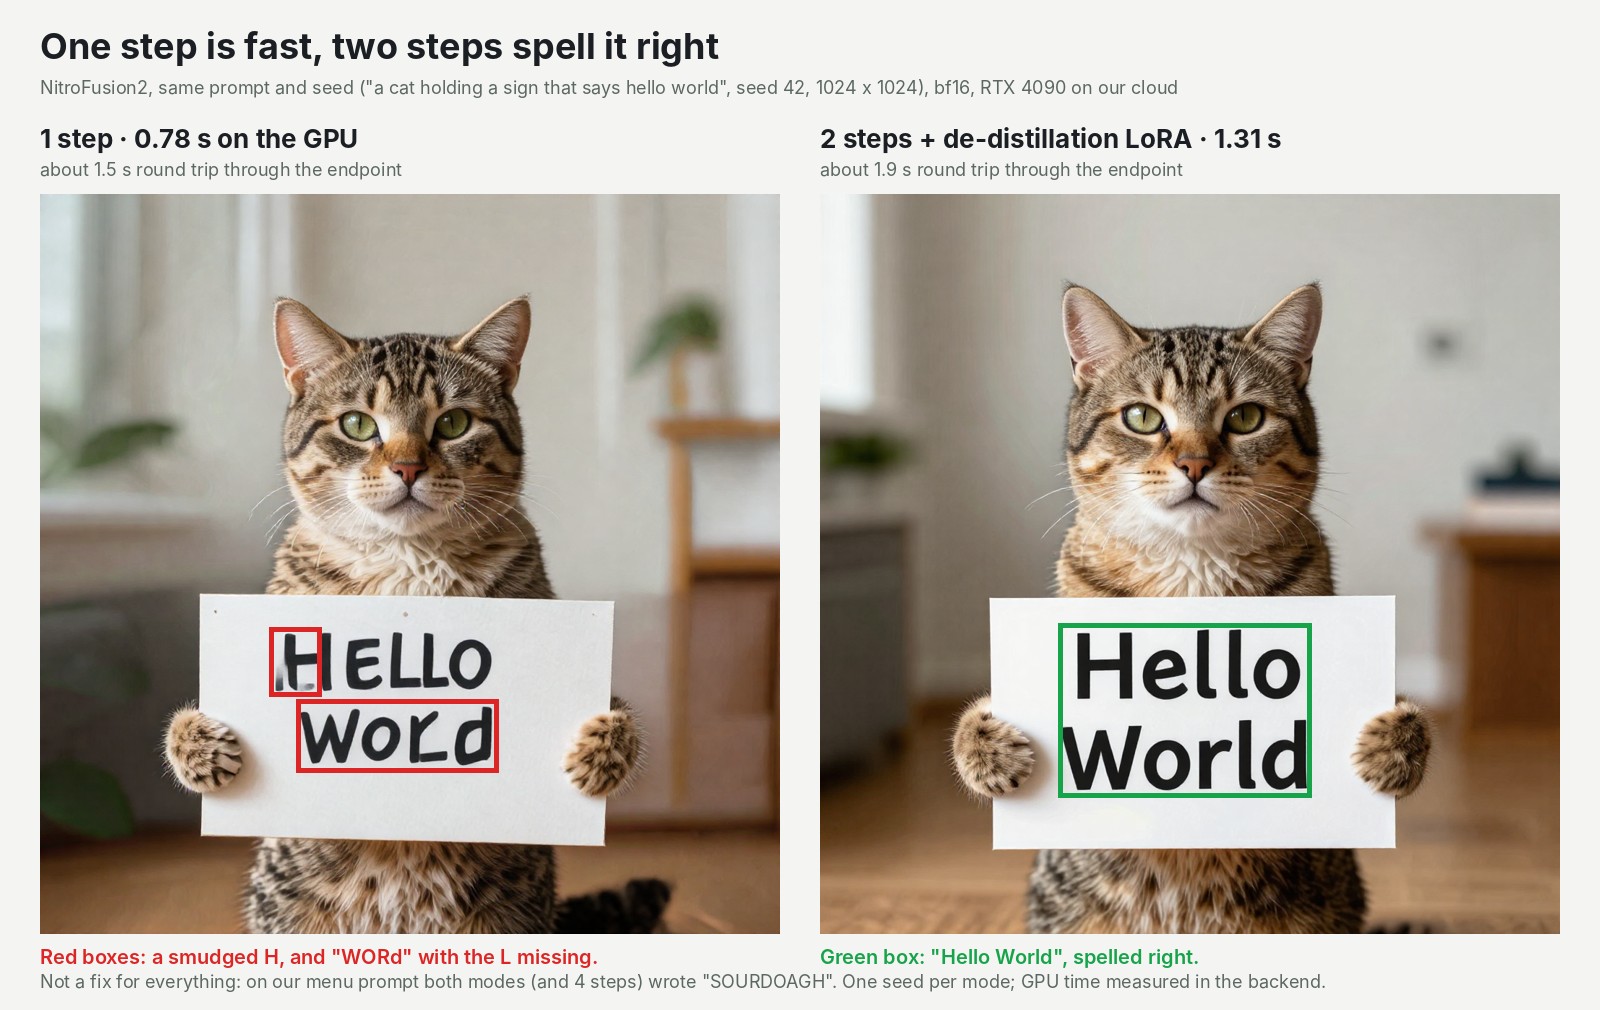
| 1024 x 1024, una imagen cada vez | Un paso | Dos pasos (receta de los autores) |
|---|---|---|
| Tiempo de GPU, RTX 4090, fichero completo de 12,3 GB | de 0,78 a 0,82 s | de 1,32 a 1,33 s |
| El cartel, semilla 42 | "HELLO WORd" | "Hello World" |
| Tarjeta real de 16 GB, copia de 5 GB | unos 4,0 s | unos 7,3 s |
Dos pasadas en lugar de ocho: un alumno entrenado para ahorrarse el trabajo
NitroFusion2 es rápido porque lo entrenaron para terminar la imagen antes. Un modelo de imagen como este parte de ruido aleatorio y lo va limpiando en pasadas. Cada pasada, un "paso", hace correr toda la red de 6,2B parámetros sobre la imagen una vez. Z-Image-Turbo, publicado por el laboratorio Tongyi-MAI con licencia Apache-2.0, hace ocho.
Dar-Yen Chen y Yi-Zhe Song, del grupo SketchX de la Universidad de Surrey, entrenaron una versión alumna que lo hace en uno o dos. Un alumno rápido aprende a llegar a donde llega el profesor lento. Imagina a un músico de sesión que aprende a tocar de un tirón la parte final que el productor fue construyendo en ocho grabaciones superpuestas.
Su artículo, publicado el 3 de noviembre, centra el entrenamiento en las palabras del prompt.
Las propias cifras de los autores anticipan lo que vimos. En una prueba de texto largo escrito dentro de imágenes, un paso saca 43 sobre 100. Z-Image-Turbo con ocho pasos saca 92, y NitroFusion2 con dos pasos, 76. En lo fiel que es la imagen al prompt, un paso iguala o supera a ocho. El artículo lo dice claramente: queda "a substantial gap" en el renderizado de texto. Son sus benchmarks. No los hemos repetido.
Para dos pasos, los autores recomiendan un pequeño complemento de 0,38 GB. Hace que el primer paso sea mitad Z-Image-Turbo para quitar algunos defectos, y después el alumno termina solo. Todo es Apache-2.0: los pesos y el código. La ficha del modelo también incluye copias comprimidas, de 2,0 GB a 7,2 GB, junto a la versión completa de 12,3 GB. Lo vimos en el vídeo de noticias de AI Search del 8 de noviembre.
Un paso cuesta 0,78 segundos de tiempo de GPU, dos cuestan 1,32
Cada paso extra añade algo más de medio segundo. El artículo solo da números de pasos, así que lo cronometramos. Servimos NitroFusion2 como API en una RTX 4090 de nuestra nube y pedimos imágenes de 1024 x 1024, una cada vez, todas con la semilla 42. La tarjeta que nos tocó era la versión de 48 GB de la 4090, así que limitamos la memoria del modelo para que se comportara como la tarjeta habitual de 24 GB. No probamos Z-Image-Turbo con ocho pasos ni varios usuarios a la vez: esto es NitroFusion2 contra sí mismo.
| Pasos | Tiempo de GPU | Ida y vuelta a través de la API |
|---|---|---|
| 1 | de 0,78 a 0,82 s | de 1,45 a 1,50 s |
| 2 | de 1,32 a 1,33 s | de 1,95 a 2,00 s |
| 4 | 2,42 s | 3,08 s |
La ida y vuelta incluye enviar la petición, codificar el PNG y recibirlo por la red. Añade unos dos tercios de segundo, así que con un paso la fontanería cuesta casi lo mismo que el dibujo.
A través de la API, un paso da unas 40 imágenes por minuto, y dos pasos, unas 30. Para una persona, eso es una vista previa nueva cada segundo y medio, más o menos. Dos pasos se notan como una pausa corta. Cuatro pasos, el máximo que acepta el modelo, tardan unas tres veces más que uno, y en el prompt del menú cuatro pasos siguieron escribiendo "SOURDOAGH".
Los titulares grandes aguantan un paso, la letra pequeña no aguanta ninguno
El resultado depende del tamaño del texto. Las palabras grandes salieron bien en un paso. La letra pequeña siguió floja con todos los números de pasos que probamos.
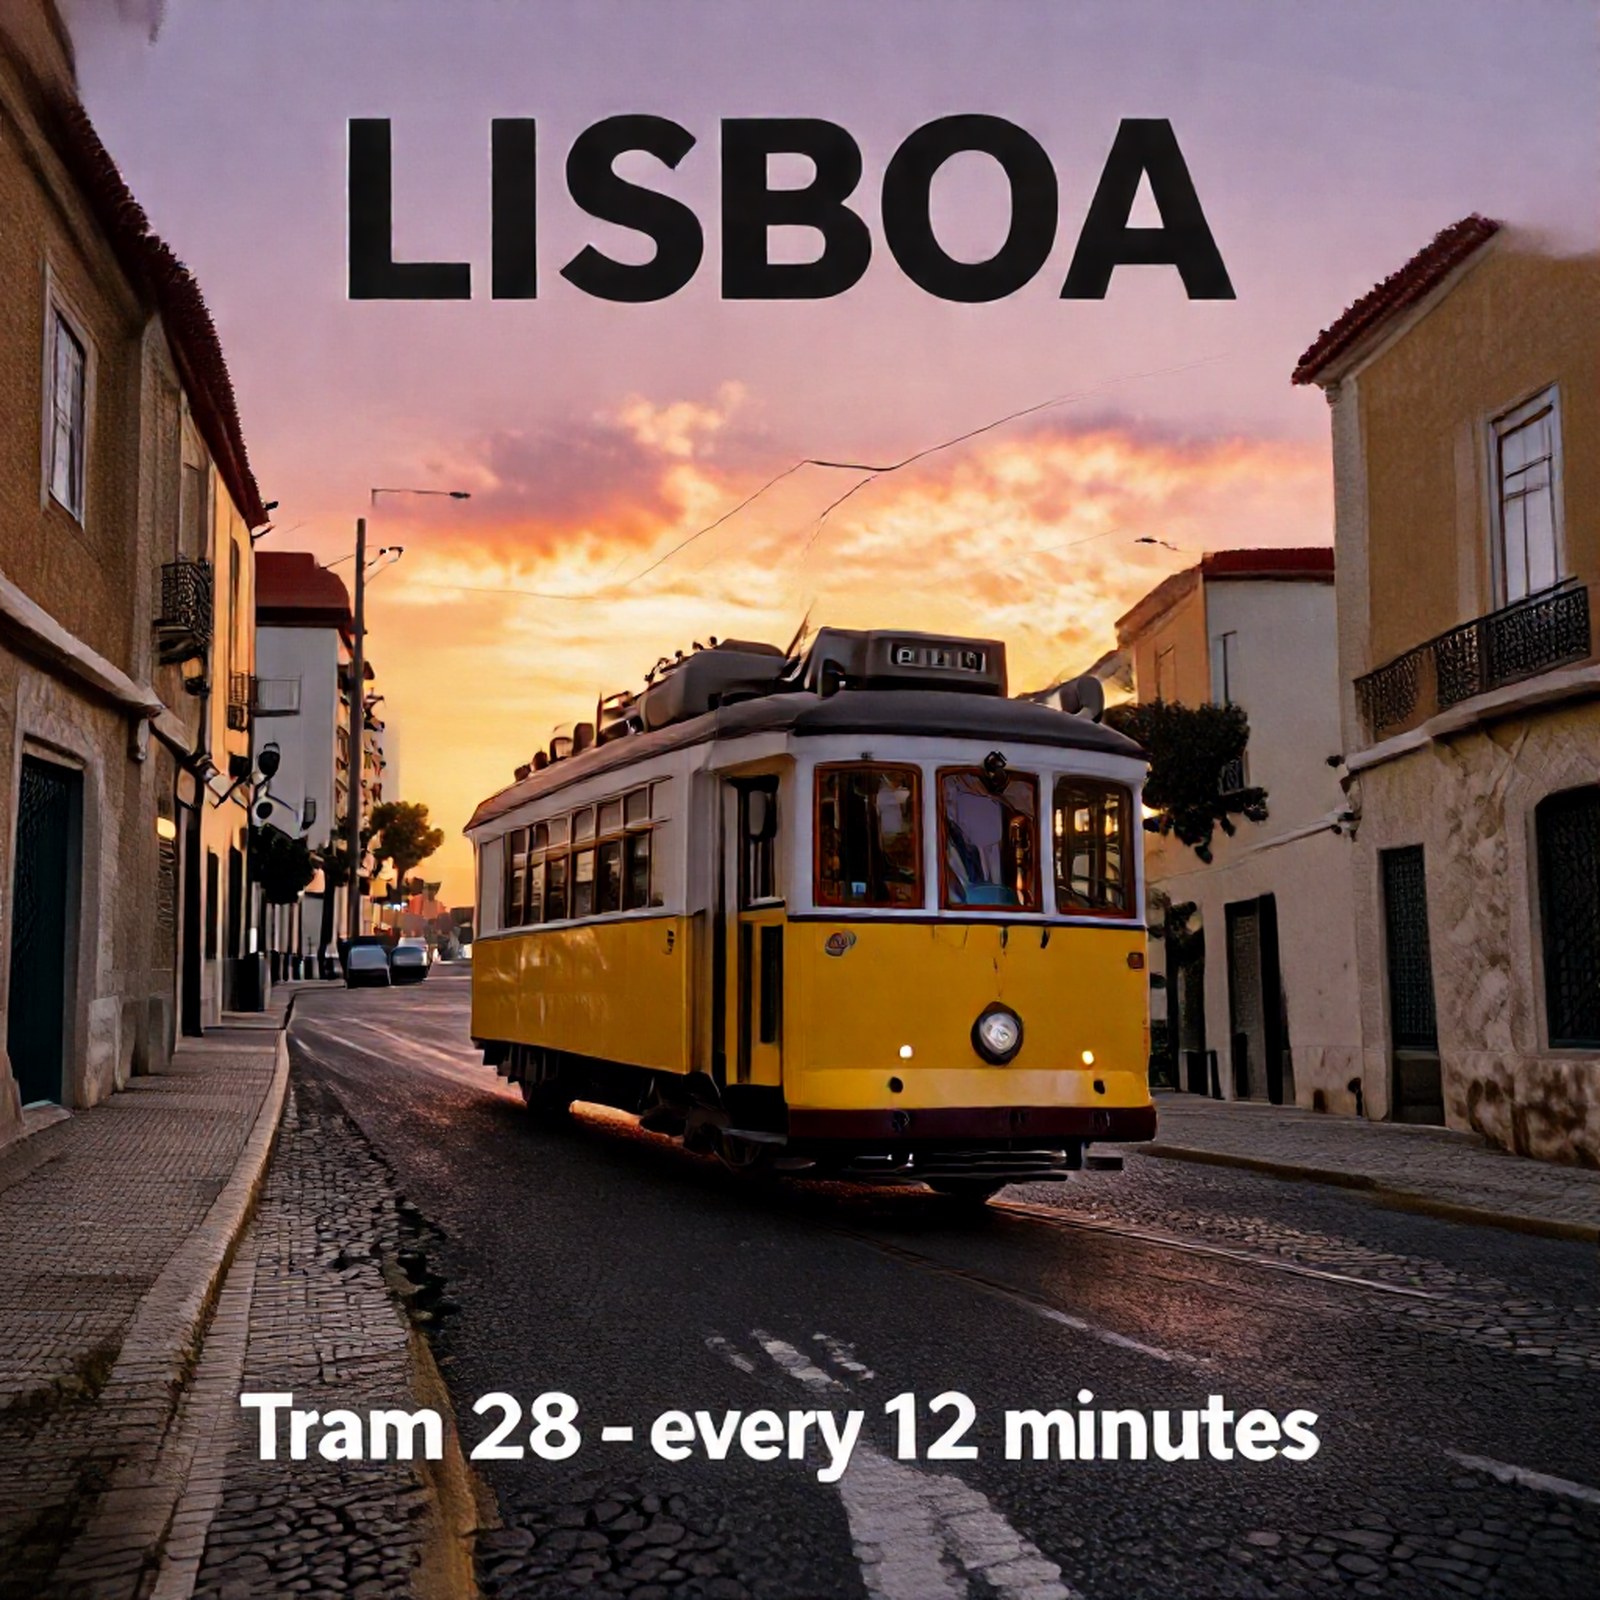
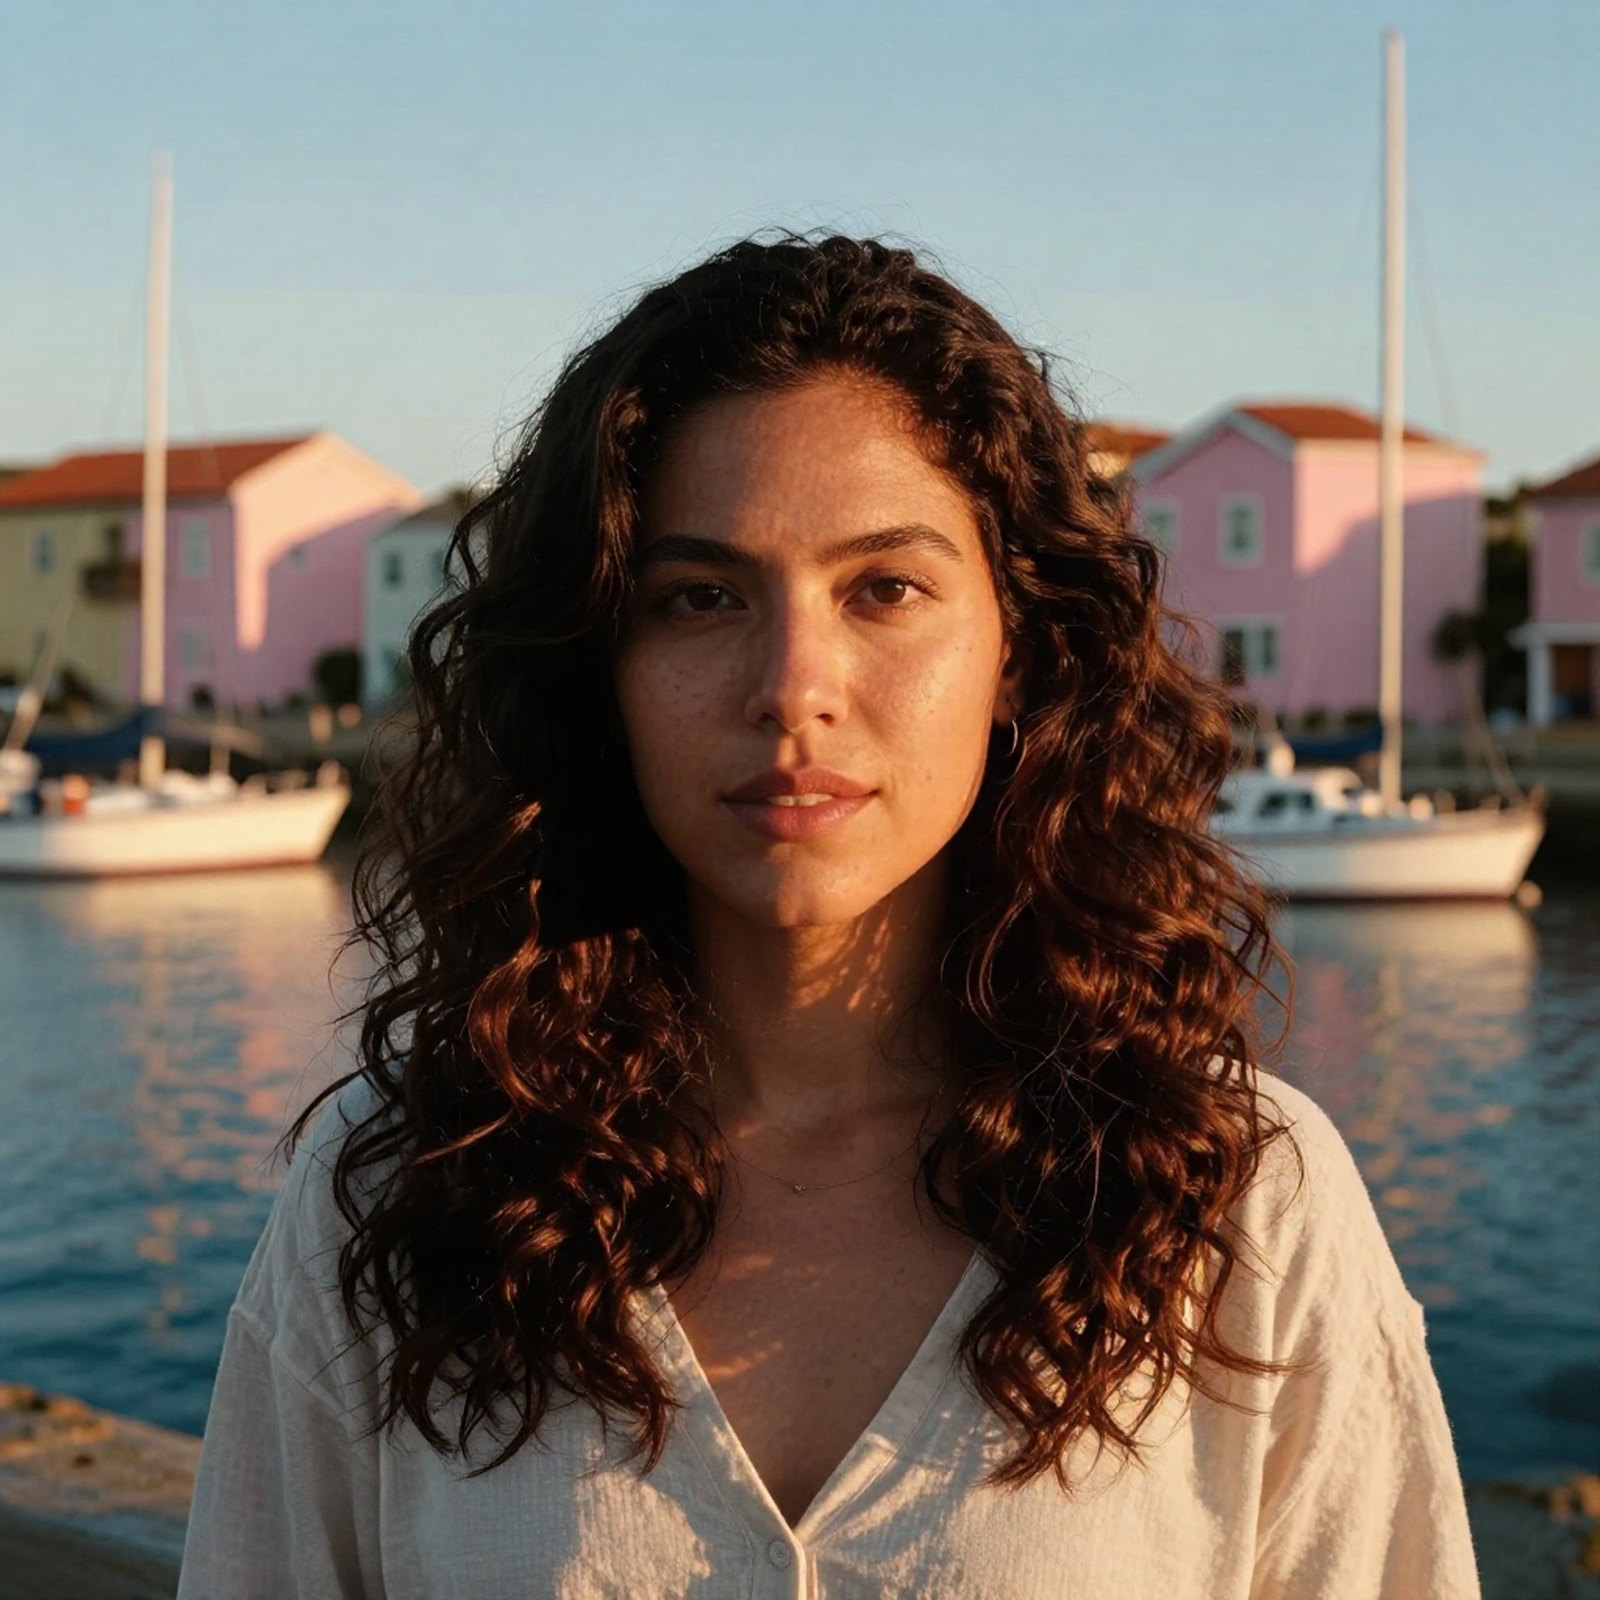
El cartel del tranvía sacó bien "LISBOA" y "Tram 28 - every 12 minutes" en un paso, en dos pasos y en la tarjeta de 16 GB. El prompt del retrato de los autores salió limpio con uno y con dos pasos.
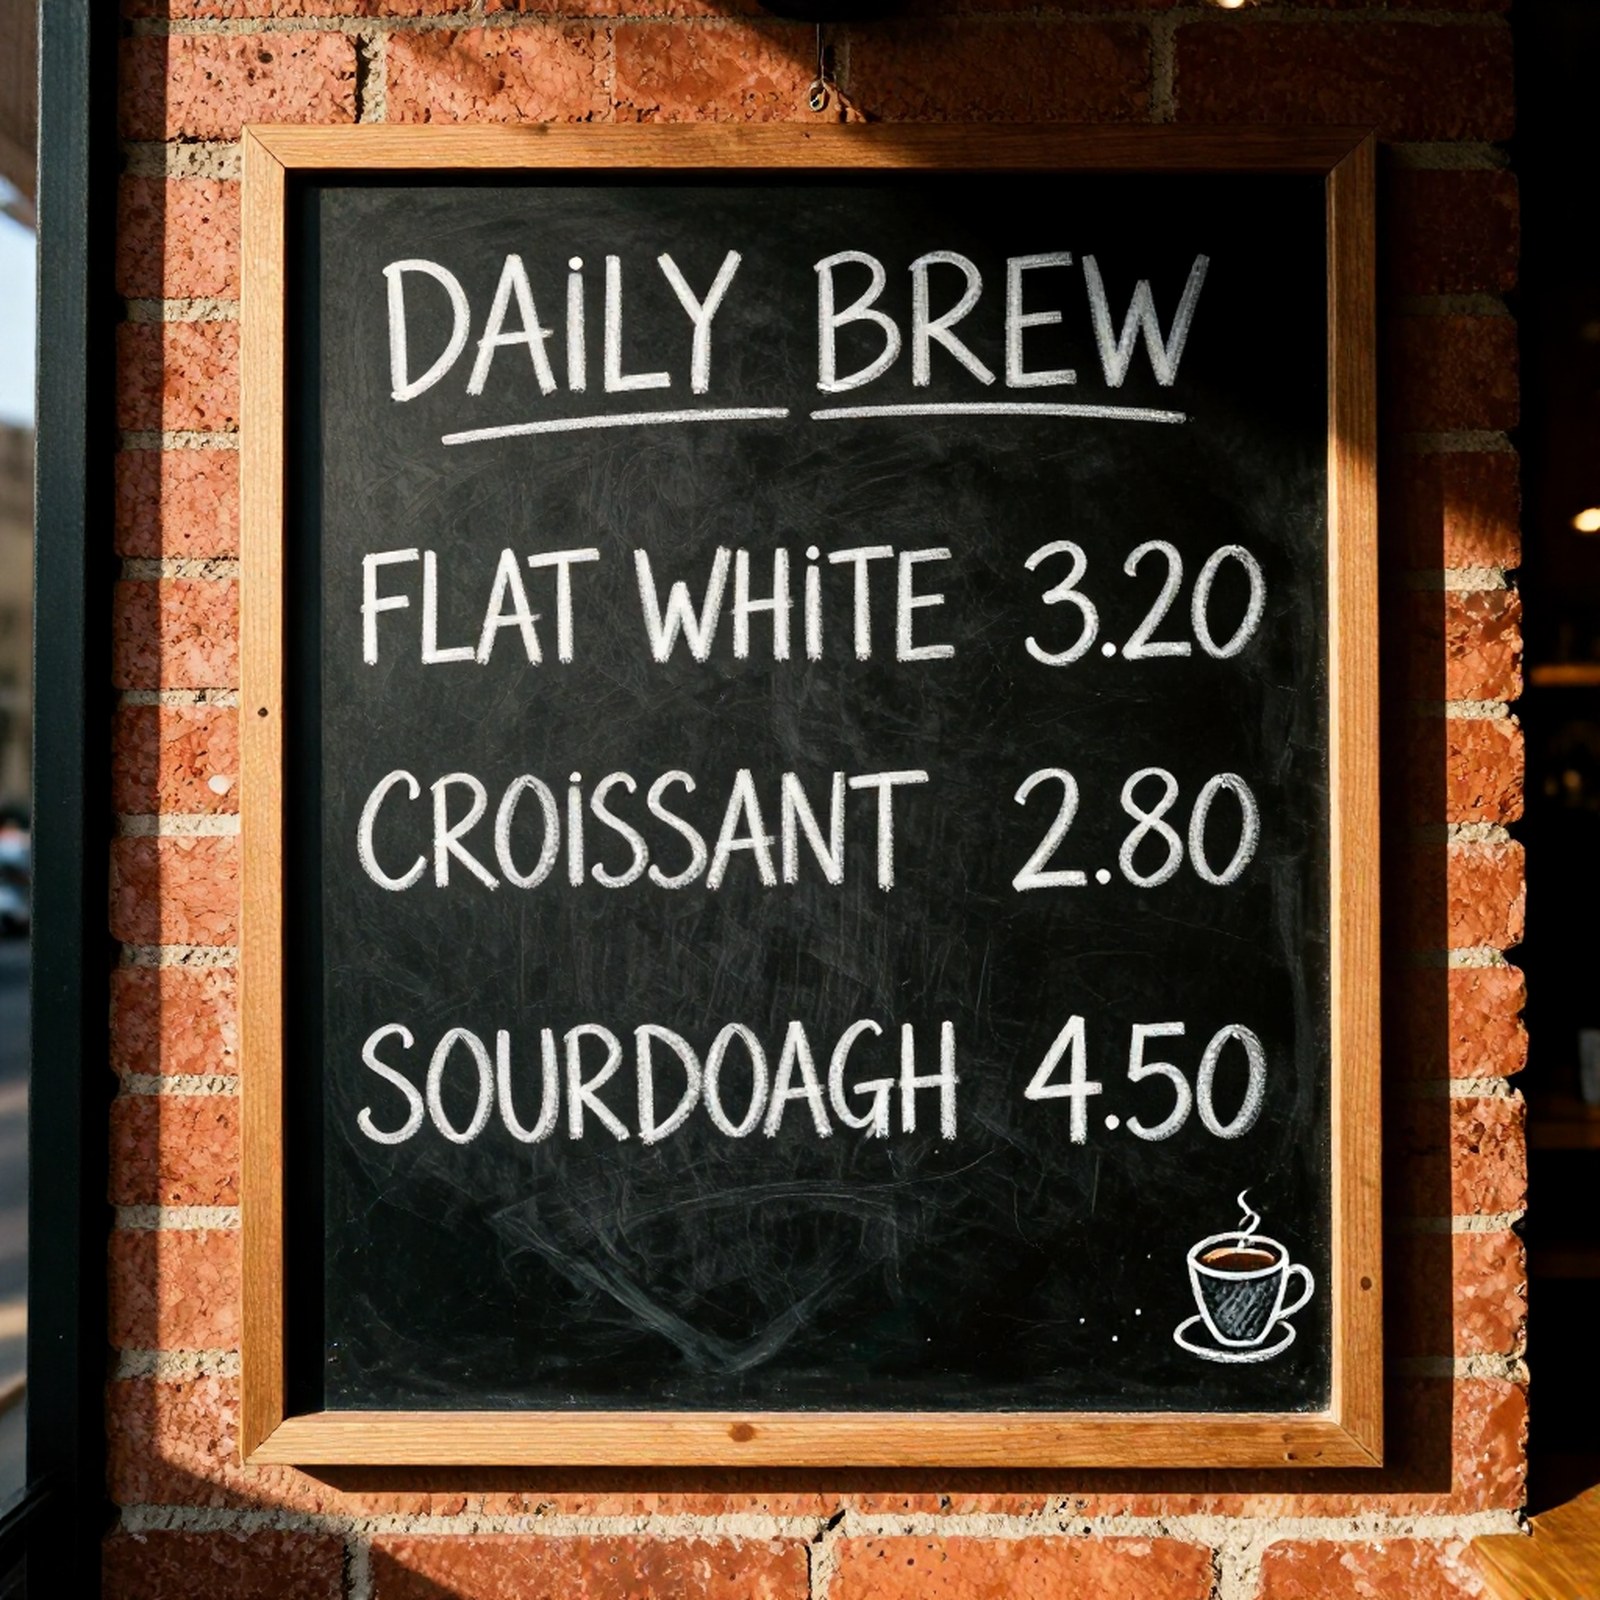
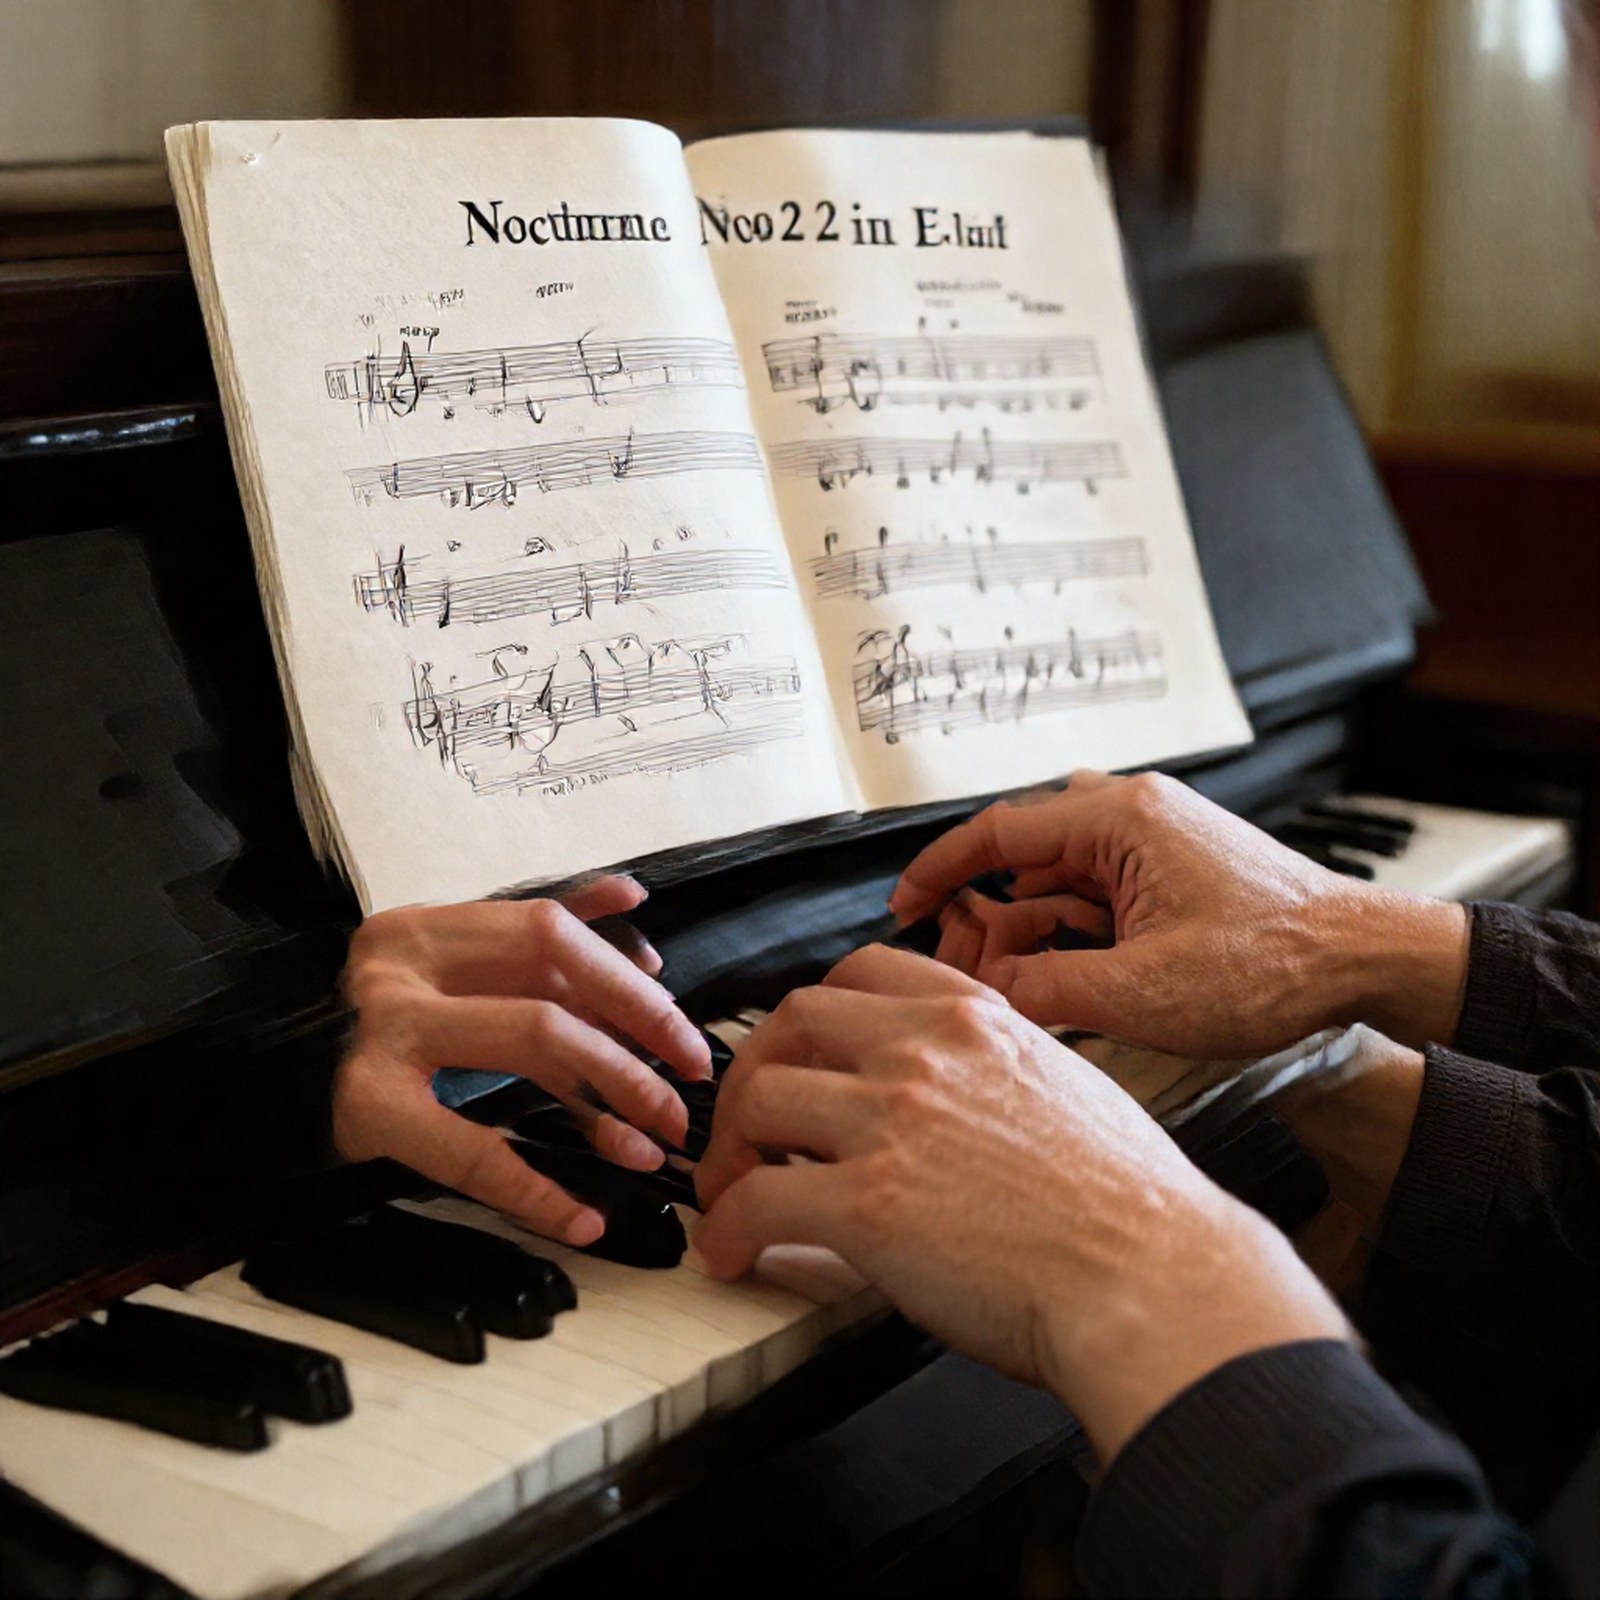
El menú de cafetería muestra el límite. Pedía "FLAT WHITE 3.20 / CROISSANT 2.80 / SOURDOUGH 4.50". En la 4090, todos los modos que probamos escribieron "SOURDOAGH": un paso, dos pasos, cuatro pasos y dos pasos sin el complemento. Los precios y las demás palabras estaban bien. En la tarjeta de 16 GB, un paso también escribió "CROSSANT". En la partitura, el título pequeño "Nocturne No. 2 in E-flat" salió ilegible con un paso y aún imperfecto con dos.
Una advertencia sobre las semillas. La misma semilla da píxeles distintos en otra GPU. En la tarjeta de 16 GB, el cartel de un paso salió bien, "HELLO WORLD". Una semilla por prompt es una comprobación de comportamiento, no un benchmark. Quédate con el patrón: el texto corto y grande suele salir bien en un paso, un segundo paso arregla algunos errores, y el texto pequeño o largo hay que revisarlo cada vez.
Qué GPU: una tarjeta real de 16 GB funciona con la copia de 5 GB, a 4 segundos por imagen
La tarjeta real más pequeña que funcionó fue una RTX 2000 Ada de 16 GB, una tarjeta pequeña de estación de trabajo de 70 vatios. Ejecutó la copia de 5 GB con todo en la tarjeta, unas cinco veces más despacio que la 4090. Le quedó libre menos de medio gigabyte de memoria. En la 4090 limitada, la copia de 5 GB tardó alrededor de 1 segundo, así que la mayor parte de los 4 segundos en la tarjeta pequeña se debe a un chip más lento.
¿Por qué no meter sin más el fichero de 12,3 GB en una tarjeta de 16 GB? Ese fichero es solo parte de la carga. El lector de texto de Z-Image-Turbo (la parte que lee el prompt) añade unos 8 GB, así que el montaje con el fichero completo de 12,3 GB llegó a un pico de unos 23 GB. Eso pide una tarjeta de 24 GB para quedarse en la GPU. Mover partes a la memoria del sistema entre usos permite ejecutar el fichero completo con un límite de 16 GB, pero a 14-19 segundos por imagen. La copia más grande de los autores, la de 7,2 GB, tampoco entró: con un límite de 16 GB se quedó sin memoria en la primera imagen. Con el lector de texto en la tarjeta, la copia de 5 GB es la que deja sitio.
| Tarjeta o presupuesto de memoria | Montaje | Tiempo por imagen (1 paso, 2 pasos) | ¿Tarjeta real? |
|---|---|---|---|
| RTX 2000 Ada 16 GB | copia de 5 GB, todo en la tarjeta | 4,0 s, 7,3 s | sí |
| Presupuesto de 16 GB | fichero completo de 12,3 GB, partes movidas a la memoria del sistema entre usos | de 14 a 19 s | no, un límite en la 4090 |
| Presupuesto de 12 GB | copia de 5 GB, partes movidas a la memoria del sistema entre usos | de 7,5 a 10,5 s | no, un límite en la 4090 |
Un presupuesto de 8 GB falla: el lector de texto ya ocupa unos 8 GB, así que no queda nada para el resto. No teníamos una tarjeta real de 12 GB, y no probamos las copias más pequeñas de 2 GB a 4 GB ni un lector de texto más pequeño para tarjetas de 8 GB.
En InferenceKey: listo en 67 segundos, y dos ajustes que cambiar
Una máquina GPU nueva en la plataforma estaba lista para servir 67 segundos después de pedirla. Esos 67 segundos cubren la preparación de Python (28 s), la descarga de unos 20 GB de pesos (33,8 s) y la carga (4,4 s). Solo descarga lo que usa NitroFusion2 y se salta los 24,6 GB de Z-Image-Turbo que sustituye. En la tarjeta de 16 GB, el mismo camino tardó 76 segundos.
No hay nada integrado que sirva este modelo, así que escribimos un pequeño fichero de Python que le dice a la plataforma cómo cargarlo y responder a las peticiones. Sigue los ajustes de los propios autores, incluido el complemento a media intensidad en el primer paso. La plataforma no necesitó ningún cambio. Fue una copia local de nuestro stack, no el servicio alojado.
El problema con el que te vas a encontrar: el probador de imágenes del panel empieza con 20 pasos y una guía (cuánto empuja hacia el prompt) de 4,5, valores equivocados para este modelo. NitroFusion2 rechaza 20 pasos con un error: solo acepta de 1 a 4. Pon los pasos a 1 o 2 y la guía a 0, y el probador respondió al cartel de un paso en unos 1,1 segundos. Estado: documentado en el README del ejemplo, los valores por defecto del probador no han cambiado.
¿Deberías usarlo? Un paso para vistas previas, dos para cualquier cosa con palabras
- Vistas previas, miniaturas, borradores en directo: un paso, menos de un segundo de tiempo de GPU.
- Imágenes con texto corto y grande que llegan a clientes: dos pasos, y revísalas.
- Menús, etiquetas, precios, letra pequeña: ninguno de los dos. Pon tú el texto encima, o prueba el Z-Image-Turbo de ocho pasos.
- Una tarjeta de 16 GB: la copia de 5 GB, y dile al ejemplo que lo mantenga todo en la tarjeta, o vuelve a un camino mucho más lento.
- Una tarjeta de 8 GB: no con este montaje.
Para generar las imágenes del cartel y del menú en tu propia tarjeta, ejecuta el ejemplo del SDK de NitroFusion2. Necesita una tarjeta NVIDIA de 24 GB, o de 16 GB con la copia de 5 GB, y unos 27 GB de disco (32 GB con la copia de 5 GB).
Para ingenieros
Créditos
- Dar-Yen Chen y Yi-Zhe Song (SketchX, CVSSP, Universidad de Surrey; Turing Elite Research Labs): NitroFusion2, el artículo "NitroFusion2: Bringing Adversarial Loss to the Text Stream of Multimodal Diffusion Transformers" (arXiv 2611.05648, CC BY 4.0), los pesos (Apache-2.0), la LoRA de des-destilación (el complemento de 0,38 GB), los ficheros GGUF, el código y
inference.py(Apache-2.0), cuatro workflows de ComfyUI y la página del proyecto. Se apoya en NitroFusion (Dar-Yen Chen, Hmrishav Bandyopadhyay, Kai Zou y Yi-Zhe Song, CVPR 2025). - Tongyi-MAI: Z-Image-Turbo (Apache-2.0), cuyo codificador de texto, tokenizador, VAE y scheduler reutiliza el pipeline.
- Los mantenedores de diffusers:
ZImagePipeline, el cargador de LoRA de Z-Image y la carga de GGUF en un solo fichero en diffusers 0.42.1. - PedroMarinhoDev: versiones de la comunidad para ComfyUI en int8, W6A8 y W4A8 (no las hemos probado).
- AI Search: donde lo vimos (2026-11-08 AI NEWS, capítulo en el 03:50).
- Nuestra parte: el backend personalizado, el despliegue a través de la plataforma, los tiempos, la escalera de memoria, las comprobaciones de calidad, el ejemplo del SDK y el vídeo de la demo.
Modelo y ficheros
ChenDY/NitroFusion2: sha62d1a7000af9c46a0c4348d936bd7670ff33c1b9, creado el 2026-10-27, modificado por última vez el 2026-11-08, sin restricción de acceso, apache-2.0, librería diffusers, pipeline text-to-image, modelo baseTongyi-MAI/Z-Image-Turbo. Publicación según la ficha: 2026-11-03.- Transformer:
ZImageTransformer2DModelde diffusers, 6.154.908.736 parámetros (la tabla 1 del artículo dice 6B, igual que Z-Image-Turbo). Bf16 en 3 fragmentos: 4.986.858.288 + 4.986.868.776 + 2.336.146.728 B (12,31 GB). Fichero úniconf2-bf16.safetensorsde 12.309.866.400 B.nf2-BF16.ggufynf2-F16.ggufde 12.311.939.136 B cada uno. - Niveles GGUF (GB): Q2_K_4XS 2,04, Q2_K_3XS 2,30, Q2_K_2XS 2,70, Q2_K_XS 3,00, Q2_K_S 3,30, Q2_K_M 3,60, Q2_K_L 4,01, Q3_K_S 4,36, Q3_K_M 4,56, Q3_K_L 4,60, Q4_0 4,59, Q4_K_S 4,79, Q4_1 4,85, Q4_K_M 5,07, Q5_0 5,26, Q5_K_S 5,29, Q5_1 5,53, Q5_K_M 5,58, Q6_K 6,10, Q8_0 7,22.
nf2-dedistill-lora.safetensors: 381.553.336 B.- Z-Image-Turbo sha
f332072a: codificador de texto Qwen3 en 3 fragmentos (unos 8,05 GB), VAE de 167.666.902 B, y su propio transformer de unos 24,6 GB (F32), que nuestro backend no descarga. Su ficha promete una latencia por debajo del segundo en una H800 y que entra en dispositivos de consumo de 16 GB. El ejemplo de diffusers de su ficha usanum_inference_steps=9("This actually results in 8 DiT forwards") yguidance_scale=0.0. - Receta de los autores (
inference.py, idéntico en main de GitHub): solo de 1 a 4 pasos, shift del scheduler {1: 3.0, 2: 6.0, 3: 8.0, 4: 9.0}, sigmas1 - i/steps, guía 0.0, escalas de LoRA {1: (0.0,), 2: (0.5, 0.0), 3: (0.5, 0.6, 0.0), 4: (0.5, 0.6, 0.7, 0.0)}, por defecto 1024 x 1024 y 2 pasos,pipe.enable_model_cpu_offload()en__main__. - Método: Text-Stream Adversarial Distillation (cabezas discriminadoras sobre los estados intermedios de los tokens de texto del MMDiT congelado) y Aspect-Cued Discrimination (el discriminador se condiciona con pistas de tipografía, objeto, estilo, fondo, acción y composición).
- Entrenamiento según el artículo: 100k referencias sintéticas de Z-Image-Turbo con 12 pasos (EN/CN), descripciones de Qwen3.5-35B-A3B, Adam lr 5e-5, batch 256, ocho H100, 20.000 pasos (5.000 off-policy, 15.000 on-policy). No hay código de entrenamiento en el repo.
- Limitaciones según el artículo: las escenas complejas siguen costando, sobre todo con un paso; menos diversidad entre muestras (la diversidad de OneIG queda por debajo de las dos referencias con 1 y 2 pasos); un efecto balancín entre las pistas de ACD.
Tabla 1 del artículo (cifras de los autores, no reproducidas por nosotros; el texto la llama tabla 2):
| Modelo | NFE | LongText-EN | LongText-CN | GenEval | DPG-Bench | OneIG |
|---|---|---|---|---|---|---|
| NitroFusion2 | 1 | 43,34 | 47,78 | 75,86 | 86,48 | 47,63 |
| Z-Image-Turbo | 1 | 11,72 | 12,70 | 57,08 | 77,23 | 32,43 |
| TwinFlow | 1 | 29,18 | 36,85 | 66,34 | 85,17 | 42,20 |
| NitroFusion2 | 2 | 76,03 | 81,95 | 74,46 | 86,21 | 51,45 |
| Z-Image-Turbo | 2 | 72,89 | 78,48 | 76,53 | 85,78 | 50,94 |
| Z-Image-Turbo++ (6B+6B) | 2 | 89,88 | 91,62 | 75,70 | 85,86 | 52,50 |
| Z-Image-Turbo | 8 | 91,74 | 92,56 | 75,01 | 84,86 | 52,84 |
Montaje y por qué
- GPU: una RTX 4090 en InferenceKey Cloud. La tarjeta se identificó como
NVIDIA GeForce RTX 4090, 49140 MiB(la variante de 48 GB), así que el workload principal se ejecutó conNF2_VRAM_LIMIT_GIB=23.4para hacer de tarjeta de 24 GB. No se usó ninguna tarjeta estándar de 24 GB. El pipeline bf16 necesita unos 22 GiB residentes, y por eso la referencia es un presupuesto de 24 GB. Después, una RTX 2000 Ada de 16 GB real (16.380 MiB, 70 W) para la comprobación con tarjeta pequeña. - Backend: un backend de Python personalizado nuevo,
NitroFusion2Backend0.1.0 (paquete de 5.600 B), sobreZImagePipelinede diffusers 0.42.1, con el transformer de NitroFusion2 y la LoRA como adaptadordedistill. Versiones fijadas: torch 2.14.1, transformers 5.21.0, accelerate 1.15.0, peft 0.21.2, gguf 0.19.0. Por qué personalizado: ningún backend integrado sirve el pipeline de Z-Image. Por qué diffusers: es el camino de los propios autores, y la 0.42.1 tiene el pipeline, el cargador de LoRA y el GGUF en un solo fichero para este transformer. - Modos de memoria (
NF2_MEMORY_MODE):gpu(todo residente),model(enable_model_cpu_offload, el valor por defecto del script de los autores),sequential. El valor por defectoautoeligegpusolo con al menos 23 GiB libres; si no,model. En una tarjeta de 16 GB, ponNF2_TRANSFORMER=nf2-Q4_K_M.ggufyNF2_MEMORY_MODE=gpude forma explícita, oautovuelve al offload y pierdes el camino de 4 s. - Stack: un manager local de InferenceKey, nats-proxy y worker compilados desde main
97aec23e. Producción sin tocar. - Campos de la petición (al estilo de imágenes de OpenAI):
prompt(obligatorio),size("1024x1024", lados de 256 a 2048, múltiplos de 16),seed,stepsonum_inference_steps(de 1 a 4, por defecto 2),dedistill(por defecto true),output_format(png,jpeg,webp). La guía siempre es 0. La respuesta añadeseconds,encode_seconds,vae_seconds,vram_peak_gibymemory_mode. Endpoint:POST /endpoint/<project>/nitrofusion2/v1/images/generations.
Paso a paso con el ejemplo del SDK
El ejemplo es el commit 1ca451bd de main de inferencekey-sdk: backend.py, publish.py, main.py, requirements.txt, README.md, .env.example.
cp .env.example .env    # INFERENCEKEY_SDK_TOKEN, INFERENCEKEY_API_KEY,
                        # INFERENCEKEY_PROJECT, IK_WORKER_ID (read by main.py)
# publish.py does not read .env: export these two in the shell
export INFERENCEKEY_TENANT_ID=<tenant-id>
export INFERENCEKEY_USER_TOKEN=<dashboard-session-token>
python publish.py       # packages backend.py into dist/ and uploads it to your tenant
IK_KEEP_ALIVE=1 python main.py
Sin INFERENCEKEY_TENANT_ID e INFERENCEKEY_USER_TOKEN, publish.py solo genera dist/*.tar.gz, imprime "upload the package from Dashboard -> Custom backends instead" y sale con 0. En ese caso, sube el fichero desde Dashboard -> Custom backends antes de ejecutar main.py, o ensure() no tendrá ningún backend que desplegar.
Para una tarjeta de 16 GB, añade a .env antes de main.py:
NF2_TRANSFORMER=nf2-Q4_K_M.gguf
NF2_MEMORY_MODE=gpu
main.py llama a ensure() para un workload fijo en IK_WORKER_ID con ready_timeout_secs: 2400, request_timeout_secs: 600 y el entorno NF2_*, espera con wait_until_ready(2400) y después hace tres llamadas a 1024 x 1024 con la semilla 42: el cartel con 1 paso, el menú con 1 paso y el menú con 2 pasos. Borra el workload al salir salvo con IK_KEEP_ALIVE=1. Disco: unos 21 GB de pesos (26 GB si además está el fichero Q4_K_M) más un venv de 5,5 GB.
Una petición suelta:
curl -s https://<api-host>/endpoint/<project>/nitrofusion2/v1/images/generations \
  -H "Authorization: Bearer $INFERENCEKEY_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"prompt": "a cat holding a sign that says hello world",
       "size": "1024x1024", "steps": 2, "seed": 42}'
Mediciones completas
Tiempo hasta listo:
- RTX 4090: "ready after 67 s" según el SDK. Venv 28 s (CPython 3.12.3), después
download 33.8s, load 4.4s, transformer bf16, memory mode gpu (budget 23.4 GiB), weights in VRAM 19.5 GiB. Caché de HF de unos 20 GB. - RTX 2000 Ada: "ready after 76 s".
download 28.4s, load 23.0s, transformer nf2-Q4_K_M.gguf, memory mode gpu (budget 15.5 GiB), weights in VRAM 12.7 GiB.
Por petición, 1024 x 1024, semilla 42, una cada vez. Tiempo de GPU medido en el backend con cuda.synchronize, ida y vuelta desde el cliente HTTP hasta el manager local.
| Tarjeta / configuración | Caso | GPU s | Ida y vuelta s | Codificador de texto s | VAE s | Pico de torch GiB |
|---|---|---|---|---|---|---|
| 4090 bf16 | cartel, 1 paso, primera llamada | 1,72 | 3,43 | 0,638 | 0,379 | 21,86 |
| 4090 bf16 | menú, 1 paso, x6 | de 0,780 a 0,816 | de 1,45 a 1,50 | de 0,05 a 0,064 | 0,149 | 21,86 |
| 4090 bf16 | menú, 2 pasos, x6 | de 1,318 a 1,330 | de 1,95 a 2,00 | unos 0,055 | 0,149 | 21,86 |
| 4090 bf16 | cartel/retrato/póster/manos, 2 pasos | de 1,312 a 1,326 | de 1,90 a 1,99 | 0,149 | 21,86 | |
| 4090 bf16 | retrato/póster/manos, 1 paso | 0,783 | de 1,47 a 1,52 | de 0,149 a 0,15 | 21,86 | |
| 4090 bf16 | menú, 2 pasos, sin LoRA | 1,341 | 2,01 | 21,86 | ||
| 4090 bf16 | menú, 4 pasos | 2,419 | 3,08 | 21,86 | ||
| RTX 2000 Ada, Q4_K_M | 1 paso (x5) | de 3,98 a 4,33 (5,16 la primera) | de 4,66 a 4,91 (7,06 la primera) | de 0,21 a 0,25 | de 0,57 a 0,60 | 15,11 |
| RTX 2000 Ada, Q4_K_M | 2 pasos (x5) | de 7,19 a 7,42 | de 7,83 a 8,32 | unos 0,21 | de 0,57 a 0,74 | 15,11 |
Derivado de lo anterior, peticiones sueltas, sin batching: de 1,2 a 1,3 imágenes por segundo de tiempo de GPU con 1 paso (de 0,67 a 0,69 por ida y vuelta) y unas 0,75 con 2 pasos (de 0,50 a 0,51 por ida y vuelta). El probador de imágenes del panel mostró "ok · 1098 ms" para el póster de 1 paso.
Escalera de VRAM. Los escalones emulados se ejecutaron en un proceso aparte en la 4090 de 48 GB con torch.cuda.set_per_process_memory_fraction, junto al workload en marcha, así que sus tiempos pueden incluir algo de contención. Cada escalón ejecutó el cartel y el menú con 1 y 2 pasos, dos veces, semilla 42.
| GPU o límite | Configuración | Pico de VRAM | Tiempo por imagen | Salida | Real o emulada |
|---|---|---|---|---|---|
| RTX 4090, límite de 23,4 GiB | bf16, todo en la GPU, a través de la plataforma | 21,86 GiB de torch | 0,78-0,82 s (1), 1,32-1,33 s (2) | bien, referencia | tarjeta real con límite |
| 15,2 GiB | bf16 + enable_model_cpu_offload | 12,30 GiB / 13.122 MiB | 14,2-19,4 s | bien, mismas imágenes | emulada |
| 15,2 GiB | GGUF Q8_0, todo en la GPU | CUDA out of memory. Tried to allocate 80.00 MiB ... 15.20 GiB allowed en la primera petición (preparación de 37,3 s) | emulada | ||
| 15,2 GiB | GGUF Q4_K_M, todo en la GPU | 15,11 GiB / 16.008 MiB | 0,95-1,03 s (1), 1,64-1,71 s (2) | bien, mismo texto que bf16 | emulada |
| RTX 2000 Ada 16 GB | GGUF Q4_K_M, todo en la GPU, a través de la plataforma | 15,11 GiB / 15.948 MiB de la tarjeta | 3,98-4,33 s (1), 7,19-7,42 s (2) | bien | real |
| 11,2 GiB | Q4_K_M + offload del modelo | 7,69 GiB / 8.366 MiB | 7,5-10,5 s | bien, mismo texto | emulada |
| 7,2 GiB | Q4_K_M + offload del modelo | Tried to allocate 48.00 MiB ... 7.20 GiB allowed (el codificador de texto bf16 solo, unos 7,5 GiB) | emulada | ||
| 7,2 GiB | Q4_K_M + offload secuencial | la preparación falló: KeyError: None | emulada |
Sin probar: un codificador de texto cuantizado o en CPU para 8 GB; resoluciones distintas de 1024; las versiones de la comunidad para ComfyUI en int8, W6A8 y W4A8; batches de más de 1 y concurrencia; tarjetas reales de 12 GB y tarjetas estándar de 24 GB (no había ninguna tarjeta de 10 a 12 GB disponible); los niveles GGUF Q2, Q3, Q5 y Q6; Q8_0 con offload o en una tarjeta de 24 GB; Z-Image-Turbo con 8 pasos.
Notas de calidad (una semilla por caso, no es un benchmark)
Prompts: el cartel del gato y el retrato de los autores, más cuatro nuestros (un menú de cafetería en pizarra, un póster del tranvía de Lisboa, una partitura sobre un piano y un par de manos).
- Cartel (prompt de los autores "a cat holding a sign that says hello world"): en la 4090, 1 paso "HELLO WORd" (falta la L, d minúscula, H borrosa), 2 pasos "Hello World". Los escalones Q4 en la 4090 dieron el mismo texto que bf16. RTX 2000 Ada con Q4: 1 paso "HELLO WORLD", 2 pasos bien.
- Menú ("FLAT WHITE 3.20 / CROISSANT 2.80 / SOURDOUGH 4.50"): "SOURDOAGH" con 1, 2 y 4 pasos y con 2 sin LoRA en la 4090. RTX 2000 Ada con 1 paso: "CROSSANT" y un "0" suelto debajo de 4.50; con 2 pasos, "SOURDOAGH".
- Póster: "LISBOA" y "Tram 28 - every 12 minutes" bien con 1 y 2 pasos y en la tarjeta de 16 GB.
- Piano: el título "Nocturne No. 2 in E-flat" ilegible con 1 paso, aún imperfecto con 2. Manos creíbles.
- Retrato (prompt de los autores): limpio con 1 y 2 pasos.
Vídeo de la demo
Un recorrido narrado de 3 minutos: qué es NitroFusion2 (con la página del proyecto, las figuras y la tabla 1 de los autores, con su crédito), el panel generando con 1 y 2 pasos, y la escalera de memoria.
Problemas pendientes
- La 4090 era una variante de 48 GB. El resultado de 24 GB es un límite (
NF2_VRAM_LIMIT_GIB=23.4), no una tarjeta estándar de 24 GB. Estado: indicado, sin repetir en una tarjeta de 24 GB. - Valores por defecto del probador de imágenes (20 pasos, guía 4,5): devuelven un 400
NitroFusion2 is distilled for 1 to 4 steps. Estado: documentado en el README, valores por defecto de la plataforma sin cambiar. - Q8_0 no entra en 16 GB con el codificador de texto bf16 residente. Estado: usar Q4_K_M.
- 8 GB falla: OOM con offload del modelo,
KeyError: Nonecon offload secuencial y un transformer GGUF. Estado: abierto, sin probar con un codificador de texto más pequeño. - Errores de texto con un paso, y una errata ("SOURDOAGH") con todos los números de pasos. Estado: comportamiento del modelo, coincide con la carencia en el renderizado de texto que reconoce el artículo.
- Menor: nuestro primer SQL de siembra para el tenant de prueba local afectó por error al tenant por defecto sembrado; se corrigió antes de reiniciar el manager, sin efecto en la prueba. En el stderr del backend aparece un
RuntimeWarninginofensivo sobreinferencekey.backend.serveensys.modules.
Fuentes
- Ficha del modelo: https://huggingface.co/ChenDY/NitroFusion2
- Código e
inference.py: https://github.com/ChenDarYen/NitroFusion2 - Artículo: https://arxiv.org/abs/2611.05648
- Página del proyecto: https://chendaryen.github.io/NitroFusion2.github.io/
- Modelo base: https://huggingface.co/Tongyi-MAI/Z-Image-Turbo
- Dónde lo vimos: https://www.youtube.com/watch?v=9RIK3A24ZxA (AI Search, 2026-11-08, en el 03:50)
- Ejemplo del SDK: https://github.com/inferencekey/inferencekey-sdk/tree/main/examples/nitrofusion2-text2image-custom-backend-private-nvidia