SenseNova Code2Video en una RTX 4090: un borrador en 10 minutos, un hueco en cada fila y ninguna película terminada
Un 27B que hace vídeo escribiendo código funcionó en Claude Code en una tarjeta de 24 GB: un borrador con un error de composición y ningún vídeo terminado.
Para hacer un vídeo explicativo no hace falta un modelo de vídeo. Un modelo de texto puede escribir una página web que dibuje cada fotograma, renderizarla, mirar los fotogramas y corregir lo que ve. Eso hace SenseNova 6.8 Code2Video, el modelo abierto de 27B de SenseTime. Manejado por Claude Code, funcionó en una sola RTX 4090 de 24 GB. A los diez minutos tenía un clip completo de 12 segundos que pasaba su comprobación automática del fichero. La imagen estaba mal: los puntos que debían formar un rectángulo de 5 por 6 quedaron en 5 filas de 7, con un hueco en cada fila. Después se llenó su memoria de trabajo, todo lo que había leído y escrito. Claude Code pasó 21 minutos intentando resumirla, chocó cada vez con nuestro límite de longitud de respuesta y nunca terminó. El modelo entra en una tarjeta gaming, y nuestro ejemplo del SDK repite el montaje.
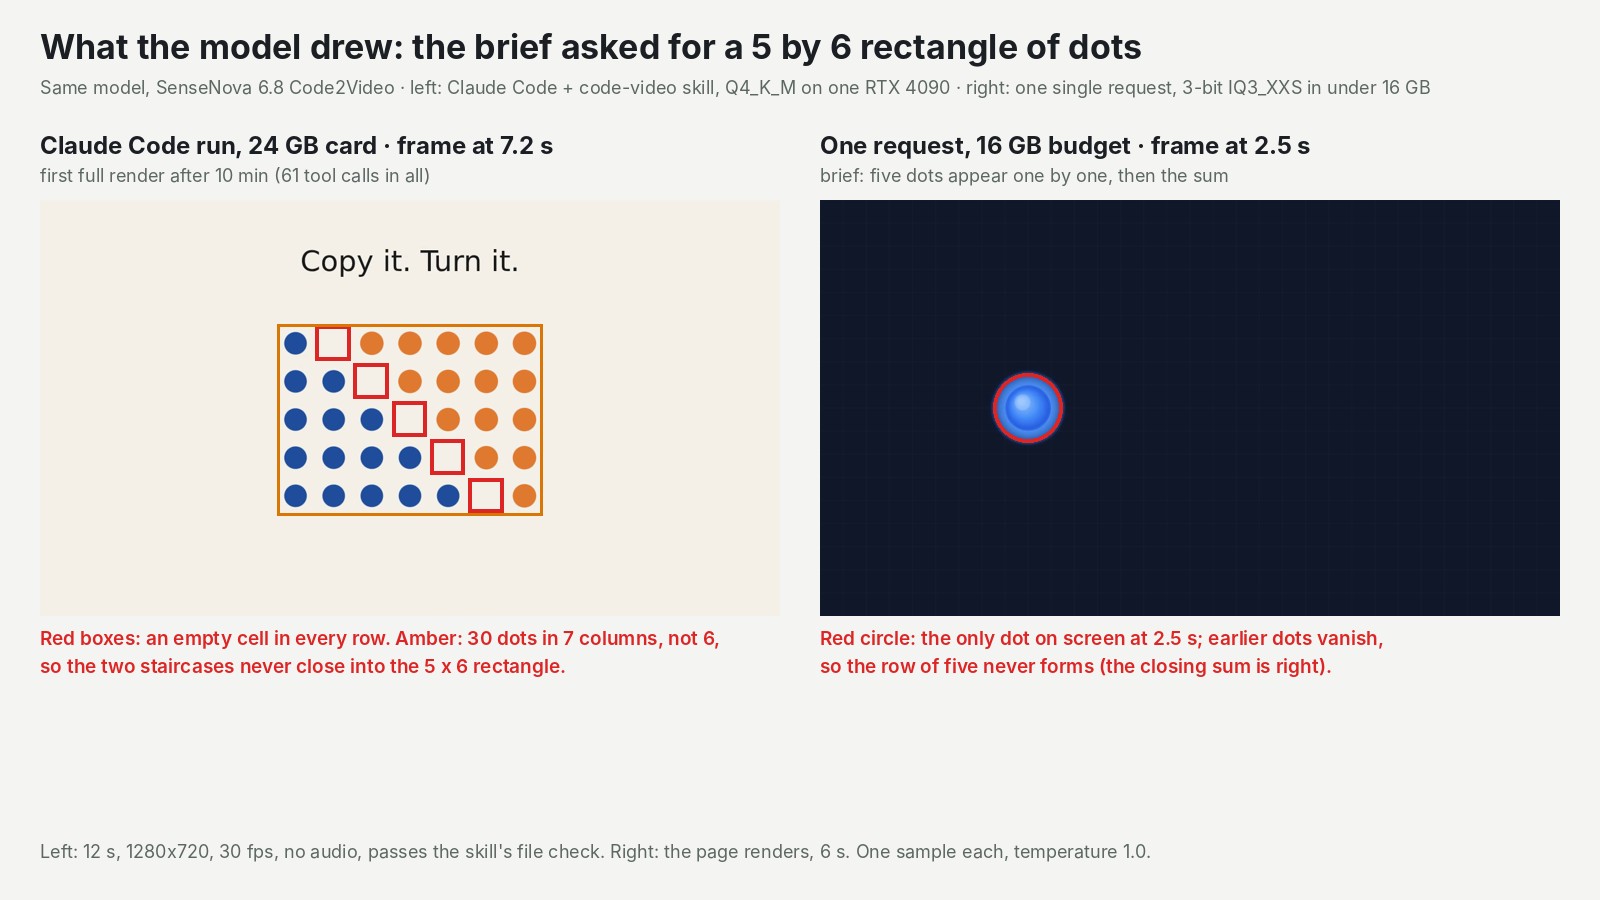
| Tiempo de GPU en una RTX 4090 | Primer renderizado completo de 12 s | Copia más pequeña cuya página se renderiza |
|---|---|---|
| Ocupada escribiendo salida 32 de los 40 minutos | Un borrador, un error de composición | Una copia más pequeña de 3 bits llegó a un pico de 13,7 GiB en la 4090, por debajo de 16 GB (la página se renderiza con un fallo) |
Un vídeo hecho de código: el modelo escribe un programa, lo renderiza y revisa los fotogramas
SenseNova 6.8 Code2Video no pinta píxeles. Sus autores lo llaman "a lightweight open model for code-driven video creation" que "builds and renders videos by generating executable code". Un clip es una página web en la que cada instante tiene exactamente una imagen. Un navegador sin ventana recorre esa página fotograma a fotograma, y una herramienta de vídeo estándar une los fotogramas en un MP4.
Por diseño, cada elemento en pantalla es código, así que puedes cambiar una etiqueta o un color y volver a renderizar. El texto sale escrito exactamente como se pidió, porque se teclea, no se dibuja. Y el "modelo de vídeo" es un modelo normal de texto e imagen. Lo sirves con los mismos servidores de código abierto que ya usas para los modelos de chat.
SenseTime publicó el modelo con una licencia abierta, junto con una skill de Claude Code (un paquete de instrucciones y scripts) llamada code-video. La skill enseña el ciclo: planificar, escribir la página, renderizar fotogramas fijos y mirarlos "at least twice". Después, renderizar el vídeo, pasar una comprobación del fichero y escribir una nota de verificación. Su mejor consejo cabe en una línea: "Get a rough full-length render early (even ugly), then improve it."
También publicaron seis producciones completas. Cada vídeo llevó de 261 a 876 rondas en las que el modelo escribe, ejecuta y comprueba, y de 37 a 99 fotogramas revisados. La ficha del modelo dice que "sustains runs of more than 10 hours and more than 2,000 turns"; no lo hemos comprobado. Los autores ejecutan el modelo a tamaño completo en cuatro GPU, con una memoria de trabajo cinco veces mayor que la que usamos nosotros (512K tokens). También son francos: sin benchmark, "clearly behind the strongest proprietary models on visual polish and long-horizon reliability", y sin imágenes fotorrealistas.
Así que la pregunta que llevamos a la prueba era más pequeña que la suya. ¿Puede una copia comprimida, de un tercio del tamaño, terminar un clip corto en una sola tarjeta de 24 GB, y en cuántos turnos y minutos? No encontramos ninguna ejecución publicada que lo responda.
Nuestra prueba: un encargo de 12 segundos, una tarjeta de 24 GB y un tope de 40 minutos
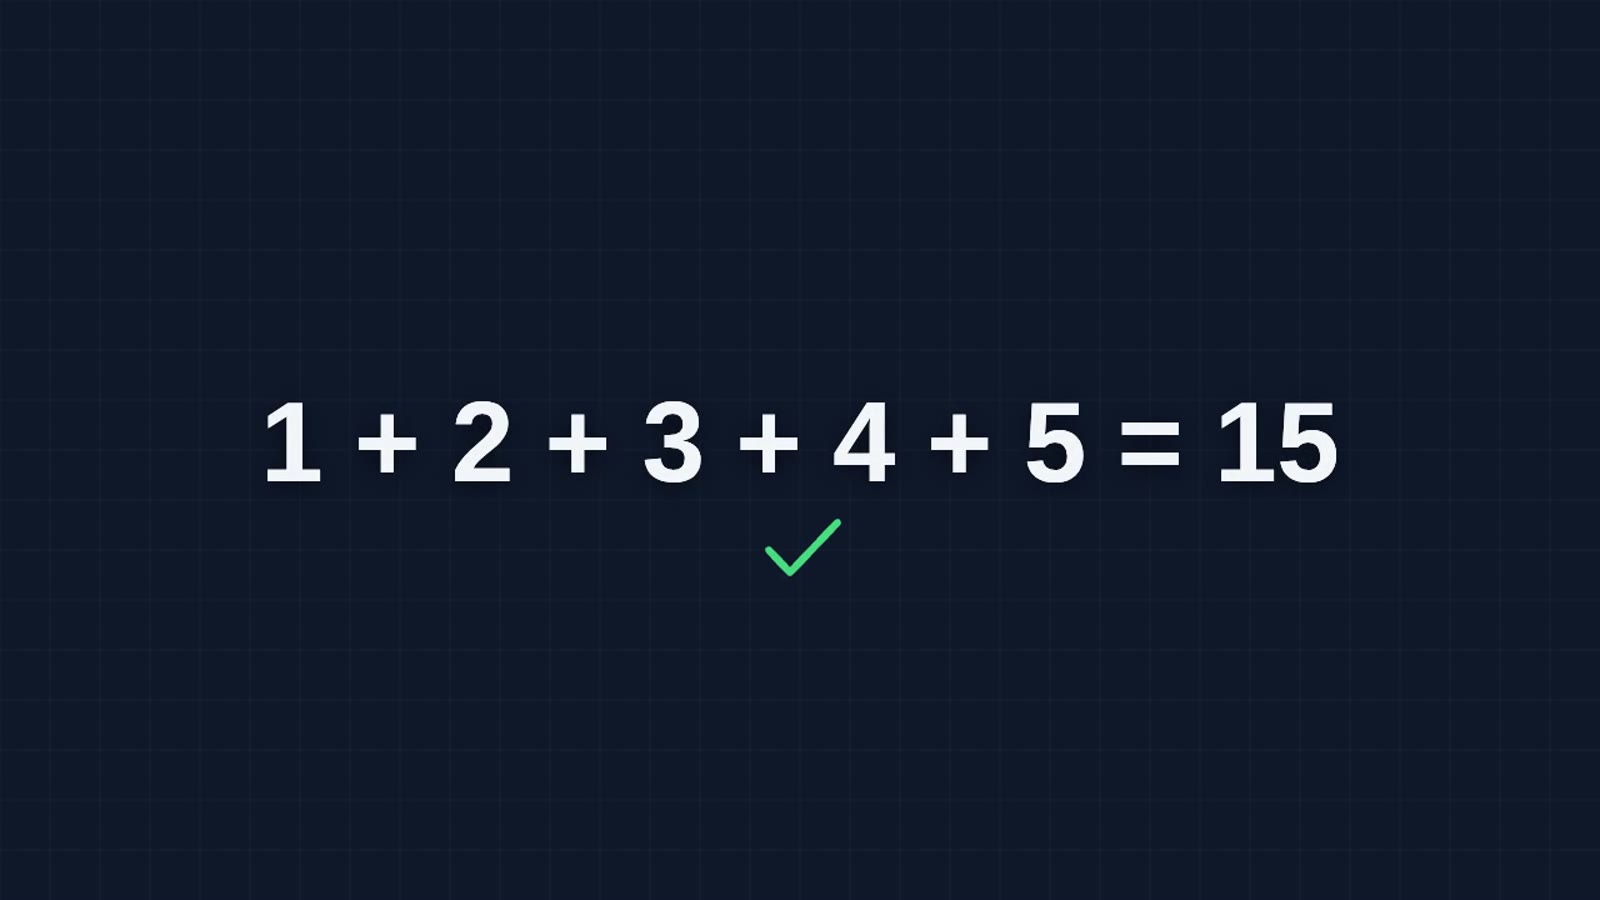
El encargo era un vídeo explicativo mudo de 12 segundos llamado "Half a Rectangle". Muestra 1 + 2 + 3 + 4 + 5 = 15 como una escalera de puntos azules. Después copia la escalera en naranja, gira la copia y cierra las dos en un rectángulo de 5 por 6 con 30 puntos. La mitad de 30 es 15. Es un encargo pequeño con un dato que tiene que salir bien.
El primer paso de los autores es convertir una idea corta en un encargo denso y detallado con un modelo generalista potente. Ellos usan Claude Opus 5.5, y nosotros también, con su plantilla. Fue el único modelo cerrado de nuestra cadena. El encargo de 898 palabras pasó después a SenseNova dentro de Claude Code, que funcionó sin supervisión en un entorno aislado y con la skill sin cambios. Todas las llamadas al modelo fueron a la RTX 4090 de nuestra nube.
El modelo se ejecutó desde la copia comprimida de bartowski (4 bits, 17,2 GB) más una parte de visión de 0,93 GB, para que pudiera ver sus fotogramas. Le dimos a Claude Code una memoria de trabajo de 98.304 tokens en lugar de los 512K de los autores, un tope de 16.384 tokens por respuesta en lugar de 64K, 120 turnos y 40 minutos. Esos límites son nuestros, marcados por una tarjeta y una mañana. Sin audio.
Un renderizado completo de borrador, con siete columnas donde el encargo pedía seis
El modelo leyó la skill y el encargo, y escribió su plan a los 5 minutos. Dibujó sus primeros fotogramas fijos a los 6 minutos. A los 10 minutos tenía renderizados los 12 segundos completos: 1280 por 720, 30 fotogramas por segundo, 360 fotogramas. Fue un intento con un encargo, y las respuestas del modelo varían a propósito, así que un segundo intento podría salir mejor o peor.
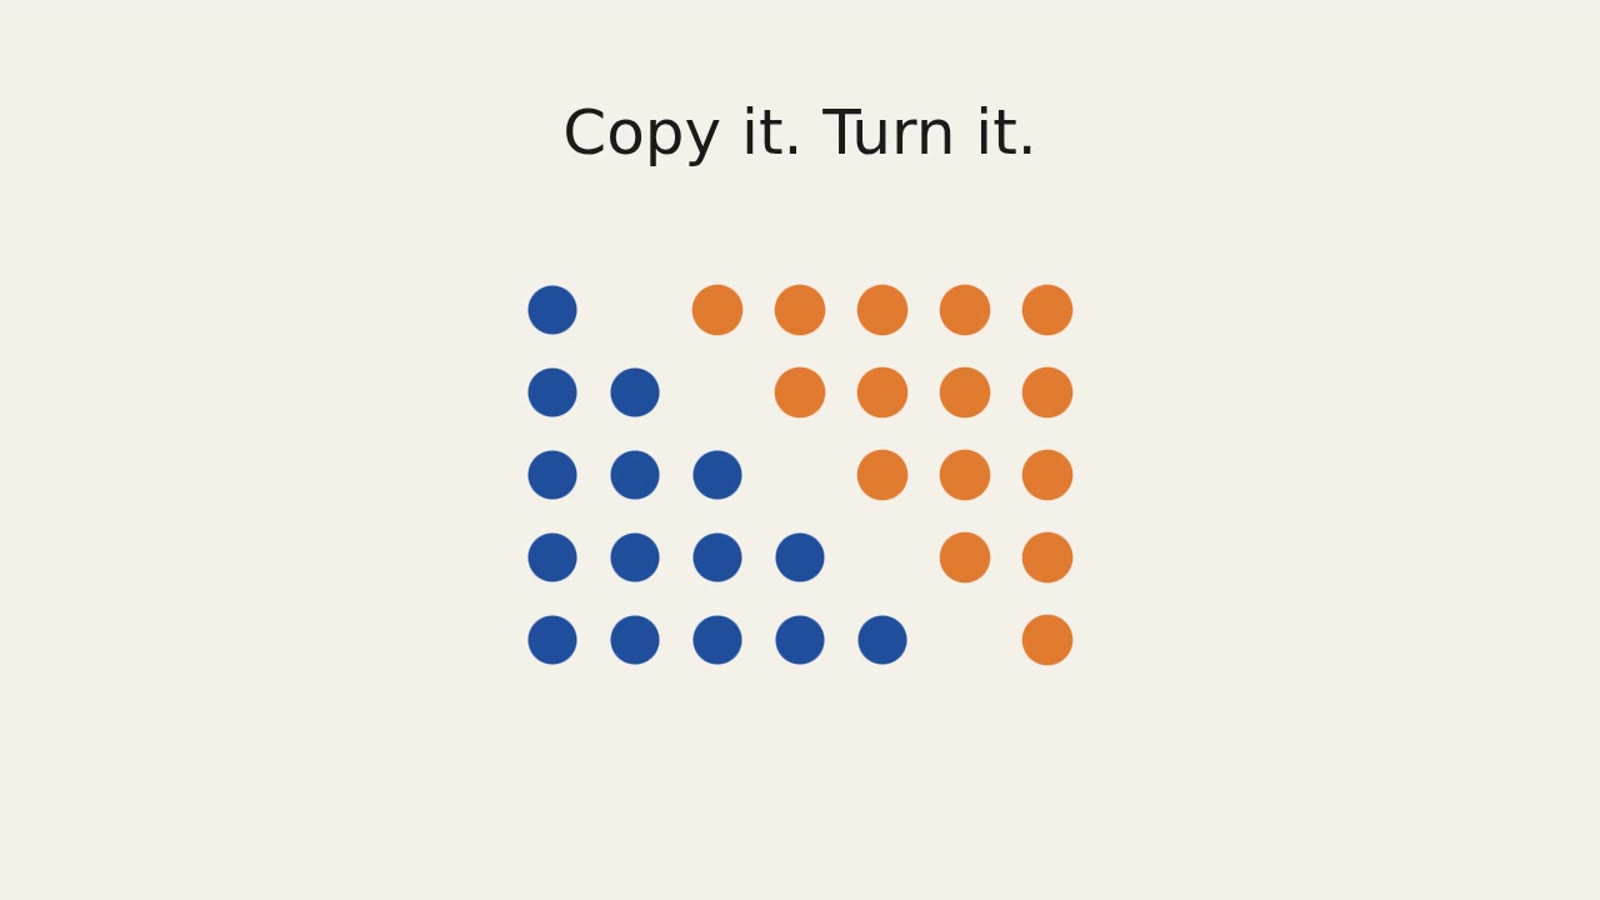
El ciclo funcionó como lo describen los autores. El modelo leyó 21 de sus propios fotogramas como imágenes y actuó según lo que vio. Vio que los puntos naranjas caían en la esquina superior izquierda, lo atribuyó a un desplazamiento aplicado dos veces y lo corrigió. Después vio que sus bandas de resaltado tapaban las líneas de la cuadrícula y corrigió el orden de dibujo. El movimiento es limpio y cada palabra en pantalla está escrita exactamente como en el encargo.
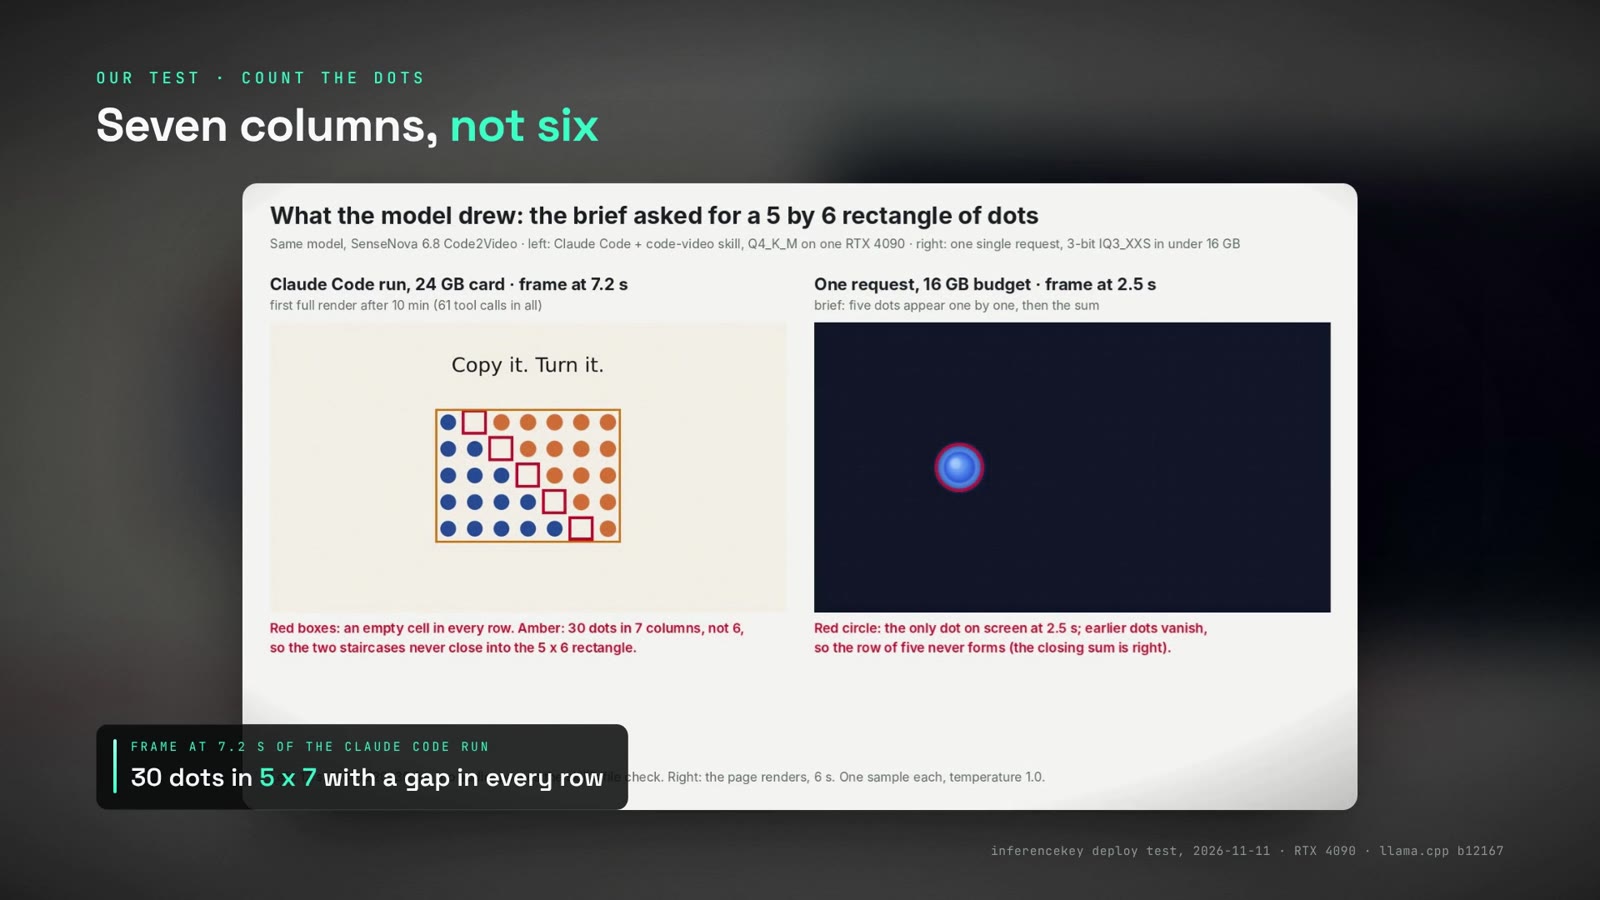
Aun así, la imagen rompe el único dato que importa. Medimos los centros de los puntos en el segundo 7,2: 30 puntos en 7 columnas por 5 filas, cada fila "azul, una celda vacía, naranja". El rótulo dice "5 rows × 6 columns = 30", y la cuadrícula de 6 columnas dibujada detrás de los puntos deja fuera la séptima columna. La comprobación del fichero pasó igualmente. Comprueba resolución, fotogramas por segundo y duración, no la imagen.
El coste, entonces: un borrador en 10 minutos; la ejecución completa de 40 minutos se llevó 61 llamadas a herramientas y unos 78.000 tokens escritos, y lo que costaría un clip terminado no se sabe porque la ejecución no terminó.
Los últimos 21 minutos se fueron en que Claude Code resumiera su propia memoria
Imagina la memoria de trabajo como una mesa: cada fichero leído, cada fotograma revisado y cada línea escrita se quedan encima. Cuando la mesa está llena al 80 %, Claude Code pide al modelo que resuma el trabajo hecho, despeja la mesa y se queda solo con el resumen.
Nuestra mesa tenía sitio para 98.304 tokens. Se llenó tras unos 19 minutos de trabajo. Claude Code pidió un resumen tres veces. Cada vez el modelo escribió hasta chocar con el tope de 16.384 tokens por respuesta, y el resumen nunca volvió en condiciones de usarse. Esos tres intentos se llevaron 21 minutos, hasta que el límite de 40 minutos lo paró todo sin vídeo final y sin nota de verificación.
En cuatro de las seis ejecuciones de los autores, Claude Code despejó una mesa de 167K a 492K tokens, con un tope de respuesta de 64K. Los sospechosos probables son nuestros ajustes: el tope de 16.384 tokens por respuesta y el razonamiento oculto del modelo, que dejamos activado y que gasta ese tope. Nuestros registros no dicen cuál de los dos.
Qué GPU: con 24 GB funcionó el agente, las copias más pequeñas solo respondieron a una petición
Ejecutamos el agente en una 4090 real de 24 GB. Sin ninguna tarjeta de 16 GB disponible, probamos copias más pequeñas en la 4090 y vigilamos su pico de memoria. Cada una recibió una petición corta para una página de animación de 6 segundos (con tope de 8.192 tokens, un encargo más pequeño que el del agente) y una imagen de 15 puntos para describir.
| Tarjeta o presupuesto | Copia y memoria de trabajo | Pico de memoria de la tarjeta | Velocidad | Resultado | ¿Tarjeta real? |
|---|---|---|---|---|---|
| RTX 4090 24 GB | 4 bits, 98K tokens, ejecución de Claude Code | 20,9 GiB | de 39 a 48 tokens/s | ejecución de Claude Code, ver arriba | sí |
| RTX 4090 24 GB | 4 bits, 32K tokens, una petición | 18,8 GiB | 47,6 tokens/s | imagen bien, página nunca escrita: los 8.192 tokens se fueron en razonamiento oculto | sí |
| Presupuesto de 16 GB | 3 bits, 32K tokens, una petición | 13,7 GiB | 63,5 tokens/s | imagen bien, la página se renderiza, pero solo se ve un punto cada vez | no, ejecutado en la 4090 |
| Presupuesto de 12 GB | 2 bits, 16K tokens, una petición | 10,0 GiB | 78,7 tokens/s | imagen bien, página cortada a los 8.192 tokens | no, ejecutado en la 4090 |
Una muestra de cada uno dice poco, y la petición de 4 bits no escribió código, así que no hay una comparación en igualdad de condiciones.
En InferenceKey: listo en 25 segundos, el arreglo de imágenes aún sin desplegar
En una máquina recién creada con los ficheros en disco, el modelo respondió 25,2 segundos después de pedirlo, y Claude Code le habla como a la API de Anthropic. Apuntar Claude Code a la 4090 llevó una URL, un nombre de modelo y unos pocos ajustes de contexto. Por nuestra parte hicieron falta dos cambios: un arreglo de imágenes y un tiempo de espera de 30 minutos por petición, para que las respuestas largas no se cortaran a los 2 minutos. No cambió nada de la skill de los autores.
El problema con el que te vas a encontrar: cuando Claude Code enviaba un fotograma, nuestra plataforma descartaba la imagen o la pasaba como texto. Estado: arreglado en nuestra compilación de prueba, aún no en el servicio alojado, donde los fotogramas siguen llegando a ciegas.
Esta ejecución usó una copia local de la plataforma, no el servicio alojado. Los fallos menores (un tiempo de espera, un reinicio de máquina, un reintento de subida) están en el apéndice con su estado.
¿Deberías usarlo? Vale la pena probarlo para borradores cortos en una tarjeta de 24 GB, si revisas cada fotograma
- Quieres vídeos explicativos y animaciones con texto exacto: vale la pena probarlo en una tarjeta de 24 GB.
- Necesitas que la imagen salga bien a la primera: revisa tú cada fotograma.
- Quieres un vídeo terminado sin supervisión: cuenta con horas y mucha más memoria de trabajo, como hacen los autores. Nuestra ejecución de 40 minutos no terminó.
- Tienes una tarjeta de 16 GB: la copia de 3 bits entra sobre el papel, no se ha probado como agente y su única muestra tenía un fallo.
Para hacer tu propio clip, ejecuta python main.py desde el ejemplo del SDK de SenseNova Code2Video en una tarjeta de 24 GB alquilada en nuestra nube; los pasos de montaje están en el apéndice, y su paso con Claude Code solo ve los fotogramas cuando se publique el arreglo de imágenes.
Para ingenieros
Créditos
- SenseTime (equipo SenseNova): el modelo (Apache-2.0), ajustado a partir de Qwen3.8-27B según su ficha; la ficha del modelo con recetas para vLLM, SGLang y LightLLM; seis trayectorias de producción publicadas; la skill
code-video, la plantilla de prompt y los vídeos (el repo de GitHub no indica licencia). - El equipo de Qwen: el modelo base que nombran los autores.
- bartowski: las cuantizaciones GGUF que ejecutamos (Q4_K_M, IQ3_XXS, IQ2_XXS, mmproj bf16), hechas con llama.cpp b11969 y una imatrix.
- Los mantenedores de llama.cpp: la versión b12167 con el tarball precompilado de CUDA 13.4, el soporte multimodal y el parseo de llamadas a herramientas con
--jinja. - Anthropic: Claude Code, el arnés que recomiendan los autores, y Claude Opus 5.5, que escribió nuestro encargo detallado a partir de la plantilla de los autores.
- AI Search: donde lo vimos (vídeo de noticias del 2026-11-01, capítulo en el 39:53).
- Nuestra parte: el despliegue a través de la plataforma, el arreglo de imágenes en nuestra traducción de
/v1/messages, la ejecución de Claude Code en un entorno aislado, la comprobación por píxeles de su salida, la escalera de memoria, el ejemplo del SDK y el vídeo de la demo.
Modelo y ficheros
sensenova/SenseNova-6.8-Code2Video: sha0f99ab03, creado el 2026-10-24, modificado por última vez el 2026-11-03, sin restricción de acceso, Apache-2.0,pipeline_tagimage-text-to-text, idiomas en y zh. Publicado a finales de octubre; ficha actualizada por última vez el 2026-11-03.- 27.356.728.560 parámetros en BF16 (12 fragmentos, unos 54,7 GB).
Qwen3_5ForConditionalGeneration: 64 capas confull_attention_interval4 (16 capas de atención completa, 48 de atención lineal), 4 cabezas KV x head_dim 256, hidden 5120, torre de visión de profundidad 27, 1 capa MTP.max_position_embeddings262.144 con factor yarn 2.0 (de ahí los 512K). - Configuración de generación: temperature 1.0, top_k 20, top_p 0.95, muestreo activado.
- GGUF de bartowski
0ef7c7e3: bf16 53,81 GB, Q8_0 28,67, Q6_K 23,62, Q5_K_M 20,68, Q4_K_M 17,20 (marcado como predeterminado), IQ3_XXS 12,08, IQ2_XXS 8,64; mmproj bf16 0,93 GB y f16. Otras cuantizaciones de la comunidad que aparecen en la ficha: OliviaRossi GSQ-RCO-GGUF, Abiray MTP-GGUF, BennyDaBall NVFP4-GGUF, Hayabala EXL3. - Binario del backend: el llama.cpp precompilado para NVIDIA, así que no hubo que compilar nada.
- Caché KV en q8_0: 16 capas x 4 cabezas x 256 x 2 x 1 B = 32 KiB por token, así que 96K son unos 3 GiB (coincidió con el pico medido) y 512K serían unos 16 GiB.
- Ajustes del arnés de los autores:
CLAUDE_CODE_MAX_CONTEXT_TOKENS=524288,CLAUDE_AUTOCOMPACT_PCT_OVERRIDE=80, salida máxima de 64K,--max-turns2000 o más, tiempo de espera de 10 h o más. Si no, Claude Code trata un modelo desconocido como uno de 200K. La ficha de HF diceCLAUDE_CODE_MAX_OUTPUT_TOKENS=64000, el README de GitHub 65536. La ficha habla de ejecuciones de más de 2.000 turnos; la sección de pesos del README dice "over a thousand". No hemos verificado ninguna de las dos cifras. - Trayectorias de los autores (
trajectories/all.openai.jsonl, razonamiento activado): fourier_light_painting 675 turnos del asistente y 99 imágenes revisadas, forest_landslide 445 y 47, signal_noise_shape 713 y 51, cmyk_halftone 261 y 37, geometry_risograph 521 y 67, frame_form_flow 876 y 69. Compactación: fourier 2 veces, de unos 492K a 13-16K; signal_noise_shape 1 vez, de 491K a 14K; risograph 4 veces, de unos 167-172K a 10-15K; frame_form_flow 7 veces, de unos 167-173K a 6-13K; forest_landslide usó 2 reanudaciones; cmyk_halftone no tiene ningún límite de contexto. Las cifras de 6-16K son todo el contexto que queda tras la compactación (postTokens), no la longitud del resumen. - Entorno de la skill: Claude Code, Node.js 18+, Python 3, ffmpeg/ffprobe, fuentes, Playwright Chromium;
requirements.txtnumpy, scipy, soundfile, librosa, edge-tts, faster-whisper. HEAD de GitHub776ae798, un único commit con fecha del 2026-10-26.
Montaje
- GPU en InferenceKey Cloud: una RTX 4090 de 24 GB (24.564 MiB, 450 W, compute capability 8.9, driver 595.91.07).
- Backend: el backend integrado
llamacppconINFERENCEKEY_LLAMACPP_TAG=b12167eINFERENCEKEY_LLAMACPP_ASSET=ubuntu-cuda-13.4-x64. Por qué llama.cpp: las recetas de la ficha son vLLM, SGLang y LightLLM en BF16 con paralelismo de tensores 4 y contexto de 512K (unos 54,7 GB solo de pesos). El GGUF de 17,2 GB es lo que entra en una tarjeta de consumo. - Un manager local de InferenceKey compilado desde nuestra rama main, con el parche de imágenes. Producción sin tocar.
- Claude Code 2.1.322 sin interfaz en un entorno aislado de Docker (Ubuntu 24.04, ffmpeg, Node 24, Playwright 1.56.1 Chromium, fuentes Noto y DejaVu,
--memory 8g --cpus 6), con solo la carpeta de la tarea y un HOME nuevo montados, y la clave de API pasada por variable de entorno. - Manifiesto del worker:
INFERENCEKEY_BACKEND_REQUEST_TIMEOUT_SECS=1800(120 s por defecto); no probamos la ejecución sin él. - Ajustes de Claude Code:
CLAUDE_CODE_MAX_CONTEXT_TOKENS=98304,CLAUDE_AUTOCOMPACT_PCT_OVERRIDE=80,CLAUDE_CODE_MAX_OUTPUT_TOKENS=16384,CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1, el modelo pequeño apuntando al mismo slug. Claude Code mostró[claude-code:unrecognized_model], sin consecuencias. - Encargo: "Half a Rectangle", 12 s, 1280x720, 30 fps, mudo, 898 palabras, escrito por Claude Opus 5.5 a partir de
prompts/enhance_prompt.md. Prompt: el prompt de la fase 2 de los autores más una frase con el límite de 40 minutos.
El comando de arranque que ejecuta el backend:
INFERENCEKEY_LLAMACPP_TAG=b12167 \
INFERENCEKEY_LLAMACPP_ASSET=ubuntu-cuda-13.4-x64 \
llama-server \
  -hf bartowski/sensenova_SenseNova-6.8-Code2Video-GGUF \
  --hf-file sensenova_SenseNova-6.8-Code2Video-Q4_K_M.gguf \
  --mmproj-url <bf16 mmproj URL> \
  --alias sensenova-code2video -ngl 99 -fa on \
  -c 98304 -ctk q8_0 -ctv q8_0 \
  --jinja --reasoning-format deepseek \
  --temp 1.0 --top-k 20 --top-p 0.95 \
  -np 1 --cache-reuse 256
La cadena COMMAND exacta, con la URL del mmproj, está en el main.py del ejemplo.
Paso a paso con el ejemplo del SDK
- Clona inferencekey-sdk y abre
examples/sensenova-code2video-27b-claude-code-llamacpp-private-nvidia(commitd352b7b5e83921cbc9fd28c4f0b9054ee9e2cb23). cp .env.example .envy rellenaINFERENCEKEY_SDK_TOKEN,INFERENCEKEY_API_KEY,INFERENCEKEY_PROJECTeIK_WORKER_ID(un worker NVIDIA privado con 24 GB). Opcional:C2V_CONTEXT(98304),C2V_KV_TYPE(q8_0). Para una tarjeta de 16 GB:C2V_GGUF_FILE=sensenova_SenseNova-6.8-Code2Video-IQ3_XXS.ggufyC2V_CONTEXT=32768(sin probar en una tarjeta real de 16 GB).pip install -r requirements.txtmás el binding local de Pythoninferencekeycompilado con maturin (no está en PyPI).IK_KEEP_ALIVE=1 python main.py: haceensure()de un workloadllamacppfijo asignado a tu worker,wait_until_ready(3600)y después una llamada en streaming a/v1/messagesque pide una páginawindow.seek(t)de 6 s; guardaoutputs/clip.htmlyoutputs/answer.json. SinIK_KEEP_ALIVE=1llama adelete()al final.cp claude-settings.example.json claude-settings.jsony pon el slug de tu proyecto enANTHROPIC_BASE_URL(https://cloud.inferencekey.com/endpoint/<project>/sensenova-code2video).ANTHROPIC_MODELtiene que ser el slug del workloadsensenova-code2video(odefault); si no, el endpoint devuelve 400.API_TIMEOUT_MSes 1800000.- En la carpeta de la tarea ejecuta
npm install playwright && npx playwright install chromium(elcapture.mjsde la skill carga Playwright desde ahí, así que una instalación global no basta), pon tu encargo detallado en<task>/dense_prompt.mdy ejecuta./run_claude_code.sh <task>. Copia la skill de los autores en la tarea y después ejecutaclaude -p --settings ... --max-turns 150 --permission-mode acceptEdits --allowedTools "Bash,Read,Write,Edit,Glob,Grep,Skill"con un tiempo de espera de 60 minutos (C2V_MAX_TURNS,C2V_MINUTES). Ejecútalo en una carpeta o un contenedor aislados: el agente ejecuta comandos de shell sin preguntar.
El camino en streaming del ejemplo no se ejecutó de principio a fin antes de liberar la GPU. La misma forma de petición funcionó en nuestra prueba de imágenes.
Tiempos
| Paso | Tiempo |
|---|---|
De ensure() a listo, worker recién creado | 25,2 s |
| Instalación del tarball de llama.cpp | alrededor de 1 s |
| Descarga previa del GGUF y del mmproj (fuera del camino hasta listo) | 26 s y 3 s |
Del arranque de Claude Code a SPEC.md | 5 min (07:08 UTC) |
| Primeros fotogramas fijos | de 07:09 a 07:12 |
Renderizado completo de 12 s out/v1.mp4 | 10 min (07:13) |
| Medición de los centroides de los puntos con numpy y scipy | de 07:14 a 07:16; llamada a herramienta número 61 a las 07:16:44 |
| Una petición larga | de 07:17 a 07:21 aproximadamente, liberada en 78.416 tokens |
| Tres peticiones de compactación | de 07:21:50 a 07:42:40, cada una liberada en n_tokens 82.969 |
| Tiempo de espera agotado | 07:43:04 |
Decodificación: 47,7 tokens/s con contexto nuevo, 44,5 a unos 30K, 39,4 a unos 66K; 78.039 tokens en 1.915 s (40,8 de media); prefill de 75 s en 44 peticiones, con solo 5 prefills de más de 8K tokens. La decodificación fue cerca del 96 % del tiempo de GPU. Pico de VRAM de 21.425 MiB en la ejecución y 21.729 MiB en toda la sesión de GPU. Llamadas a herramientas: Bash 29, Read 26 (21 imágenes), Edit 4, Write 2. El último evento del stream tiene estado compacting.
Comprobación de la salida v1.mp4: check_video.sh pasó (1280x720, 30,000 fps, 360 fotogramas, 12,000 s, h264 yuv420p, sin pista de audio, aviso por una pausa final congelada de 2,1 s hecha a propósito). En t = 7,2 s, 30 centros de puntos en 7 columnas (x de 441 a 837, separación de 66 px) por 5 filas (y de 247 a 512), cada fila con k azules, una celda vacía y 6-k naranjas. En t = 11,5 s, "30 ÷ 2 = 15" se lee, pero la guía de 6 columnas deja fuera la séptima. Todo el texto en pantalla coincide con el encargo. Las notas del propio modelo durante la ejecución: "B's final placement is off (dots land top-left), the settle term double-counts the translation", después un arreglo del orden de dibujo de la banda de la cuadrícula y, al final de la ejecución, "My snap origin was wrong (rows start at y=247, cols at x=441). Redo:".
Escalera de VRAM
Los escalones 2 a 4 se ejecutaron directamente en llama-server b12167 en la 4090, con caché KV q8_0 y el mmproj bf16 en la GPU. Cada uno recibió el encargo de página de 6 s del ejemplo (193 tokens de prompt, máximo de 8.192 tokens de salida) y un PNG de 15 puntos con una pregunta de lectura en frío. Pico medido con nvidia-smi cada 0,5 s. Este encargo es más pequeño que el de la ejecución de Claude Code, así que los escalones no son comparables en igualdad de condiciones con ella.
| GPU o presupuesto | Configuración | Pico de VRAM | Tiempo por salida | Salida correcta | Real o emulada |
|---|---|---|---|---|---|
| RTX 4090 24 GB | Q4_K_M + mmproj bf16, contexto de 98.304 q8_0, Claude Code a través del endpoint | 21.425 MiB | de 39,4 a 47,7 tok/s; renderizado completo a los 10 min | no: 5x7 con huecos, atasco en la compactación, sin final.mp4 en 40 min | real |
| RTX 4090 24 GB | Q4_K_M + mmproj, 32K q8_0 | 19.233 MiB | 47,6 tok/s; encargo 172,5 s; imagen 7,7 s | imagen bien; encargo: 8.192 tokens de razonamiento, sin respuesta (finish length) | real |
| Presupuesto de 16 GB | IQ3_XXS + mmproj, 32K q8_0 | 13.994 MiB | 63,5 tok/s; encargo de 4.375 tokens en 69,2 s; imagen 4,3 s | imagen bien; la página se renderiza (180 fotogramas) pero solo se ve un punto cada vez; suma final correcta | emulada en la 4090 |
| Presupuesto de 12 GB | IQ2_XXS + mmproj, 16K q8_0 | 10.252 MiB | 78,7 tok/s; encargo 104,4 s; imagen 11,3 s | imagen bien; página cortada a los 8.192 tokens (html incompleto) | emulada en la 4090 |
Intentamos usar una tarjeta real de 16 GB y todas las opciones estaban agotadas (RTX 2000 Ada, RTX 5080, RTX A4000, RTX 4080 y 4080 SUPER, RTX 4000 Ada). No se sabe si 13.994 MiB dejan margen suficiente en una tarjeta real de 16 GB con la sobrecarga del driver.
Sin probar: una tarjeta real de 16 o 12 GB; Claude Code con los ficheros más pequeños; contextos por encima de 96K; el razonamiento desactivado (--chat-template-kwargs); un tope de salida mayor o un ajuste de compactación distinto; la receta BF16 de los autores en vLLM con paralelismo de tensores 4; audio.
Problemas pendientes
/v1/messagesdescartaba las imágenes (crates/manager/src/api/openai.rs,anthropic_message_to_openai): los bloquesimagese saltaban y los arrays detool_resultse convertían en cadenas, así que un PNG leído por Claude Code llegaba al modelo como texto base64. Arreglo local: los bloques de imagen pasan a ser partesimage_urlde OpenAI; las imágenes de los resultados de herramientas se vuelven a adjuntar en el siguiente mensaje del usuario. Comprobación en vivo: 200, en streaming, 601 tokens de entrada / 291 de salida, 6,8 s, lectura correcta. Se añadió un test unitario pero no se compiló (disco lleno). Abierto hasta que se despliegue en el servicio alojado.- Las llamadas sin streaming mueren a los 120 s. La primera llamada sin streaming devolvió 503 tras el tiempo de espera del backend del worker, con llama-server en 5.599 tokens de razonamiento. Arreglado para la ejecución con
INFERENCEKEY_BACKEND_REQUEST_TIMEOUT_SECS=1800; el ejemplo ahora usa streaming. - Un reinicio del worker no adoptó el llama-server en marcha. El segundo llama-server salió por falta de VRAM; se perdió alrededor de 1,5 minutos hasta que el watchdog recuperó el workload. Abierto.
- La subida del binario del worker agotó el tiempo de espera en la primera máquina (SFTP, latencia alta) y el manager la terminó a los 2,18 minutos. Un reintento restringido a la UE subió en 8 s. Conocido, abierto.
- Compactación a 98K: tres resúmenes llegaron al tope de 16.384 tokens; los registros no muestran por qué. Remedios sin probar: un contexto mayor, un tope de salida mayor, el razonamiento desactivado.
- Menor: llama.cpp desactiva
cache_reusecon multimodal; la caché de prefijos normal siguió funcionando.
Vídeo de la demo
La demo narrada de 203 segundos: primero los vídeos de los autores (con crédito a SenseNova), su ficha del modelo, los turnos por vídeo y los tamaños de los ficheros; después nuestro despliegue en la RTX 4090, una repetición de las 61 llamadas a herramientas y de la compactación, nuestro clip, la comparación clave y la escalera de memoria.
Fuentes
- sensenova/SenseNova-6.8-Code2Video (ficha del modelo, config, configuración de generación, secciones de despliegue y de arnés).
- OpenSenseNova/SenseNova-6.8-Code2Video (skill, scripts, plantilla de prompt, limitaciones).
- Trayectorias de producción.
- bartowski/sensenova_SenseNova-6.8-Code2Video-GGUF.
- AI Search, 2026-11-01, capítulo "SenseNova Code2Video" en el 39:53.
- Ejemplo del SDK.
- Nuestra prueba anterior de otro modelo de SenseTime, SenseNova-Loop-9B.