SenseNova-Loop-9B: un 9B en bucle entra en una tarjeta de 20 GB, y lo paga en velocidad
Un 9B que pasa dos veces por sus capas centrales: acierta en una tarjeta real de 20 GB con prompts cortos, a 2 o 3 tokens/s, y a 9,2 con un PR de SGLang.
El tamaño de un modelo suele decirte qué GPU necesita y a qué velocidad irá. SenseNova-Loop-9B-Preview, un modelo abierto de SenseTime, guarda 9B parámetros (los números que aprende durante el entrenamiento), pero usa muchos de ellos dos veces en cada palabra. Así que ocupa lo que un 9B, y sus autores cuentan el trabajo por palabra como el de un 14,6B. Lo ejecutamos sin comprimir en una RTX 4000 Ada real de 20 GB y en una A40 de 48 GB de nuestra nube. Las dos leyeron un gráfico, resolvieron un problema de matemáticas y llamaron a una herramienta sin fallos. Con el código de los autores lo paga en velocidad: 2 o 3 palabras por segundo. Si se quita el bucle, la velocidad se dobla y las respuestas se rompen.
Con ese código, una respuesta sobre un gráfico tardó unos tres minutos. Una versión de SGLang todavía sin publicar resolvió el problema en 34 segundos en lugar de 101. llama.cpp y vLLM, tal como se distribuyen, todavía no pueden cargarlo. Una tarjeta de 20 GB te abre la puerta para prompts cortos, y el ejemplo del final lo ejecuta.
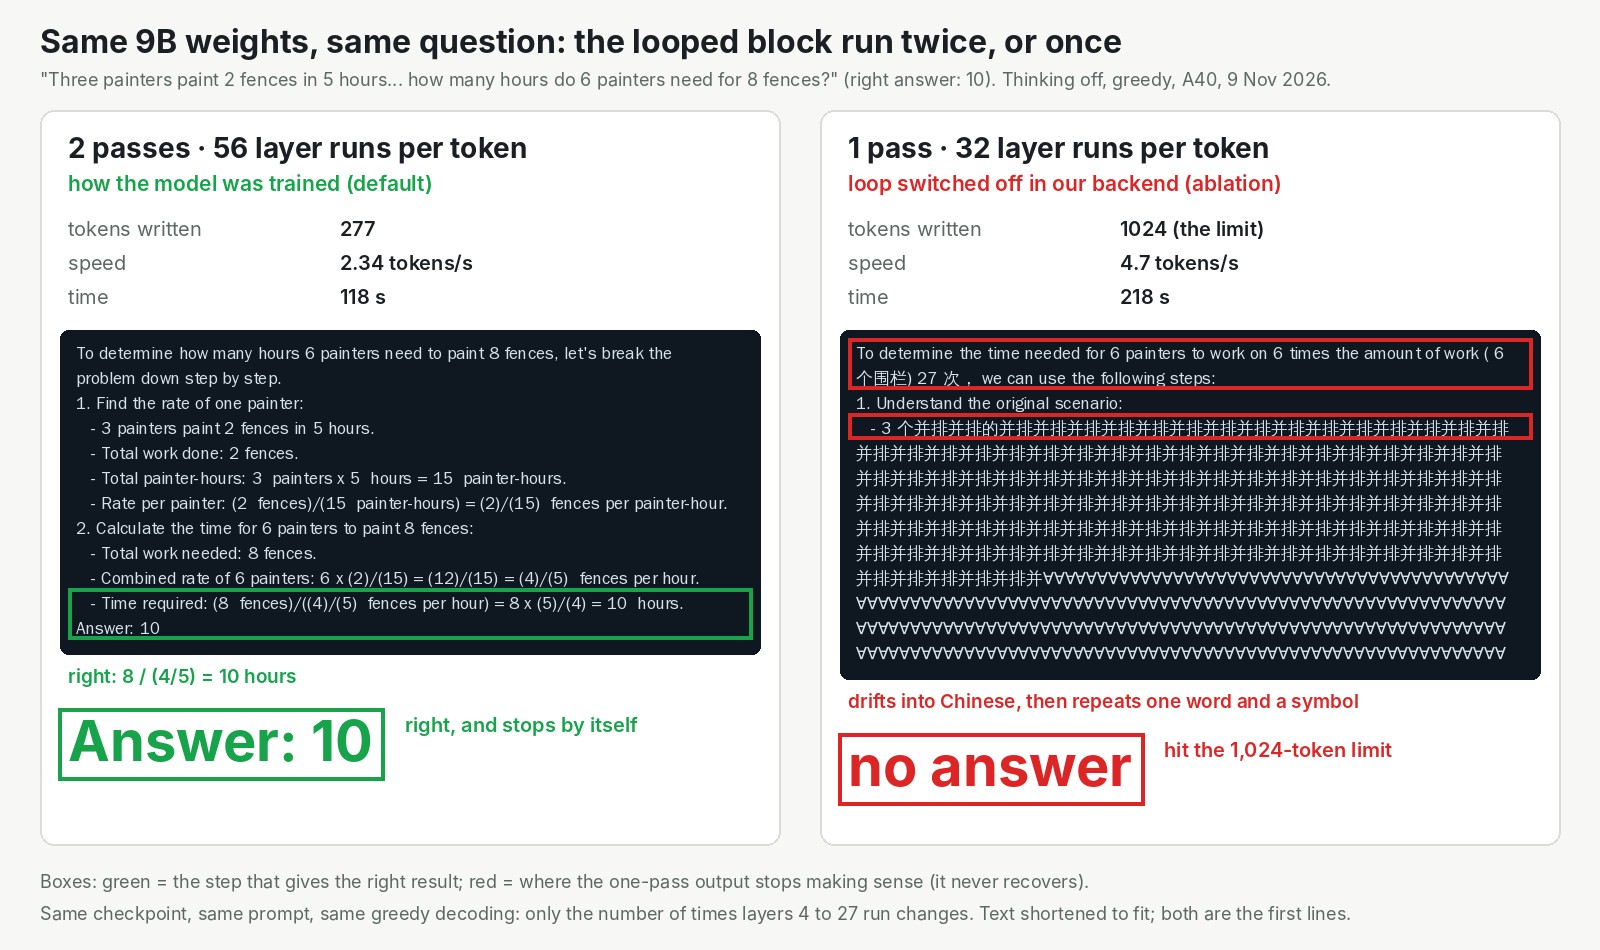
El mismo fichero, la misma pregunta. A la izquierda, el modelo pasa dos veces por sus capas centrales, como se entrenó. A la derecha, le hicimos pasar solo una vez.
| Memoria | Velocidad | Precisión |
|---|---|---|
| Entra en una tarjeta real de 20 GB con prompts de hasta unos 3K tokens | Una respuesta sobre un gráfico tarda unos 3 minutos (un problema de matemáticas baja de 101 s a 34 s con el pull request de SGLang) | Respuestas correctas en las tres peticiones en las dos tarjetas |
Un 9B que calcula como un 14,6B: 32 capas guardadas, 56 ejecutadas
El modelo es una pila de 32 pasos de procesamiento (capas), y cada palabra hace 56 pasadas de capa por ellos. Las capas 4 a 27 se ejecutan una vez y luego otra, con exactamente los mismos parámetros. La página del modelo de SenseTime lo describe como "~9B total parameters; ~14.6B inference parameters". Es su cuenta del cálculo por palabra, no una que hayamos comprobado, y no dice nada de la calidad.
Funciona como una partitura con un signo de repetición sobre el puente: la banda toca el puente dos veces, pero la partitura no gana páginas. El software de servicio habitual todavía no tiene código para esa repetición.
Lee imágenes además de texto, y se entrenó con textos de hasta 262.144 tokens (los "256K"). Su licencia Apache 2.0 permite el uso comercial, sin formularios. La sección de noticias de la página del modelo fecha el lanzamiento el 30 de octubre, y la página se actualizó por última vez el 2 de noviembre.
En Terminal-Bench 2.1, una prueba de 0 a 100 de agentes que trabajan en una terminal, los autores dan 40,45, frente a 29,20 de Qwen3.5 9B. En la misma tabla, Qwen3.5 27B, tres veces más grande, saca 47,19 y el modelo de 3B de Nanbeige saca 49,44. No reprodujimos esas cifras. Vimos el modelo en el vídeo de noticias de AI Search del 1 de noviembre y en un hilo de r/LocalLLaMA el día que salió. Nada de lo que habíamos publicado antes trataba un modelo que reutiliza sus propias capas, así que lo probamos.
llama.cpp, Ollama, LM Studio y vLLM, tal como se distribuyen, todavía no pueden cargarlo
Lo primero que pregunta un ingeniero es "¿funciona en mi herramienta de siempre?". Esta semana la respuesta es no para las herramientas habituales que ejecutan modelos en tu propio ordenador o servidor.
- llama.cpp, Ollama, LM Studio. El llama.cpp oficial no puede cargarlo. Una petición de funcionalidad abierta el 3 de noviembre sigue abierta. Los ficheros convertidos de AtomicChat necesitan un llama.cpp modificado y solo leen texto. Su página del modelo dice que LM Studio y Ollama tampoco lo soportan todavía.
- vLLM y SGLang. Son los programas de servicio que ponen un modelo detrás de una API para muchos usuarios. El soporte existe solo como cambios de código propuestos (pull requests), no en versiones publicadas. El de vLLM, de sufubao, es solo de texto por ahora. Compilamos el de SGLang, de WANDY666, y lo medimos más abajo.
Así que hoy, en una sola tarjeta, solo el código de los propios autores lo ejecuta con texto e imágenes. Funciona en Python, con el código del modelo distribuido junto a los pesos. Eso es lo que desplegamos.
Nuestra prueba: el código de los autores en dos tarjetas reales, una petición cada vez
Cargamos el modelo sin comprimir, en el formato que indican los autores. La ejecución principal usó una A40 de 48 GB de nuestra nube. La de confirmación usó una RTX 4000 Ada real de 20 GB, una tarjeta de estación de trabajo.
Las mismas tres peticiones fueron a las dos: un problema de matemáticas con el modelo razonando primero, una pregunta sobre la imagen de un gráfico y una llamada a herramienta. Una llamada a herramienta es el modelo pidiéndole a tu programa que ejecute una función, aquí una consulta de tipo de cambio. Añadimos prompts largos con un código escondido que encontrar en las dos tarjetas, y el experimento del bucle de la imagen de arriba en la A40.
Enviamos una petición cada vez y ejecutamos cada petición una sola vez: demuestra que el modelo funciona de principio a fin, no lo bueno que es. El prompt más largo tuvo 12.046 tokens, lejísimos de 256K. No probamos una tarjeta real de 24 GB, versiones comprimidas, varios usuarios a la vez ni un 9B normal sin bucle en la misma tarjeta. Así que todavía no podemos decir cuánta de la lentitud es del bucle y cuánta del software.
Respuestas correctas en las dos tarjetas, pero una respuesta sobre un gráfico tarda unos tres minutos
Todas las peticiones principales volvieron bien en las dos tarjetas, con las mismas respuestas (el texto del gráfico fue idéntico). El gráfico era una factura de la luz inventada de una panadería. El modelo encontró que agosto era el mes más bajo, con 2.140 kWh, calculó 3.110 kWh ahorrados entre dos trimestres y les puso un precio de 653,10 euros. La llamada a herramienta volvió como un get_exchange_rate limpio con USD y EUR.
| Petición | A40 48 GB | RTX 4000 Ada 20 GB | Respuesta |
|---|---|---|---|
| Problema de matemáticas, con razonamiento | 101 s, 3,0 tokens/s | 138 s, 2,25 tokens/s | 10, correcta en las dos |
| Imagen del gráfico, con razonamiento (455 tokens) | 157 s, 2,9 tokens/s | 204 s, 2,25 tokens/s | 2.140 kWh, 3.110 kWh, 653,10 EUR, correcta en las dos |
| Llamada a herramienta | 29 s | 34 s | get_exchange_rate(USD, EUR), correcta en las dos |
Una respuesta sobre un gráfico con razonamiento tarda minutos, lo que vale para un trabajo por lotes de noche y es un suplicio en una ventana de chat.
Lo que lo frena probablemente no es la GPU en sí. Por este camino, la CPU le pasa el trabajo a la GPU en muchos trozos pequeños por palabra. En la A40, un núcleo de CPU estuvo al 100 % mientras la GPU solo estaba ocupada entre el 38 y el 53 % del tiempo (sobre todo entre el 33 y el 47 % en la RTX 4000 Ada). Cada palabra ejecuta 56 capas, así que cada palabra paga 56 capas de reparto de trabajo. No medimos por qué la A40 fue alrededor de un tercio más rápida.
Parece un problema de software: el pull request de SGLang se ejecutó en la misma A40 a entre 9,1 y 9,2 tokens por segundo. El problema de matemáticas que tardó 101 segundos con Transformers tardó allí 33,6 segundos, con un texto idéntico. La respuesta sobre el gráfico también fue idéntica.
Una respuesta errónea que conviene conocer: ante una pregunta con trampa sobre el precio de un bolígrafo, sin razonar primero, dijo 0,65 en las dos tarjetas. La respuesta correcta es 0,15.
Si quitas el bucle escribe el doble de rápido, y deja de tener sentido
Ejecutar las capas 4 a 27 una vez en lugar de dos llevó al modelo de unos 2,3 a 4,7 tokens por segundo, y lo rompió. Los parámetros eran los mismos. Solo cambió el número de pasadas, con un interruptor que añadimos a nuestro código de carga.
En el problema de matemáticas se equivocó en la primera frase, se pasó al chino, repitió una palabra y luego un símbolo, hasta llegar a nuestro límite de 1.024 tokens. En el gráfico leyó 3.350 como 3.530, escribió "kg" en lugar de kWh, cambió de idioma y respondió 1.414 kWh y 293,34 euros, las dos cosas mal. Un cuento corto repitió su propio arranque.
Recortar el bucle sí da velocidad, solo que no una velocidad que puedas usar: el modelo se entrenó esperando la segunda pasada. También probamos tres pasadas, con las que el modelo nunca se entrenó. Siguió escribiendo texto fluido, alrededor de un tercio más lento que con dos pasadas.
El acelerador integrado (MTP) no funcionó en ningún motor que probamos
La página del modelo marca como "Available" el MTP, una pieza pequeña que adivina las siguientes palabras para que el modelo grande las compruebe de una vez. En una sola GPU no conseguimos ejecutarlo.
El código de Transformers se salta esos pesos al cargar. El pull request de vLLM indica que el MTP no está soportado. El pull request de SGLang cargó una segunda copia entera del modelo y falló. Con nuestro arreglo de una línea, la pieza que adivina se cargó y luego se cayó. Otro programa de servicio documenta el MTP, pero solo en 2 a 4 GPU. Si el MTP acelera este modelo, todavía no te lo podemos decir.
Qué GPU: una tarjeta real de 20 GB funciona, con prompts de hasta unos 3K tokens
La tarjeta más pequeña que funcionó es una RTX 4000 Ada real de 20 GB, sin comprimir, a través de nuestra plataforma (sus resultados están en la tabla de arriba). Aguantó un prompt de 3.046 tokens. Un prompt de unos 6.000 tokens se quedó sin memoria. El servidor respondió a esa petición con un error y siguió atendiendo la siguiente.
El modelo ocupa 17,5 GiB una vez cargado, y un prompt de 12.046 tokens lo sube a 19,9 GiB. Una tarjeta de 20 GB tiene en realidad 19,55 GiB, así que eso no entra. Los parámetros se comparten entre las dos pasadas, pero cada pasada guarda sus propias notas sobre el prompt, y esas notas crecen con su longitud. Por eso son los prompts largos, y no los pesos, los que deciden entre 20 y 24 GB.
La A40 de 48 GB es donde empezamos, no lo que necesitas:
| Tarjeta o presupuesto de memoria | Real o emulada | Resultado |
|---|---|---|
| A40 48 GB | real | todo bien, incluido un prompt de 12K tokens (referencia) |
| Presupuesto de 24 GB (límite de 22,5 GiB en la A40) | emulada | todo bien, incluido el prompt de 12K tokens, mismas respuestas |
| RTX 4000 Ada 20 GB | real | peticiones principales y un prompt de 3K tokens bien, con unos 6K tokens se quedó sin memoria |
| Presupuesto de 20 GB (límite de 18,5 GiB en la A40) | emulada | prompts cortos bien, el prompt de 12K tokens se quedó sin memoria |
| Presupuesto de 16 GB (límite de 14,5 GiB en la A40) | emulada | no carga |
Una fila emulada significa que limitamos cuánta memoria de la A40 podía usar el modelo. Dice si el modelo entra, no cómo rinde una tarjeta más pequeña.
En InferenceKey: listo en 57 segundos, con el código de los autores detrás de una API de chat
El modelo necesita el código de sus propios autores, y nuestra plataforma puede ejecutar código así. La A40 respondió 57,4 segundos después de pedir el modelo, con los pesos ya en disco. Unos 36 de esos segundos se fueron en un calentamiento único antes de la primera petición. Un worker de 20 GB recién creado tardó 106,7 segundos, unos 30 de ellos instalando antes sus paquetes de Python.
El worker ejecutó un fichero corto de Python nuestro, unos cientos de líneas alrededor del código de Transformers de los autores. Acepta peticiones de chat normales con imágenes y herramientas y devuelve la respuesta, el razonamiento del modelo, las llamadas a herramientas y los tiempos.
Esta ejecución usó una copia local de la plataforma, no el servicio alojado, con el mismo código de worker. Las cifras de SGLang vienen de una compilación aparte, fuera de la plataforma.
¿Deberías usarlo? Sí, para trabajos pacientes con prompts cortos en una tarjeta de 20 a 24 GB
- Quieres un modelo abierto que lea imágenes y llame a herramientas en una tarjeta pequeña: merece una prueba. Una tarjeta real de 20 GB lo ejecutó sin comprimir, con respuestas correctas. En esa tarjeta es una herramienta para prompts cortos, no el agente de contexto largo que describe la página del modelo.
- Necesitas prompts largos: cuenta con 24 GB o más, según la tabla de arriba.
- Necesitas velocidad: todavía no. Con el código de los autores, una respuesta con razonamiento tarda minutos. El pull request de SGLang deja hoy una respuesta de 101 segundos en 34, pero no está integrado. Según cuentan, un fork parcheado de llama.cpp llega a unos 31 tokens por segundo con una versión comprimida y solo de texto (issue #31571 de llama.cpp); no lo hemos probado.
- Esperabas recortar el bucle para ganar velocidad: no lo hagas. La segunda pasada es lo que mantiene las respuestas coherentes.
Para obtener el mismo problema de matemáticas, la misma respuesta sobre el gráfico y la misma llamada a herramienta en tu propio worker NVIDIA, ejecuta python main.py desde el ejemplo del SDK de SenseNova-Loop-9B. Necesita unos 19 GB de memoria de GPU libre y 40 GB de disco, y borra el despliegue al terminar.
Para ingenieros
Créditos
- SenseTime (OpenSenseNova): el modelo, el decodificador en bucle y su uso de mHC de dos flujos en el bloque en bucle, el código de modelado de Transformers distribuido en el repo de Hugging Face, la ficha del modelo, los benchmarks y los ejemplos de muestra. Apache-2.0. El repo de GitHub solo contiene el README, recursos y ejemplos (comprobado con la API de GitHub; la carga de la página agotó el tiempo de espera).
- El equipo de Qwen: la base de texto Qwen3.5 (
qwen3_5_text) y la torre de visión (qwen3_5_vision) sobre las que está construido el modelo. - WANDY666: SGLang PR #47281, "[Feat] sensenova_loop: Add multimodal Loop and mHC inference", abierto, head
336c54ac, actualizado por última vez el 2026-10-30. Nuestros 9,2 tokens/s salen de él. - sufubao: vLLM PR #64832, "[Model] Add SenseNova Loop support", abierto, head
86014ad4, actualizado el 2026-11-04. - ModelTC (LightLLM): PR #1665 integrado el 2026-10-29 con una guía de despliegue y una sección "Enable MTP" (
--mtp_mode eagle_with_att --mtp_step 3 --tp 4); PR #1695 integrado el 2026-11-09 con checkpoints AWQ ("AWQ TP2 passed text, image, MTP, and tool-call smoke tests"). La última versión etiquetada es la v1.2.0 (2026-08-10), así que esto solo está en main. - AtomicChat: los ficheros GGUF, hechos con un llama.cpp parcheado sobre el commit
5047748f11. GuideboardLabs: un fork de llama.cpp fuera del árbol principal (GuideboardLabs/llama.cpp-sensenova-loop, ramasensenova-loop) y un segundo repo GGUF, ambos enlazados desde el issue #31571 de llama.cpp. - flash-linear-attention: los kernels de Gated DeltaNet que usa el camino de Transformers (JIT de Triton durante el calentamiento).
- AI Search (vídeo, 1 de noviembre de 2026, en el 51:58) y el hilo de r/LocalLLaMA del 30 de octubre, donde vimos el modelo.
- Nuestra parte: el backend personalizado y el ejemplo del SDK, el despliegue en dos tarjetas, el interruptor para el experimento del bucle, la compilación de SGLang y los intentos con MTP, las mediciones.
Modelo y ficheros
-
Pesos cargados en bf16 (el formato que indican los autores) desde fragmentos guardados sobre todo en FP32; los routers de mHC se quedan en FP32.
-
Cada visita al bucle guarda su propia caché de atención/recurrente (documentación del PR de vLLM); solo las capas de atención completa, una de cada cuatro, guardan una caché KV que crece con el prompt.
-
SenseNovaLoopForConditionalGeneration,model_typeqwen3_5_text; 32 capas de decodificador; hidden 4096, FFN 12.288, 16 cabezas de consulta / 4 cabezas KV, head_dim 256, vocabulario de 248.320; cada grupo de 4 capas son 3 Gated DeltaNet (atención lineal) + 1 de atención completa; torre de visiónqwen3_5_vision, 27 bloques;max_position_embeddings262.144;mamba_ssm_dtypefloat32;mtp_num_hidden_layers1. -
loop_settings{start: 4, end: 28, eval_count: 2, counts: [2]}: capas 0 a 3 una vez, bloque [4, 28) dos veces con pesos compartidos, capas 28 a 31 y la cabeza una vez, 56 ejecuciones de capa por pasada hacia delante. -
mHC de dos flujos (manifold-constrained hyper-connections): dentro del bloque en bucle, el modelo lleva dos copias de su estado en curso y las mezcla con pequeñas tablas de enrutado aprendidas, guardadas en FP32 mientras la base está en bf16. Esta es la parte a medida para la que los motores habituales necesitan código nuevo.
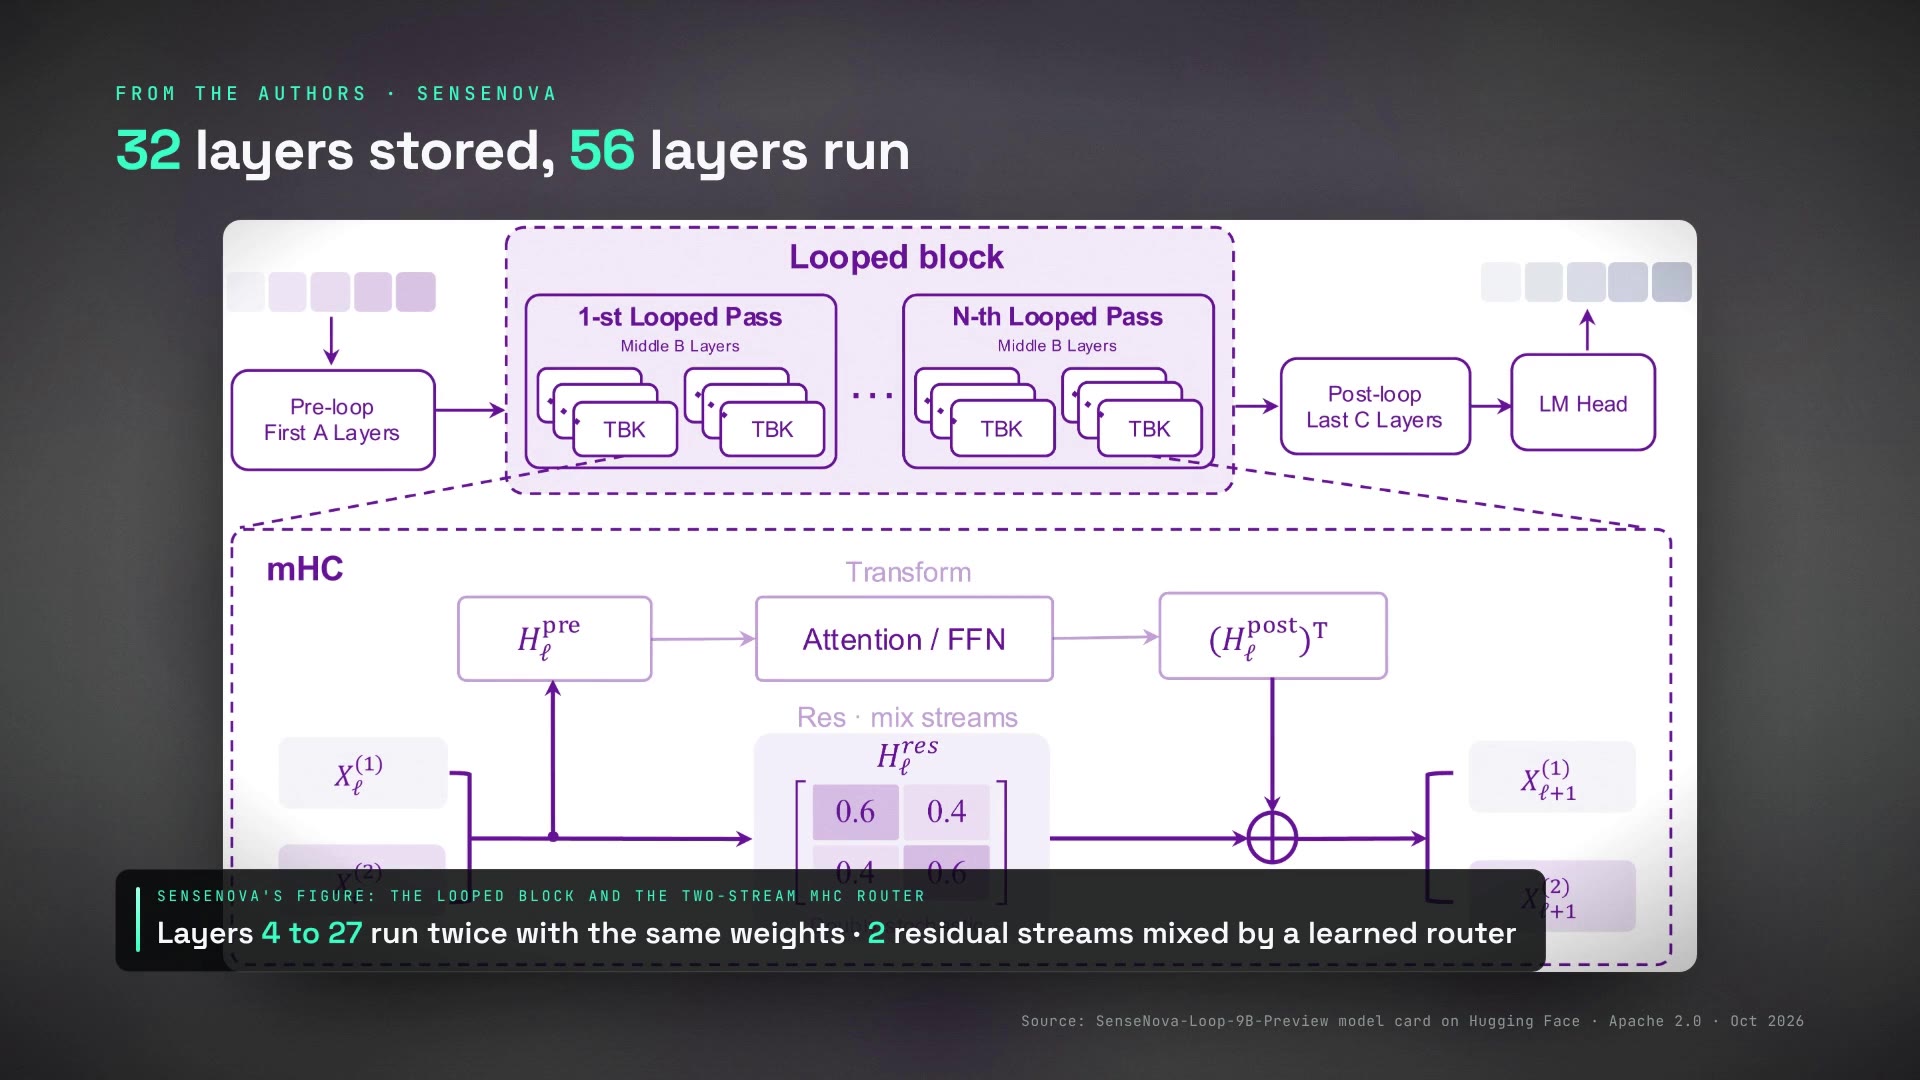
mhc{streams: 2, iterations: 20, start: 4, end: 28}: normalización de Sinkhorn con 20 iteraciones; ficha: "BF16 backbone; FP32 mHC routing parameters" (precisión de exportación; los fragmentos publicados son sobre todo FP32 y nuestro backend los convierte a bf16 al cargar); el código de modelado fuerza FP32 enmhc_attn/mhc_ffnmediante_keep_in_fp32_modules.- El código de modelado ignora los pesos de MTP:
_keys_to_ignore_on_load_unexpected = [r"^mtp\."]. - Checkpoint en la revisión
9937e91c7301b7dcbb5bf17e3e4e95c499a11e99(lastModified 2026-11-02): 8 fragmentos safetensors de unos 38,65 GB (sobre todo FP32),mtp.safetensorsde 486.582.880 B,tokenizer.jsonde unos 20 MB. Cargado en bf16 ocupa 17.960 MiB. Algunos catálogos (el nuestro incluido) estimaban "about 23 GB loaded in bf16"; la cifra medida es 17,5 GiB. El GGUF BF16 de AtomicChat figura con 16,7 GB. - Tabla de aceleración de la ficha: MTP "Available"; Dspark y Dflash2 "Training in progress".
- Entorno comprobado por los autores: Transformers 5.18.0, PyTorch 2.11.0 con CUDA 13.0,
trust_remote_code=True.
Benchmarks de los autores (no reproducidos)
| Benchmark | SenseNova-Loop-9B |
|---|---|
| Terminal-Bench 2.1 | 40,45 (Qwen3.5 9B 29,20, Qwen3.5/3.6 35B-A3B 40,45, Qwen3.5 27B 47,19, Nanbeige 4.2-3B 49,44, IQuest-Coder 40B-Loop 17,98) |
| BIRD-Dev | 71,38 |
| WorkBuddy | 66,89 |
| AIDABench | 58,87 |
| TeamBench | 48,89 |
| T3-Banking | 18,56 |
| AutomationBench | 13,72 |
| RaccoonPPTBench (interno) | 70,70 |
Dónde funciona hoy (comprobado el 2026-11-09)
| Motor | Estado | Notas |
|---|---|---|
Transformers 5.18 + trust_remote_code | funciona (lo que desplegamos) | texto e imágenes, sin MTP, de 2,2 a 3,0 tokens/s, limitado por los lanzamientos |
| SGLang PR #47281 | PR abierto, compilado y probado por nosotros | texto e imágenes, de 9,1 a 9,2 tokens/s en una A40, MTP sin conectar |
| vLLM PR #64832 | PR abierto, sin probar | solo texto, "Image inputs and MTP remain unsupported", solo pesos sin cuantizar, sin descarga a CPU con los pesos compartidos del bucle; su documentación indica que cada visita al bucle guarda su propia caché de atención/recurrente, así que compartir pesos no reduce la caché |
| LightLLM main | integrado, no en una versión publicada, sin probar | ejemplo de la ficha ghcr.io/modeltc/lightllm:main con --tp 4; MTP documentado |
| llama.cpp upstream | no soportado | issue #31571 abierto; solo está soportado el SenseNova U1, que no tiene relación |
| GGUF de AtomicChat en llama.cpp parcheado | sin probar | solo texto, sin mmproj, bloque MTP excluido; BF16 16,7 GB, Q8_0 8,9 GB, Q6_K 6,9 GB, Q5_K_M 6,0 GB, Q4_K_M 5,2 GB (tabla de ficheros; la barra lateral da otros tamaños) |
| Ollama, LM Studio | no soportado según la ficha GGUF y el issue #31571 | sin probar por nosotros |
Montaje
- GPU: una A40 de 48 GB en nuestra nube (cc 8.6, driver 595.91.07 / CUDA 13.2, 9 vCPU). Confirmación: una RTX 4000 Ada Generation real de 20 GB (20.475 MiB, cc 8.9, 9 vCPU).
- Plataforma: un manager local de InferenceKey compilado desde
main(3666da3b), con el worker conectado por un túnel; producción sin tocar. - Backend: backend personalizado de Python
sensenova-loop-9b0.1.1, porque ningún motor integrado puede cargar la arquitectura y Transformers es el único camino con imágenes que comprobaron los autores. - Pesos descargados de antemano con
hf_xet: 38,2 GB en 21 s (A40) y 28 s (RTX 4000 Ada).
Paso a paso con el ejemplo del SDK
- Clona inferencekey-sdk y abre
examples/sensenova-loop-9b-vision-chat-custom-backend-private-nvidia(commit6c585a0462e33351a17ba5050ec8ee8cc8c01be5). Ficheros:backend.py,publish.py,main.py,requirements.txt,README.md,.env.example,samples/energy-chart.png. cp .env.example .envy rellenaINFERENCEKEY_SDK_TOKEN,INFERENCEKEY_API_KEY,INFERENCEKEY_PROJECTeIK_WORKER_ID: un worker NVIDIA privado, compatible con bf16 (Ampere o posterior), con unos 19 GB de memoria de GPU libre (21 GB para un prompt de 12K tokens), unos 40 GB de disco libre y un driver para CUDA 12.8 o posterior.- Instala el cliente:
pip install requestsy la compilación local del SDK (pip install maturin && (cd ../../bindings/python && maturin develop --release)).requirements.txtes para el worker:inferencekey,transformers==5.18.0,torch==2.11.0,torchvision==0.26.0,accelerate,safetensors,pillow,numpy,flash-linear-attention,huggingface_hub[hf_xet]. python publish.pyuna vez, conINFERENCEKEY_TENANT_IDeINFERENCEKEY_USER_TOKEN(o subedist/*.tar.gzen Dashboard, Custom backends).python main.py. Haceensure()de un workload con backendsensenova-loop-9b, tareatext2text, políticaFIXED,ready_timeout_secs3600 yrequest_timeout_secs1200, espera, envía las tres peticiones a/v1/chat/completions, escribe./outputs/*.jsony llama adelete()salvo queIK_KEEP_ALIVE=1.
Qué hace el backend:
snapshot_downloadfijado a la revisión9937e91c...conignore_patterns['assets/*', 'examples/*', '*.md', 'mtp.safetensors'].AutoModelForImageTextToTexten bf16 contrust_remote_code,AutoProcessory después un calentamiento.LOOP_VRAM_LIMIT_GIBlimita PyTorch contorch.cuda.set_per_process_memory_fraction(así emulamos las tarjetas más pequeñas).- Por petición (en
extra_body):enable_thinking(true por defecto),max_tokens(con tope de 8192),temperature/top_p(greedy por defecto),toolsyloop_passesde 1 a 4 (2 por defecto, eleval_countde la config), que reconstruye el_loop_plandel modelo de texto para esa petición. Imágenes como URLsdata:, con el lado más largo limitado a 1536. - Devuelve
content,reasoning,tool_calls(con la forma de OpenAI) ytimings(tokens, tokens/s, primer token, VRAM pico, ejecuciones de capa por token).
La petición que produjo el experimento del bucle, escrita con el helper ask() del ejemplo del SDK:
ask(url, key, [{"role": "user", "content":
    "Three painters paint 2 fences in 5 hours. Working at the same rate, how many hours "
    "do 6 painters need for 8 fences? End with 'Answer: <number>'."}],
    max_tokens=1024, enable_thinking=False, loop_passes=1)  # 2 = trained setting
Tiempos
| Fase | A40 (ejecución 1) | RTX 4000 Ada (worker recién creado) |
|---|---|---|
Listo después de ensure() | 57,4 s | 106,7 s |
| venv de Python | reutilizado | unos 30 s |
| Carga | 16,3 s | 22,8 s |
| Calentamiento | 36,2 s (32,8 s hasta el primer token, JIT de Triton de los kernels de fla) | 40,4 s |
Ejecuciones de la escalera dentro del proceso con la caché de Triton caliente: montaje de 20,6 a 22,6 s (carga de 11,3 a 12,8 s, calentamiento de 4,7 a 4,8 s).
Peticiones a través de la plataforma (greedy, 2 pasadas)
| Caso | A40 | RTX 4000 Ada 20 GB |
|---|---|---|
| Problema de matemáticas, con razonamiento | 306 tokens, 101,4 s, 3,02 tok/s, primer token 0,45 s, pico 18.088 MiB, "Answer: 10" | 310 tokens, 137,9 s, 2,25 tok/s, "Answer: 10" |
| Gráfico, con razonamiento (964 tokens de prompt) | 455 tokens, 156,6 s, 2,93 tok/s, primer token 1,55 s, pico 18.295 MiB | 455 tokens, 203,8 s, 2,25 tok/s, texto idéntico |
| Llamada a herramienta, sin razonamiento | 73 tokens, 29,4 s, 2,49 tok/s | 73 tokens, 33,6 s, 2,17 tok/s |
| Gráfico, sin razonamiento | 161 tokens, 69,2 s, 2,33 tok/s, correcta | |
| Precio del bolígrafo (real 0,15), sin razonamiento | "0.65", errónea | "0.65", errónea |
Código de second_largest() | correcta, 35 tokens, 2,58 tok/s | |
| Cuento, 160 tokens | fluido, 2,47 tok/s | |
| Código escondido en un prompt largo | 12.046 tokens: "7319-LOOP" correcto, primer token 14,6 s (5,3 s en caliente), pico 20.383 MiB | 3.046 tokens correcto, primer token 11,1 s, pico 18.649 MiB; unos 6K tokens: 503 "CUDA out of memory. Tried to allocate 142.00 MiB ... total capacity of 19.55 GiB", siguiente petición 200 |
Aritmética del gráfico: 9.940 - 6.830 = 3.110 kWh, a 0,21 euros/kWh = 653,10 euros.
Experimento del bucle (loop_passes, A40, sin razonamiento, greedy)
| Caso | 2 pasadas (56 ejecuciones de capa, entrenado) | 1 pasada (32) | 3 pasadas (84, sin entrenar) |
|---|---|---|---|
| Vallas | correcta, 277 tokens, 2,34 tok/s, 118 s | sin respuesta: "( 6 个围栏) 27 次", luego "并排" repetido, luego "∀" hasta 1.024 tokens, 4,70 tok/s, 218 s | |
| Gráfico | correcta | lee 3.350 como 3.530, escribe "kg", se pasa al chino, 1.414 kWh / 293,34 EUR (errónea), 4,43 tok/s | |
| Precio del bolígrafo | "0.65" (errónea) | divaga, "欧元", cortado en 64 tokens | |
| Horario de trenes | coherente | "Zarhanda", "Start: 11:47 (09:47)" | |
| Cuento | fluido, 2,47 tok/s | repite su arranque, "seerrag" / "searg", 4,46 tok/s | fluido, 1,68 tok/s |
Por qué es lento con Transformers
La decodificación está limitada por los lanzamientos: el proceso de Python al 100 % de un núcleo de CPU, uso de la GPU del 38 al 53 % (nvidia-smi cada segundo). causal_conv1d no está instalado y recurre al camino de referencia de PyTorch. Cada token hace 56 ejecuciones de capa, así que el número de lanzamientos de kernels escala más o menos con el bucle; la aceleración de 2x del experimento con 1 pasada encaja con eso.
SGLang PR #47281 (fuera de la plataforma, misma A40)
git clone --filter=blob:none https://github.com/sgl-project/sglang.git && cd sglang
git fetch origin pull/47281/head && git checkout 336c54ac1e721197806d94b6929f567446a59693
uv venv -p 3.12 ../sgvenv && source ../sgvenv/bin/activate   # venv python and ninja on PATH for every step below
SGLANG_BUILD_RUST_EXTS=none uv pip install -e ./python
uv pip install ninja   # CUDA graph capture JIT-compiles kernels
python -m sglang.launch_server --model-path <snapshot of 9937e91c> --served-model-name sensenova-loop \
  --context-length 32768 --mem-fraction-static 0.88 --max-running-requests 4
- Compilación en 73 s: sglang 0.5.24.dev152+g336c54ac1, torch 2.14.1, sglang-kernel 0.4.10, flashinfer 0.7.2, transformers 5.19.0.
--mem-fraction-staticse aplica a la memoria libre: con 0.5 junto a nuestro backend falló con "Not enough GPU memory for hybrid (mamba/linear-attention) state cache ... max_mamba_cache_size=-29".- En marcha: CUDA graphs para batch 1/2/4 en 62 s, KV de 49.618 tokens, caché mamba de 26 huecos. Cuento de 400 tokens a 9,2 tok/s (dos veces), vallas 306 tokens en 33,6 s (texto idéntico al de Transformers), gráfico 455 tokens a 9,1 tok/s (respuesta idéntica), llamada a herramienta 67 tokens a 9,2 tok/s (
<tool_call>en bruto, sin parser configurado). TTFT de 0,37 a 0,81 s.
Intentos con MTP
- Transformers:
mtp.*ignorado al cargar. PR de vLLM: documentado como no soportado. - PR de SGLang, decodificación especulativa NEXTN, 3 pasos, top-k 1, 4 tokens de borrador. Intento 1 junto a nuestro backend: OOM al cargar el borrador. Intento 2 (GPU libre): el borrador era otra vez el
SenseNovaLoopForConditionalGenerationentero (17,57 GB), y luego falló por la memoria de la caché de estado híbrida; el PR no asociasensenova_loopa la clase de borrador MTP de Qwen3.5. - Intento 3 con nuestro parche de una línea (añade la arquitectura a la lista de reescritura
Qwen3_5ForCausalLMMTPenmodel_config.py): la cabeza MTP carga (4,26 GB, 1,85 s), los grafos de verificación del modelo objetivo se capturan (29 s) y la captura del CUDA graph de decodificación del borrador se cae conTypeError: AttentionBackend.forward() missing 3 required positional arguments: 'q', 'k', and 'v'(radix_linear_attention.py:151desdeqwen3_5.py:1087). Lo dejamos ahí. - LightLLM main documenta el MTP (
--mtp_mode eagle_with_att --mtp_step 3 --tp 4,test/start_scripts/sensenova_loop/sensenova_loop_mtp.sh); sin probar por nosotros. No hemos medido ninguna aceleración del MTP por ningún camino.
Memoria de GPU y escalera de VRAM
- Después de cargar: 17.960 MiB asignados. nvidia-smi de 18.599 a 18.783 MiB para el proceso con prompts cortos.
- Pico de PyTorch: de 18.037 a 18.295 MiB (cortos, hasta 966 tokens y una imagen), 18.649 MiB (3.046 tokens), de 20.374 a 20.383 MiB (12.046 tokens).
| GPU o límite | Configuración | VRAM pico | Tiempo por salida | ¿Salida correcta? | Real o emulada |
|---|---|---|---|---|---|
| A40 48 GB | bf16, backend personalizado de Transformers, a través de la plataforma | 18.295 MiB (corto), 20.383 MiB (12K) | gráfico 69,2 s (2,33 tok/s), vallas 118 s | sí (referencia) | real |
| Límite de 22,5 GiB (tarjeta de 24 GB) | mismo backend dentro del proceso, set_per_process_memory_fraction; gráfico + vallas + aguja de 12K, sin razonamiento | 20.374 MiB PyTorch, 22.278 MiB smi | gráfico 68,9 s (2,35 tok/s), vallas 120 s, primer token de la aguja 5,3 s | sí, respuestas idénticas | emulada |
| RTX 4000 Ada 20 GB | worker recién creado a través de la plataforma, main.py + prompts largos | 18.295 MiB (gráfico), 18.649 MiB (3K) | gráfico con razonamiento 204 s (2,25 tok/s), herramienta 33,6 s | sí hasta unos 3K tokens; con unos 6K tokens 503 OOM ("Tried to allocate 142.00 MiB ... total capacity of 19.55 GiB") | real |
| Límite de 18,5 GiB (tarjeta de 20 GB) | igual, dentro del proceso | 18.291 MiB PyTorch, 19.174 MiB smi | gráfico 68,2 s (2,38 tok/s), vallas 115 s (2,40) | cortos sí; 12K OOM ("Tried to allocate 48.00 MiB ... 18.50 GiB allowed") | emulada |
| Límite de 14,5 GiB (tarjeta de 16 GB) | igual | no: la carga falla ("Tried to allocate 17.54 GiB ... 14.50 GiB allowed") | emulada |
Los peldaños emulados se ejecutaron en la A40, así que sus velocidades son de la A40. Sin probar: una tarjeta real de 24 GB, los ficheros GGUF, cargas en int8 / fp8 / 4 bits, descarga a CPU, concurrencia, el contexto de 256K, LightLLM.
Problemas pendientes
- Ningún motor publicado sirve el modelo. El soporte de SGLang y vLLM son PR abiertos (vLLM solo texto); LightLLM solo está en main. Abierto en upstream.
- Decodificación lenta en el camino de referencia: de 2,2 a 3,0 tok/s, limitada por los lanzamientos. Abierto en upstream; el PR de SGLang da 9,2.
- MTP anunciado, pero no ejecutable en ningún camino de una GPU que probamos. Abierto en upstream.
- El runtime del SDK en PyPI va por detrás de la documentación: el backend 0.1.0 falló con "cannot import name 'chat_completion' from 'inferencekey.backend'" porque el worker instala
inferencekey0.260725.739 de PyPI. Arreglado en el backend 0.1.1 (el chat se enruta aprocess()); el hueco de publicación sigue abierto por nuestra parte. - Aviso del tokenizador en cada carga ("incorrect regex pattern ... fix_mistral_regex", Transformers 5.18.0). Las salidas estuvieron bien. Sin investigar.
- Límite de 20 GB: los prompts de unos 6K tokens se quedan sin memoria; el backend sigue en pie.
- Modelo: la pregunta del precio del bolígrafo sale mal sin razonamiento en las dos tarjetas.
Vídeo de la demo
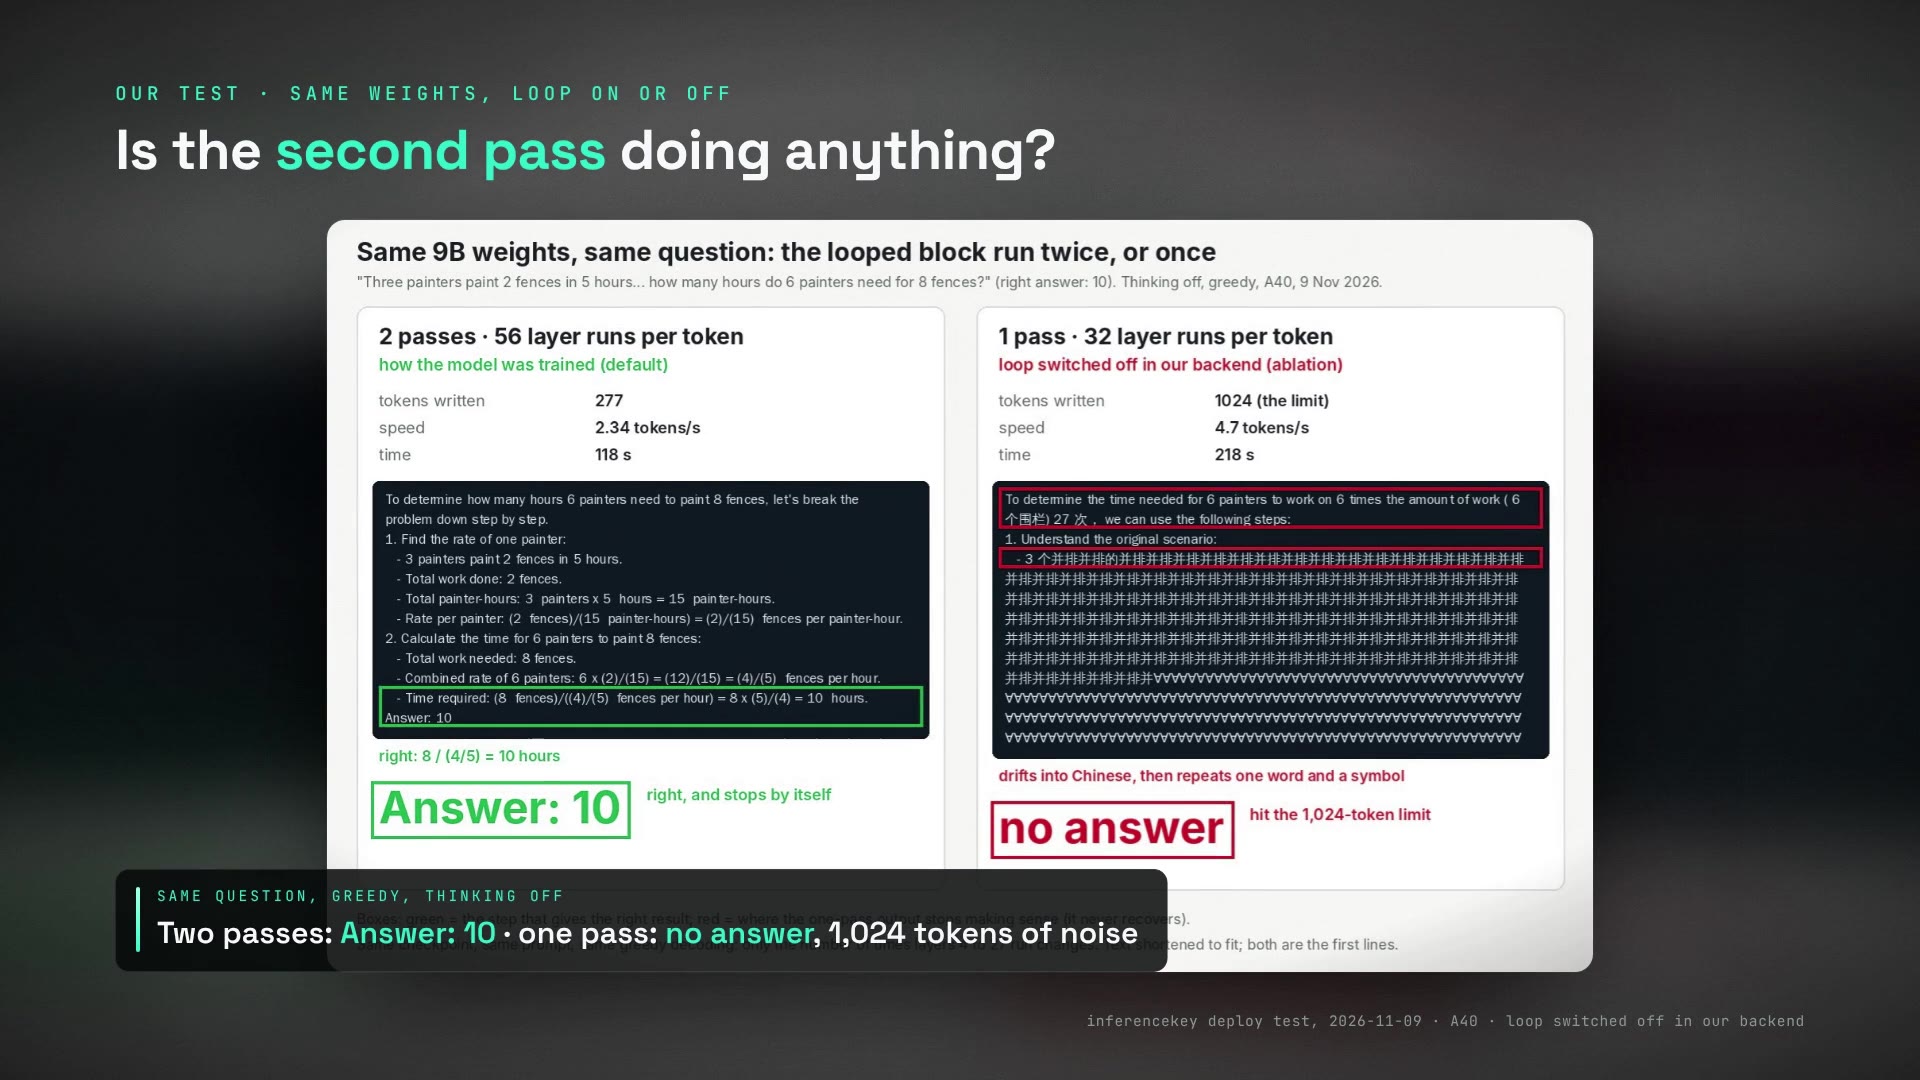
161 s, narrado: primero los ejemplos de muestra de los autores, la arquitectura y su gráfico de benchmarks, la respuesta sobre el gráfico a través del endpoint en la A40, la comparación del bucle, velocidades y memoria, y el worker real de 20 GB. Una corrección: el inserto de velocidad dice que ningún motor público ejecuta todavía el MTP. LightLLM main documenta el MTP en configuraciones de varias GPU (ver arriba); no lo probamos.
Fuentes
- Ficha del modelo y código: https://huggingface.co/sensenova/SenseNova-Loop-9B-Preview (revisión
9937e91c,config.json,modeling_sensenova_loop.py) - GitHub: https://github.com/OpenSenseNova/SenseNova-Loop
- GGUF: https://huggingface.co/AtomicChat/SenseNova-Loop-9B-Preview-GGUF
- PR de SGLang: https://github.com/sgl-project/sglang/pull/47281
- PR de vLLM: https://github.com/vllm-project/vllm/pull/64832
- LightLLM: https://github.com/ModelTC/LightLLM/pull/1665, https://github.com/ModelTC/LightLLM/pull/1695
- Issue de llama.cpp: https://github.com/ggml-org/llama.cpp/issues/31571
- Dónde lo vimos: AI Search, https://www.youtube.com/watch?v=IGICYFyP_EI (1 de noviembre de 2026, en el 51:58)
- Ejemplo del SDK: https://github.com/inferencekey/inferencekey-sdk/tree/main/examples/sensenova-loop-9b-vision-chat-custom-backend-private-nvidia