Qwen3.5-0.8B: una IA editó el 0,016 % de sus pesos, y los bucles de razonamiento bajaron del 93 % a cerca del 32 %
Sin entrenar, dos capas editadas. Las respuestas cortadas en el límite de tokens bajan del 93 % a cerca del 32 %. En 50 problemas: 62 % frente a 8 %.
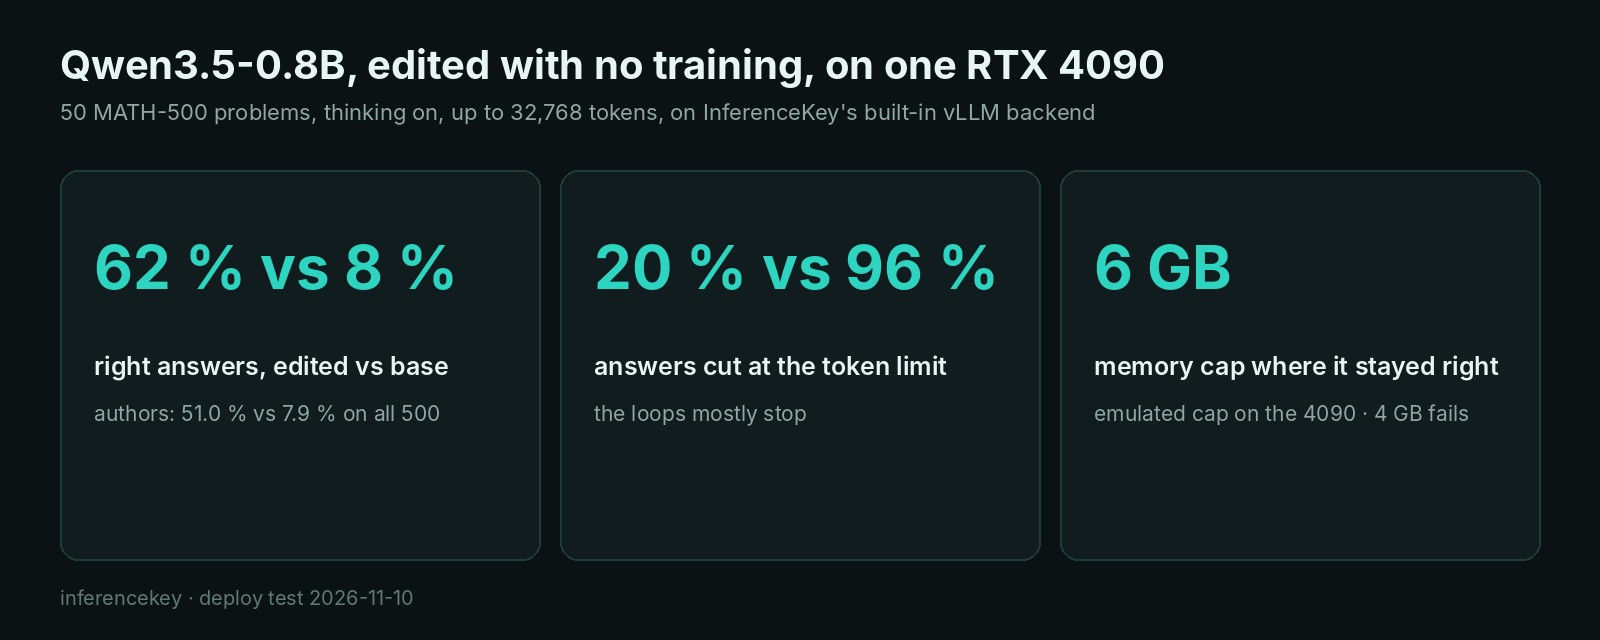
Otra IA cambió 64 columnas de números en cada uno de dos puntos de Qwen3.5-0.8B, un modelo de razonamiento abierto y pequeño, y lo hizo sin ningún entrenamiento. Ejecutamos el modelo editado y el original uno junto al otro en una RTX 4090 de nuestra nube, con los mismos 50 problemas de matemáticas y los mismos ajustes. El editado acertó el 62 %. El original, el 8 %, porque el 96 % de sus respuestas no terminaban nunca: seguía pensando en círculos hasta chocar con el límite de 32.768 tokens (trozos de palabras). Si sirves modelos de razonamiento pequeños en tus propias GPU, esto va tanto de coste como de precisión. Una respuesta que no termina ocupa una plaza en tu tarjeta hasta que el límite la corta, y casi nunca da una respuesta. El fichero editado se carga y se sirve con el mismo comando que el modelo base. Solo comprobamos matemáticas con el razonamiento activado.
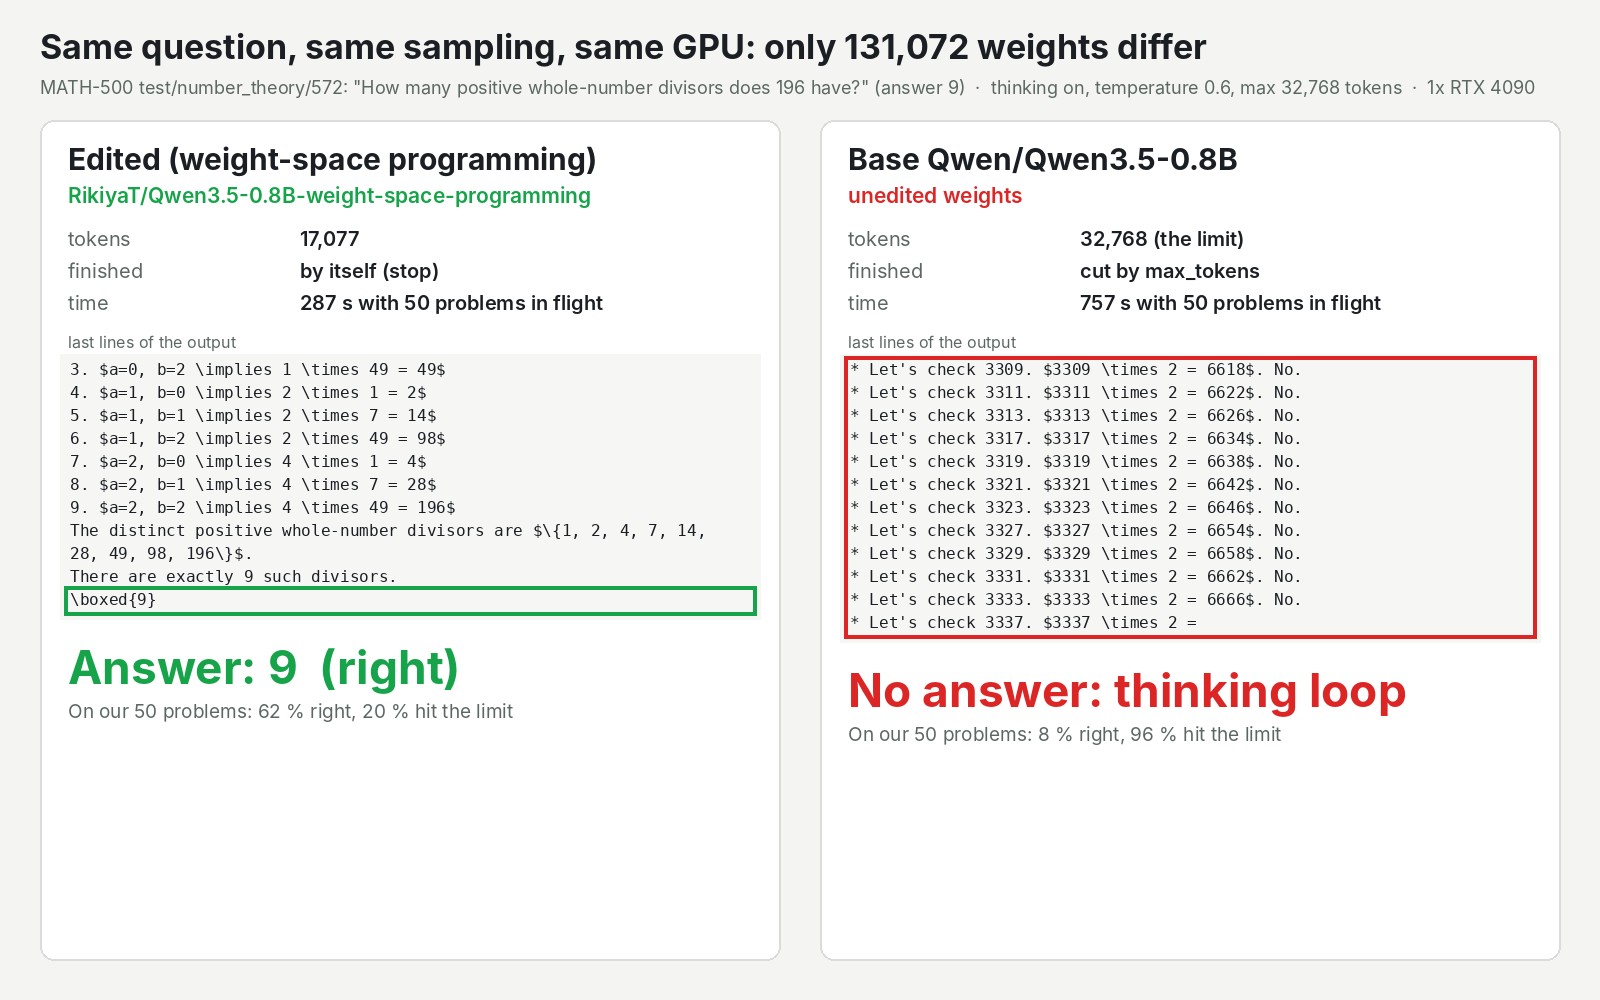
La pregunta de la imagen es sencilla: ¿cuántos divisores tiene 196? La respuesta es 9. El modelo editado la encontró y se detuvo. El modelo base se puso a enumerar números por encima de 3.300, uno a uno, y seguía cuando el límite lo cortó.
| En nuestros 50 problemas de matemáticas de competición (MATH-500) | Editado | Base |
|---|---|---|
| Respuestas correctas | 62 % | 8 % |
| Respuestas cortadas en el límite de 32.768 tokens | 20 % | 96 % |
| Tokens de media por respuesta | 20.444 | 31.832 |
Un modelo que no encuentra el final, y una edición que se lo da
La edición hace una sola cosa: quita la costumbre que hacía entrar al modelo en bucle. Las matemáticas que el modelo acierta ya estaban ahí.
Qwen3.5-0.8B es un miembro de la familia Qwen3.5 con unos 0.8B números aprendidos (los pesos). Antes de responder, un modelo de razonamiento escribe un borrador: piensa en voz alta y después da el resultado. La propia ficha del modelo de Qwen avisa de que este tamaño es "more prone to entering thinking loops" que sus hermanos. Imagina una banda que no encuentra el final de una canción. Todos siguen afinados, pero el cierre da vueltas y vueltas hasta que el técnico de sonido desenchufa. En una GPU, el técnico de sonido es el límite de tokens, y cada token que escribe el modelo ocupa tiempo de tarjeta.
El 2 de noviembre de 2026, un equipo del MIT CSAIL publicó un artículo en su blog sobre lo que llaman programación en el espacio de pesos. En uno de sus experimentos, un modelo grande al que llaman GPT-6 Astra recibe una herramienta para inspeccionar y cambiar los números del modelo pequeño. También recibe problemas de práctica, ninguno del test con el que se le evalúa. Su presupuesto es un número de ejecuciones de práctica del modelo pequeño: 10, 25 o 50. Astra observa lo que hace el modelo, lee sus entrañas y edita los números directamente. Sin entrenamiento de ningún tipo.
De las primeras 96 respuestas de práctica del modelo base, 85 llegaron al límite de 32.768 tokens. Con 50 ejecuciones, Astra encontró el patrón detrás de los bucles en dos puntos del modelo y lo borró de 64 columnas de números en cada uno. Son 131.072 pesos de todo el modelo: el 0,016 %. En MATH-500, un conjunto estándar de 500 problemas de matemáticas de competición, los autores dan un salto del 7,9 % al 48,1 % de aciertos. La proporción de respuestas cortadas en el límite bajó del 93 % al 33,1 %. Dan saltos parecidos en otros dos tests, que no repetimos (ver el apéndice).
Los autores publicaron el cambio exacto y un script que lo reconstruye. El usuario de Hugging Face akhaliq reconstruyó el fichero del modelo editado, lo volvió a ejecutar con los 500 problemas y montó una demo pública. Su repetición acertó el 51,0 %, con el 31,6 % de las respuestas cortadas en el límite. Vimos la noticia en el vídeo de noticias de AI Search del 8 de noviembre.
62 % de aciertos frente a 8 % en una RTX 4090, y los bucles bajan del 96 % al 20 %
Con los ajustes de evaluación de los autores, el fichero editado cortó la mayoría de sus bucles en nuestro hardware y acertó casi ocho veces más respuestas.
Los dos modelos funcionaron uno junto al otro en una sola RTX 4090 de 24 GB de nuestra nube, cada uno detrás de su propio endpoint de API. Los dos usaron vLLM, el motor de servicio de código abierto que usó la repetición de akhaliq, con el borrador de razonamiento activado y con los ajustes de aleatoriedad de los autores.
Las preguntas fueron los primeros 50 problemas de MATH-500 en el orden de la repetición de akhaliq, un intento por problema, hasta 32.768 tokens por respuesta. Los 50 se lanzaron a la vez para cada modelo, con los dos modelos al mismo tiempo. Los corregimos con el propio script de corrección de los autores.
| Editado | Base | |
|---|---|---|
| Correctas | 31 de 50 (62 %) | 4 de 50 (8 %) |
| Cortadas en 32.768 tokens | 10 (20 %) | 48 (96 %) |
| Tokens de media por respuesta | 20.444 | 31.832 |
Nuestro 62 % está por encima de las dos cifras publicadas. Eso es la muestra pequeña: en estos 50 problemas, la repetición de akhaliq dio una media del 54 %, y nuestras respuestas coincidieron con su resultado habitual en 42 de 50. El 8 % y el 96 % del modelo base caen justo en las cifras de los autores.
Las dos veces que el modelo base terminó una respuesta, acertó. Sus otras 2 respuestas correctas salieron de bucles que habían escrito el número correcto antes de que el límite los cortara.
El ahorro: 1,02 millones de tokens en lugar de 1,59 millones para los mismos 50 problemas
En los mismos 50 problemas, el modelo editado dio una media de 20.444 tokens por respuesta y el base de 31.832, y el 20 % de las respuestas editadas se cortaron en el límite frente al 96 %. Por respuesta correcta: unos 5 minutos de tiempo de lote frente a 32 segundos (398.000 tokens frente a 33.000). Esa diferencia se apoya en solo 4 respuestas correctas del base, así que tómala como aproximada.
Una GPU sirve un número fijo de respuestas a la vez. Con el modelo base, casi todas esas plazas estaban atascadas en un bucle, hasta 12,6 minutos en la pregunta de los divisores. El modelo editado sigue escribiendo respuestas largas, pero la mayoría terminan con un resultado.
¿Por qué no bajar sin más el límite, o vigilar el stream y parar un bucle, como sugiere la ficha de Qwen? Así un bucle falla antes y ahorra tiempo de tarjeta. No lo hemos probado, ni tampoco el razonamiento desactivado, con el modelo base, así que pruébalo antes de cambiar de fichero.
Dónde deja de funcionar: quita bucles, no añade capacidad
La edición corrigió una mala costumbre. No hizo más listo al modelo, y los propios autores lo dicen.
Probaron el mismo enfoque con Gemma 3 270M, un modelo que rara vez entra en bucle: solo el 8,5 % de sus respuestas llegaban al límite. Astra no pudo mejorarlo. Se quedó entre el 6,8 % y el 7,7 % en MATH-500 fuera cual fuera el presupuesto. En sus palabras: "Editing weights could remove an obstacle that hid an ability, but it could not add an ability the model lacked." Así que no esperes que funcione con un modelo cuyo problema no sean los bucles.
Incluso editado, una quinta parte de nuestras respuestas siguió en bucle, y otras 3 terminaron sin respuesta final. Las respuestas son largas, así que una sola respuesta tarda alrededor de un minuto ella sola. Y el salto solo llegó con el presupuesto más grande: con 10 o 25 ejecuciones, las ediciones de Astra dejaron al modelo en el 12,3 % y el 14,1 %.
El vídeo de AI Search también avisa contra el bombo, y menciona un análisis que al parecer llevó al modelo sin editar a cerca del 44 % en MATH-500 solo cambiando ajustes. El vídeo no cita la fuente, y no lo hemos comprobado.
Solo probamos matemáticas con el razonamiento activado. No comprobamos chat general, seguimiento de instrucciones, razonamiento desactivado ni imágenes con el fichero editado. La ficha de Qwen dice que el modelo de 0.8B funciona con el razonamiento desactivado por defecto.
Qué GPU: el modelo editado terminó con un tope de memoria emulado de 6 GB
Esta prueba muestra que el modelo arranca y termina respuestas largas con cada tope. Usamos cinco problemas que ya había resuelto en el lote, y dio las mismas cinco respuestas correctas con 6 GB que con 8 GB, en el mismo tiempo. Con 5 GB solo pasó después de recortar el espacio reservado para conversaciones en paralelo de 256 a 32. Con 4 GB no arrancó.
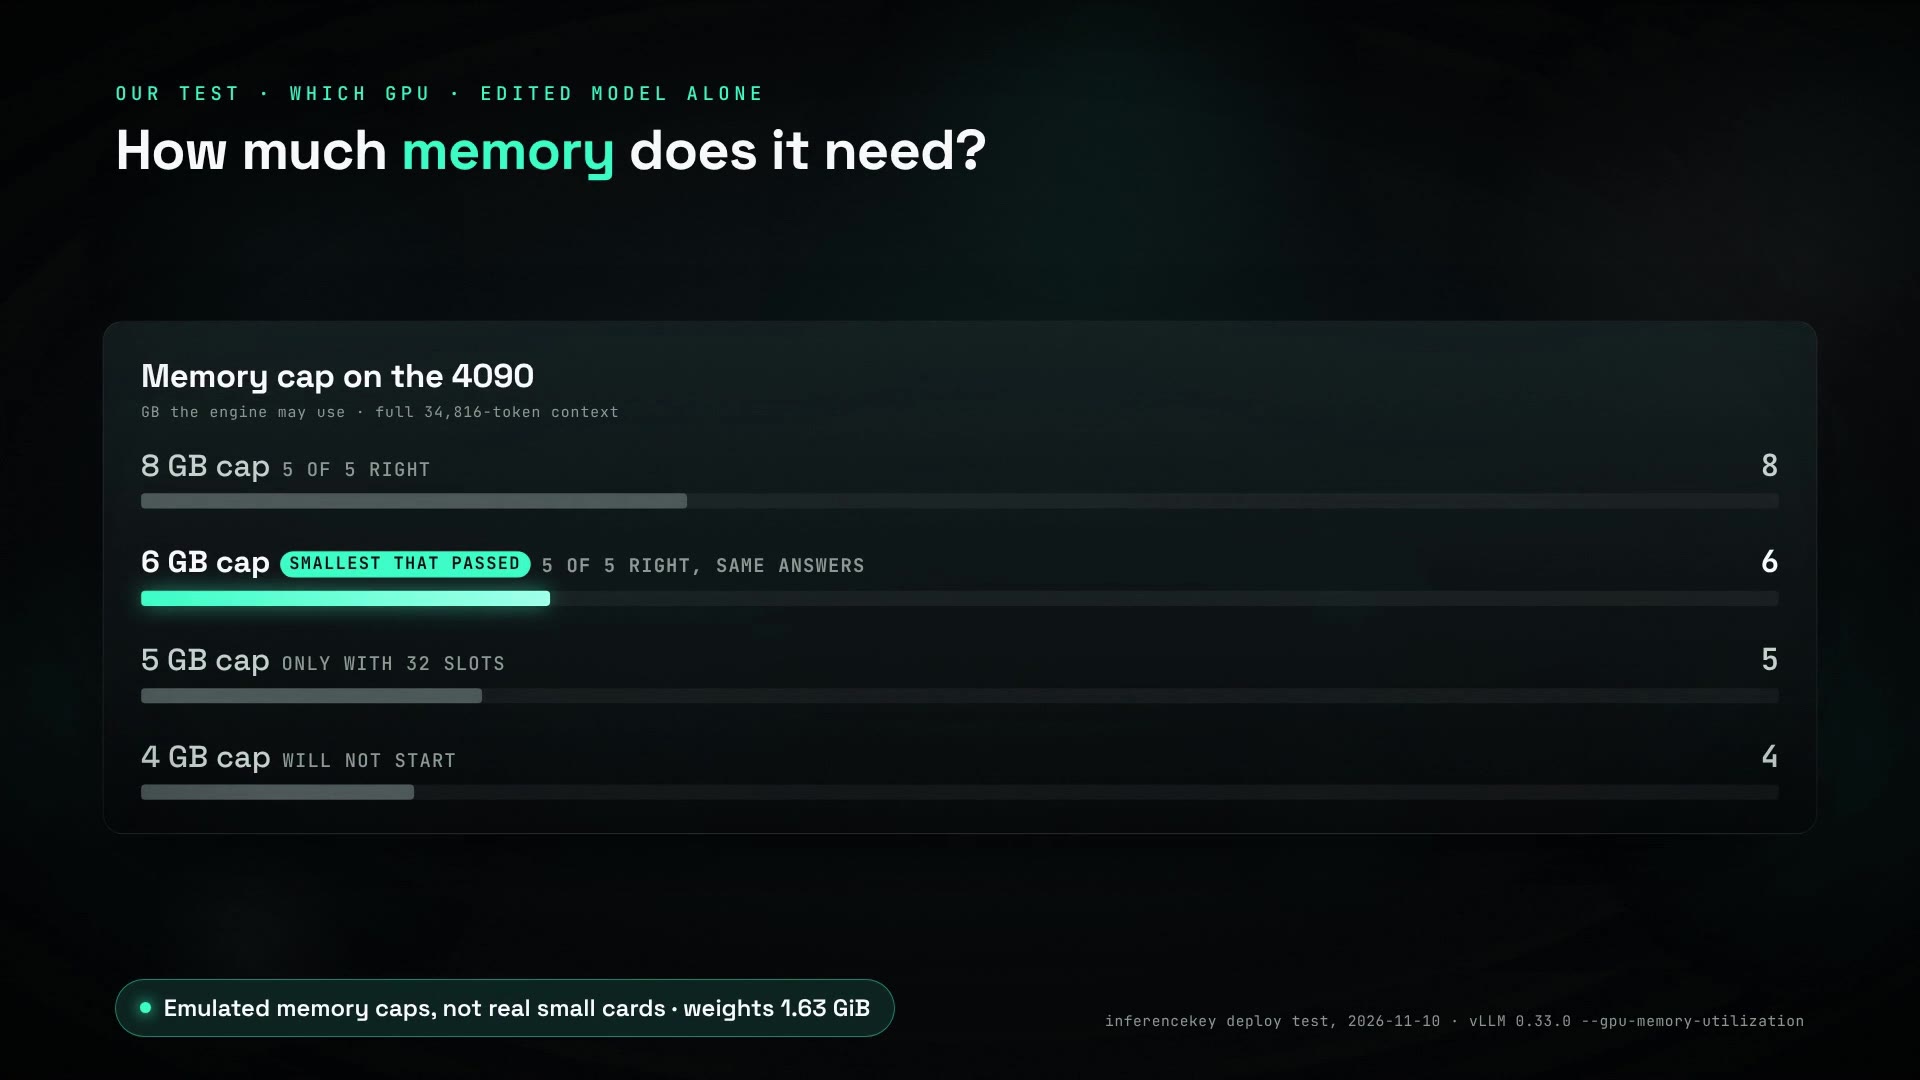
Todos los topes por debajo de 24 GB fueron un límite que pusimos en la 4090. No ejecutamos una tarjeta real de 6 u 8 GB. Una tarjeta pequeña real también tiene una memoria más lenta, así que cuenta con que vaya más despacio que esto. No probamos el tope de 4 GB con un límite de respuesta más corto, ni una versión comprimida del modelo.
En InferenceKey: el base y su gemelo editado en una tarjeta de 24 GB, listos en 7 minutos
Una tarjeta de 24 GB alojó a la vez el base y su gemelo editado, cada uno con menos de media tarjeta, con 16,9 GiB usados en el pico. Los dos estuvieron listos 418 segundos después de pedirlos, partiendo de una máquina en frío. Unos tres minutos se fueron en instalar vLLM, y otros tres más o menos en el calentamiento del propio motor. Con esa instalación ya en la máquina, un motor nuevo estaba listo en alrededor de un minuto.
Nuestra API todavía no puede cambiar algunos ajustes por petición, como el interruptor del razonamiento, así que los fijamos en el servidor para todos los que llaman.
Un problema con el que te vas a encontrar: una respuesta del modelo base recibida en streaming a través del endpoint se paró a los 152 segundos, sin ningún error que nuestro cliente pudiera ver y sin marca de final. Para un cliente, una respuesta cortada parece una terminada. Sospechamos del timeout de dos minutos de silencio de la plataforma, que enviaría un error que nuestro script de ejemplo ignora, pero la causa no está confirmada. Hasta entonces, comprueba que cada respuesta en streaming diga que terminó como es debido antes de fiarte de ella.
¿Deberías usarlo? Pruébalo si sirves Qwen3.5-0.8B con el razonamiento activado
- Si ya sirves Qwen3.5-0.8B con el razonamiento activado y le mandas matemáticas: prueba el cambio. Tiene el mismo tamaño y la misma licencia, y funciona con el mismo motor.
- Si quieres las mejores matemáticas de un modelo diminuto: tómalo como un arreglo, no como una mejora. Saca lo que el modelo ya sabía, y sigue escribiendo respuestas largas.
- Si estás dimensionando una GPU: el resultado de 6 GB se emuló en una tarjeta de 24 GB, no en una tarjeta real de 6 GB; mira la sección de memoria.
- Si ejecutas otro modelo pequeño que entra en bucle: esto es un método publicado con logs, no un producto. El resultado de Gemma dice que solo ayuda cuando el problema son los bucles.
Para ejecutar la misma comparación en tu propia máquina con GPU, usa el ejemplo del SDK de la edición de pesos de Qwen3.5-0.8B con IK_WITH_BASELINE=1. Necesita una máquina NVIDIA registrada (un worker) con una tarjeta de 24 GB y unos 15 GB de disco libre. Las claves de acceso y la compilación local del SDK están en el paso a paso de abajo. Borra los dos workloads al terminar.
Para ingenieros
Créditos
- El equipo de Qwen: Qwen/Qwen3.5-0.8B, Apache-2.0, incluido el aviso sobre los bucles en la ficha.
- Rikiya Takehi, Jayden Teoh (contribución a partes iguales), Alex Zhang, Omar Khattab, MIT CSAIL: el método, el Experimento 8, el diff exacto bit a bit y
apply_edit.py, que reconstruye la edición y verifica sus hashes, y los logs. Artículo del blog (2 de noviembre de 2026), checkpoint, logs y diffs. El modelo que edita es "GPT-6 Astra". - akhaliq, con ML Intern en HF Jobs (2026-11-02): reconstruyó la edición en CPU, verificó sus hashes y montó el checkpoint de Hugging Face y su ficha; la repetición independiente con MATH-500 completo; el Space de la demo (publicado primero como
akhaliq/weight-space-programming-demo, Gradio sobre ZeroGPU). - AI Search: donde lo vimos, vídeo 9RIK3A24ZxA, del 12:01 al 16:59.
- Verificación: el repositorio de logs de los autores contiene el diff exacto respecto al base y
apply_edit.py, que comprueba el sha256 de cada tensor reconstruido; akhaliq los usó para reconstruir y verificar el checkpoint. - Nuestra parte: servir los dos en una tarjeta (no recalculamos los hashes de los tensores; el fichero se sirvió tal como está publicado) a través de InferenceKey, la comparación con 50 problemas, las tomas del endpoint, la escalera de memoria y el ejemplo del SDK.
El modelo y la edición
| Elemento | Valor |
|---|---|
| Repo editado | RikiyaT/Qwen3.5-0.8B-weight-space-programming, sha d1671a178705bcab7644806d23c535517f35723b, Apache-2.0, un shard bf16 de 1.746.943.032 bytes (1,75 GB, 1,63 GiB) |
| Repo base | Qwen/Qwen3.5-0.8B, sha 2fc06364715b967f1860aea9cf38778875588b17, Apache-2.0, shard de 1.746.942.600 bytes |
generation_config.json | no lo incluye ninguno de los dos repos |
| Arquitectura | Qwen3_5ForConditionalGeneration (la versión multimodal completa). El artículo evaluó una exportación solo de texto; los tensores del LM tienen hashes idénticos y los prompts de texto no usan la torre de visión |
| Tensores cambiados | model.language_model.layers.15.mlp.down_proj.weight sha256 82e2d733ea64feaeb4af93a1e065641d3df98b494a8b7576ef2f52e90fe2ee53; model.language_model.layers.19.mlp.down_proj.weight sha256 8ef3c61bc36af113ad58e89dbb0a4a14dcba5a45cb750c15ab515c82ddd12eb2 (bytes bf16 en bruto) |
| Forma | cada uno [1024, 3584] bf16, 64 columnas cambiadas, 131.072 pesos tocados (0,016 %) |
Manifiesto (exp8_math/runs/p50c/edit/manifest.json) | entradas cambiadas 65.260 (capa 15) y 64.928 (capa 19), 130.188 en total (no se cuentan las entradas tocadas que al redondear vuelven al mismo valor bf16); cambio relativo 0,106 y 0,081 |
| Reconstrucción | exp8_math/code/apply_edit.py verifica con sha256 cada tensor reconstruido contra el checkpoint evaluado en el artículo |
| Licencia de los logs | la ficha dice CC BY 4.0 / MIT; GitHub indica NOASSERTION |
Experimento 8: Astra atribuyó los bucles a una dirección escrita por los MLP de las capas 15 y 19 y la restó de 64 columnas de salida de down_proj en cada una. Entorno: un kernel de Python sobre los pesos (sin GPU para Astra), problemas de práctica (7.469 problemas de entrenamiento de GSM8K y 7.275 de MATH, no los conjuntos de test), un presupuesto de 10, 25 o 50 pasadas hacia delante (una pasada: hasta 512 problemas respondidos o 1.024 textos leídos). Evaluación: razonamiento activado, hasta 32.768 tokens, temperature 0,6, top-p 0,95, top-k 20, presence penalty 1,5. MATH-500 promedia 4 muestras, GSM8K e IFEval 2.
Cifras de los autores (no reproducidas por nosotros salvo MATH-500 con 50 problemas)
| MATH-500 | GSM8K | IFEval | Llegan al límite de tokens | |
|---|---|---|---|---|
| Base | 7,9 | 13,8 | 21,0 | 93,0 % |
| Editado, 10 pasadas | 12,3 | 25,7 | 49,0 | 87,2 % |
| Editado, 25 pasadas | 14,1 | 25,1 | 39,9 | 86,4 % |
| Editado, 50 pasadas (el checkpoint publicado) | 48,1 | 67,1 | 62,3 | 33,1 % |
Gemma 3 270M: base 6,8 % en MATH-500, editado 7,0 / 7,6 / 7,7 / 7,0 % con 5 / 10 / 25 / 50 pasadas, el 8,5 % de las respuestas del base llegan al límite.
Repetición independiente (akhaliq, 2026-11-02): MATH-500 completo, 500 x 4 = 2.000 generaciones, 43.407.495 tokens, 3.059 s en una H200, vLLM 0.33.0, transformers 5.20.2, math-verify 0.9.0, seed 0: 51,0 % correctas, 31,6 % llegan al límite, 14.190,9 tokens/s, media de 21.704 tokens. Prueba rápida del base, 25 problemas x 4: 5,0 % correctas, 95 % llegan al límite, media de 31.690 tokens.
La ficha del modelo no indica una versión mínima de vLLM. La repetición usó la 0.33.0 y nosotros también. No se probó ninguna otra versión.
Montaje
- Una RTX 4090 de 24 GB en InferenceKey Cloud (driver 595.91.07, CUDA 13.2), los dos modelos en la misma tarjeta.
- Manager local de InferenceKey compilado desde
origin/maineb1ee503, backendvllmintegrado,vllm_version="0.33.0". Producción no se tocó. - Comando de servicio, por workload:
vllm serve <model> --dtype bfloat16 --max-model-len 34816 \
  --gpu-memory-utilization 0.45 \
  --default-chat-template-kwargs '{"enable_thinking": true}' \
  --override-generation-config '{"temperature": 0.6, "top_p": 0.95, "top_k": 20, "presence_penalty": 1.5}'
Usa --gpu-memory-utilization 0.90 cuando el modelo editado funcione solo. El log de vLLM confirma el override: "Default vLLM sampling parameters have been overridden ... {'presence_penalty': 1.5, 'temperature': 0.6, 'top_k': 20, 'top_p': 0.95}".
Por qué en el servidor: en eb1ee503, el ChatSampling del manager (crates/shared/src/models.rs) reenvía temperature, max_tokens, top_p, stop, presence_penalty, frequency_penalty y seed. top_k y chat_template_kwargs no se reenvían, y el generate_text() del SDK no tiene presence_penalty ni top_k.
Paso a paso con el ejemplo del SDK
Carpeta: examples/qwen3-5-0-8b-weight-edit-math-vllm-private-nvidia (commit 7661793, más 07215bb).
- Compila el SDK en local con maturin e instala el
requirements.txtdel ejemplo. - Copia
.env.examplea.envy rellena un tokenik_sdk_, una API keyik_live_limitada a<project>/*, el slug del proyecto eIK_WORKER_ID(un worker NVIDIA registrado con unos 15 GB de disco libre). - Opcional:
IK_WITH_BASELINE=1despliega el modelo base junto al editado (0.45 de la tarjeta cada uno),IK_MAX_TOKENS(por defecto 32.768),IK_KEEP_ALIVE=1mantiene los workloads después de la ejecución. python main.py. Llama aensure()para cada workload y await_until_ready(), envía en streaming el problematest/number_theory/572de MATH-500 (divisores de 196, respuesta 9) a cada endpoint por HTTP simple, imprime los tokens, el tiempo y la respuesta de la caja, y borra los workloads salvo queIK_KEEP_ALIVE=1.- Para un presupuesto de 5 GB añade
--max-num-seqs 32al comando (documentado en el ejemplo).
Tiempos
| Paso | Editado | Base |
|---|---|---|
De ensure() a listo, worker en frío | 418,1 s | 418,2 s |
pip install vllm==0.33.0 | unos 3 min (compartido) | |
| Carga de pesos (descargados de antemano) | 0,29 a 0,32 s | |
| Inicio del motor (perfilado, KV cache, calentamiento) | 181,7 s | 186,0 s |
| de ello, torch.compile | 17,3 a 17,7 s | |
| CUDA graphs | 8 a 9 s | |
| Motores de la escalera en caliente, uno cada vez | 60 a 63 s (133 s en el peldaño de 5 GB) |
MATH-500, 50 problemas por modelo
Los primeros 50 ids de problema en el orden del fichero de la repetición de akhaliq eval/scores_edited_math500.json (en el checkpoint de HF), 1 muestra, seed 0, máximo 32.768 tokens nuevos, los 50 en vuelo por modelo, los dos modelos a la vez, con las peticiones enviadas directamente a los dos servidores vLLM que lanzó la plataforma. Corregido con el mathqa.py de los autores (el último \boxed{} de toda la salida) y math-verify 0.9.0; recalculado a partir de los ficheros corregidos, idéntico.
| Editado | Base | |
|---|---|---|
| Correctas | 31/50 (62 %) | 4/50 (8 %) |
| Llegan a 32.768 tokens | 10 (20 %) | 48 (96 %) |
| Terminadas sin caja | 3 | 0 |
| Tokens medios / máximos | 20.444 / 32.768 | 31.832 / 32.768 |
| Mediana de tokens de las respuestas terminadas | 17.477 (40 terminadas) | 9.377 (2 terminadas, las dos correctas; las otras 2 respuestas correctas se cortaron en el límite después de encerrar en la caja la respuesta correcta) |
| Tokens totales / tiempo real | 1.022.176 en 986,7 s | 1.591.617 en 1.194,4 s |
| Tokens por respuesta correcta | unos 33.000 | unos 398.000 |
| Por materia | álgebra 10/12, teoría de números 5/7, preálgebra 4/7, precálculo 4/7, geometría 3/5, álgebra intermedia 3/8, combinatoria 2/4 | preálgebra 2/7, álgebra 2/12, el resto 0 |
| Repetición de akhaliq | los mismos 50: 54 % (media de 4 muestras); nuestro acierto o fallo con 1 muestra coincide con su mayoría en 42/50 | prueba rápida del base, 25 problemas x 4: 5 % (95 % cortadas) |
Rendimiento: una petición sola, de 300 a 380 tokens/s; dos a la vez a través de los endpoints, unos 175 tokens/s cada una; de 3.100 a 4.300 tokens/s por motor al principio con 50 en marcha, bajando a medida que se llenaba la KV cache. En el agregado de la ejecución: unos 1.036 tokens/s el editado frente a 1.333 el base, una comparación que no es justa: los dos motores arrancaron en el mismo momento y el editado se quedó con la mitad de la memoria de trabajo, así que empezó a encolar antes. Detalles: la KV cache se repartió en 6,48 GiB para el base (517.266 tokens) frente a 3,32 GiB para el editado (265.098 tokens) con el mismo ajuste de 0.45, porque los dos motores perfilaron la memoria en el mismo momento, así que el motor editado encoló peticiones (99 % de KV, 22 en marcha y 21 esperando en un momento dado). La ejecución completa de 100 problemas (2,61 M tokens) tardó 1.194 s.
Problema 572 (divisores de 196)
- A través de los endpoints de la plataforma, los dos a la vez, grabado: el editado dio
\boxed{9}en 14.518 tokens, 87 s. El base, 32.768 tokens tras 138 s, sin respuesta, con las últimas líneas repitiendo "Wait, $14 \times 14 = 196$." - Ejecución por lotes: el editado, 17.077 tokens, se detuvo, correcta, unos 287 s con 50 en vuelo. El base, 32.768 tokens, cortada, enumerando "Let's check 3309. $3309 \times 2 = 6618$. No." hacia arriba, unos 757 s. Es la imagen de la comparación principal.
Memoria de GPU y escalera de VRAM
Pesos de 1,63 GiB por modelo. Pico de la tarjeta de 17.282 MiB (16,9 GiB) con los dos motores a 0.45, 100 % de utilización, 286 W. Motor editado solo a 0.45, en reposo: 6.846 MiB.
Escalera: modelo editado solo, el mismo comando, --max-model-len 34816, 5 problemas que el modelo editado resolvió en el lote (572, 515, 807, 2584, 248) en vuelo, máximo 32.768. Cada peldaño por debajo de 24 GB es un tope puesto con --gpu-memory-utilization en la 4090, no una tarjeta real.
| GPU o tope | Config | KV cache | Resultado | Real o emulado |
|---|---|---|---|---|
| RTX 4090 24 GB | los dos modelos, 0.45 cada uno, 50 problemas cada uno | 6,48 / 3,32 GiB | 62 % frente a 8 % de aciertos, pico de 16,9 GiB | real |
| Tope de 8 GB | 0.333 | 4,3 GiB (343.186 tokens) | 5/5 correctas, de 25 a 96 s por respuesta, la más larga 31.606 tokens en 95,5 s | emulado |
| Tope de 6 GB | 0.245 | 2,23 GiB (177.561 tokens) | 5/5 correctas, salidas y tiempos idénticos a 8 GB (95,7 s) | emulado |
| Tope de 5 GB | 0.204, max_num_seqs por defecto 256 | falla: max_num_seqs (256) exceeds available Mamba cache blocks (202) | emulado | |
| Tope de 5 GB | 0.204, --max-num-seqs 32 | 1,74 GiB (138.766 tokens) | 5/5 correctas (textos distintos, otras formas de lote), la más larga 30.948 tokens en 97 s | emulado |
| Tope de 4 GB | 0.163 | 0,29 GiB | falla: necesita 0,44 GiB de KV cache para una petición de 34.816 tokens; vLLM sugiere un máximo de 22.304 tokens | emulado |
| Tope de 3 GB | 0.122 | -0,66 GiB | falla: no hay memoria disponible para los bloques de la cache | emulado |
No probado: una tarjeta pequeña real (ese día no había nada por debajo de 16 GB disponible, y no se probó la RTX 2000 Ada de 16 GB), 4 GB con un contexto más corto, fp8, más de 50 peticiones concurrentes, el camino de visión. Las tarjetas reales de 6 a 8 GB tienen menos ancho de banda de memoria: cuenta con que sean más lentas que estos tiempos.
Problemas pendientes
- Final silencioso de una respuesta del base en streaming (abierto). A través del endpoint, mientras la KV cache del motor base estaba saturada, el stream se cerró tras 152,3 s con 3.286 caracteres, sin
finish_reasony sinusage. Causa no confirmada, el SSE en bruto no se capturó. Eneb1ee503, el camino de streaming de GPU del manager usaSTREAM_IDLE_TIMEOUT_MS = 120_000y, al saltar el timeout, emite un chunk{"error":{"code":"inference_timeout",...}}seguido de[DONE]. Elask()del ejemplo solo leechoicesyusage, así que el cliente ignoraría un chunk así sin decir nada; el ejemplo todavía necesita un arreglo para mostrarlo. Comprueba en tu propio cliente que haya una claveerrory unfinish_reason. - pip concurrente en un mismo venv (abierto). Dos workloads con el mismo
vllm_versionejecutaronpip install vllm==0.33.0en el mismo venv a la vez. Aquí funcionó. Es una condición de carrera. - Reparto desigual de la KV (con apaño). Dos motores que arrancan juntos en una tarjeta perfilan la memoria a la vez y el segundo ve menos memoria libre. Arráncalos uno detrás de otro.
- Con 5 GB hace falta
--max-num-seqs 32(documentado en el ejemplo). - El modelo: el 20 % de las respuestas editadas siguen llegando a 32.768 tokens y 3 terminaron sin caja. Una ejecución temprana del ejemplo con un valor por defecto de 16.384 tokens cortó la respuesta editada, así que ahora el valor por defecto es 32.768.
- Menor: el
min_disk_gbde 60 en la petición de creación del worker se ignoró (se dieron 100 GB). El primer arranque de nats-proxy del stack local falló por falta deJWT_SECRET. - Corrección: el
mcqa.pyde los autores no está publicado. Un stub cubrió un import que solo se usa en las estadísticas de bucles; el código de corrección no se tocó. - No verificado por nosotros: GSM8K, IFEval; la mención del vídeo de AI Search a cerca del 44 % para el modelo sin editar con otros ajustes (sin fuente citada).
Vídeo de la demo
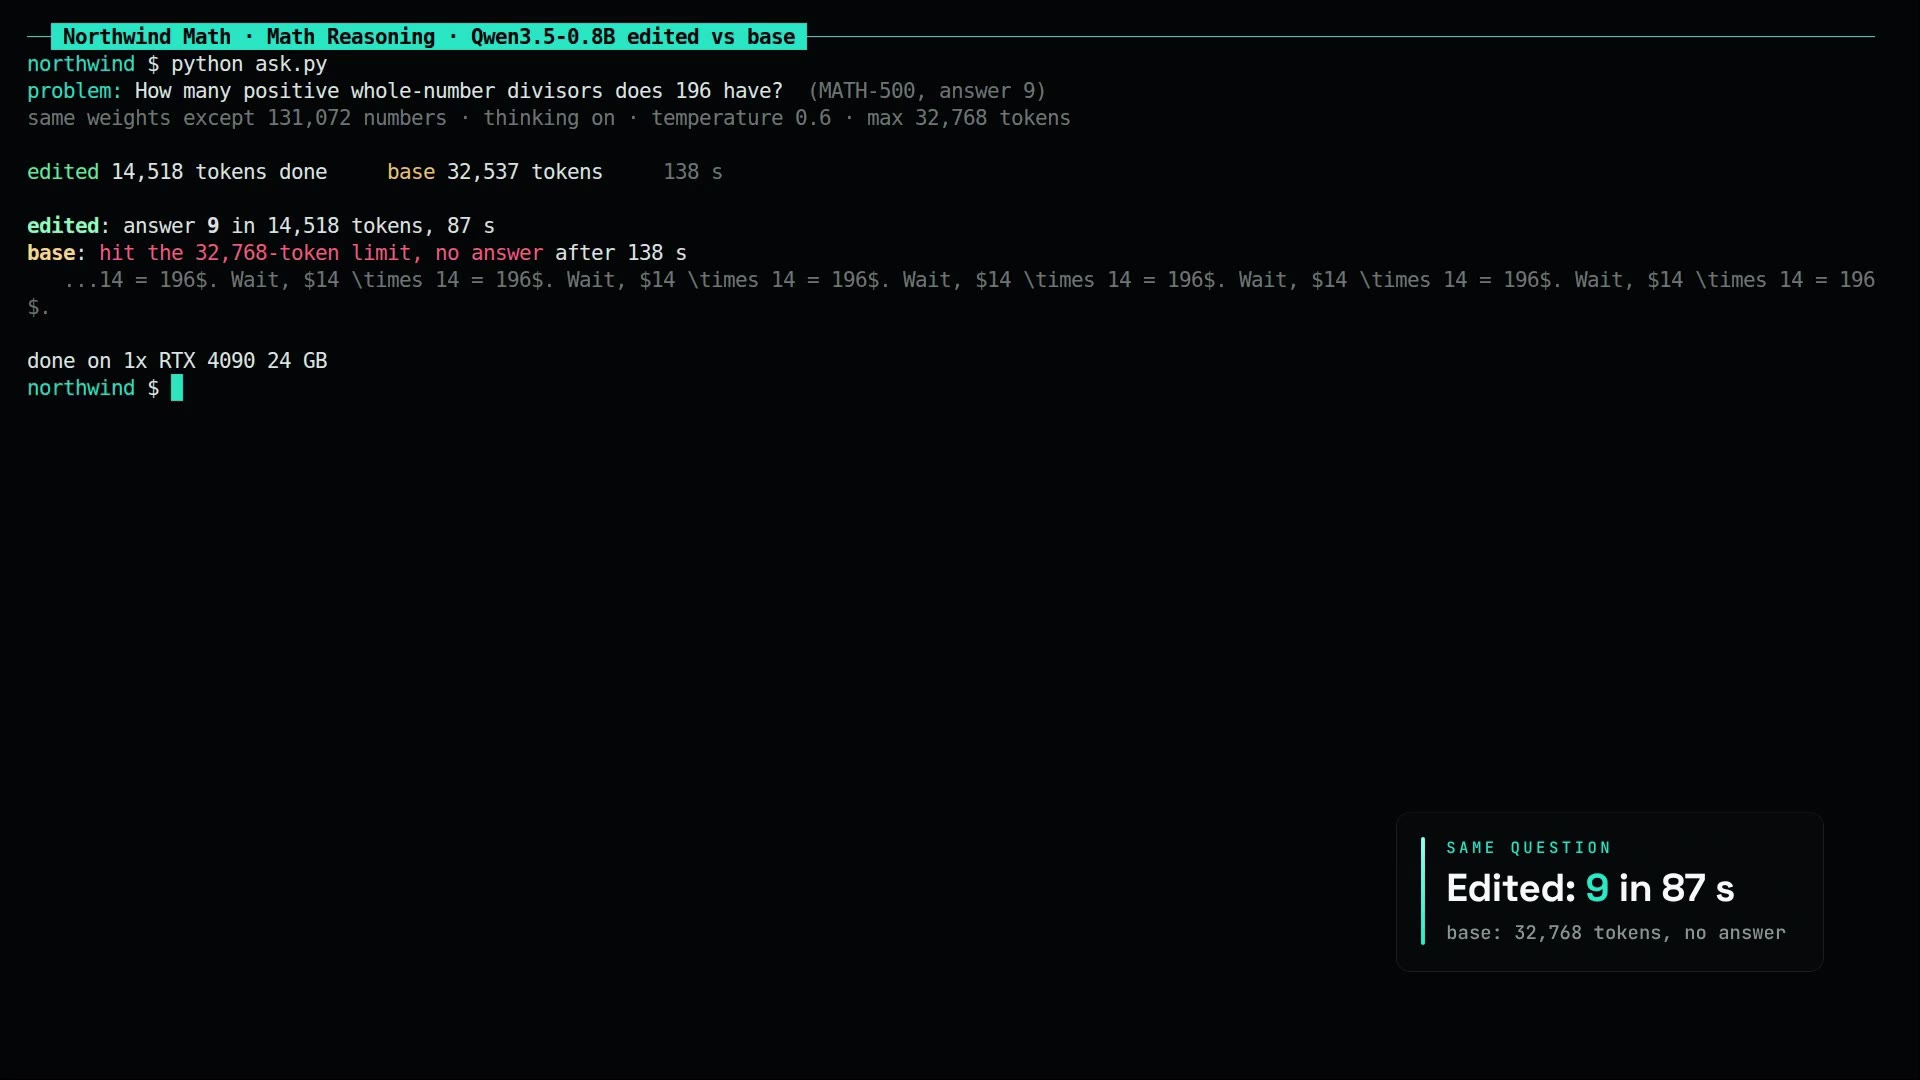
176,6 s, narrado: el blog de los autores con su reconocimiento, el aviso de Qwen sobre los bucles, las cifras de los autores y las nuestras, los dos modelos respondiendo a la pregunta de los divisores a través de los endpoints, y los topes de memoria.
Fuentes
- Blog: Sparks of Weight-Space Programming, Takehi, Teoh, Zhang, Khattab (MIT CSAIL), 2 de noviembre de 2026.
- Checkpoint editado y su ficha, con la repetición y los hashes: RikiyaT/Qwen3.5-0.8B-weight-space-programming.
- Modelo base y aviso sobre los bucles: Qwen/Qwen3.5-0.8B.
- Logs, diffs y
apply_edit.py: RikiyaT/lm_understand-logs. - Space de la demo: ML-Intern-lab/weight-space-programming-demo (antes
akhaliq/weight-space-programming-demo). - Dónde lo vimos: AI Search, 8 de noviembre de 2026.
- Nuestro ejemplo: inferencekey-sdk, qwen3-5-0-8b-weight-edit-math-vllm-private-nvidia.