SenseNova Code2Video auf einer RTX 4090: ein Entwurf in 10 Minuten, eine Lücke in jeder Reihe, kein fertiger Film
Ein 27B-Modell, das Videos per Code erstellt, lief in Claude Code auf einer 24-GB-Karte: ein Entwurf mit Layoutfehler, kein fertiger Film.
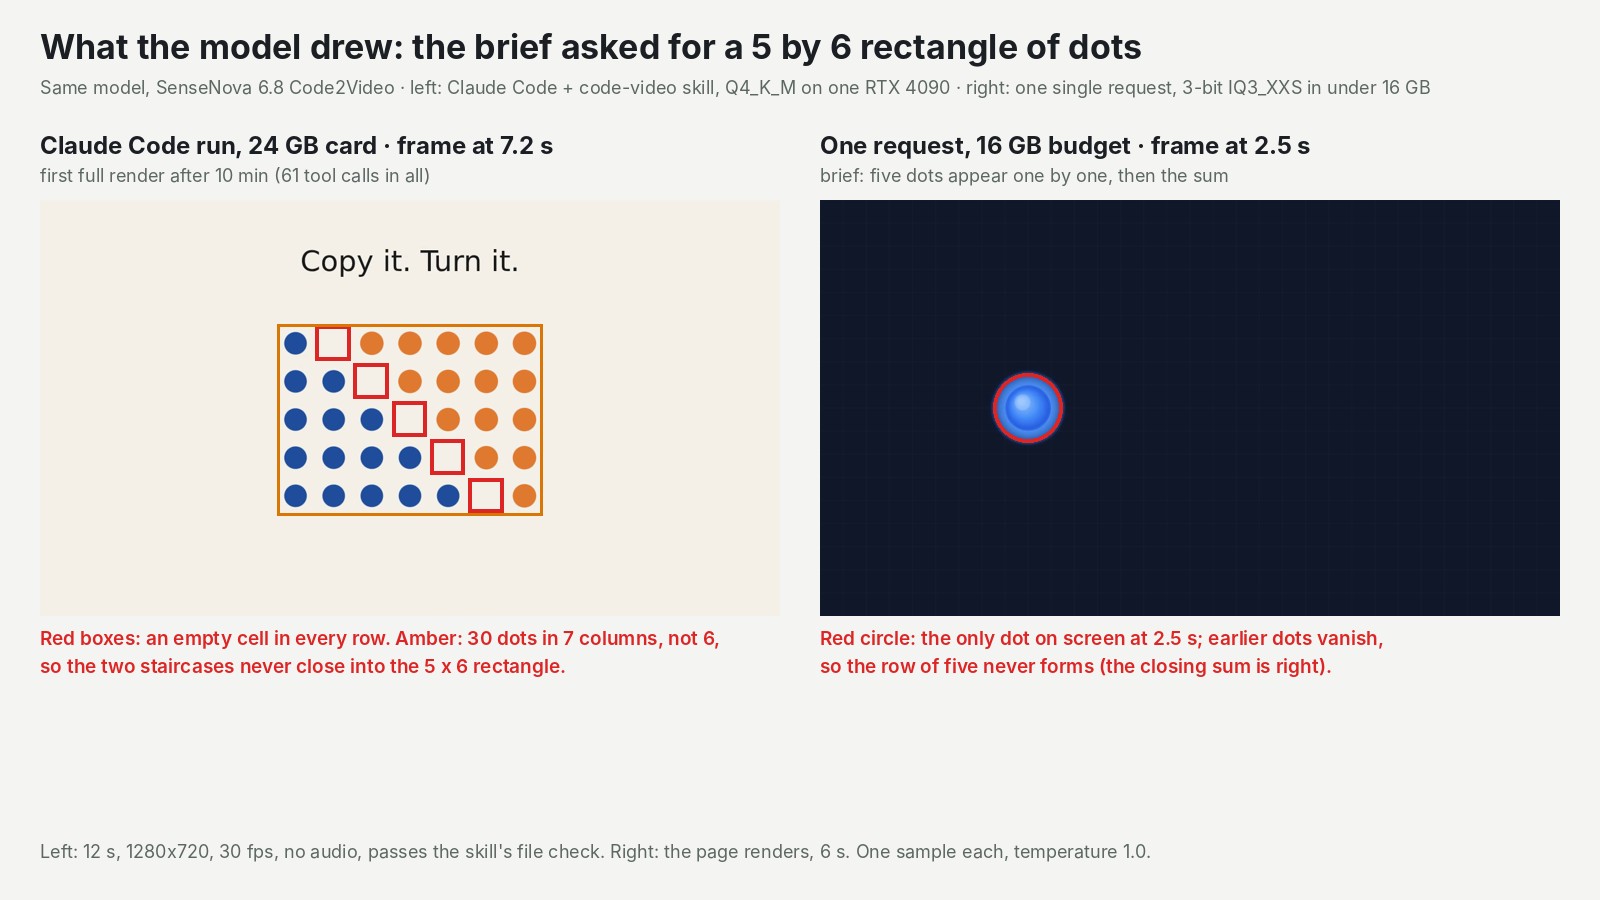
Für ein Erklärvideo brauchst du kein Videomodell. Ein Textmodell kann eine Webseite schreiben, die jedes Bild zeichnet, sie rendern, sich die Bilder ansehen und korrigieren, was es sieht. Genau das macht SenseNova 6.8 Code2Video, das offene 27B-Modell von SenseTime. Gesteuert von Claude Code lief es auf einer einzigen RTX 4090 mit 24 GB. Nach zehn Minuten hatte es einen kompletten 12-Sekunden-Clip, der seine automatische Dateiprüfung bestand. Das Bild war falsch: Punkte, die ein Rechteck aus 5 mal 6 bilden sollten, landeten in 5 Reihen zu 7, mit einer Lücke in jeder Reihe. Dann lief sein Arbeitsgedächtnis voll, also alles, was es gelesen und geschrieben hatte. Claude Code versuchte 21 Minuten lang, es zusammenzufassen, stieß jedes Mal an unser Limit für die Antwortlänge und wurde nie fertig. Das Modell passt auf eine Gaming-Karte, und unser SDK-Beispiel baut das Setup nach.
| GPU-Zeit auf einer RTX 4090 | Erster vollständiger 12-s-Render | Kleinste Kopie, deren Seite rendert |
|---|---|---|
| 32 der 40 Minuten mit dem Schreiben von Ausgabe beschäftigt | Ein Entwurf, ein Layoutfehler | Eine kleinere 3-Bit-Kopie lag auf der 4090 in der Spitze bei 13,7 GiB, unter 16 GB (Seite rendert, mit einem Bug) |
Ein Video aus Code: Das Modell schreibt ein Programm, rendert es und prüft die Bilder
SenseNova 6.8 Code2Video malt keine Pixel. Seine Autoren nennen es „a lightweight open model for code-driven video creation“, das „builds and renders videos by generating executable code“. Ein Clip ist eine Webseite, auf der jeder Zeitpunkt genau ein Bild hat. Ein Browser ohne Fenster geht diese Seite Bild für Bild durch, und ein Standard-Videotool klebt die Bilder zu einer MP4 zusammen.
Jedes Element auf dem Bildschirm ist dabei Code, du kannst also ein einzelnes Label oder eine einzelne Farbe ändern und neu rendern. Text erscheint genau so geschrieben, wie er im Code steht, weil er getippt und nicht gezeichnet wird. Und das „Videomodell“ ist ein ganz normales Text- und Bildmodell. Du betreibst es mit denselben Open-Source-Servern, die du schon für Chatmodelle nutzt.
SenseTime hat das Modell unter einer offenen Lizenz veröffentlicht, dazu einen Claude-Code-Skill (ein Paket aus Anweisungen und Skripten) namens code-video. Der Skill bringt dem Modell die Schleife bei: planen, die Seite schreiben, Standbilder rendern und sie sich „at least twice“ ansehen. Dann den Film rendern, eine Dateiprüfung laufen lassen und eine Verifikationsnotiz schreiben. Sein bester Rat passt in eine Zeile: „Get a rough full-length render early (even ugly), then improve it.“
Sie haben außerdem sechs komplette Produktionsläufe veröffentlicht. Jeder Film brauchte 261 bis 876 Runden, in denen das Modell schrieb, ausführte und prüfte, und 37 bis 99 angesehene Bilder. Laut Model Card „sustains runs of more than 10 hours and more than 2,000 turns“; das haben wir nicht überprüft. Die Autoren betreiben das Modell in voller Größe auf vier GPUs, mit einem Arbeitsgedächtnis, das fünfmal so groß ist wie unseres (512K Tokens). Sie sind auch offen: kein Benchmark, „clearly behind the strongest proprietary models on visual polish and long-horizon reliability“, und kein fotorealistisches Material.
Unsere Frage für den Test war also kleiner als ihre. Schafft eine komprimierte Kopie, ein Drittel so groß, einen kurzen Clip auf einer 24-GB-Karte, und in wie vielen Runden und Minuten? Wir haben keinen veröffentlichten Lauf gefunden, der das beantwortet.
Unser Test: ein 12-Sekunden-Auftrag, eine 24-GB-Karte, 40 Minuten Limit
Der Auftrag war ein stummes 12-Sekunden-Erklärvideo namens „Half a Rectangle“. Es zeigt 1 + 2 + 3 + 4 + 5 = 15 als Treppe aus blauen Punkten. Dann kopiert es die Treppe in Orange, dreht die Kopie und schließt beide zu einem Rechteck aus 5 mal 6, also 30 Punkten. Die Hälfte von 30 ist 15. Ein kleiner Auftrag mit einer einzigen Tatsache, die stimmen muss.
Der erste Schritt der Autoren ist, eine kurze Idee mit einem starken allgemeinen Modell zu einem dichten, detaillierten Auftrag auszubauen. Sie nehmen Claude Opus 5.5, wir auch, mit ihrer Vorlage. Es war das einzige geschlossene Modell in unserer Kette. Der Auftrag mit 898 Wörtern ging dann an SenseNova in Claude Code, das unbeaufsichtigt in einer abgeschotteten Umgebung lief, mit unverändertem Skill. Jeder Modellaufruf ging an die RTX 4090 in unserer Cloud.
Das Modell lief aus der komprimierten Kopie von bartowski (4 Bit, 17,2 GB) plus einem Bildteil von 0,93 GB, damit es seine Bilder sehen konnte. Wir gaben Claude Code ein Arbeitsgedächtnis von 98.304 Tokens statt der 512K der Autoren, eine Obergrenze von 16.384 Tokens pro Antwort statt 64K, 120 Runden und 40 Minuten. Diese Limits sind unsere, vorgegeben von einer Karte und einem Vormittag. Kein Ton.
Ein vollständiger Entwurf, mit sieben Spalten, wo der Auftrag sechs verlangte
Das Modell las den Skill und den Auftrag und schrieb nach 5 Minuten seinen Plan. Nach 6 Minuten zeichnete es seine ersten Standbilder. Nach 10 Minuten hatte es die vollen 12 Sekunden gerendert: 1280 mal 720, 30 Bilder pro Sekunde, 360 Bilder. Das war ein Versuch mit einem Auftrag, und die Antworten des Modells variieren absichtlich, ein zweiter Versuch könnte also besser oder schlechter ausfallen.
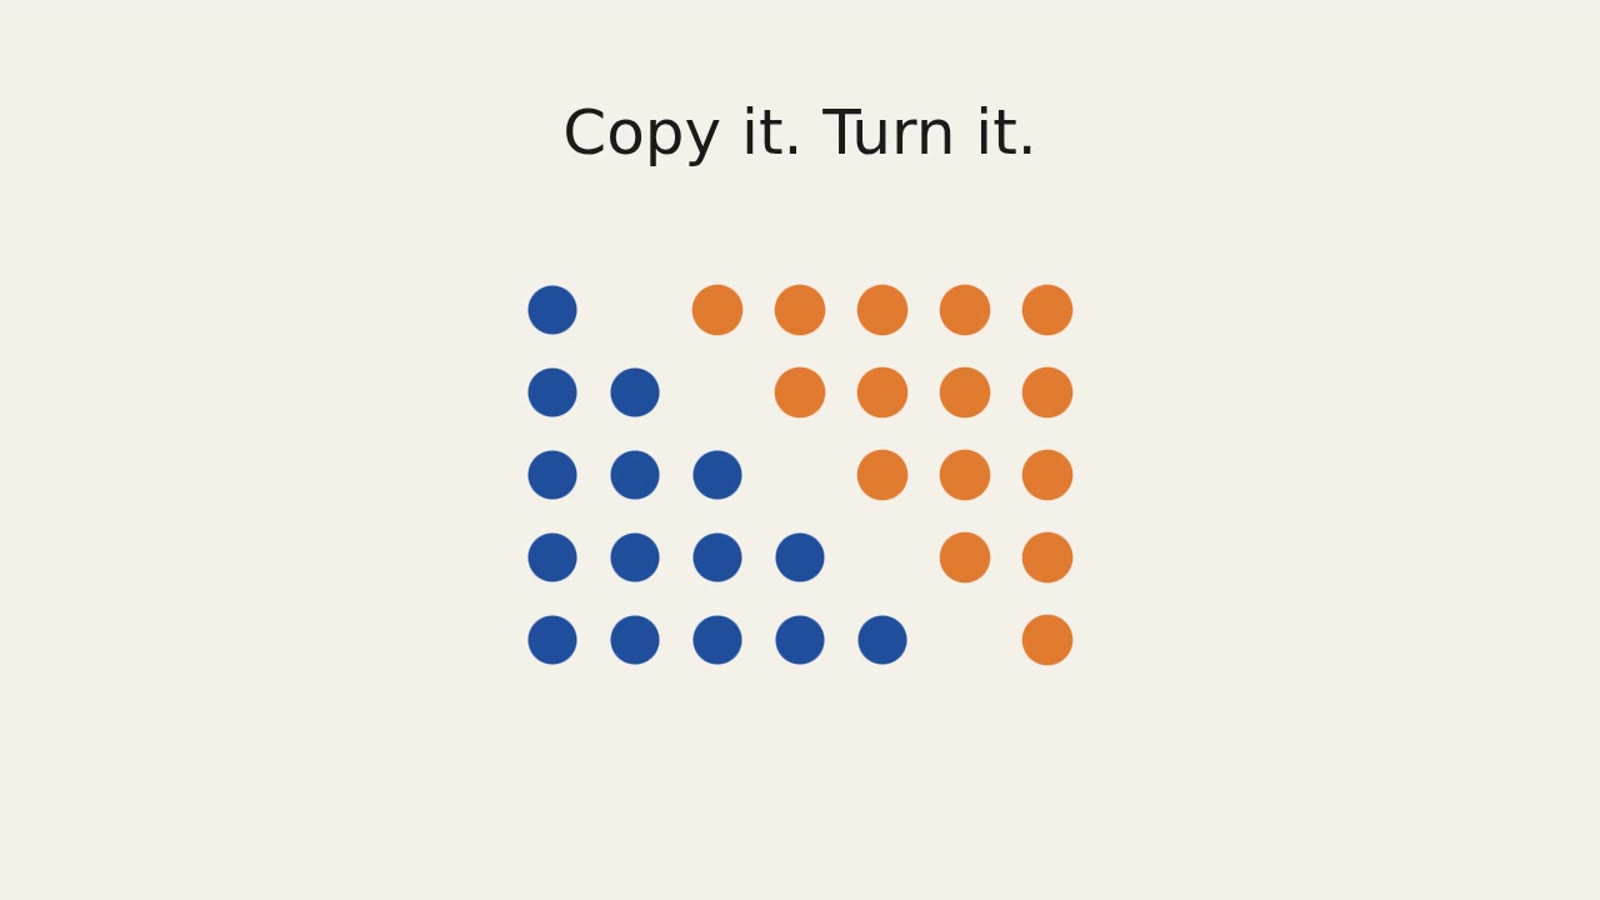
Die Schleife funktionierte so, wie die Autoren sie beschreiben. Das Modell las 21 seiner eigenen Bilder als Bilder und handelte nach dem, was es sah. Es sah, dass die orangen Punkte in der linken oberen Ecke landeten, führte das auf eine doppelt angewendete Bewegung zurück und korrigierte es. Dann sah es, dass seine Hervorhebungsstreifen die Gitterlinien verdeckten, und korrigierte die Zeichenreihenfolge. Die Bewegung ist sauber, und jedes Wort auf dem Bildschirm ist genau so geschrieben wie im Auftrag.
Das Bild verletzt trotzdem die eine Tatsache, auf die es ankommt. Wir haben die Punktmittelpunkte bei 7,2 Sekunden gemessen: 30 Punkte in 7 Spalten und 5 Reihen, jede Reihe „blau, eine leere Zelle, orange“. Die Beschriftung sagt „5 rows × 6 columns = 30“, und das 6-spaltige Gitter hinter den Punkten lässt die siebte Spalte weg. Die Dateiprüfung bestand trotzdem. Sie prüft Auflösung, Bildrate und Länge, nicht das Bild.
Die Kosten also: ein Entwurf in 10 Minuten; der gesamte 40-Minuten-Lauf brauchte 61 Tool-Aufrufe und etwa 78.000 geschriebene Tokens, und ob ein fertiger Clip herausgekommen wäre, wissen wir nicht, weil der Lauf nicht fertig wurde.
Die letzten 21 Minuten verbrachte Claude Code damit, sein eigenes Gedächtnis zusammenzufassen
Stell dir das Arbeitsgedächtnis als Schreibtisch vor: Jede gelesene Datei, jedes angesehene Bild und jede geschriebene Zeile bleibt darauf liegen. Wenn der Schreibtisch zu 80 % voll ist, bittet Claude Code das Modell, die bisherige Arbeit zusammenzufassen, räumt den Tisch ab und behält nur die Zusammenfassung.
Unser Schreibtisch fasste 98.304 Tokens. Er war nach etwa 19 Minuten Arbeit voll. Claude Code bat dreimal um eine Zusammenfassung. Jedes Mal schrieb das Modell, bis es an die Obergrenze von 16.384 Tokens für eine einzelne Antwort stieß, und die Zusammenfassung kam nie brauchbar zurück. Diese drei Versuche kosteten 21 Minuten, bis das 40-Minuten-Limit alles stoppte, ohne fertigen Film und ohne Verifikationsnotiz.
In vier der sechs Läufe der Autoren räumte Claude Code einen Schreibtisch von 167K bis 492K Tokens ab, mit einer Antwortgrenze von 64K. Die wahrscheinlichen Verdächtigen sind unsere Einstellungen: die Antwortgrenze von 16.384 Tokens und das versteckte Reasoning des Modells, das eingeschaltet blieb und diese Grenze aufbraucht. Unsere Logs zeigen nicht, was davon es war.
Welche GPU: 24 GB trugen den Agenten, kleinere Kopien beantworteten nur eine Anfrage
Den Agenten ließen wir auf einer echten 4090 mit 24 GB laufen. Weil keine 16-GB-Karte verfügbar war, testeten wir kleinere Kopien auf der 4090 und beobachteten ihren Spitzenspeicher. Jede bekam eine kurze Anfrage nach einer Animationsseite von 6 Sekunden (begrenzt auf 8.192 Tokens, ein kleinerer Auftrag als der des Agenten) und ein Bild mit 15 Punkten zum Beschreiben.
| Karte oder Budget | Kopie und Arbeitsgedächtnis | Spitzenspeicher der Karte | Tempo | Ergebnis | Echte Karte? |
|---|---|---|---|---|---|
| RTX 4090 24 GB | 4 Bit, 98K Tokens, Lauf mit Claude Code | 20,9 GiB | 39 bis 48 Tokens/s | Lauf mit Claude Code, siehe oben | ja |
| RTX 4090 24 GB | 4 Bit, 32K Tokens, eine Anfrage | 18,8 GiB | 47,6 Tokens/s | Bild richtig, Seite nie geschrieben: alle 8.192 Tokens gingen ins versteckte Reasoning | ja |
| 16-GB-Budget | 3 Bit, 32K Tokens, eine Anfrage | 13,7 GiB | 63,5 Tokens/s | Bild richtig, Seite rendert, aber es ist immer nur ein Punkt zu sehen | nein, auf der 4090 gelaufen |
| 12-GB-Budget | 2 Bit, 16K Tokens, eine Anfrage | 10,0 GiB | 78,7 Tokens/s | Bild richtig, Seite bei 8.192 Tokens abgeschnitten | nein, auf der 4090 gelaufen |
Je eine Stichprobe sagt wenig, und die 4-Bit-Anfrage schrieb keinen Code, einen direkten Vergleich gibt es also nicht.
Auf InferenceKey: bereit in 25 Sekunden, Bild-Fix noch nicht ausgerollt
Auf einer frischen Maschine mit den Dateien auf der Platte antwortete das Modell 25,2 Sekunden nach unserer Anfrage, und Claude Code spricht mit ihm wie mit der API von Anthropic. Um Claude Code auf die 4090 zu richten, brauchte es eine URL, einen Modellnamen und ein paar Kontexteinstellungen. Auf unserer Seite brauchte es zwei Änderungen: einen Bild-Fix und einen Request-Timeout von 30 Minuten, damit lange Antworten nicht nach 2 Minuten abgeschnitten wurden. Am Skill der Autoren änderte sich nichts.
Das Problem, auf das du stoßen wirst: Wenn Claude Code ein Bild schickte, ließ unsere Plattform das Bild fallen oder reichte es als Text weiter. Status: in unserem Test-Build behoben, noch nicht im gehosteten Dienst, wo die Bilder weiterhin blind ankommen.
Dieser Lauf nutzte eine lokale Kopie der Plattform, nicht den gehosteten Dienst. Kleinere Ecken und Kanten (ein Timeout, ein Neustart der Maschine, ein wiederholter Upload) stehen mit ihrem Status im Anhang.
Solltest du es nutzen? Einen Versuch wert für kurze Entwürfe auf einer 24-GB-Karte, wenn du jedes Bild prüfst
- Du willst Erklärvideos und Motion Graphics mit exaktem Text: einen Versuch wert auf einer 24-GB-Karte.
- Das Bild muss beim ersten Mal stimmen: Prüf jedes Bild selbst.
- Du willst einen fertigen Film ohne Aufsicht: Plane Stunden und viel mehr Arbeitsgedächtnis ein, wie die Autoren. Unser 40-Minuten-Lauf wurde nicht fertig.
- Du hast eine 16-GB-Karte: Die 3-Bit-Kopie passt auf dem Papier, ist als Agent ungetestet, und ihre eine Stichprobe hatte einen Bug.
Für deinen eigenen Clip führst du python main.py aus dem SDK-Beispiel für SenseNova Code2Video auf einer 24-GB-Karte aus, gemietet in unserer Cloud; die Setup-Schritte stehen im Anhang, und der Schritt mit Claude Code sieht Bilder erst, wenn der Bild-Fix ausgerollt ist.
Für Ingenieure
Credits
- SenseTime (SenseNova-Team): das Modell (Apache-2.0), laut seiner Card feinabgestimmt aus Qwen3.8-27B; die Model Card mit Rezepten für vLLM, SGLang und LightLLM; sechs veröffentlichte Produktions-Trajektorien; der
code-video-Skill, Prompt-Vorlage und Medien (das GitHub-Repo nennt keine Lizenz). - Das Qwen-Team: das Basismodell, das die Autoren nennen.
- bartowski: die GGUF-Quants, die wir genutzt haben (Q4_K_M, IQ3_XXS, IQ2_XXS, bf16 mmproj), erstellt mit llama.cpp b11969 und einer imatrix.
- Die Maintainer von llama.cpp: Release b12167 mit dem vorgebauten CUDA-13.4-Tarball, multimodaler Unterstützung und Tool-Call-Parsing per
--jinja. - Anthropic: Claude Code, der Harness, den die Autoren empfehlen, und Claude Opus 5.5, das unseren dichten Auftrag aus der Vorlage der Autoren schrieb.
- AI Search: wo wir es entdeckt haben (News-Video vom 2026-11-01, Kapitel bei 39:53).
- Unser Teil: das Deployment über die Plattform, der Bild-Fix in unserer
/v1/messages-Übersetzung, der Lauf mit Claude Code in der Sandbox, die Pixelprüfung seiner Ausgabe, die Speicherleiter, das SDK-Beispiel und das Demovideo.
Modell und Dateien
sensenova/SenseNova-6.8-Code2Video: sha0f99ab03, erstellt am 2026-10-24, zuletzt geändert am 2026-11-03, nicht gated, Apache-2.0,pipeline_tagimage-text-to-text, Sprachen en und zh. Ende Oktober veröffentlicht; Card zuletzt aktualisiert am 2026-11-03.- 27.356.728.560 Parameter in BF16 (12 Shards, etwa 54,7 GB).
Qwen3_5ForConditionalGeneration: 64 Schichten mitfull_attention_interval4 (16 Schichten mit voller Attention, 48 mit linearer Attention), 4 KV-Heads x head_dim 256, hidden 5120, Tiefe des Vision-Towers 27, 1 MTP-Schicht.max_position_embeddings262.144 mit yarn-Faktor 2,0 (die Angabe von 512K). - Generierungs-Config: Temperatur 1,0, top_k 20, top_p 0,95, Sampling an.
- bartowski-GGUF
0ef7c7e3: bf16 53,81 GB, Q8_0 28,67, Q6_K 23,62, Q5_K_M 20,68, Q4_K_M 17,20 (als Standard markiert), IQ3_XXS 12,08, IQ2_XXS 8,64; mmproj bf16 0,93 GB und f16. Weitere Community-Quants auf der Card: OliviaRossi GSQ-RCO-GGUF, Abiray MTP-GGUF, BennyDaBall NVFP4-GGUF, Hayabala EXL3. - Backend-Binary: das vorgebaute llama.cpp für NVIDIA, es musste also nichts gebaut werden.
- KV-Cache bei q8_0: 16 Schichten x 4 Heads x 256 x 2 x 1 B = 32 KiB pro Token, also sind 96K etwa 3 GiB (passte zur gemessenen Spitze) und 512K wären etwa 16 GiB.
- Harness-Einstellungen der Autoren:
CLAUDE_CODE_MAX_CONTEXT_TOKENS=524288,CLAUDE_AUTOCOMPACT_PCT_OVERRIDE=80, maximale Ausgabe 64K,--max-turns2000 oder mehr, Timeout 10 h oder mehr. Sonst behandelt Claude Code ein unbekanntes Modell als 200K-Modell. Die HF-Card sagtCLAUDE_CODE_MAX_OUTPUT_TOKENS=64000, das GitHub-README 65536. Die Card spricht von Läufen mit mehr als 2.000 Runden; der Abschnitt zu den Gewichten im README sagt „over a thousand“. Keins von beiden haben wir überprüft. - Trajektorien der Autoren (
trajectories/all.openai.jsonl, Thinking an): fourier_light_painting 675 Assistant-Runden und 99 Prüfbilder, forest_landslide 445 und 47, signal_noise_shape 713 und 51, cmyk_halftone 261 und 37, geometry_risograph 521 und 67, frame_form_flow 876 und 69. Compaction: fourier 2x bei etwa 492K auf 13-16K; signal_noise_shape 1x bei 491K auf 14K; risograph 4x bei etwa 167-172K auf 10-15K; frame_form_flow 7x bei etwa 167-173K auf 6-13K; forest_landslide nutzte 2 Resumes; cmyk_halftone hat keine Kontextgrenze. Die Werte von 6-16K sind der gesamte Kontext, der nach der Compaction übrig bleibt (postTokens), nicht die Länge der Zusammenfassung. - Umgebung des Skills: Claude Code, Node.js 18+, Python 3, ffmpeg/ffprobe, Fonts, Playwright Chromium;
requirements.txtnumpy, scipy, soundfile, librosa, edge-tts, faster-whisper. GitHub HEAD776ae798, ein Commit vom 2026-10-26.
Setup
- GPU auf InferenceKey Cloud: eine RTX 4090 24 GB (24.564 MiB, 450 W, Compute Capability 8.9, Treiber 595.91.07).
- Backend: das eingebaute
llamacpp-Backend mitINFERENCEKEY_LLAMACPP_TAG=b12167undINFERENCEKEY_LLAMACPP_ASSET=ubuntu-cuda-13.4-x64. Warum llama.cpp: Die Rezepte der Card sind vLLM, SGLang und LightLLM in BF16 mit Tensor-Parallelität 4 und 512K Kontext (etwa 54,7 GB allein für die Gewichte). Das GGUF mit 17,2 GB ist das, was auf eine Consumer-Karte passt. - Ein lokaler InferenceKey-Manager, gebaut aus unserem Main-Branch, mit dem Bild-Patch. Produktion nie angefasst.
- Claude Code 2.1.322 headless in einer Docker-Sandbox (Ubuntu 24.04, ffmpeg, Node 24, Playwright 1.56.1 Chromium, Noto- und DejaVu-Fonts,
--memory 8g --cpus 6), nur der Aufgabenordner und ein frisches HOME gemountet, API-Key per Umgebungsvariable übergeben. - Worker-Manifest:
INFERENCEKEY_BACKEND_REQUEST_TIMEOUT_SECS=1800(Standard 120 s); ohne das haben wir den Lauf nicht probiert. - Einstellungen von Claude Code:
CLAUDE_CODE_MAX_CONTEXT_TOKENS=98304,CLAUDE_AUTOCOMPACT_PCT_OVERRIDE=80,CLAUDE_CODE_MAX_OUTPUT_TOKENS=16384,CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1, kleines Modell auf denselben Slug gesetzt. Claude Code gab[claude-code:unrecognized_model]aus, harmlos. - Auftrag: „Half a Rectangle“, 12 s, 1280x720, 30 fps, stumm, 898 Wörter, geschrieben von Claude Opus 5.5 aus
prompts/enhance_prompt.md. Prompt: der Stage-2-Prompt der Autoren plus ein Satz, der das 40-Minuten-Limit nennt.
Der Startbefehl, den das Backend ausführt:
INFERENCEKEY_LLAMACPP_TAG=b12167 \
INFERENCEKEY_LLAMACPP_ASSET=ubuntu-cuda-13.4-x64 \
llama-server \
  -hf bartowski/sensenova_SenseNova-6.8-Code2Video-GGUF \
  --hf-file sensenova_SenseNova-6.8-Code2Video-Q4_K_M.gguf \
  --mmproj-url <bf16 mmproj URL> \
  --alias sensenova-code2video -ngl 99 -fa on \
  -c 98304 -ctk q8_0 -ctv q8_0 \
  --jinja --reasoning-format deepseek \
  --temp 1.0 --top-k 20 --top-p 0.95 \
  -np 1 --cache-reuse 256
Der genaue COMMAND-String mit der mmproj-URL steht in main.py des Beispiels.
Schritt für Schritt mit dem SDK-Beispiel
- Klone inferencekey-sdk und öffne
examples/sensenova-code2video-27b-claude-code-llamacpp-private-nvidia(Commitd352b7b5e83921cbc9fd28c4f0b9054ee9e2cb23). cp .env.example .envund tragINFERENCEKEY_SDK_TOKEN,INFERENCEKEY_API_KEY,INFERENCEKEY_PROJECTundIK_WORKER_IDein (ein privater NVIDIA-Worker mit 24 GB). Optional:C2V_CONTEXT(98304),C2V_KV_TYPE(q8_0). Für eine 16-GB-Karte:C2V_GGUF_FILE=sensenova_SenseNova-6.8-Code2Video-IQ3_XXS.ggufundC2V_CONTEXT=32768(auf einer echten 16-GB-Karte ungetestet).pip install -r requirements.txtplus das lokale Python-Bindinginferencekey, gebaut mit maturin (nicht auf PyPI).IK_KEEP_ALIVE=1 python main.py:ensure()eines festenllamacpp-Workloads, an deinen Worker gepinnt,wait_until_ready(3600), dann ein streamender/v1/messages-Aufruf, der eine 6-s-Seite mitwindow.seek(t)anfordert; speichertoutputs/clip.htmlundoutputs/answer.json. OhneIK_KEEP_ALIVE=1ruft es am Endedelete()auf.cp claude-settings.example.json claude-settings.jsonund setz deinen Projekt-Slug inANTHROPIC_BASE_URL(https://cloud.inferencekey.com/endpoint/<project>/sensenova-code2video).ANTHROPIC_MODELmuss der Workload-Slugsensenova-code2video(oderdefault) sein, sonst gibt der Endpoint 400 zurück.API_TIMEOUT_MSist 1800000.- Führ im Aufgabenordner
npm install playwright && npx playwright install chromiumaus (dascapture.mjsdes Skills lädt Playwright von dort, eine globale Installation reicht also nicht), leg deinen dichten Auftrag in<task>/dense_prompt.mdab und starte dann./run_claude_code.sh <task>. Das Skript kopiert den Skill der Autoren in die Aufgabe und führt dannclaude -p --settings ... --max-turns 150 --permission-mode acceptEdits --allowedTools "Bash,Read,Write,Edit,Glob,Grep,Skill"mit einem Timeout von 60 Minuten aus (C2V_MAX_TURNS,C2V_MINUTES). Lass es in einem isolierten Ordner oder Container laufen: Der Agent führt Shell-Befehle aus, ohne zu fragen.
Der Streaming-Pfad des Beispiels lief nicht von Anfang bis Ende, bevor die GPU freigegeben wurde. Dieselbe Form der Anfrage funktionierte in unserem Bildtest.
Zeiten
| Schritt | Zeit |
|---|---|
ensure() bis bereit, frischer Worker | 25,2 s |
| Installation des llama.cpp-Tarballs | etwa 1 s |
| Vorab-Download von GGUF und mmproj (nicht auf dem Weg zu bereit) | 26 s und 3 s |
Start von Claude Code bis SPEC.md | 5 min (07:08 UTC) |
| Erste Standbilder | 07:09 bis 07:12 |
Vollständiger 12-s-Render out/v1.mp4 | 10 min (07:13) |
| Messung der Punktschwerpunkte mit numpy und scipy | 07:14 bis 07:16; 61. Tool-Aufruf um 07:16:44 |
| Eine lange Anfrage | etwa 07:17 bis 07:21, freigegeben bei 78.416 Tokens |
| Drei Compaction-Anfragen | 07:21:50 bis 07:42:40, jede freigegeben bei n_tokens 82.969 |
| Timeout | 07:43:04 |
Decode: 47,7 Tokens/s frisch, 44,5 bei etwa 30K, 39,4 bei etwa 66K; 78.039 Tokens in 1.915 s (40,8 im Schnitt); Prefill 75 s über 44 Anfragen, nur 5 Prefills über 8K Tokens. Decode machte etwa 96 % der GPU-Zeit aus. Spitzen-VRAM 21.425 MiB im Lauf, 21.729 MiB für die gesamte GPU-Sitzung. Tool-Aufrufe: Bash 29, Read 26 (21 Bilder), Edit 4, Write 2. Das letzte Ereignis im Stream ist der Status compacting.
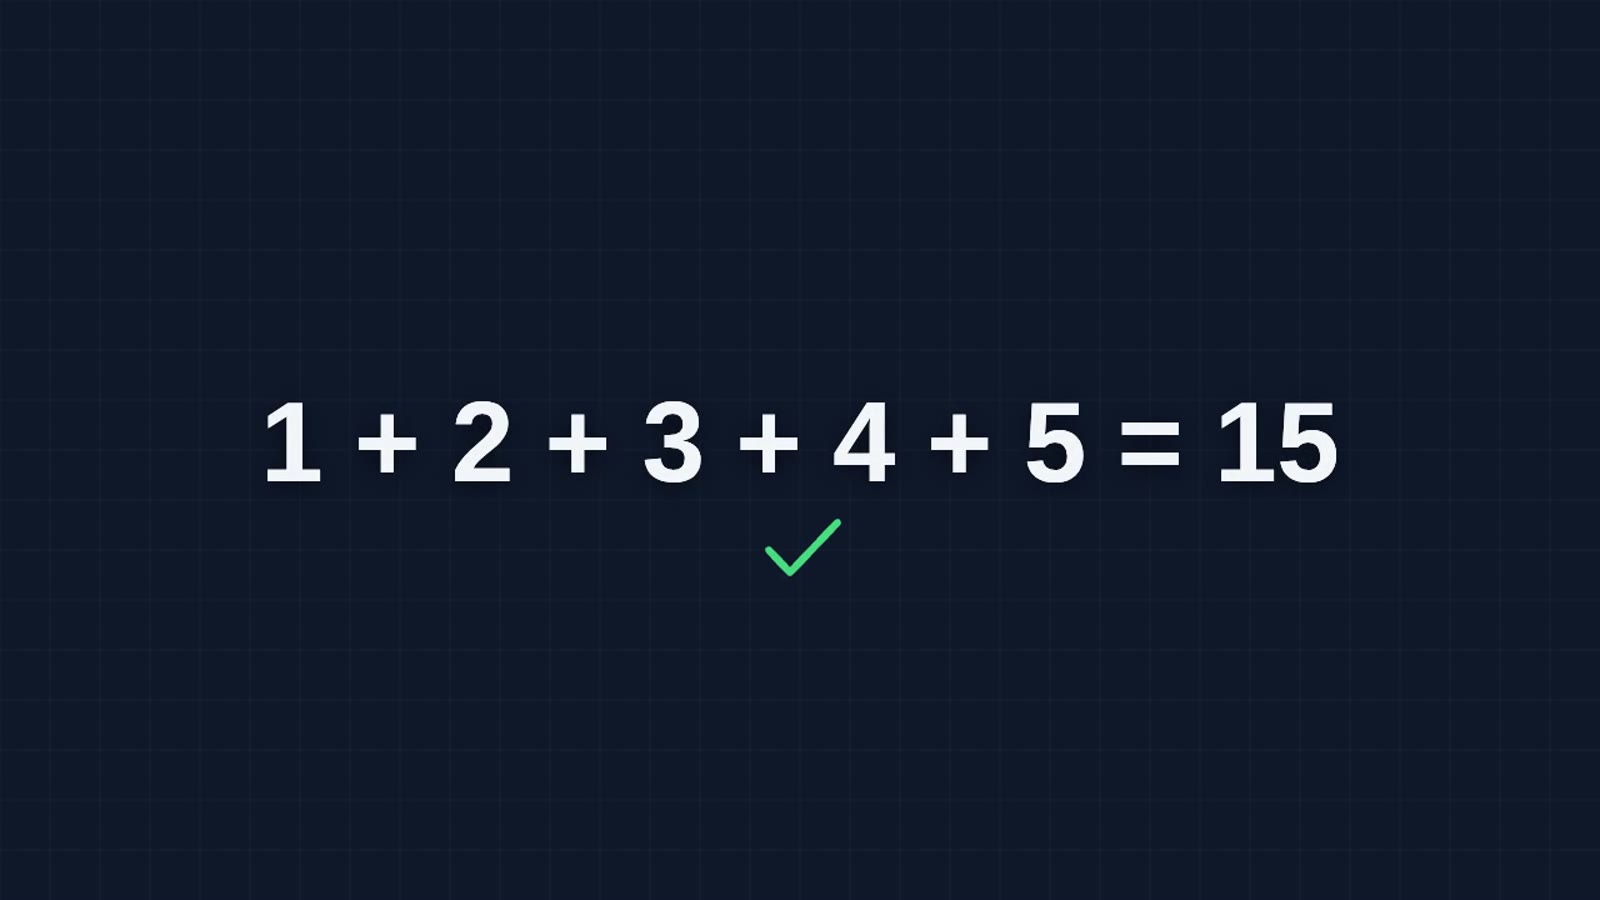
Ausgabeprüfung von v1.mp4: check_video.sh bestanden (1280x720, 30,000 fps, 360 Bilder, 12,000 s, h264 yuv420p, kein Audiostream, Warnung wegen eines absichtlich eingefrorenen Endbilds von 2,1 s). Bei t = 7,2 s 30 Punktmittelpunkte in 7 Spalten (x 441 bis 837, Abstand 66 px) und 5 Reihen (y 247 bis 512), jede Reihe blau k, eine leere Zelle, orange 6-k. Bei t = 11,5 s ist „30 ÷ 2 = 15“ lesbar, aber die 6-spaltige Führung verfehlt die siebte Spalte. Aller Text auf dem Bildschirm stimmt mit dem Auftrag überein. Die eigenen Notizen des Modells aus dem Lauf: „B's final placement is off (dots land top-left), the settle term double-counts the translation“, dann ein Fix der Zeichenreihenfolge der Gitterstreifen, und spät im Lauf „My snap origin was wrong (rows start at y=247, cols at x=441). Redo:“.
VRAM-Leiter
Die Stufen 2 bis 4 liefen direkt auf llama-server b12167 auf der 4090 mit q8_0-KV-Cache und dem bf16-mmproj auf der GPU. Jede bekam den 6-s-Seitenauftrag des Beispiels (193 Prompt-Tokens, maximal 8.192 Ausgabe-Tokens) und ein PNG mit 15 Punkten samt einer Frage zum Lesen ohne Vorwissen. Spitze per nvidia-smi alle 0,5 s. Dieser Auftrag ist kleiner als der des Laufs mit Claude Code, die Stufen sind also nicht direkt mit ihm vergleichbar.
| GPU oder Budget | Konfiguration | Spitzen-VRAM | Zeit pro Ausgabe | Ausgabe OK | Echt oder emuliert |
|---|---|---|---|---|---|
| RTX 4090 24 GB | Q4_K_M + bf16 mmproj, 98.304 ctx q8_0, Claude Code über den Endpoint | 21.425 MiB | 39,4 bis 47,7 tok/s; vollständiger Render nach 10 min | nein: 5x7 mit Lücken, Compaction hängt, kein final.mp4 in 40 min | echt |
| RTX 4090 24 GB | Q4_K_M + mmproj, 32K q8_0 | 19.233 MiB | 47,6 tok/s; Auftrag 172,5 s; Bild 7,7 s | Bild richtig; Auftrag 8.192 Tokens Thinking, keine Antwort (finish length) | echt |
| 16-GB-Budget | IQ3_XXS + mmproj, 32K q8_0 | 13.994 MiB | 63,5 tok/s; Auftrag 4.375 Tokens in 69,2 s; Bild 4,3 s | Bild richtig; Seite rendert (180 Bilder), aber immer nur ein Punkt sichtbar; Schlusssumme richtig | emuliert auf der 4090 |
| 12-GB-Budget | IQ2_XXS + mmproj, 16K q8_0 | 10.252 MiB | 78,7 tok/s; Auftrag 104,4 s; Bild 11,3 s | Bild richtig; Seite bei 8.192 Tokens abgeschnitten (unvollständiges html) | emuliert auf der 4090 |
Wir haben eine echte 16-GB-Karte versucht, und jede Option war ausverkauft (RTX 2000 Ada, RTX 5080, RTX A4000, RTX 4080 und 4080 SUPER, RTX 4000 Ada). Ob 13.994 MiB auf einer echten 16-GB-Karte mit dem Overhead des Treibers genug Luft lassen, ist unbekannt.
Nicht probiert: eine echte 16- oder 12-GB-Karte; Claude Code mit den kleineren Dateien; Kontexte über 96K; Thinking aus (--chat-template-kwargs); eine höhere Ausgabegrenze oder eine andere Compaction-Einstellung; das BF16-Rezept der Autoren auf vLLM mit Tensor-Parallelität 4; Ton.
Offene Probleme
/v1/messageshat Bilder verworfen (crates/manager/src/api/openai.rs,anthropic_message_to_openai):image-Blöcke wurden übersprungen undtool_result-Arrays in Strings umgewandelt, ein von Claude Code gelesenes PNG käme also als Base64-Text beim Modell an. Lokaler Fix: Bildblöcke werden zu OpenAI-image_url-Teilen; Bilder aus Tool-Ergebnissen werden an die folgende User-Nachricht wieder angehängt. Live-Prüfung: 200, streamend, 601 Tokens rein / 291 raus, 6,8 s, richtig gelesen. Ein Unit-Test wurde hinzugefügt, aber nicht kompiliert (Platte voll). Offen, bis er im gehosteten Dienst ausgerollt ist.- Nicht streamende Aufrufe sterben nach 120 s. Der erste nicht streamende Aufruf gab nach dem Backend-Timeout des Workers 503 zurück, als llama-server bei 5.599 Thinking-Tokens war. Für den Lauf behoben mit
INFERENCEKEY_BACKEND_REQUEST_TIMEOUT_SECS=1800; das Beispiel streamt jetzt. - Ein Neustart des Workers übernahm den laufenden llama-server nicht. Der zweite llama-server beendete sich mangels VRAM; etwa 1,5 Minuten gingen verloren, bis der Watchdog den Workload zurückbrachte. Offen.
- Der Upload der Worker-Binary lief auf der ersten Maschine in einen Timeout (SFTP, hohe Latenz), und der Manager beendete sie nach 2,18 Minuten. Ein auf die EU beschränkter neuer Versuch lud in 8 s hoch. Bekannt, offen.
- Compaction bei 98K: Drei Zusammenfassungen liefen bis zur Grenze von 16.384 Tokens; die Logs zeigen nicht, warum. Ungetestete Abhilfen: ein größerer Kontext, eine höhere Ausgabegrenze, Thinking aus.
- Kleinigkeit: llama.cpp deaktiviert
cache_reusebei Multimodalität; normales Prefix-Caching funktionierte trotzdem.
Demovideo
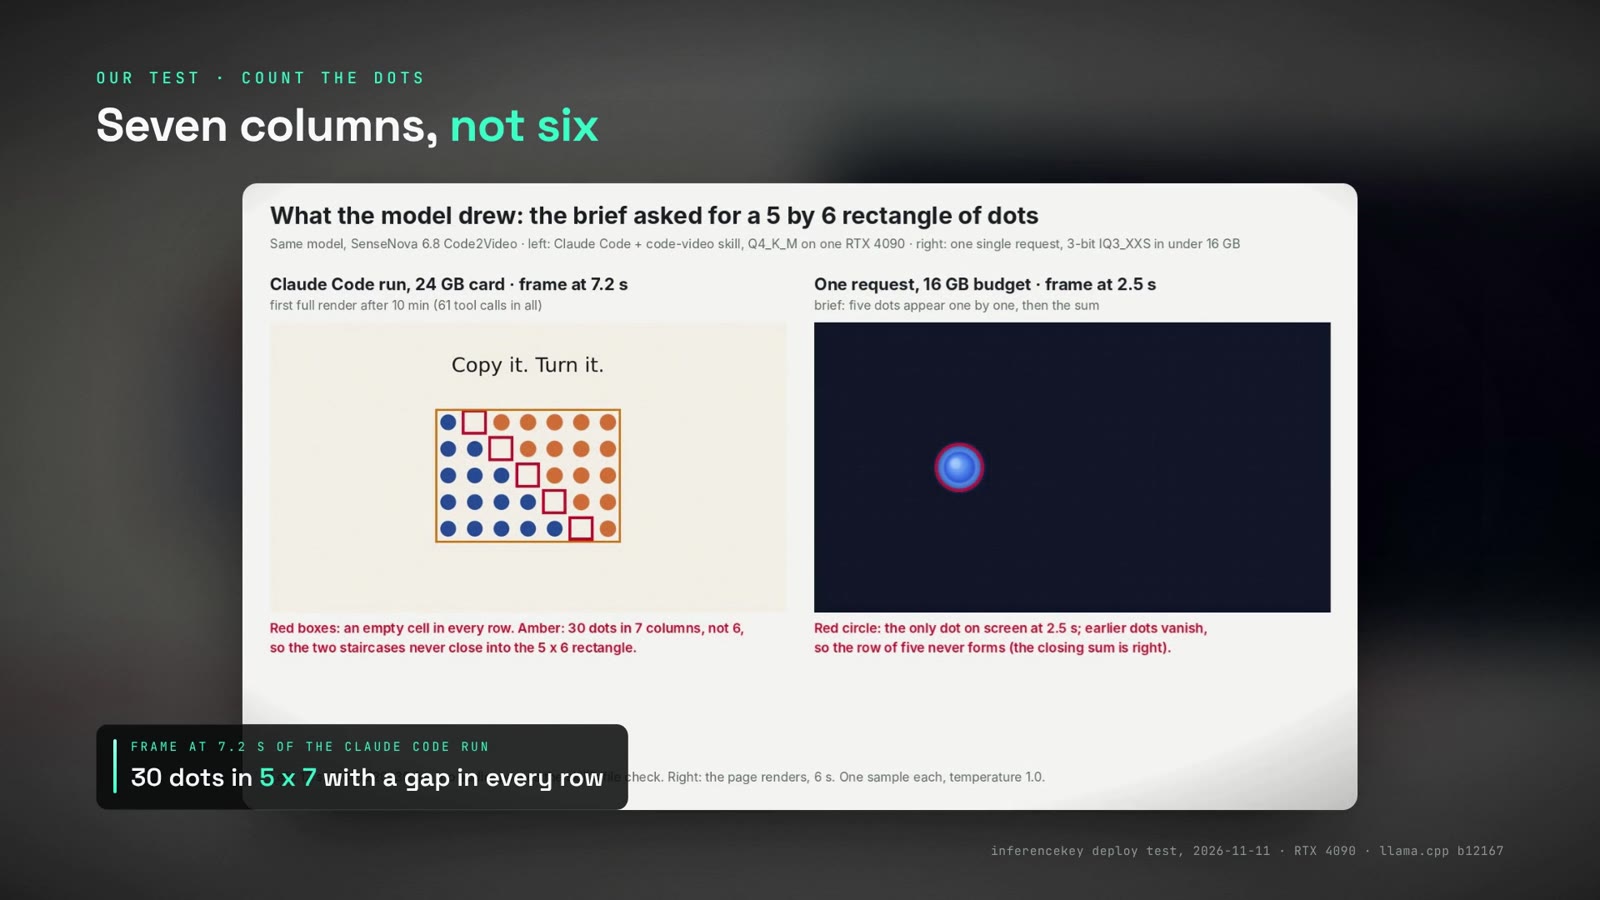
Die 203 Sekunden lange Demo mit Sprecher: zuerst die Filme der Autoren (SenseNova zugeschrieben), ihre Model Card, Runden pro Film und Dateigrößen, dann unser Deployment auf der RTX 4090, eine Wiedergabe der 61 Tool-Aufrufe und der Compaction, unser Clip, der zentrale Vergleich und die Speicherleiter.
Quellen
- sensenova/SenseNova-6.8-Code2Video (Model Card, Config, Generierungs-Config, Abschnitte zu Deployment und Harness).
- OpenSenseNova/SenseNova-6.8-Code2Video (Skill, Skripte, Prompt-Vorlage, Einschränkungen).
- Produktions-Trajektorien.
- bartowski/sensenova_SenseNova-6.8-Code2Video-GGUF.
- AI Search, 2026-11-01, Kapitel „SenseNova Code2Video“ bei 39:53.
- SDK-Beispiel.
- Unser früherer Test eines anderen SenseTime-Modells, SenseNova-Loop-9B.