RelayVSR escala 4x un clip de 480p de 3 segundos en 10 segundos de GPU con una sola tarjeta de 24 GB
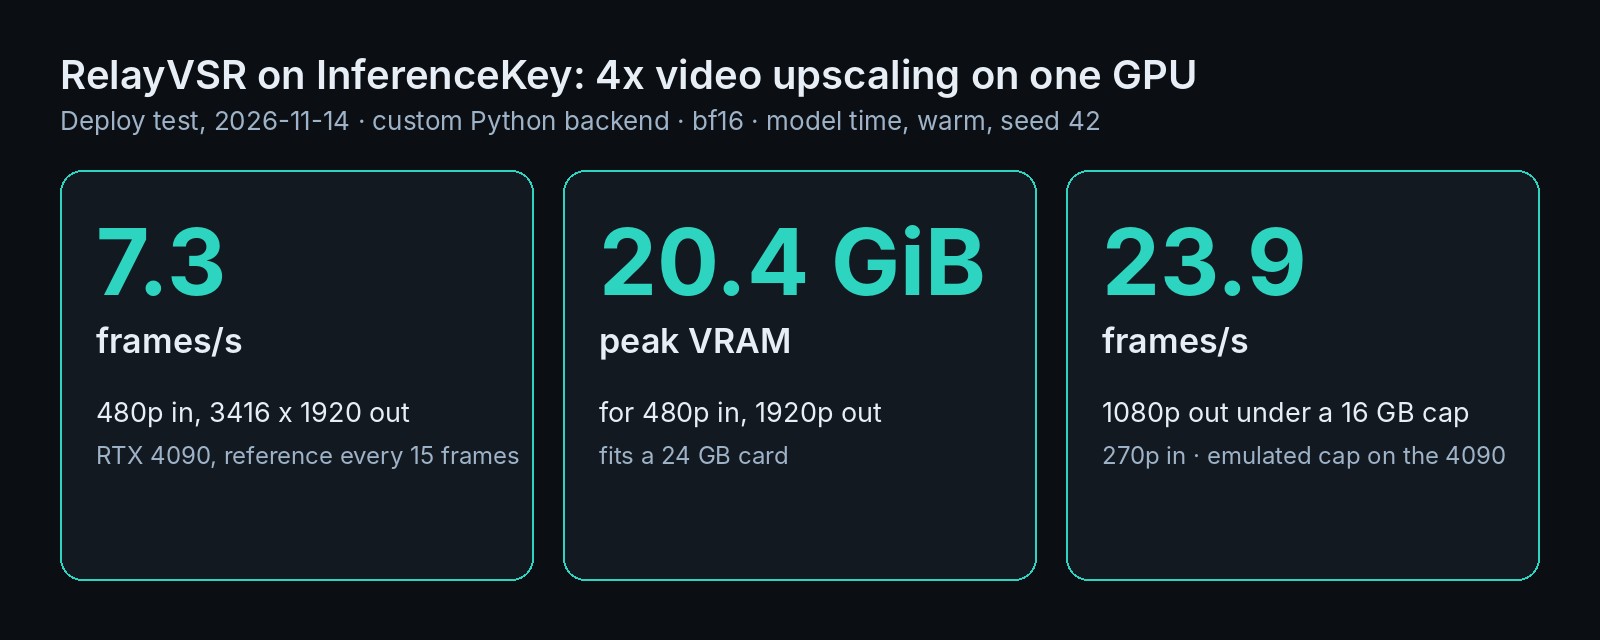
RelayVSR escaló 4x un clip de 480p a 7,3 fotogramas/s de GPU en una RTX 4090, con pico de 20,4 GiB. Con un límite emulado de 16 GB solo entró la salida 1080p.
RelayVSR multiplica por 4 la resolución de un vídeo. Un modelo generativo grande dibuja solo unos pocos fotogramas clave con detalle, y una red pequeña lleva ese detalle a los fotogramas intermedios. Lo ejecutamos en una RTX 4090 de nuestra nube (InferenceKey Cloud). Un clip de cine de 3 segundos a 480p volvió a 3416 x 1920 tras unos 10 segundos de trabajo de GPU, usando 20,4 GiB (unos 22 GB) de los 24 GB de memoria de la tarjeta. De principio a fin, la petición tardó de 26 a 41 segundos, sobre todo por la codificación de vídeo en la CPU (más abajo). Una RTX 3090 real hizo el mismo trabajo a la mitad de velocidad, más o menos. Si tienes tus propias GPU, eso pone el escalado de vídeo 4x al alcance de una tarjeta gaming de 24 GB en lugar de una de centro de datos. Nuestro ejemplo del SDK lo despliega en tu propia tarjeta.
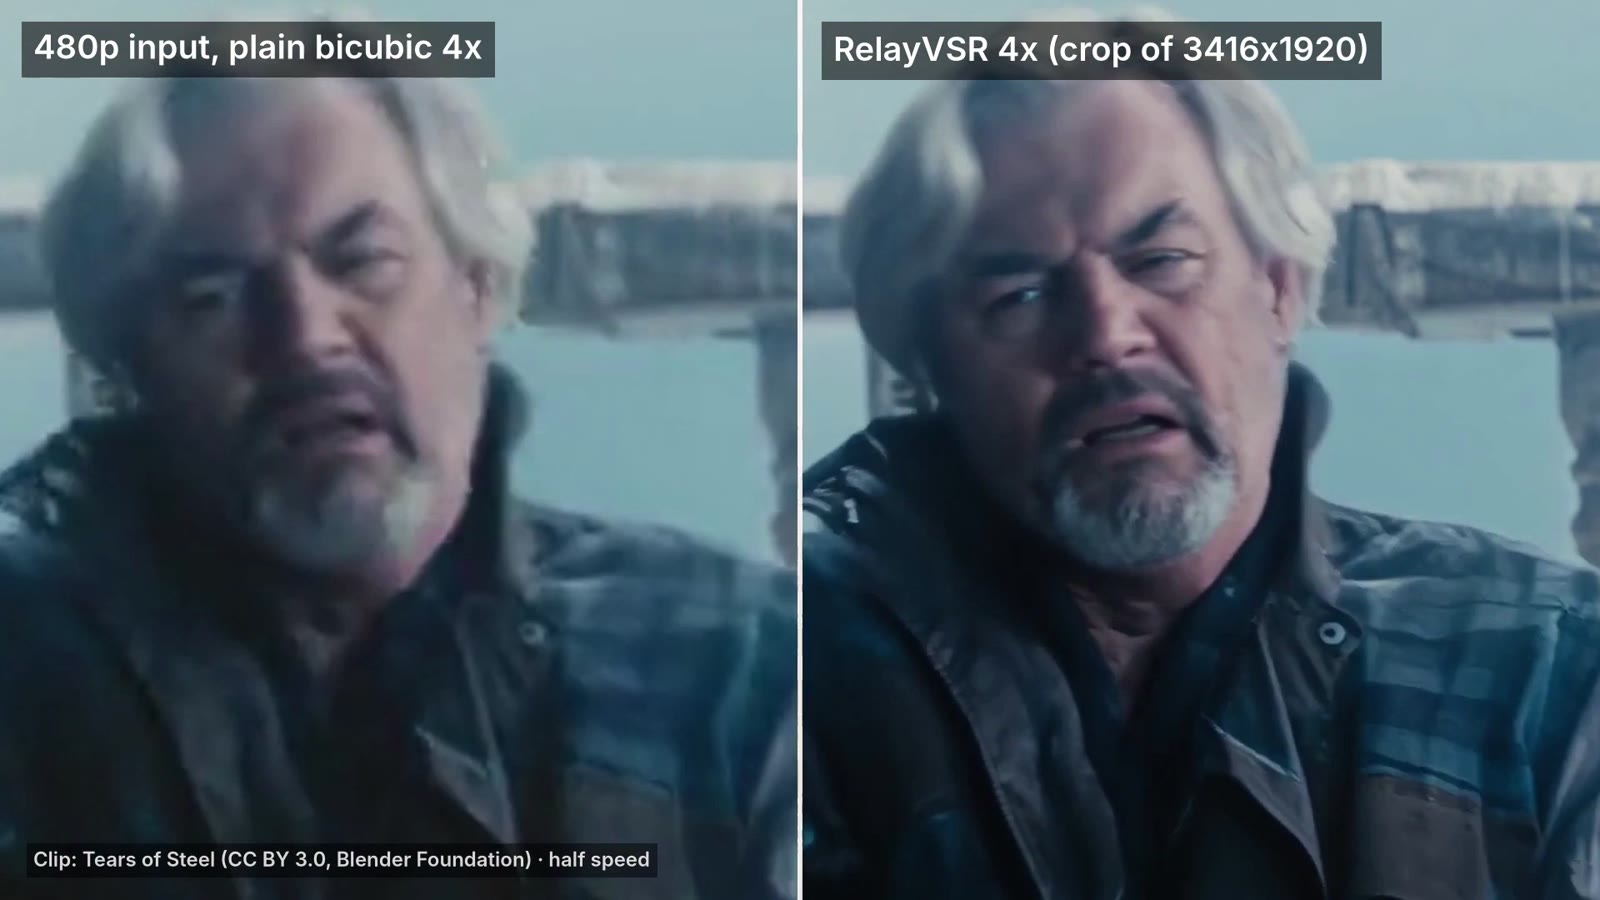
Clip: Tears of Steel (CC) Blender Foundation, mango.blender.org, CC BY 3.0.
| Una RTX 4090, clip de 3 segundos | Fotogramas por segundo de tiempo de GPU | Pico de memoria de GPU |
|---|---|---|
| 480p de entrada, 3416 x 1920 de salida, un fotograma clave cada 15 | 7,33 | 20,4 GiB |
| Igual, un fotograma clave cada 31 | 9,10 | 20,4 GiB |
| 270p de entrada, 1920 x 1080 de salida, un fotograma clave cada 15 | 23,9 | 13,1 GiB (unos 14 GB), entra en un límite de 16 GB (emulado) |
Seis fotogramas caros de 72: cómo reparte RelayVSR el trabajo
RelayVSR es rápido porque la mayoría de los fotogramas nunca pasan por el modelo grande. Imagina cómo se hacía la animación dibujada a mano. Un animador principal dibuja las poses clave, y los intercaladores dibujan los fotogramas que las unen.
RelayVSR hace lo mismo con dos modelos. El principal es un generador de referencias adaptado de Wan2.2, un modelo de vídeo abierto de Wan-AI. Dibuja una versión detallada de un fotograma de cada 15, los fotogramas clave. El intercalador es una red pequeña diseñada por los propios autores, de 32 millones de parámetros frente a los 5B del modelo grande. Escala todos y cada uno de los fotogramas, mirando el vídeo de baja resolución y los fotogramas clave detallados a cada lado. En nuestro clip de 72 fotogramas, el modelo grande dibujó 6 fotogramas clave y la red pequeña escaló los 72.
Ese reparto es lo que hace que baste una tarjeta. Los autores lo compararon a 1080p en una A100, una tarjeta de centro de datos. RelayVSR declara 29,29 fotogramas por segundo con 13,82 GB de memoria de GPU. El rival más rápido de su tabla declara 23,48 con 31,36 GB, y dos escaladores de IA más pesados se quedan por debajo de un fotograma por segundo con 41 a 74 GB. En su estudio con usuarios, la gente valoró la calidad general de RelayVSR por encima de ese rival, muy por encima de los dos pesados y más o menos al nivel de FlashVSR, que en su tabla es casi cuatro veces más lento. Uno de los dos pesados aun así se mantuvo más fiel al original y parpadeó menos. Esas cifras son suyas, no nuestras.
El trabajo es de Xijun Wang, Xin Li, Zirui Lang, Suhang Yao, Haoran Li y Zhibo Chen, de la Universidad de Ciencia y Tecnología de China. Publicaron el artículo el 29 de septiembre de 2026, el código en GitHub y los pesos en Hugging Face, actualizados por última vez el 13 de noviembre. Wan2.2 y los dos ficheros de pesos de RelayVSR son Apache-2.0, una licencia abierta que permite el uso comercial. La descarga ocupa unos 10,2 GB. Lo vimos en el vídeo de noticias de AI Search del 8 de noviembre. Nuestra parte: el backend que lo sirve como API, las pruebas de velocidad y la prueba de la tarjeta más pequeña.
Casi 4K en 10 segundos de GPU para un clip de 3 segundos, y 1080p más o menos a la velocidad a la que se reproduce
En una RTX 4090, RelayVSR convirtió 3 segundos de película a 480p en 3416 x 1920 (más abajo lo llamamos 1920p) en unos 10 segundos de tiempo de GPU. Es más o menos tres veces más lento que la reproducción de la película. De un clip de 270p a 1080p, los mismos 3 segundos tardaron unos 3 segundos de tiempo de GPU (23,9 fotogramas por segundo).
El clip eran 72 fotogramas de Tears of Steel, el cortometraje abierto de la Blender Foundation, reducido a 854 x 480. Muestra a un hombre con barba y chaqueta de cuadros girando la cabeza. También ejecutamos el clip de demo de 360p de los propios autores para una salida de 1440p. Todas las cifras de aquí son el tiempo de GPU de los dos modelos, tal como lo miden los autores, tras un clip de calentamiento, con una petición cada vez en una tarjeta sin otra carga. No probamos clips en paralelo.
| RTX 4090, un fotograma clave cada 15 | Salida | Fotogramas por segundo | Pico de memoria |
|---|---|---|---|
| 480p de entrada | 3416 x 1920 | 7,33 | 20,4 GiB |
| 360p de entrada (clip de los autores) | 2496 x 1440 | 12,27 | 15,5 GiB |
| 270p de entrada | 1920 x 1080 | 23,85 | 13,1 GiB |
A 1080p, la 4090 llegó a cerca del 80% de la cifra de los autores en la A100, con el mismo intervalo y el mismo tamaño de salida en un clip más corto.
La salida es claramente más nítida que un escalado 4x bicúbico simple, el filtro de redimensionado estándar. Las caras, el pelo, la barba y la tela de la chaqueta ganan un detalle convincente. La muestra en pantalla partida lo enseña a media velocidad.
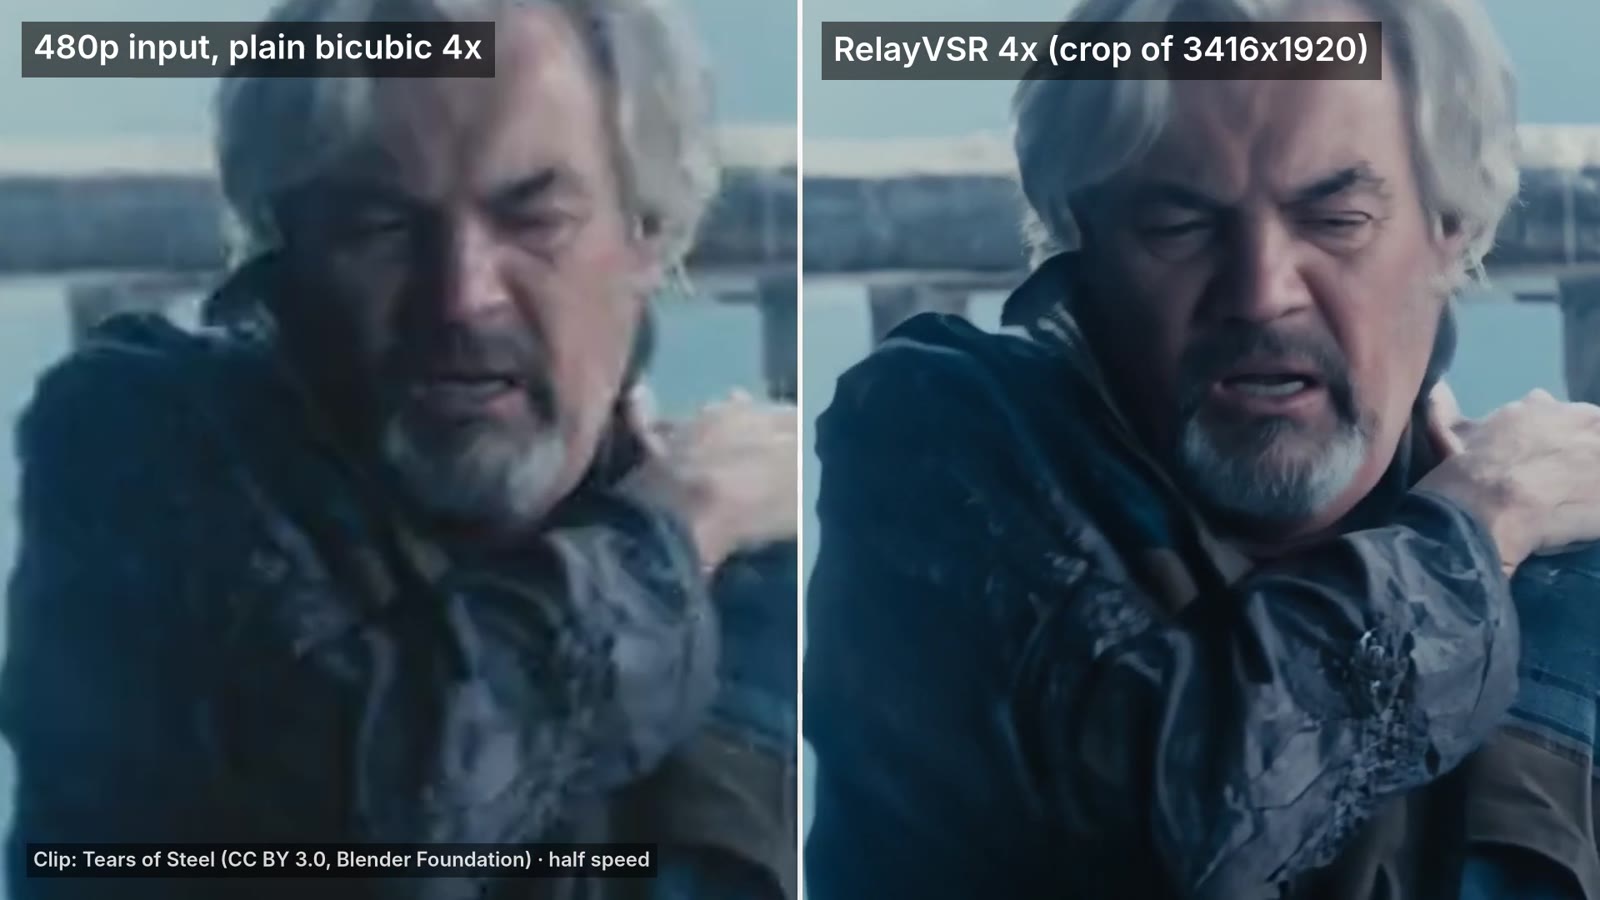
Es una comprobación visual sobre un clip, no un benchmark de calidad: miramos fotogramas sueltos y solo comparamos con el bicúbico. El detalle añadido es generado, verosímil en lugar de recuperado, así que revísalo antes de usarlo donde importe la fidelidad. La entrada era una película HD limpia reducida, así que el metraje antiguo o dañado de verdad está sin probar.
Un fotograma clave cada 31 es una cuarta parte más rápido, y más blando con movimiento rápido
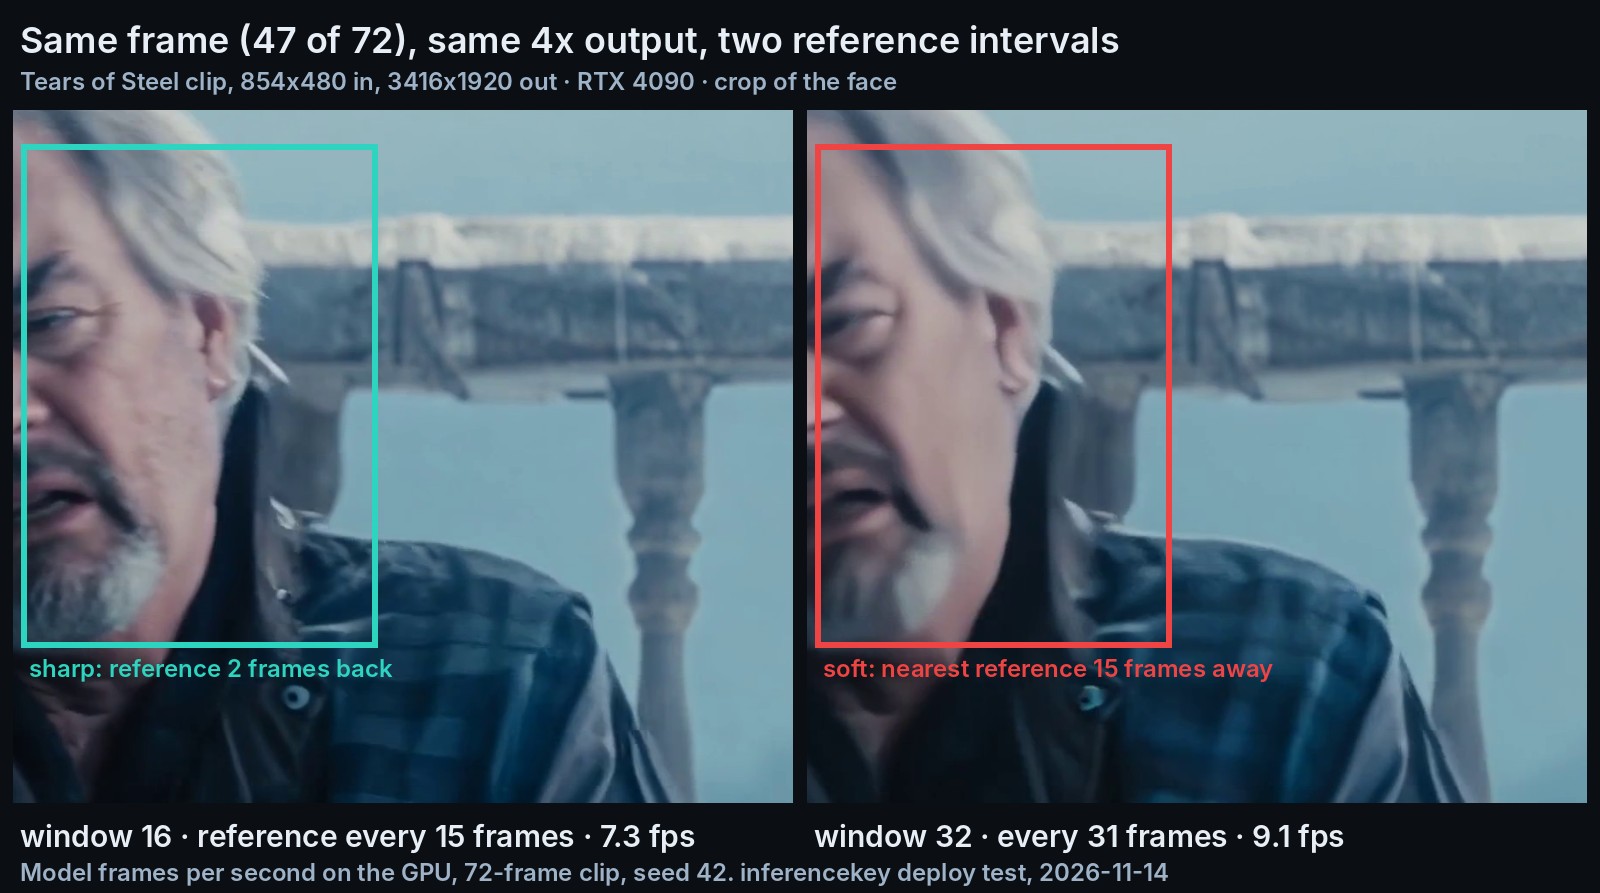
Separar los fotogramas clave el doble bajó el clip de 3 segundos de unos 10 a unos 8 segundos de tiempo de GPU (de 7,33 a 9,10 fotogramas por segundo). El precio se nota con el movimiento. Es un ajuste por petición: un fotograma clave cada 15 por defecto, o uno cada 31.
Mira el fotograma 47 de la imagen de arriba. Con el valor por defecto, el último fotograma clave estaba 2 fotogramas antes, y la cara sale nítida. Con un fotograma clave cada 31, el más cercano está a 15 fotogramas, en mitad de un giro de cabeza, y la cara se ablanda. El intercalador llevó el detalle todo lo lejos que pudo, y en una cara en movimiento 15 fotogramas era demasiado. En el fotograma 38, a 7 fotogramas de un fotograma clave en los dos modos, las dos salidas se parecen.
Con este único clip, nuestra intuición es que las escenas más lentas aguantan el intervalo largo, mientras que el movimiento rápido y las caras deberían quedarse con el valor por defecto.
Qué GPU: 24 GB para entrada de 480p, un presupuesto de 16 GB solo para salida de 1080p
La tarjeta real más pequeña que funcionó fue una de 24 GB. Tanto la RTX 4090 como la RTX 3090 escalaron 480p a 3416 x 1920. La 3090 es la tarjeta más antigua y barata, e iba a la mitad de velocidad, más o menos: 3,76 fotogramas por segundo, 19 segundos de tiempo de GPU para el clip de 3 segundos. Con salida de 1080p tardó unos 7 segundos para el clip (10,69 fotogramas/s).
Los presupuestos más pequeños solo pudimos emularlos. Intentamos conseguir una tarjeta real de 16 GB en nuestra nube, y todas las opciones de 16 GB que probamos estaban sin stock. Así que limitamos cuánta memoria de la 4090 podía usar el modelo. Un límite de 15,2 GiB hace las veces de una tarjeta de 16 GB, y uno de 11,2 GiB de una de 12 GB (un GiB es un gigabyte algo mayor, unos 1,07 GB). El código de los autores no tiene ningún interruptor para sacar partes del modelo de la GPU, así que la única palanca era el tamaño de la entrada.
| Tarjeta o presupuesto de memoria (los presupuestos son límites en la 4090) | Entrada a salida | Resultado |
|---|---|---|
| RTX 3090 24 GB, tarjeta real | 480p a 1920p | 3,76 fotogramas/s |
| Presupuesto de 16 GB | 480p a 1920p | sin memoria |
| Presupuesto de 16 GB | 360p a 1440p | sin memoria |
| Presupuesto de 16 GB | 270p a 1080p | entra, misma salida que sin límite |
| Presupuesto de 12 GB | 270p a 1080p | sin memoria |
Nada entró en el límite de 12 GB: solo el modelo grande ocupa 9,6 GiB, y deja demasiado poco para los fotogramas.
Lo que no probamos: formatos numéricos más pequeños que ahorran memoria, y clips de más de 72 fotogramas. 1440p llegó a un pico de 15,5 GiB, por encima de nuestro límite pero por debajo del total de una tarjeta de 16 GB, así que queda abierto si funciona en una real.
En InferenceKey: listo en 71 segundos, y la GPU no es la parte lenta
La tarjeta es tuya por horas, y el modelo estaba sirviendo 71,2 segundos después de pedirlo. Esos segundos cubren montar el entorno de Python, cargar 10,2 GB de pesos en la GPU y un clip de calentamiento corto, con los pesos ya copiados en el disco local de la máquina. En la 3090 el mismo proceso tardó 165,8 segundos, frenado por las descargas de esa máquina. Era una copia local de nuestra plataforma, no el servicio alojado.
Nada de lo que viene integrado sirve un escalador de vídeo, así que escribimos un backend propio. Es un fichero pequeño de Python que le dice a la plataforma cómo cargar el modelo y responder a las peticiones. Ejecuta una versión fija del código de los propios autores, con sus ajustes. Envías el clip dentro de una petición de API estándar, y la respuesta trae el vídeo 4x y sus tiempos.
El problema con el que te vas a encontrar es el tiempo de CPU, no el de GPU. Un clip de 72 fotogramas a 1920p tardó de 26 a 41 segundos desde la petición hasta la respuesta, para 8 a 10 segundos de trabajo de GPU. El resto es comprimir 72 fotogramas grandes en un MP4 en el procesador. Además, la respuesta tiene que entrar en un único mensaje de 8 MB, así que un clip de 1920p se comprime dos veces. A 1080p entra a la primera, y la ida y vuelta completa tardó de 6,4 a 7,2 segundos. Estado: abierto. Viene de devolver el vídeo dentro de la respuesta. El README del ejemplo dice que se envíen los vídeos largos en trozos de 2 a 3 segundos, y devolver un enlace de descarga en su lugar eliminaría la segunda pasada.
¿Deberías usarlo? Una tarjeta de 24 GB, el intervalo por defecto, clips cortos
- Escalar 480p a 1920p: una tarjeta de 24 GB, una 4090 o, a la mitad de velocidad, una 3090.
- Salida de 1080p a partir de clips de baja resolución: entró en un presupuesto de 16 GB (emulado).
- Movimiento rápido y caras: mantén un fotograma clave cada 15.
- Escenas lentas, donde lo que más importa es la velocidad: uno cada 31 te da cerca de una cuarta parte más de velocidad.
- Un presupuesto de 12 GB: nada entró en nuestro límite emulado.
- Audio: no se copia, así que vuelve a ponerlo tú.
Para escalar tu propio clip en tu propia GPU, ejecuta python main.py my-clip.mp4 desde el ejemplo del SDK de RelayVSR. Necesita una tarjeta NVIDIA de 24 GB y unos 25 GB de disco, y escribe los dos intervalos de fotogramas clave en outputs/.
Para ingenieros
Créditos
- Xijun Wang, Xin Li, Zirui Lang, Suhang Yao, Haoran Li y Zhibo Chen (Universidad de Ciencia y Tecnología de China): RelayVSR, el artículo "RelayVSR: Large-Small Model Collaboration for Efficient Real-World Video Super-Resolution" (arXiv 2609.37850, enviado el 29 de septiembre de 2026), los pesos (Apache-2.0), el código con
inference.pyyrefvsr_inference, y la página del proyecto. - Wan-AI: Wan2.2-TI2V-5B (Apache-2.0), la base del generador de referencias.
- FlashVSR (OpenImagingLab, Zhuang et al., 2026): una referencia de comparación en el artículo, reconocida en el README de los autores. El artículo llama a la red pequeña Dual-Memory Video Transformer, de diseño de los autores; en el código su clase es
FlashVSRConditionNet, descrita como "FlashDecoder-style streaming VSR with configurable persistent conditions" (checkpointflash.safetensors). - Hugging Face Diffusers: diffusers (fijado en 0.37.1), reconocido por los autores.
- Blender Foundation: Tears of Steel (CC) Blender Foundation | mango.blender.org, CC BY 3.0, nuestro clip de prueba.
- AI Search: donde lo vimos (AI NEWS, 2026-11-08, capítulo en 02:32).
- Nuestra parte: el backend propio, el despliegue a través de la plataforma, los tiempos, la escalera de memoria, las comprobaciones visuales, el ejemplo del SDK y el vídeo de demo.
Modelo y método
kopper/RelayVSR: sha751954dc8adf34aa1d636a39fc548b9089703c85, última modificación 2026-11-13T05:04:59Z, sin acceso restringido, apache-2.0, modelo baseWan-AI/Wan2.2-TI2V-5B. Ficheros:wan.safetensorsde 10.066.399.024 B (generador de referencias adaptado de Wan2.2-TI2V-5B, con los embeddings de prompt incluidos) yflash.safetensorsde 127.759.784 B (la red VSR ligera; el valor por defecto de los autores es "S, step 60000, EMA").- Mecanismo, "Sparse Generative Relay": el modelo grande produce latentes de referencia solo para fotogramas clave dispersos; un "Dual-Memory Video Transformer" ligero aplica superresolución a cada fotograma a partir de esas referencias y del vídeo de baja resolución.
- En el código,
CollaborativeFrameStream(refvsr_inference/runtime/streaming.py) ejecuta el generador Wan una vez por extremo (un paso en el timestep 1000, guidance 1.0) sobre el primer y el último fotograma de cada ventana, con extremos que se solapan. La red pequeña decodifica cada fotograma de la ventana condicionado por los latentes de ambos extremos (dual-endpoint), con una ventana de atención de vídeo de dos fotogramas (el actual y uno anterior). Un clip de 72 fotogramas recibe 6 referencias con ventana 16 y 4 con ventana 32. - Tabla 5 del artículo (los "32 millones de parámetros" del texto son parámetros entrenables): Wan2.2-TI2V-5B con un LoRA de rango 512 (1.32B parámetros entrenables, LoRA más proyección LR). Red pequeña: 10 bloques transformer de anchura 512, ventana de atención de vídeo de 2 fotogramas (24 x 24 en espacio), 31.9M parámetros entrenables.
- El entrenamiento del modelo grande termina con Video-Aware Reference Optimization (VARO), un paso de aprendizaje por refuerzo con dos recompensas: una a nivel de sistema sobre el vídeo que produce la red pequeña fija, y otra a nivel de referencia sobre la calidad de los fotogramas clave decodificados.
- Ficha de Wan2.2-TI2V-5B: VAE de compresión 16 x 16 x 4, 720p a 24 fps, una sola GPU de consumo como una 4090 (al menos 24 GB con flags de offload).
- Flags de los autores:
--window-sizepor defecto 16 ("Reference interval + 1"; cuenta los dos extremos, así que los fotogramas clave caen cada 15 fotogramas, y la ventana 32 da uno cada 31; el README dice que se suba "to let the small model process more intermediate frames"),--dtype bf16|fp16|fp32(por defecto bf16),--max-frames,--fps,--seed 42,--start-frame,--cpu-threads 8. La salida es exactamente 4x la entrada, conserva los FPS y no copia el audio. Versiones fijadas: torch 2.10.0 (extra cu128), diffusers 0.37.1, accelerate 1.15.0, triton 3.6, av. Python 3.11 a 3.13, Linux, GPU NVIDIA. Sin interruptor de offload ni de poca VRAM.
Cifras de los autores (tabla 8 del artículo, 201 fotogramas, 4x, una A100 de 80 GB, intervalo 15; no reproducidas por nosotros salvo donde se indica):
| Salida | Dual-endpoint fps / GB | Fps con primer fotograma clave |
|---|---|---|
| 720p | 58,32 / 11,92 | 68,59 |
| 1080p | 29,29 / 13,82 (primer fotograma 0,327 s) | 35,89 |
| 1440p | 17,59 / 16,47 | 21,44 |
| 2160p | 8,23 / 24,25 | 10,05 |
Referencias de comparación a 1080p en la misma tabla (fps / GB): SwiftVR 23,48 / 31,36, FlashVSR 7,80 / 24,45, Stream-DiffVSR 0,85 / 25,92, SeedVR2-3B 0,79 / 73,89, DOVE 0,56 / 41,08, SparkVSR 0,56 / 41,30, RealBasicVSR 18,50 / 24,81, RealViformer 14,87 / 12,36.
Tabla 9 (A100, dual-endpoint) por intervalo de fotogramas clave 5 / 10 / 15 / 20 / 25: 1080p 18,10 / 25,60 / 29,29 / 32,20 / 34,13 fps; 2160p 4,91 / 7,12 / 8,23 / 9,17 / 9,69 fps.
Los dos escaladores más pesados que se citan en el texto son SeedVR2-3B y DOVE.
Tabla 11 (estudio con usuarios bueno-igual-malo, positivo a favor de RelayVSR), calidad general: +26,7 frente a SwiftVR, -3,3 frente a FlashVSR (casi neutral), +46,8 frente a SeedVR2, +53,6 frente a DOVE. Frente a DOVE, fidelidad al contenido -8,9 y estabilidad temporal -8,7: DOVE es el que sale mejor valorado en esas dos.
Configuración y por qué
- GPU: una RTX 4090 de 24 GB en nuestra nube (InferenceKey Cloud) para la ejecución principal y la escalera de memoria (24.564 MiB, 450 W). Después, una RTX 3090 real de 24 GB en nuestra nube (24.576 MiB, 350 W) como segunda tarjeta de consumo. Las dos son las variantes estándar de 24 GB. El objetivo para un tercer peldaño era una tarjeta de 16 GB, pero todas las opciones de 16 GB que probamos devolvieron "no stock" (RTX 4080 SUPER, RTX 4080, RTX 5080, RTX 2000 Ada, RTX A4000, V100 16 GB), y las RTX 4000 Ada y RTX A4500 de 20 GB devolvieron lo mismo.
- Backend: un backend propio nuevo de Python,
relayvsr-video-upscale0.1.0 (RelayVSRBackend), CPython 3.12.setup()descarga el tarball del código de los autores en el commite856773350f53036d825404c9ea9228e6dffadca(solorefvsr_inference/, el clip de demo y LICENSE), descarga los dos checkpoints en la revisión fijada, montaload_checkpoints+WanVSRPipelineexactamente comoinference.pyy ejecuta un calentamiento de 17 fotogramas a 128 x 224.process()decodifica el clip, lo pasa en streaming porCollaborativeFrameStream, suma los tiemposDeviceSpande los autores por etapa, codifica en H.264 con CRF 18 y sube el CRF (18, 22, 26, 30, 34) hasta que el base64 entra en 7,5 MB. Por qué propio: ningún backend integrado sirve un modelo de vídeo a vídeo. Por qué el código de los autores: sus cifras están medidas con él, y es la única vía que ejecuta los dos modelos juntos. - Transporte: el SDK no tiene un tipo de tarea de vídeo para backends propios, así que el paquete y el workload van etiquetados como
text2imagey el vídeo viaja como JSON en base64 por la ruta de chat (/v1/chat/completions). - Plataforma: un manager local de InferenceKey, nats-proxy y un worker compilados desde main. Producción sin tocar.
- Pesos en el worker: descargados de antemano al disco local del worker (8,6 s en la máquina de la 4090, 83,5 s en la de la 3090) mientras el worker montaba el venv.
Paso a paso con el ejemplo del SDK
El ejemplo es el commit c06208ce en main de inferencekey-sdk: backend.py, publish.py, main.py, requirements.txt, README.md, .env.example.
Necesitas un token del SDK (ik_sdk_), una API key (ik_live_), el slug del proyecto, el id de un worker privado de NVIDIA asignado al proyecto (IK_WORKER_ID), y tu id de tenant más un token de sesión del panel para publish.py y para activar la ruta de chat (o haz las dos cosas en el panel). El worker necesita unos 25 GB de disco (venv de unos 7 GB, pesos de 10,2 GB) y gcc (Triton y FlexAttention compilan kernels en el primer uso).
El SDK aún no está en PyPI, así que el cliente usa la compilación local del repositorio (examples/CONTRIBUTING.md, sección 4). En .env.example, INFERENCEKEY_TENANT_ID y INFERENCEKEY_USER_TOKEN están comentados: descoméntalos y rellénalos para publish.py y la ruta de chat, o haz los dos pasos en el panel.
git clone https://github.com/inferencekey/inferencekey-sdk.git
cd inferencekey-sdk/examples/relayvsr-video-upscale-custom-backend-private-nvidia
python -m venv .venv && . .venv/bin/activate
pip install maturin requests
( cd ../../bindings/python && maturin develop --release )   # local SDK build into this venv
cp .env.example .env         # INFERENCEKEY_SDK_TOKEN, INFERENCEKEY_API_KEY,
                             # INFERENCEKEY_PROJECT, IK_WORKER_ID, and uncomment
                             # INFERENCEKEY_TENANT_ID, INFERENCEKEY_USER_TOKEN
python publish.py            # once: packages backend.py and uploads it to your tenant
python main.py my-clip.mp4   # or no argument: the authors' 360p demo clip
main.py llama a ensure() para un workload fijo en IK_WORKER_ID (ready_timeout_secs 2400, request_timeout_secs 900), activa el endpoint de chat, espera con wait_until_ready(2400), escala el clip con ventana 16 y ventana 32 y escribe outputs/x4-w16.mp4 y outputs/x4-w32.mp4. Borra el workload al salir salvo que IK_KEEP_ALIVE=1. RVSR_CLIP_FRAMES (por defecto 72) fija los fotogramas por llamada.
Una petición es JSON en el último mensaje del usuario:
{"video_b64": "<base64 MP4, up to 5 MB>", "window_size": 16, "max_frames": 72, "seed": 42}
video_url (https) o "demo": true sirven en lugar de video_b64. window_size tiene que estar entre 2 y 64. Fotogramas de entrada de hasta 960 x 544 (RVSR_MAX_PIXELS), hasta 241 fotogramas (RVSR_MAX_FRAMES). El contenido del mensaje de la respuesta es JSON: video_b64 (H.264, sin audio), width, height, frames, fps, keyframes, crf y timings (model_fps, wan_ms, flash_ms, first_frame_ms, wall_s, peak_vram_mib). El endpoint es POST /endpoint/<project>/relayvsr/v1/chat/completions.
Ajustes del backend, que se pasan por el env del workload: RVSR_VRAM_LIMIT_GIB (limita la memoria de GPU del backend con torch.cuda.set_per_process_memory_fraction), RVSR_DTYPE, RVSR_MAX_FRAMES, RVSR_MAX_PIXELS, RVSR_OUTPUT_DIR (guarda una copia con CRF 18 en el worker) y RVSR_WARMUP.
Mediciones completas
Tiempo hasta estar listo:
- RTX 4090: "ready after 71.2 s" según el SDK. Log del backend:
download 20.1s, load 8.4s, warmup 4.2s, weights in VRAM 9.62 GiB. - RTX 3090: "ready after 165.8 s" (el venv tardó unos 2 min en esa máquina).
A través del endpoint, llamadas en caliente, seed 42. Fps del modelo = fotogramas / tiempo del modelo (tiempo de GPU de los dos modelos, la medida de los autores). Ida y vuelta desde el cliente HTTP hasta el manager local.
| Tarjeta | Entrada a salida | Ventana | Fotogramas | Refs | Modelo s | Fps del modelo | Wan ms | Red pequeña ms | Primer fotograma ms | Pico MiB | Ida y vuelta s |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 4090 | 854x480 a 3416x1920 | 16 | 72 | 6 | 9,82 / 9,84 | 7,33 / 7,31 | 4.842 | 4.747 | 1.565 | 20.880 | 41,2 / 40,3 |
| 4090 | 854x480 a 3416x1920 | 32 | 72 | 4 | 7,91 | 9,10 | 3.104 | 4.630 | 1.571 | 20.880 | 25,7 |
| 4090 | 480x270 a 1920x1080 | 16 | 72 | 6 | 3,02 (8,11 la primera) | 23,85 | 1.404 | 1.528 | 472 | 13.364 | 7,2 |
| 4090 | 480x270 a 1920x1080 | 32 | 72 | 4 | 2,47 | 29,1 | 902 | 1.502 | 477 | 13.364 | 6,4 |
| 4090 | 624x360 a 2496x1440 | 16 | 48 | 5 | 3,91 (9,28 la primera) | 12,27 | 2.108 | 1.693 | 822 | 15.887 | 10,0 |
| 4090 | 624x360 a 2496x1440 | 32 | 48 | 3 | 2,94 | 16,31 | 1.242 | 1.630 | 888 | 15.801 | 9,4 |
| 3090 | 854x480 a 3416x1920 | 16 | 72 | 6 | 19,16 | 3,76 | 8.674 | 10.001 | 2.862 | 20.880 | 41,6 |
| 3090 | 854x480 a 3416x1920 | 32 | 72 | 4 | 15,74 | 4,58 | 5.575 | 9.810 | 2.832 | 20.880 | 38,0 |
| 3090 | 480x270 a 1920x1080 | 16 | 72 | 6 | 6,74 (14,81 la primera) | 10,69 | 2.996 | 3.528 | 998 | 13.364 | 13,5 |
| 3090 | 624x360 a 2496x1440 | 16 | 48 | 5 | 8,15 (16,77 la primera) | 5,89 | 4.134 | 3.781 | 1.719 | 15.887 | 18,5 |
- Pico de memoria reservada: 21.408 MiB (1920p), 16.112 MiB (1440p), 13.520 MiB (1080p). Pico de la tarjeta en nvidia-smi (muestreo cada 1 s): 21.900 MiB en la 4090, 21.750 MiB en la 3090.
- Primera llamada con un tamaño de fotograma nuevo (Triton y FlexAttention compilan para esa geometría), 4090: 4,71 frente a 7,33 fps a 1920p, 8,88 frente a 23,85 fps a 1080p. 3090: 2,59 fps a 1920p en la primera llamada.
- Adónde se va la ida y vuelta de 1920p (4090, ventana 16): decodificación 2,1 s, bucle de streaming con codificación H.264 CRF 18 en CPU 15,0 s (9,8 s de ellos del modelo), recodificación con CRF 22 22,0 s porque el fichero con CRF 18 superaba el límite de 7,5 MB en base64; tiempo total del backend 40,1 s. Los clips de 1920p volvieron con CRF 22, unos 4,9 MB.
- 1080p frente a los autores: 23,85 fps (ventana 16) en la 4090 frente a sus 29,29 fps en una A100 de 80 GB; la ventana 32 da 29,1 en la 4090. Su pico a 1080p es de 13,82 GB, el nuestro de 13.364 MiB (14,0 GB).
Escalera de VRAM. Los peldaños emulados se ejecutaron en la 4090 tras borrar el workload, en el venv del backend, un proceso por peldaño, con RVSR_VRAM_LIMIT_GIB asociado a torch.cuda.set_per_process_memory_fraction, los mismos clips y seed 42.
| GPU o límite | Configuración | Pico de VRAM | Velocidad | Salida | Real o emulado |
|---|---|---|---|---|---|
| RTX 4090 24 GB | bf16, 480p de entrada, 3416x1920 de salida, ventana 16, a través de la plataforma | 20.880 MiB (tarjeta 21.900) | 7,33 fps (9,82 s por 72 fotogramas) | ok, referencia | real |
| RTX 3090 24 GB | igual, a través de la plataforma | 20.880 MiB (tarjeta 21.750) | 3,76 fps (19,16 s por 72 fotogramas) | ok | real |
| Límite de 15,2 GiB (tarjeta de 16 GB) | 480p de entrada, 1920p de salida, ventana 16 | OutOfMemoryError: CUDA out of memory. Tried to allocate 38.00 MiB ... 15.20 GiB allowed | emulado | ||
| Límite de 15,2 GiB | 360p de entrada (clip de los autores), 1440p de salida, ventana 16 | Tried to allocate 96.00 MiB ... 15.20 GiB allowed | emulado | ||
| Límite de 15,2 GiB | 270p de entrada, 1080p de salida, ventana 16 / 32 | 13.355 MiB (reservados 15.518) | 23,91 / 29,58 fps | ok, idéntica byte a byte a la ejecución sin límite (ffmpeg PSNR inf) | emulado |
| Límite de 11,2 GiB (tarjeta de 12 GB) | 270p de entrada, 1080p de salida, ventana 16 / 32 | Tried to allocate 56.00 MiB ... 11.20 GiB allowed (solo los pesos del generador, 9,62 GiB) | emulado |
Sin probar: una tarjeta real de 16 GB o de 12 GB (sin stock), 12 GB con algún offload (el código no tiene), fp8 o int8, el modo de primer fotograma clave, clips de más de 72 fotogramas. Una tarjeta real de 16 GB añade una sobrecarga de driver y de contexto que el límite no modela, así que el peldaño de 16 GB es un presupuesto, no una tarjeta.
Clips de prueba y notas de calidad (inspección visual, una semilla, no un benchmark)
- Todas las cifras del texto son llamadas en caliente (tras un clip de calentamiento con ese tamaño de fotograma) con seed 42.
- Clips: (a) 3 s de Tears of Steel desde 00:02:09, recortados a 950 x 534, reducidos a 854 x 480, x264 CRF 28, 72 fotogramas a 24 fps; (b) el mismo clip a 480 x 270; (c) la demo de los autores
assets/demo/input.mp4(624 x 360, 16 fps), los primeros 48 fotogramas. - 480p a 1920p, ventana 16: cara, barba, mechones de pelo y la chaqueta de cuadros claramente más nítidos que el bicúbico 4x; la balaustrada de piedra gana textura. Sin artefactos evidentes en los fotogramas que revisamos (36, 38, 47).
- Ventana 32 frente a 16 en el fotograma 47 (referencia de la ventana 16 en el 45, referencias de la ventana 32 en el 31 y el 62): la ventana 32 se ve blanda en la cara durante el giro de cabeza. Fotograma 38, a 7 fotogramas de una referencia en ambas: se parecen.
- Ninguna métrica de calidad cuantitativa propia, sin audio. Revisamos fotogramas sueltos, no el parpadeo en movimiento en los límites entre fotogramas clave, y el bicúbico fue la única referencia de comparación (ni Real-ESRGAN ni RealBasicVSR en la misma tarjeta).
- Unidades: las cifras de memoria son MiB o GiB (1 GiB son unos 1,07 GB); el pico de 20,4 GiB son 20.880 MiB, unos 21,9 GB.
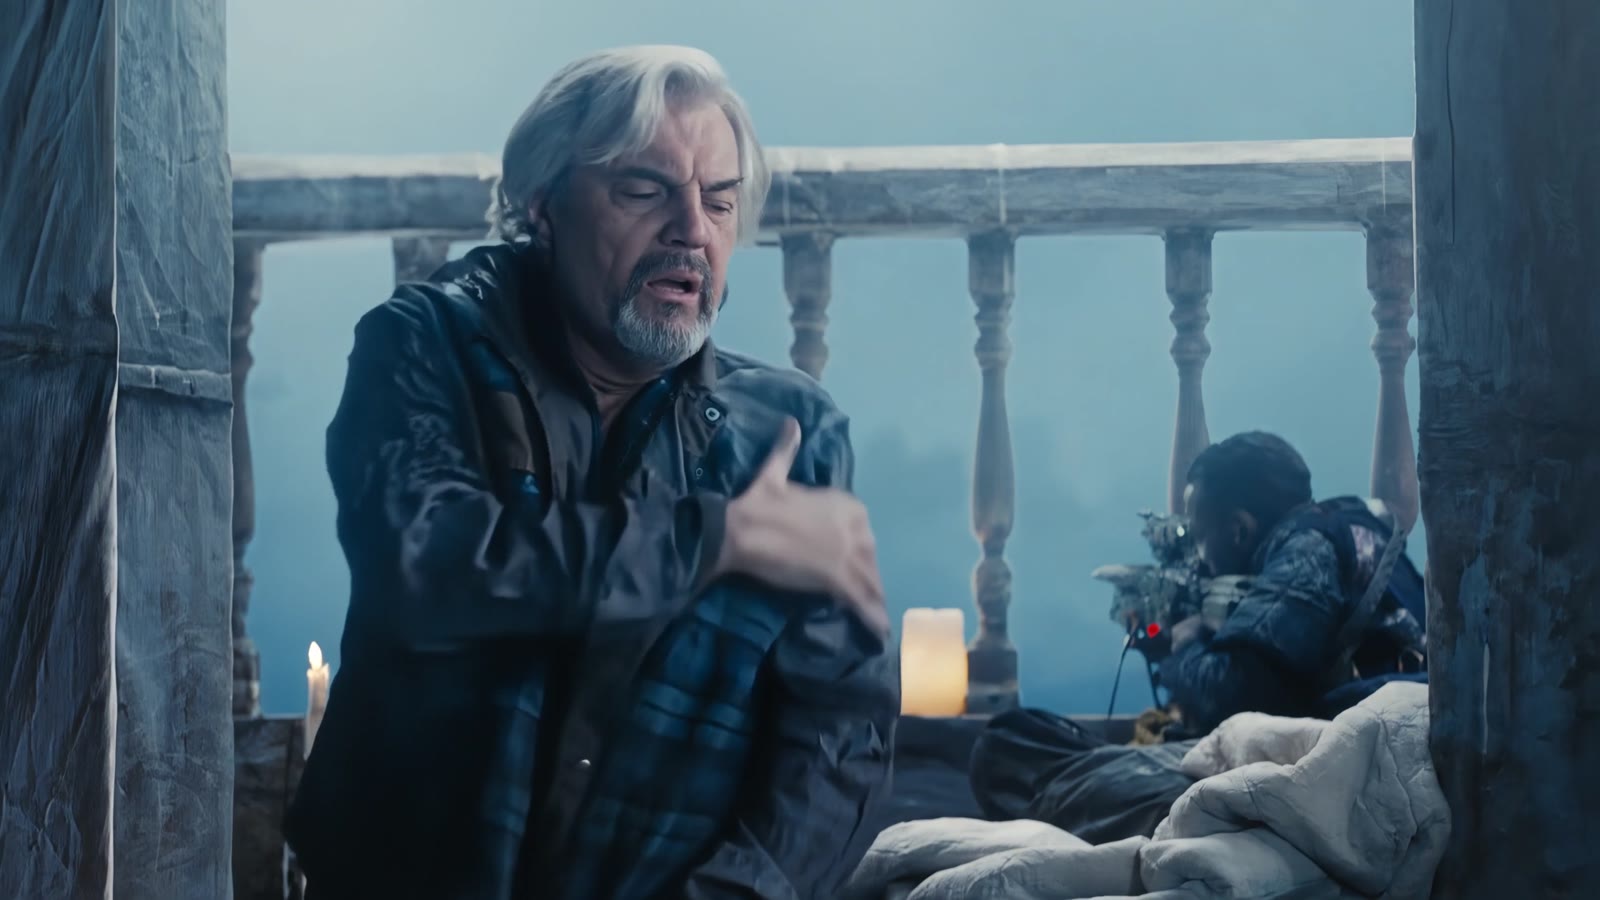
Salida completa de RelayVSR, 3416 x 1920, ventana 16, 72 fotogramas, CRF 22 tal como la devuelve el endpoint:
Vídeo de demo
Un recorrido narrado de 3 minutos (188,5 s): qué es RelayVSR, con los ejemplos y las figuras de los autores acreditados; el panel sirviéndolo en la RTX 4090; nuestras cifras de velocidad, la comparación clave y la escalera de memoria.
Problemas pendientes
- Ida y vuelta dominada por la codificación en CPU: de 26 a 41 s para un clip de 72 fotogramas a 1920p frente a 8 a 10 s de tiempo de GPU, incluida una segunda codificación con CRF 22 para que entre en el mensaje de 8 MB. Estado: abierto, un límite de diseño de devolver el vídeo dentro de la respuesta; una URL de salida en un almacén de objetos evitaría la recodificación. Envía los vídeos largos en trozos de 2 a 3 segundos.
- Sin tipo de tarea de vídeo para backends propios: el backend va etiquetado como
text2imagey el vídeo viaja por la ruta de chat como JSON en base64. Estado: abierto en el SDK, documentado en el ejemplo. - Almacén de objetos local compartido lleno: publicar el backend en el MinIO compartido de nuestra VM de desarrollo devolvió
put custom backend to S3 ... (XMinioStorageFull)porque el disco raíz de la VM estaba al 100 %. Estado: sorteado para la prueba con un MinIO privado en/dev/shm; el disco de la VM de desarrollo sigue necesitando atención. No afecta al servicio alojado. - Grabador de la demo: el
Page.gotoa/logindel grabador del panel agotó el tiempo tres veces (Timeout 30000ms exceeded). Estado: corregido con unstart_urldeabout:blanken el guion. - Menor: el worker registró
NATS connection establisheddos veces al arrancar, sin consecuencias.
Fuentes
- Ficha del modelo
- Código (commit
e856773350f53036d825404c9ea9228e6dffadca) - Artículo, arXiv 2609.37850
- Página del proyecto
- Modelo base, Wan2.2-TI2V-5B
- FlashVSR, una referencia de comparación en el artículo, reconocida por los autores
- Donde lo vimos, AI Search
- Ejemplo del SDK