RelayVSR skaliert einen 3 Sekunden langen 480p-Clip in 10 Sekunden GPU-Zeit auf einer 24-GB-Karte 4x hoch
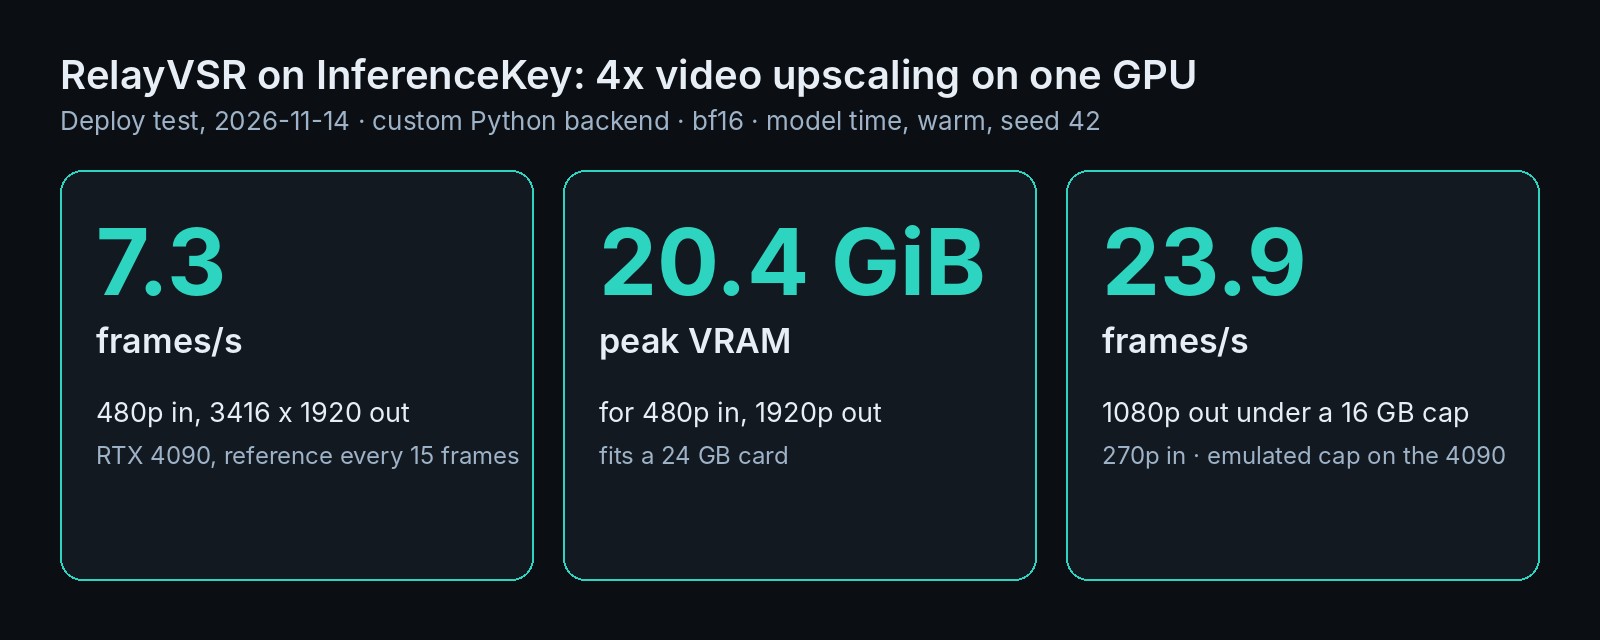
RelayVSR skalierte einen 480p-Clip 4x mit 7,3 frames/s GPU-Zeit auf einer RTX 4090, Spitze 20,4 GiB. Eine emulierte 16-GB-Grenze reichte nur für 1080p.
RelayVSR skaliert Video auf das Vierfache hoch. Ein großes generatives Modell zeichnet nur wenige detailreiche Keyframes, und ein kleines Netz trägt dieses Detail in die Frames dazwischen. Wir haben es auf einer RTX 4090 in unserer Cloud (InferenceKey Cloud) laufen lassen. Ein 3 Sekunden langer 480p-Filmclip kam nach etwa 10 Sekunden GPU-Arbeit mit 3416 x 1920 zurück und belegte dabei 20,4 GiB (etwa 22 GB) der 24 GB Speicher der Karte. Von Anfang bis Ende dauerte die Anfrage 26 bis 41 Sekunden, vor allem wegen der Videokodierung auf der CPU (siehe unten). Eine echte RTX 3090 schaffte denselben Job mit etwa halber Geschwindigkeit. Wenn du eigene GPUs betreibst, heißt das: 4x-Video-Upscaling läuft auf einer 24-GB-Gaming-Karte statt auf einer aus dem Rechenzentrum. Unser SDK-Beispiel deployt es auf deiner eigenen Karte.
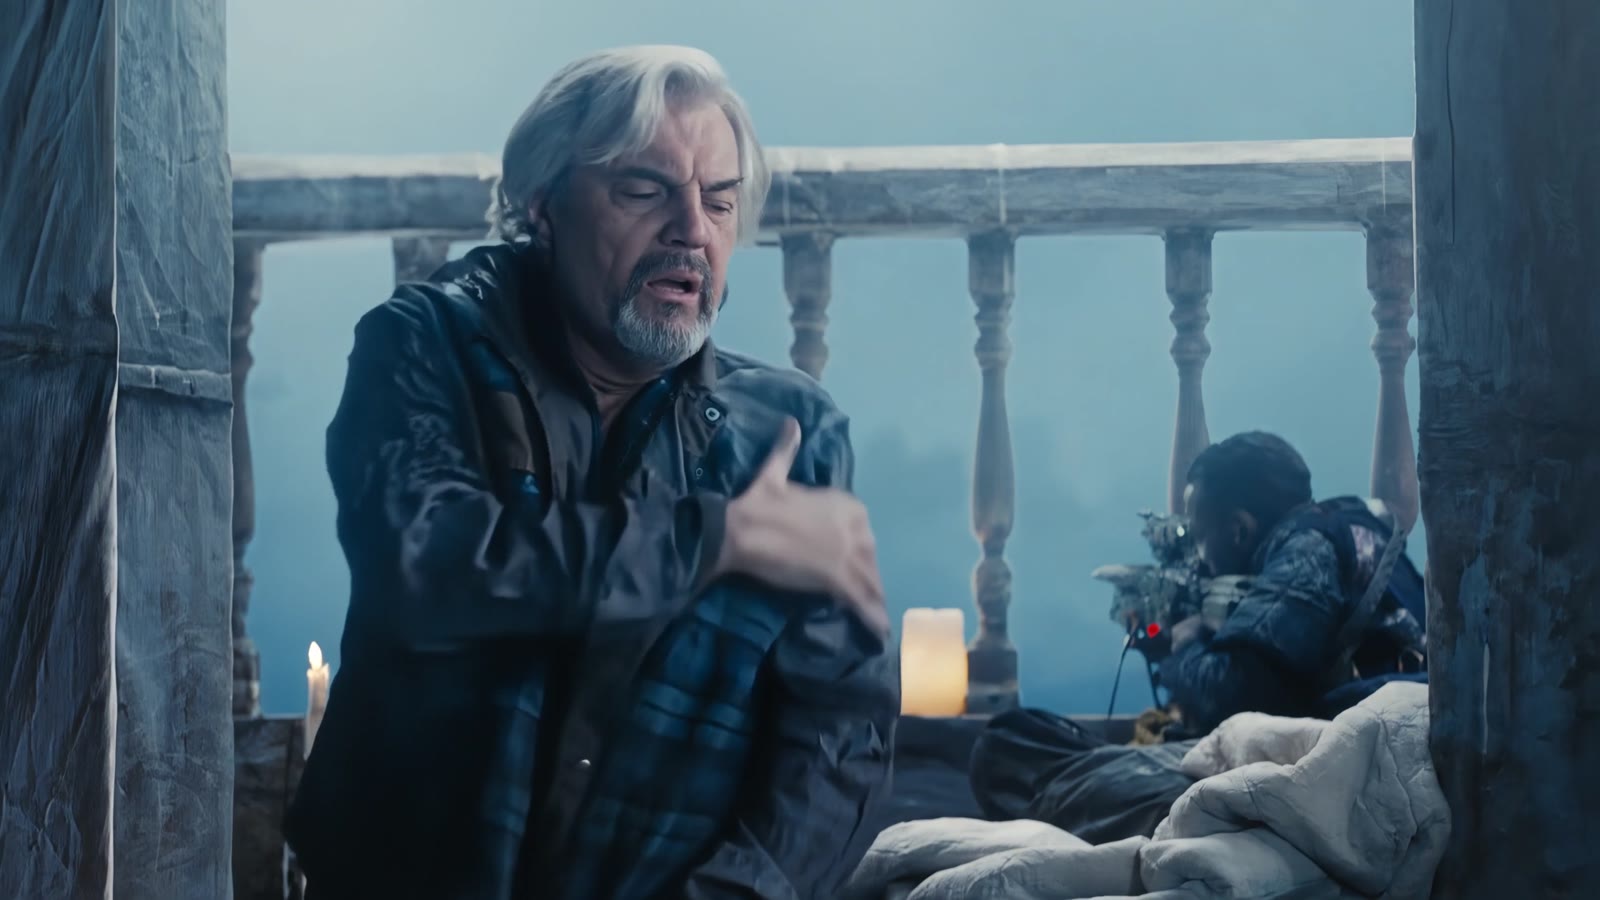
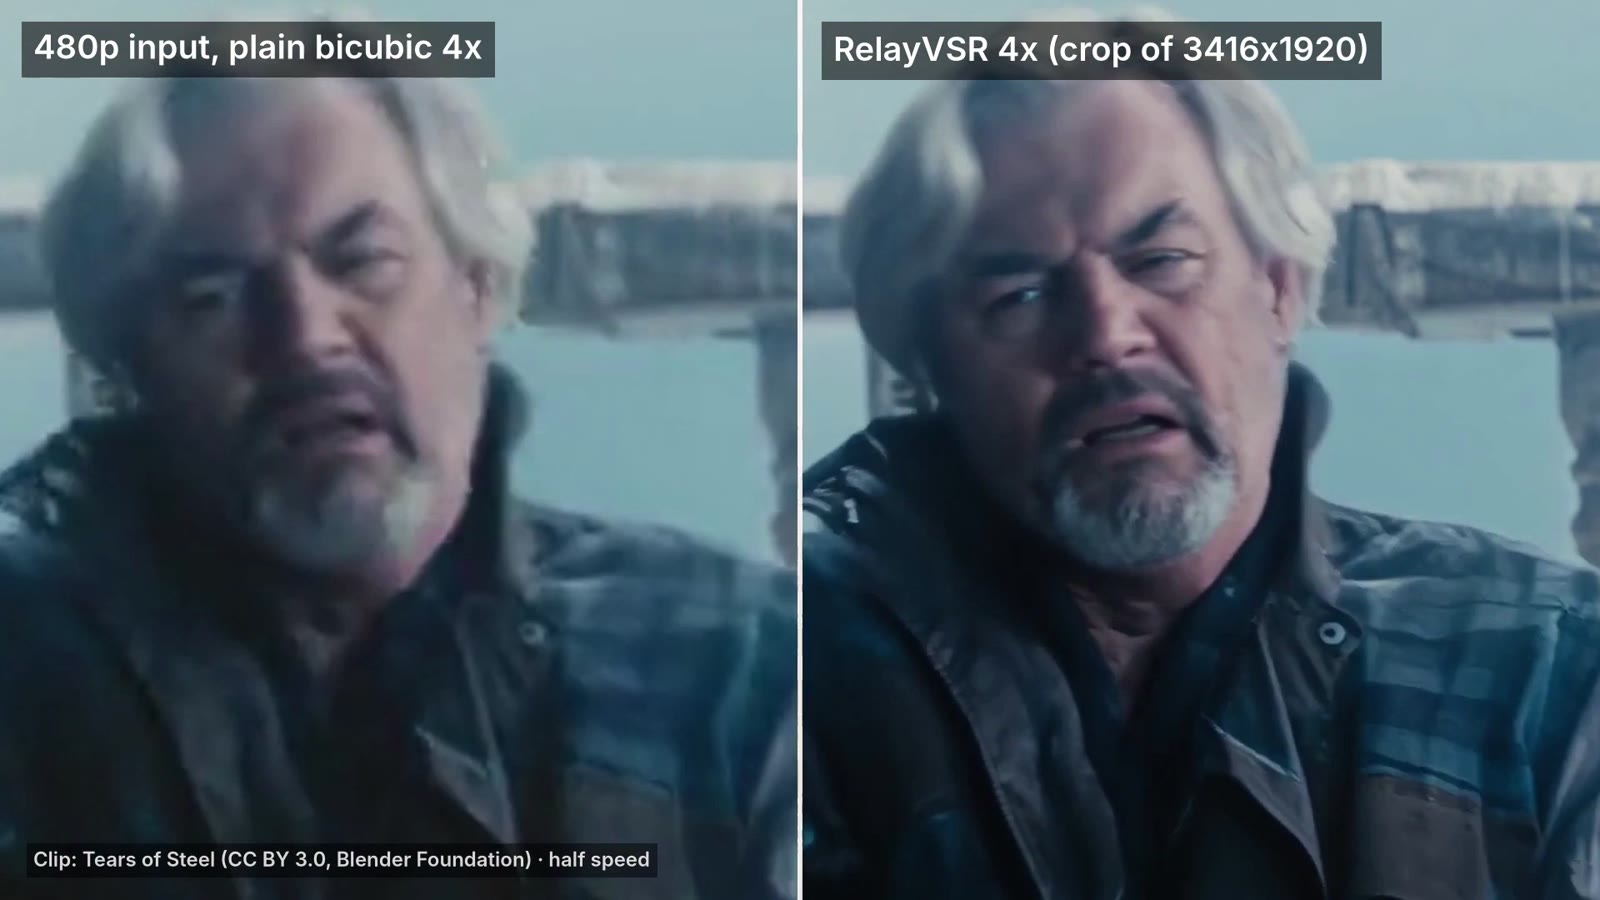
Clip: Tears of Steel (CC) Blender Foundation, mango.blender.org, CC BY 3.0.
| Eine RTX 4090, 3-Sekunden-Clip | Frames pro Sekunde GPU-Zeit | GPU-Speicher in der Spitze |
|---|---|---|
| 480p rein, 3416 x 1920 raus, Keyframe alle 15 Frames | 7,33 | 20,4 GiB |
| Dasselbe, Keyframe alle 31 Frames | 9,10 | 20,4 GiB |
| 270p rein, 1920 x 1080 raus, Keyframe alle 15 Frames | 23,9 | 13,1 GiB (etwa 14 GB), passt in eine 16-GB-Grenze (emuliert) |
Sechs teure Frames von 72: wie RelayVSR die Arbeit aufteilt
RelayVSR ist schnell, weil die meisten Frames das große Modell nie berühren. Stell dir vor, wie handgezeichnete Animation entstand. Ein Hauptanimator zeichnet die Schlüsselposen, und Zwischenphasenzeichner zeichnen die Bilder, die sie verbinden.
RelayVSR macht dasselbe mit zwei Modellen. Der Hauptanimator ist ein Referenzgenerator, abgeleitet von Wan2.2, einem offenen Videomodell von Wan-AI. Er zeichnet alle 15 Frames eine detailreiche Version eines Frames, die Keyframes. Der Zwischenphasenzeichner ist ein kleines Netz eigener Bauart der Autoren, 32 Millionen Parameter gegen 5 Milliarden beim großen Modell. Er skaliert jeden einzelnen Frame hoch und schaut dabei auf das Video in niedriger Auflösung und auf die detailreichen Keyframes auf beiden Seiten. In unserem 72-Frame-Clip hat das große Modell 6 Keyframes gezeichnet, und das kleine Netz hat alle 72 hochskaliert.
Diese Aufteilung ist der Grund, warum eine Karte reicht. Die Autoren haben es bei 1080p auf einer A100 verglichen, einer Karte fürs Rechenzentrum. RelayVSR kommt dort laut Paper auf 29,29 Frames pro Sekunde mit 13,82 GB GPU-Speicher. Der schnellste Konkurrent in ihrer Tabelle kommt auf 23,48 mit 31,36 GB, und zwei schwerere KI-Upscaler schaffen weniger als einen Frame pro Sekunde mit 41 bis 74 GB. In ihrer Nutzerstudie bewerteten die Leute die Gesamtqualität von RelayVSR besser als die dieses Konkurrenten, deutlich besser als die der beiden schweren und etwa gleichauf mit FlashVSR, das in ihrer Tabelle fast viermal langsamer ist. Einer der beiden schweren blieb trotzdem näher an der Quelle und flackerte weniger. Das sind ihre Zahlen, nicht unsere.
Die Arbeit stammt von Xijun Wang, Xin Li, Zirui Lang, Suhang Yao, Haoran Li und Zhibo Chen von der University of Science and Technology of China. Sie haben das Paper am 29. September 2026 veröffentlicht, den Code auf GitHub und die Gewichte auf Hugging Face, zuletzt am 13. November aktualisiert. Wan2.2 und beide Gewichtsdateien von RelayVSR stehen unter Apache-2.0, einer offenen Lizenz, die kommerzielle Nutzung erlaubt. Der Download ist etwa 10,2 GB groß. Entdeckt haben wir es im News-Video von AI Search vom 8. November. Unser Teil: das Backend, das es als API bereitstellt, die Geschwindigkeitstests und der Test mit der kleinsten Karte.
Fast 4K in 10 Sekunden GPU-Zeit für einen 3-Sekunden-Clip, und 1080p etwa so schnell, wie es abspielt
Auf einer RTX 4090 hat RelayVSR 3 Sekunden 480p-Film in etwa 10 Sekunden GPU-Zeit in 3416 x 1920 verwandelt (unten nennen wir das 1920p). Das ist ungefähr dreimal langsamer, als der Film abläuft. Von einem 270p-Clip auf 1080p brauchten dieselben 3 Sekunden etwa 3 Sekunden GPU-Zeit (23,9 Frames pro Sekunde).
Der Clip bestand aus 72 Frames von Tears of Steel, dem offenen Kurzfilm der Blender Foundation, herunterskaliert auf 854 x 480. Er zeigt einen bärtigen Mann in kariertem Jackett, der den Kopf dreht. Außerdem haben wir den 360p-Democlip der Autoren für eine 1440p-Ausgabe laufen lassen. Jede Zahl hier ist die GPU-Zeit der beiden Modelle, so wie die Autoren sie messen, nach einem Aufwärmclip, mit jeweils einer Anfrage auf einer sonst leeren Karte. Gleichzeitige Clips haben wir nicht getestet.
| RTX 4090, Keyframe alle 15 Frames | Ausgabe | Frames pro Sekunde | Speicherspitze |
|---|---|---|---|
| 480p rein | 3416 x 1920 | 7,33 | 20,4 GiB |
| 360p rein (Clip der Autoren) | 2496 x 1440 | 12,27 | 15,5 GiB |
| 270p rein | 1920 x 1080 | 23,85 | 13,1 GiB |
Bei 1080p erreichte die 4090 etwa 80 % des A100-Werts der Autoren, bei gleichem Intervall und gleicher Ausgabegröße, auf einem kürzeren Clip.
Die Ausgabe ist klar schärfer als einfaches bikubisches 4x-Upscaling, der Standardfilter zum Skalieren. Gesichter, Haare, Bart und der Stoff des Jacketts bekommen überzeugende Details. Das Split-Screen-Beispiel zeigt es mit halber Geschwindigkeit.
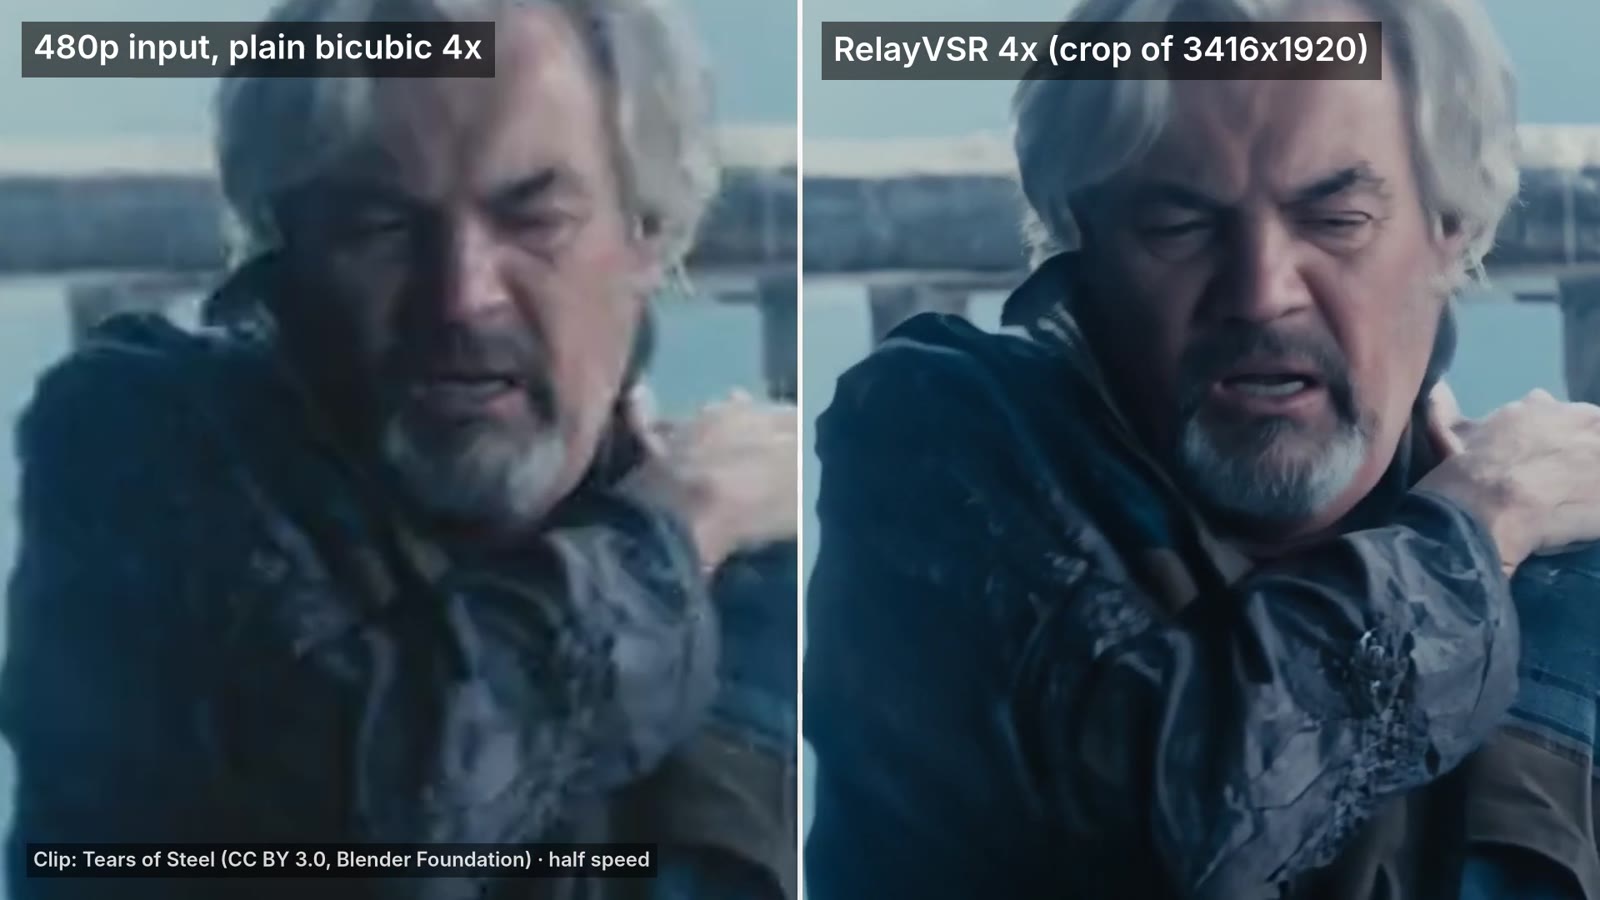
Das ist eine Sichtprüfung an einem Clip, kein Qualitätsbenchmark: Wir haben Standbilder angeschaut und nur mit bikubisch verglichen. Das zusätzliche Detail ist generiert, plausibel statt wiederhergestellt, also prüf es, bevor du es dort einsetzt, wo Originaltreue zählt. Die Eingabe war ein sauberer HD-Film, herunterskaliert; echtes altes oder beschädigtes Material ist ungetestet.
Ein Keyframe alle 31 Frames ist ein Viertel schneller und weicher bei schneller Bewegung
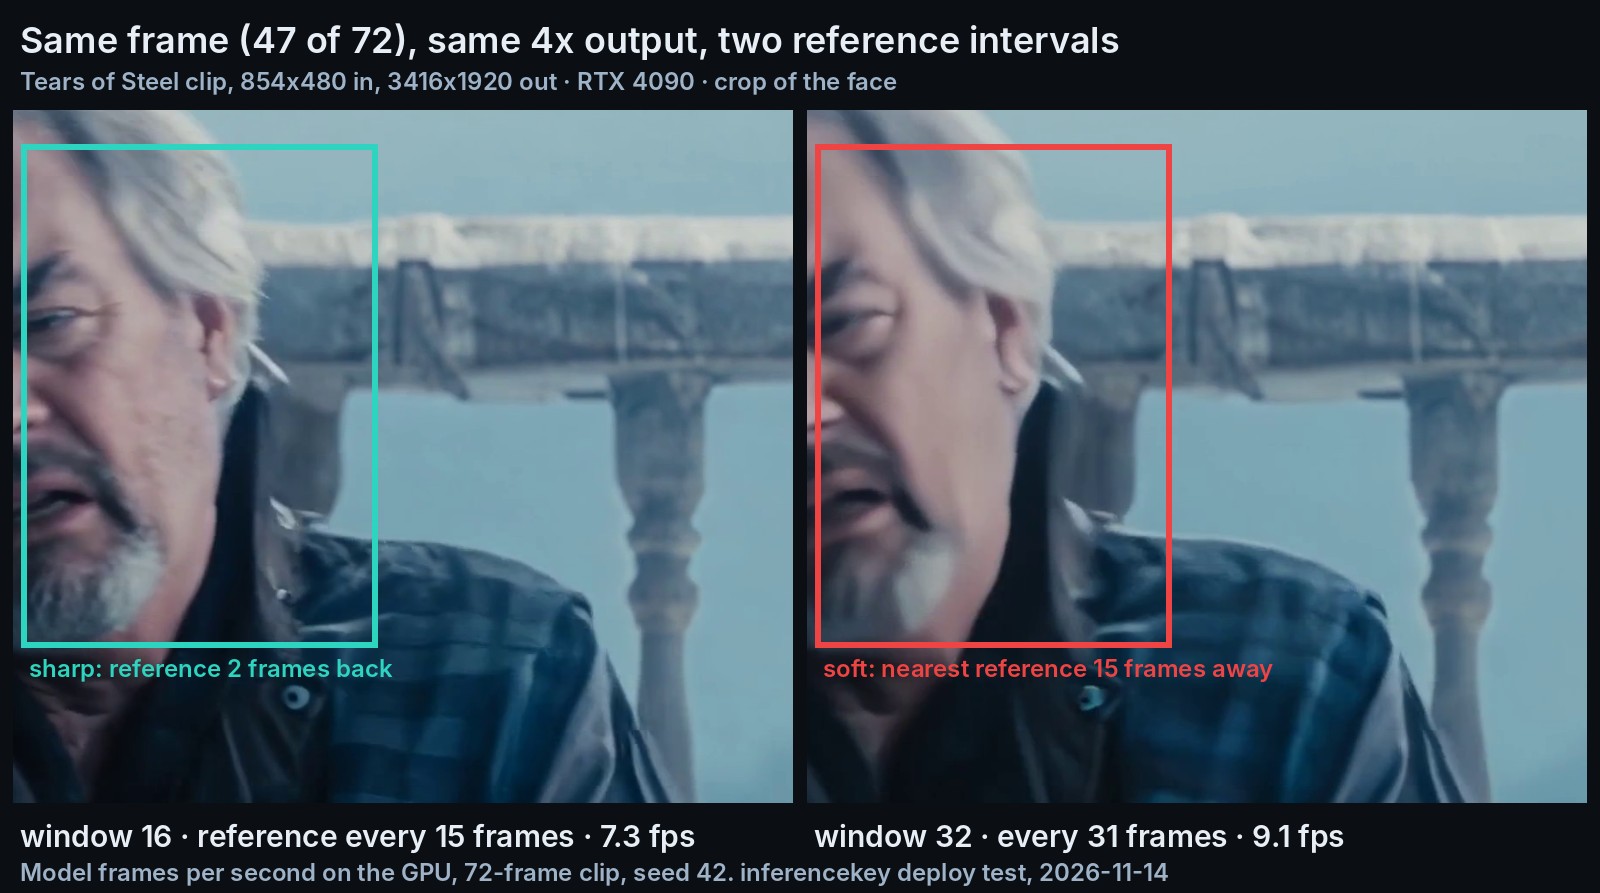
Doppelt so weit auseinanderliegende Keyframes senkten den 3-Sekunden-Clip von etwa 10 auf etwa 8 Sekunden GPU-Zeit (7,33 auf 9,10 Frames pro Sekunde). Der Preis zeigt sich bei Bewegung. Es ist eine Einstellung pro Anfrage: standardmäßig ein Keyframe alle 15 Frames, oder alle 31.
Schau dir Frame 47 im Bild oben an. Mit dem Standard lag der letzte Keyframe 2 Frames davor, und das Gesicht ist scharf. Mit einem Keyframe alle 31 Frames liegt der nächste 15 Frames entfernt, mitten in einer Kopfdrehung, und das Gesicht wird weich. Der Zwischenphasenzeichner hat das Detail so weit getragen, wie er konnte, und bei einem bewegten Gesicht waren 15 Frames zu weit. Bei Frame 38, in beiden Modi 7 Frames von einem Keyframe entfernt, sehen die beiden Ausgaben gleich aus.
Nach diesem einen Clip vermuten wir, dass ruhigere Szenen das längere Intervall vertragen, während schnelle Bewegung und Gesichter beim Standard bleiben sollten.
Welche GPU: 24 GB für 480p-Eingabe, ein 16-GB-Budget nur für 1080p-Ausgabe
Die kleinste echte Karte, die funktioniert hat, war eine mit 24 GB. Sowohl die RTX 4090 als auch die RTX 3090 haben 480p auf 3416 x 1920 hochskaliert. Die 3090 ist die ältere, günstigere Karte und lief mit etwa halber Geschwindigkeit: 3,76 Frames pro Sekunde, 19 Sekunden GPU-Zeit für den 3-Sekunden-Clip. Bei 1080p-Ausgabe brauchte sie etwa 7 Sekunden für den Clip (10,69 frames/s).
Kleinere Budgets konnten wir nur emulieren. Wir haben versucht, in unserer Cloud eine echte 16-GB-Karte zu bekommen, und jede 16-GB-Option, die wir probiert haben, war nicht verfügbar. Also haben wir begrenzt, wie viel vom Speicher der 4090 das Modell nutzen darf. Eine Grenze von 15,2 GiB steht für eine 16-GB-Karte, und 11,2 GiB für eine mit 12 GB (ein GiB ist ein etwas größeres Gigabyte, etwa 1,07 GB). Der Code der Autoren hat keinen Schalter, um Teile des Modells von der GPU auszulagern, also war der einzige Hebel die Größe der Eingabe.
| Karte oder Speicherbudget (Budgets sind Grenzen auf der 4090) | Eingabe zu Ausgabe | Ergebnis |
|---|---|---|
| RTX 3090 24 GB, echte Karte | 480p zu 1920p | 3,76 frames/s |
| 16-GB-Budget | 480p zu 1920p | Speicher voll |
| 16-GB-Budget | 360p zu 1440p | Speicher voll |
| 16-GB-Budget | 270p zu 1080p | passt, gleiche Ausgabe wie ohne Grenze |
| 12-GB-Budget | 270p zu 1080p | Speicher voll |
In die 12-GB-Grenze passte nichts: Das große Modell allein belegt 9,6 GiB, und für die Frames bleibt zu wenig übrig.
Was wir nicht probiert haben: kleinere Zahlenformate, die Speicher sparen, und Clips mit mehr als 72 Frames. 1440p lag in der Spitze bei 15,5 GiB, über unserer Grenze, aber unter dem Gesamtspeicher einer 16-GB-Karte; ob es auf eine echte passt, ist offen.
Auf InferenceKey: bereit in 71 Sekunden, und die GPU ist nicht der langsame Teil
Die Karte gehört dir stundenweise, und das Modell lief 71,2 Sekunden, nachdem wir es angefordert hatten. Diese Sekunden umfassen den Aufbau der Python-Umgebung, das Laden von 10,2 GB Gewichten auf die GPU und einen kurzen Aufwärmclip, wobei die Gewichte schon auf der lokalen Platte der Maschine lagen. Auf der 3090 dauerte derselbe Weg 165,8 Sekunden, ausgebremst von den Downloads dieser Maschine. Das war eine lokale Kopie unseres Stacks, nicht der gehostete Dienst.
Nichts Eingebautes stellt einen Video-Upscaler bereit, also haben wir ein Custom Backend geschrieben. Das ist eine kleine Python-Datei, die der Plattform sagt, wie sie das Modell lädt und Anfragen beantwortet. Sie führt eine feste Version des Codes der Autoren mit deren Einstellungen aus. Du schickst den Clip in einer normalen API-Anfrage, und die Antwort enthält das 4x-Video und seine Zeiten.
Das Problem, auf das du stoßen wirst, ist Zeit auf der CPU, nicht auf der GPU. Ein 72-Frame-Clip in 1920p brauchte von der Anfrage bis zur Antwort 26 bis 41 Sekunden, für 8 bis 10 Sekunden GPU-Arbeit. Der Rest ist das Komprimieren von 72 großen Frames zu einer MP4 auf dem Prozessor. Die Antwort muss außerdem in eine Nachricht von 8 MB passen, also wird ein 1920p-Clip zweimal komprimiert. Bei 1080p passt es beim ersten Versuch, und der ganze Hin- und Rückweg dauerte 6,4 bis 7,2 Sekunden. Status: offen. Es kommt daher, dass das Video in der Antwort zurückgegeben wird. Das README des Beispiels sagt, lange Videos in Stücken von 2 bis 3 Sekunden zu schicken, und ein Download-Link statt des Videos in der Antwort würde den zweiten Durchgang überflüssig machen.
Solltest du es nutzen? Eine 24-GB-Karte, das Standardintervall, kurze Clips
- Upscaling von 480p auf 1920p: eine 24-GB-Karte, eine 4090 oder, mit halber Geschwindigkeit, eine 3090.
- 1080p-Ausgabe aus Clips mit niedriger Auflösung: ein 16-GB-Budget hat gepasst (emuliert).
- Schnelle Bewegung und Gesichter: bleib bei einem Keyframe alle 15 Frames.
- Ruhige Szenen, wo Geschwindigkeit am meisten zählt: alle 31 Frames bringt etwa ein Viertel mehr Tempo.
- Ein 12-GB-Budget: in unsere emulierte Grenze passte nichts.
- Audio: wird nicht übernommen, also füg es selbst wieder hinzu.
Um deinen eigenen Clip auf deiner eigenen GPU hochzuskalieren, führ python main.py my-clip.mp4 aus dem RelayVSR-SDK-Beispiel aus. Es braucht eine NVIDIA-Karte mit 24 GB und etwa 25 GB Platte und schreibt beide Keyframe-Intervalle nach outputs/.
Für Ingenieure
Credits
- Xijun Wang, Xin Li, Zirui Lang, Suhang Yao, Haoran Li und Zhibo Chen (University of Science and Technology of China): RelayVSR, das Paper „RelayVSR: Large-Small Model Collaboration for Efficient Real-World Video Super-Resolution“ (arXiv 2609.37850, eingereicht am 29. Sep. 2026), die Gewichte (Apache-2.0), der Code mit
inference.pyundrefvsr_inferenceund die Projektseite. - Wan-AI: Wan2.2-TI2V-5B (Apache-2.0), die Basis des Referenzgenerators.
- FlashVSR (OpenImagingLab, Zhuang et al., 2026): eine Baseline im Paper und im README der Autoren erwähnt. Das Paper nennt das kleine Netz einen Dual-Memory Video Transformer eigener Bauart; im Code heißt seine Klasse
FlashVSRConditionNet, beschrieben als „FlashDecoder-style streaming VSR with configurable persistent conditions“ (Checkpointflash.safetensors). - Hugging Face Diffusers: diffusers (fixiert auf 0.37.1), von den Autoren erwähnt.
- Blender Foundation: Tears of Steel (CC) Blender Foundation | mango.blender.org, CC BY 3.0, unser Testclip.
- AI Search: wo wir es entdeckt haben (AI NEWS, 2026-11-08, Kapitel bei 02:32).
- Unser Teil: das Custom Backend, das Deployment über die Plattform, die Zeitmessungen, die Speicherleiter, die Sichtprüfungen, das SDK-Beispiel und das Demovideo.
Modell und Methode
kopper/RelayVSR: sha751954dc8adf34aa1d636a39fc548b9089703c85, lastModified 2026-11-13T05:04:59Z, nicht gated, apache-2.0, BasismodellWan-AI/Wan2.2-TI2V-5B. Dateien:wan.safetensors10.066.399.024 B (Referenzgenerator, abgeleitet von Wan2.2-TI2V-5B, Prompt-Embeddings enthalten) undflash.safetensors127.759.784 B (das leichtgewichtige VSR-Netz; der Standard der Autoren ist „S, step 60000, EMA“).- Mechanismus, „Sparse Generative Relay“: Das große Modell erzeugt Referenz-Latents nur für spärliche Keyframes; ein leichtgewichtiger „Dual-Memory Video Transformer“ berechnet jeden Frame in hoher Auflösung aus diesen Referenzen und dem Video in niedriger Auflösung.
- Im Code führt
CollaborativeFrameStream(refvsr_inference/runtime/streaming.py) den Wan-Generator einmal pro Endpunkt aus (ein Schritt bei Timestep 1000, Guidance 1.0), auf dem ersten und letzten Frame jedes Windows, mit überlappenden Endpunkten. Das kleine Netz dekodiert jeden Frame des Windows, konditioniert auf beide Endpunkt-Latents (Dual-Endpoint), mit einem Video-Attention-Window von zwei Frames (aktueller Frame und ein Vorgänger). Ein 72-Frame-Clip bekommt mit Window 16 sechs Referenzen und mit Window 32 vier. - Paper, Tabelle 5 (die „32 Millionen Parameter“ im Erzähltext sind trainierbare Parameter): Wan2.2-TI2V-5B mit einer LoRA von Rang 512 (1,32B trainierbare Parameter, LoRA plus LR-Projektion). Kleines Netz: 10 Transformer-Blöcke der Breite 512, Video-Attention-Window von 2 Frames (räumlich 24 x 24), 31,9M trainierbare Parameter.
- Das Training des großen Modells endet mit Video-Aware Reference Optimization (VARO), einem Reinforcement-Learning-Schritt mit zwei Rewards: einem Reward auf Systemebene für das Video, das das fixierte kleine Netz erzeugt, und einem Reward auf Referenzebene für die Qualität der dekodierten Keyframes.
- Model Card von Wan2.2-TI2V-5B: VAE mit Kompression 16 x 16 x 4, 720p bei 24 fps, eine einzelne Consumer-GPU wie eine 4090 (mindestens 24 GB mit Offload-Flags).
- Flags der Autoren:
--window-sizeStandard 16 („Reference interval + 1“; es zählt beide Enden, also fallen Keyframes alle 15 Frames, und Window 32 ergibt einen alle 31; das README sagt, man solle es erhöhen, „to let the small model process more intermediate frames“),--dtype bf16|fp16|fp32(Standard bf16),--max-frames,--fps,--seed 42,--start-frame,--cpu-threads 8. Die Ausgabe ist genau 4x die Eingabe, FPS bleiben erhalten, Audio wird nicht übernommen. Fixierte Versionen: torch 2.10.0 (Extra cu128), diffusers 0.37.1, accelerate 1.15.0, triton 3.6, av. Python 3.11 bis 3.13, Linux, NVIDIA-GPU. Kein Offload- oder Low-VRAM-Schalter.
Zahlen der Autoren (Paper, Tabelle 8, 201 Frames, 4x, eine A100 80 GB, Intervall 15; von uns nicht reproduziert, außer wo vermerkt):
| Ausgabe | Dual-Endpoint fps / GB | First-Keyframe fps |
|---|---|---|
| 720p | 58,32 / 11,92 | 68,59 |
| 1080p | 29,29 / 13,82 (erster Frame 0,327 s) | 35,89 |
| 1440p | 17,59 / 16,47 | 21,44 |
| 2160p | 8,23 / 24,25 | 10,05 |
Baselines bei 1080p in derselben Tabelle (fps / GB): SwiftVR 23,48 / 31,36, FlashVSR 7,80 / 24,45, Stream-DiffVSR 0,85 / 25,92, SeedVR2-3B 0,79 / 73,89, DOVE 0,56 / 41,08, SparkVSR 0,56 / 41,30, RealBasicVSR 18,50 / 24,81, RealViformer 14,87 / 12,36.
Tabelle 9 (A100, Dual-Endpoint) nach Keyframe-Intervall 5 / 10 / 15 / 20 / 25: 1080p 18,10 / 25,60 / 29,29 / 32,20 / 34,13 fps; 2160p 4,91 / 7,12 / 8,23 / 9,17 / 9,69 fps.
Die beiden schwereren Upscaler, die im Erzähltext vorkommen, sind SeedVR2-3B und DOVE.
Tabelle 11 (Nutzerstudie Good-Same-Bad, positiv spricht für RelayVSR), Gesamtqualität: +26,7 gegen SwiftVR, -3,3 gegen FlashVSR (fast neutral), +46,8 gegen SeedVR2, +53,6 gegen DOVE. Gegen DOVE Inhaltstreue -8,9 und zeitliche Stabilität -8,7: DOVE wird bei diesen beiden besser bewertet.
Setup und warum
- GPUs: eine RTX 4090 24 GB in unserer Cloud (InferenceKey Cloud) für den Hauptlauf und die Speicherleiter (24.564 MiB, 450 W). Dann eine echte RTX 3090 24 GB in unserer Cloud (24.576 MiB, 350 W) als zweite Consumer-Karte. Beide sind die Standardvarianten mit 24 GB. Eine 16-GB-Karte war das Ziel für eine dritte Stufe, aber jede 16-GB-Option, die wir probiert haben, lieferte „no stock“ (RTX 4080 SUPER, RTX 4080, RTX 5080, RTX 2000 Ada, RTX A4000, V100 16 GB), und die RTX 4000 Ada und RTX A4500 mit 20 GB lieferten dasselbe.
- Backend: ein neues Custom Python Backend,
relayvsr-video-upscale0.1.0 (RelayVSRBackend), CPython 3.12.setup()holt das Quell-Tarball der Autoren bei Commite856773350f53036d825404c9ea9228e6dffadca(nurrefvsr_inference/, den Democlip und LICENSE), lädt beide Checkpoints in der fixierten Revision herunter, bautload_checkpoints+WanVSRPipelinegenau wieinference.pyund führt ein Aufwärmen mit 17 Frames in 128 x 224 aus.process()dekodiert den Clip, streamt ihn durchCollaborativeFrameStream, summiert dieDeviceSpan-Zeiten der Autoren pro Stufe, kodiert H.264 mit CRF 18 und erhöht den CRF (18, 22, 26, 30, 34), bis das base64 in 7,5 MB passt. Warum custom: Kein eingebautes Backend stellt ein Modell mit Video rein, Video raus bereit. Warum der Code der Autoren: Ihre Zahlen sind damit gemessen, und es ist der einzige Weg, der die beiden Modelle zusammen ausführt. - Transport: Das SDK hat keinen Video-Task-Typ für Custom Backends, also sind Paket und Workload als
text2imagegetaggt, und das Video reist als base64-JSON über die Chat-Route (/v1/chat/completions). - Stack: ein lokaler InferenceKey-Manager, nats-proxy und Worker, gebaut aus main. Produktion wurde nie angefasst.
- Gewichte auf dem Worker: vorab auf die lokale Platte des Workers heruntergeladen (8,6 s auf der 4090-Maschine, 83,5 s auf der 3090-Maschine), während der Worker das venv gebaut hat.
Schritt für Schritt mit dem SDK-Beispiel
Das Beispiel ist Commit c06208ce auf inferencekey-sdk main: backend.py, publish.py, main.py, requirements.txt, README.md, .env.example.
Du brauchst ein SDK-Token (ik_sdk_), einen API-Key (ik_live_), den Projekt-Slug, die ID eines privaten NVIDIA-Workers, der dem Projekt zugewiesen ist (IK_WORKER_ID), und deine Tenant-ID plus ein Session-Token des Dashboards für publish.py und zum Einschalten der Chat-Route (oder du machst beides im Dashboard). Der Worker braucht etwa 25 GB Platte (venv etwa 7 GB, Gewichte 10,2 GB) und gcc (Triton und FlexAttention kompilieren Kernel beim ersten Einsatz).
Das SDK ist noch nicht auf PyPI, also nutzt der Client den lokalen Build im Repo (examples/CONTRIBUTING.md, Abschnitt 4). In .env.example sind INFERENCEKEY_TENANT_ID und INFERENCEKEY_USER_TOKEN auskommentiert: Kommentier sie ein und füll sie für publish.py und die Chat-Route aus, oder mach beide Schritte im Dashboard.
git clone https://github.com/inferencekey/inferencekey-sdk.git
cd inferencekey-sdk/examples/relayvsr-video-upscale-custom-backend-private-nvidia
python -m venv .venv && . .venv/bin/activate
pip install maturin requests
( cd ../../bindings/python && maturin develop --release )   # local SDK build into this venv
cp .env.example .env         # INFERENCEKEY_SDK_TOKEN, INFERENCEKEY_API_KEY,
                             # INFERENCEKEY_PROJECT, IK_WORKER_ID, and uncomment
                             # INFERENCEKEY_TENANT_ID, INFERENCEKEY_USER_TOKEN
python publish.py            # once: packages backend.py and uploads it to your tenant
python main.py my-clip.mp4   # or no argument: the authors' 360p demo clip
main.py ruft ensure() für einen festen Workload auf IK_WORKER_ID auf (ready_timeout_secs 2400, request_timeout_secs 900), schaltet den Chat-Endpoint ein, wartet mit wait_until_ready(2400), skaliert den Clip mit Window 16 und Window 32 hoch und schreibt outputs/x4-w16.mp4 und outputs/x4-w32.mp4. Beim Beenden löscht es den Workload, außer bei IK_KEEP_ALIVE=1. RVSR_CLIP_FRAMES (Standard 72) legt die Frames pro Aufruf fest.
Eine Anfrage ist JSON in der letzten User-Nachricht:
{"video_b64": "<base64 MP4, up to 5 MB>", "window_size": 16, "max_frames": 72, "seed": 42}
video_url (https) oder "demo": true funktionieren statt video_b64. window_size muss zwischen 2 und 64 liegen. Eingabe-Frames bis 960 x 544 (RVSR_MAX_PIXELS), bis 241 Frames (RVSR_MAX_FRAMES). Der Message-Content der Antwort ist JSON: video_b64 (H.264, ohne Audio), width, height, frames, fps, keyframes, crf und timings (model_fps, wan_ms, flash_ms, first_frame_ms, wall_s, peak_vram_mib). Der Endpoint ist POST /endpoint/<project>/relayvsr/v1/chat/completions.
Backend-Einstellungen, übergeben über die env des Workloads: RVSR_VRAM_LIMIT_GIB (begrenzt den GPU-Speicher des Backends mit torch.cuda.set_per_process_memory_fraction), RVSR_DTYPE, RVSR_MAX_FRAMES, RVSR_MAX_PIXELS, RVSR_OUTPUT_DIR (behält eine Kopie mit CRF 18 auf dem Worker) und RVSR_WARMUP.
Alle Messungen
Zeit bis bereit:
- RTX 4090: „ready after 71.2 s“ vom SDK. Backend-Log:
download 20.1s, load 8.4s, warmup 4.2s, weights in VRAM 9.62 GiB. - RTX 3090: „ready after 165.8 s“ (venv etwa 2 min auf diesem Host).
Über den Endpoint, warme Aufrufe, Seed 42. Modell-fps = Frames / Modellzeit (GPU-Zeit beider Modelle, das Maß der Autoren). Hin- und Rückweg vom HTTP-Client zum lokalen Manager.
| Karte | Eingabe zu Ausgabe | Window | Frames | Refs | Modell s | Modell-fps | Wan ms | Kleines Netz ms | Erster Frame ms | Spitze MiB | Hin und zurück s |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 4090 | 854x480 zu 3416x1920 | 16 | 72 | 6 | 9,82 / 9,84 | 7,33 / 7,31 | 4.842 | 4.747 | 1.565 | 20.880 | 41,2 / 40,3 |
| 4090 | 854x480 zu 3416x1920 | 32 | 72 | 4 | 7,91 | 9,10 | 3.104 | 4.630 | 1.571 | 20.880 | 25,7 |
| 4090 | 480x270 zu 1920x1080 | 16 | 72 | 6 | 3,02 (8,11 erster) | 23,85 | 1.404 | 1.528 | 472 | 13.364 | 7,2 |
| 4090 | 480x270 zu 1920x1080 | 32 | 72 | 4 | 2,47 | 29,1 | 902 | 1.502 | 477 | 13.364 | 6,4 |
| 4090 | 624x360 zu 2496x1440 | 16 | 48 | 5 | 3,91 (9,28 erster) | 12,27 | 2.108 | 1.693 | 822 | 15.887 | 10,0 |
| 4090 | 624x360 zu 2496x1440 | 32 | 48 | 3 | 2,94 | 16,31 | 1.242 | 1.630 | 888 | 15.801 | 9,4 |
| 3090 | 854x480 zu 3416x1920 | 16 | 72 | 6 | 19,16 | 3,76 | 8.674 | 10.001 | 2.862 | 20.880 | 41,6 |
| 3090 | 854x480 zu 3416x1920 | 32 | 72 | 4 | 15,74 | 4,58 | 5.575 | 9.810 | 2.832 | 20.880 | 38,0 |
| 3090 | 480x270 zu 1920x1080 | 16 | 72 | 6 | 6,74 (14,81 erster) | 10,69 | 2.996 | 3.528 | 998 | 13.364 | 13,5 |
| 3090 | 624x360 zu 2496x1440 | 16 | 48 | 5 | 8,15 (16,77 erster) | 5,89 | 4.134 | 3.781 | 1.719 | 15.887 | 18,5 |
- Reservierter Speicher in der Spitze: 21.408 MiB (1920p), 16.112 MiB (1440p), 13.520 MiB (1080p). Kartenspitze in nvidia-smi (Abtastung 1 s): 21.900 MiB auf der 4090, 21.750 MiB auf der 3090.
- Erster Aufruf bei einer neuen Frame-Größe (Triton und FlexAttention kompilieren für die Geometrie), 4090: 4,71 gegen 7,33 fps bei 1920p, 8,88 gegen 23,85 fps bei 1080p. 3090: 2,59 fps bei 1920p beim ersten Aufruf.
- Wohin der 1920p-Hin- und Rückweg geht (4090, Window 16): Dekodieren 2,1 s, Streaming-Schleife mit H.264-Kodierung auf der CPU bei CRF 18 15,0 s (davon Modell 9,8 s), Neukodierung mit CRF 22 22,0 s, weil die Datei mit CRF 18 über der base64-Grenze von 7,5 MB lag; Wall-Zeit des Backends 40,1 s. Die 1920p-Clips kamen mit CRF 22 zurück, etwa 4,9 MB.
- 1080p gegen die Autoren: 23,85 fps (Window 16) auf der 4090 gegen ihre 29,29 fps auf einer A100 80 GB; Window 32 ergibt 29,1 auf der 4090. Ihre 1080p-Spitze liegt bei 13,82 GB, unsere bei 13.364 MiB (14,0 GB).
VRAM-Leiter. Die emulierten Stufen liefen auf der 4090 nach dem Löschen des Workloads, im venv des Backends, ein Prozess pro Stufe, RVSR_VRAM_LIMIT_GIB abgebildet auf torch.cuda.set_per_process_memory_fraction, gleiche Clips, Seed 42.
| GPU oder Grenze | Konfiguration | VRAM-Spitze | Geschwindigkeit | Ausgabe | Echt oder emuliert |
|---|---|---|---|---|---|
| RTX 4090 24 GB | bf16, 480p rein, 3416x1920 raus, Window 16, über die Plattform | 20.880 MiB (Karte 21.900) | 7,33 fps (9,82 s pro 72 Frames) | ok, Referenz | echt |
| RTX 3090 24 GB | dasselbe, über die Plattform | 20.880 MiB (Karte 21.750) | 3,76 fps (19,16 s pro 72 Frames) | ok | echt |
| Grenze 15,2 GiB (16-GB-Karte) | 480p rein, 1920p raus, Window 16 | OutOfMemoryError: CUDA out of memory. Tried to allocate 38.00 MiB ... 15.20 GiB allowed | emuliert | ||
| Grenze 15,2 GiB | 360p rein (Clip der Autoren), 1440p raus, Window 16 | Tried to allocate 96.00 MiB ... 15.20 GiB allowed | emuliert | ||
| Grenze 15,2 GiB | 270p rein, 1080p raus, Window 16 / 32 | 13.355 MiB (reserviert 15.518) | 23,91 / 29,58 fps | ok, byte-identisch mit dem Lauf ohne Grenze (ffmpeg PSNR inf) | emuliert |
| Grenze 11,2 GiB (12-GB-Karte) | 270p rein, 1080p raus, Window 16 / 32 | Tried to allocate 56.00 MiB ... 11.20 GiB allowed (Generatorgewichte allein 9,62 GiB) | emuliert |
Nicht probiert: eine echte Karte mit 16 GB oder 12 GB (nicht verfügbar), 12 GB mit irgendeinem Offload (der Code hat keinen), fp8 oder int8, der First-Keyframe-Modus, Clips mit mehr als 72 Frames. Eine echte 16-GB-Karte bringt Treiber- und Kontext-Overhead mit, den die Grenze nicht abbildet, also ist die 16-GB-Stufe ein Budget, keine Karte.
Testclips und Qualitätsnotizen (Sichtprüfung, ein Seed, kein Benchmark)
- Jede Zahl im Erzähltext ist ein warmer Aufruf (nach einem Aufwärmclip in dieser Frame-Größe) mit Seed 42.
- Clips: (a) 3 s Tears of Steel ab 00:02:09, zugeschnitten auf 950 x 534, skaliert auf 854 x 480, x264 CRF 28, 72 Frames bei 24 fps; (b) derselbe Clip in 480 x 270; (c) die Demo der Autoren
assets/demo/input.mp4(624 x 360, 16 fps), die ersten 48 Frames. - 480p auf 1920p, Window 16: Gesicht, Bart, Haarsträhnen und das karierte Jackett klar schärfer als bikubisch 4x; die steinerne Balustrade bekommt Textur. Keine offensichtlichen Artefakte in den geprüften Frames (36, 38, 47).
- Window 32 gegen 16 bei Frame 47 (Referenz von Window 16 bei 45, Referenzen von Window 32 bei 31 und 62): Window 32 sichtbar weich im Gesicht während der Kopfdrehung. Frame 38, in beiden 7 Frames von einer Referenz entfernt: gleich.
- Keine eigene quantitative Qualitätsmetrik, kein Audio. Wir haben Standbilder geprüft, nicht das Flackern über Keyframe-Grenzen in Bewegung, und bikubisch war die einzige Baseline (kein Real-ESRGAN oder RealBasicVSR auf derselben Karte).
- Einheiten: Speicherangaben sind MiB oder GiB (1 GiB ist etwa 1,07 GB); die Spitze von 20,4 GiB sind 20.880 MiB, etwa 21,9 GB.
Vollständige Ausgabe von RelayVSR, 3416 x 1920, Window 16, 72 Frames, CRF 22, wie vom Endpoint zurückgegeben:
Demovideo
Ein kommentierter Rundgang von 3 Minuten (188,5 s): was RelayVSR ist, mit den Beispielen und Abbildungen der Autoren samt Nennung; das Panel, das es auf der RTX 4090 bereitstellt; unsere Geschwindigkeitszahlen, der Kernvergleich und die Speicherleiter.
Offene Probleme
- Hin- und Rückweg dominiert von der Kodierung auf der CPU: 26 bis 41 s für einen 72-Frame-Clip in 1920p gegen 8 bis 10 s GPU-Zeit, inklusive einer zweiten Kodierung mit CRF 22, damit er in die Nachricht von 8 MB passt. Status: offen, eine Grenze des Designs, Video inline zurückzugeben; eine Ausgabe-URL in einem Object Store würde die Neukodierung vermeiden. Schick lange Videos in Stücken von 2 bis 3 Sekunden.
- Kein Video-Task-Typ für Custom Backends: Das Backend ist als
text2imagegetaggt, und das Video fährt als base64-JSON über die Chat-Route. Status: offen im SDK, im Beispiel dokumentiert. - Geteilter lokaler Object Store voll: Das Veröffentlichen des Backends in das geteilte MinIO unserer Dev-VM lieferte
put custom backend to S3 ... (XMinioStorageFull), weil die Root-Platte der VM bei 100 % lag. Status: für den Test umgangen mit einem privaten MinIO auf/dev/shm; die Platte der Dev-VM braucht noch Aufmerksamkeit. Den gehosteten Dienst betrifft das nicht. - Demo-Recorder:
Page.gotodes Panel-Recorders auf/loginlief dreimal in einen Timeout (Timeout 30000ms exceeded). Status: behoben mit einerstart_urlvonabout:blankim Storyboard. - Kleinigkeit: Der Worker hat beim Start zweimal
NATS connection establishedgeloggt, harmlos.
Quellen
- Model Card
- Code (Commit
e856773350f53036d825404c9ea9228e6dffadca) - Paper, arXiv 2609.37850
- Projektseite
- Basismodell, Wan2.2-TI2V-5B
- FlashVSR, eine Baseline im Paper, von den Autoren erwähnt
- Wo wir es entdeckt haben, AI Search
- SDK-Beispiel