RelayVSR agrandit 4x un clip 480p de 3 secondes en 10 secondes de temps GPU sur une seule carte de 24 GB
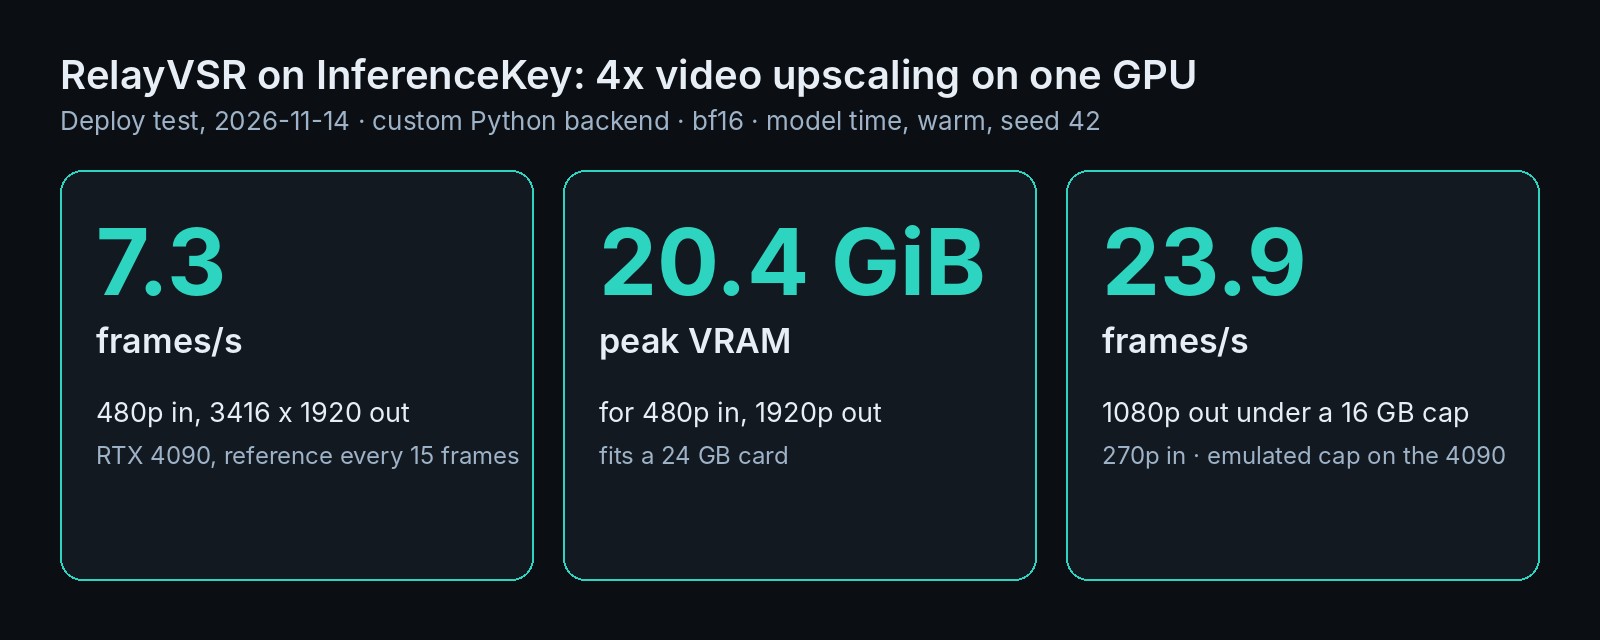
RelayVSR a agrandi 4x un clip 480p à 7,3 images/s de temps GPU sur une RTX 4090, avec un pic à 20,4 GiB. Un plafond émulé de 16 GB n'a tenu que la 1080p.
RelayVSR agrandit une vidéo 4x. Un gros modèle génératif ne dessine que quelques images clés détaillées, et un petit réseau reporte ce détail sur les images intermédiaires. Nous l'avons fait tourner sur une seule RTX 4090 de notre cloud (InferenceKey Cloud). Un extrait de film de 3 secondes en 480p est ressorti en 3416 x 1920 après environ 10 secondes de travail GPU, en utilisant 20,4 GiB (environ 22 GB) des 24 GB de mémoire de la carte. De bout en bout, la requête a pris de 26 à 41 secondes, surtout à cause de l'encodage vidéo sur le CPU (voir plus bas). Une vraie RTX 3090 a fait le même travail à environ la moitié de la vitesse. Si vous avez vos propres GPU, cela met l'agrandissement vidéo 4x à la portée d'une carte de jeu de 24 GB, sans carte de datacenter. Notre exemple du SDK le déploie sur votre propre carte.
Extrait : Tears of Steel (CC) Blender Foundation, mango.blender.org, CC BY 3.0.
| Une RTX 4090, extrait de 3 secondes | Images par seconde de temps GPU | Pic de mémoire GPU |
|---|---|---|
| 480p en entrée, 3416 x 1920 en sortie, une image clé toutes les 15 images | 7,33 | 20,4 GiB |
| Pareil, une image clé toutes les 31 images | 9,10 | 20,4 GiB |
| 270p en entrée, 1920 x 1080 en sortie, une image clé toutes les 15 images | 23,9 | 13,1 GiB (environ 14 GB), tient sous un plafond de 16 GB (émulé) |
Six images coûteuses sur 72 : comment RelayVSR partage le travail
RelayVSR est rapide parce que la plupart des images ne passent jamais par le gros modèle. Imaginez comment on faisait le dessin animé à la main. Un animateur principal dessine les poses clés, et des intervallistes dessinent les images qui les relient.
RelayVSR fait la même chose avec deux modèles. L'animateur principal est un générateur de références adapté de Wan2.2, un modèle vidéo ouvert de Wan-AI. Il dessine une version détaillée d'une image sur 15, les images clés. L'intervalliste est un petit réseau conçu par les auteurs, 32 millions de paramètres contre 5 milliards pour le gros modèle. Il agrandit chaque image, une par une, en regardant la vidéo basse résolution et les images clés détaillées de part et d'autre. Dans notre extrait de 72 images, le gros modèle a dessiné 6 images clés, et le petit réseau a agrandi les 72.
C'est ce partage qui fait qu'une seule carte suffit. Les auteurs l'ont comparé en 1080p sur une A100, une carte de datacenter. RelayVSR annonce 29,29 images par seconde avec 13,82 GB de mémoire GPU. Le concurrent le plus rapide de leur tableau annonce 23,48 avec 31,36 GB, et deux agrandisseurs IA plus lourds passent sous une image par seconde avec 41 à 74 GB. Dans leur étude utilisateurs, les participants ont jugé la qualité globale de RelayVSR supérieure à celle de ce concurrent, nettement supérieure à celle des deux lourds, et à peu près au niveau de FlashVSR, presque quatre fois plus lent dans leur tableau. L'un des deux lourds restait tout de même plus fidèle à la source et scintillait moins. Ce sont leurs chiffres, pas les nôtres.
Le travail est celui de Xijun Wang, Xin Li, Zirui Lang, Suhang Yao, Haoran Li et Zhibo Chen, de l'University of Science and Technology of China. Ils ont publié l'article le 29 septembre 2026, le code sur GitHub et les poids sur Hugging Face, mis à jour pour la dernière fois le 13 novembre. Wan2.2 et les deux fichiers de poids de RelayVSR sont sous Apache-2.0, une licence ouverte qui autorise l'usage commercial. Le téléchargement pèse environ 10,2 GB. Nous l'avons repéré dans la vidéo d'actualité d'AI Search du 8 novembre. Notre part : le backend qui le sert comme une API, les tests de vitesse et le test de la plus petite carte.
Presque de la 4K en 10 secondes de temps GPU pour un extrait de 3 secondes, et de la 1080p à peu près à la vitesse de lecture
Sur une seule RTX 4090, RelayVSR a transformé 3 secondes de film en 480p en 3416 x 1920 (que nous appelons 1920p plus bas) en environ 10 secondes de temps GPU. C'est à peu près trois fois plus lent que la lecture du film. D'un extrait en 270p vers de la 1080p, les mêmes 3 secondes ont pris environ 3 secondes de temps GPU (23,9 images par seconde).
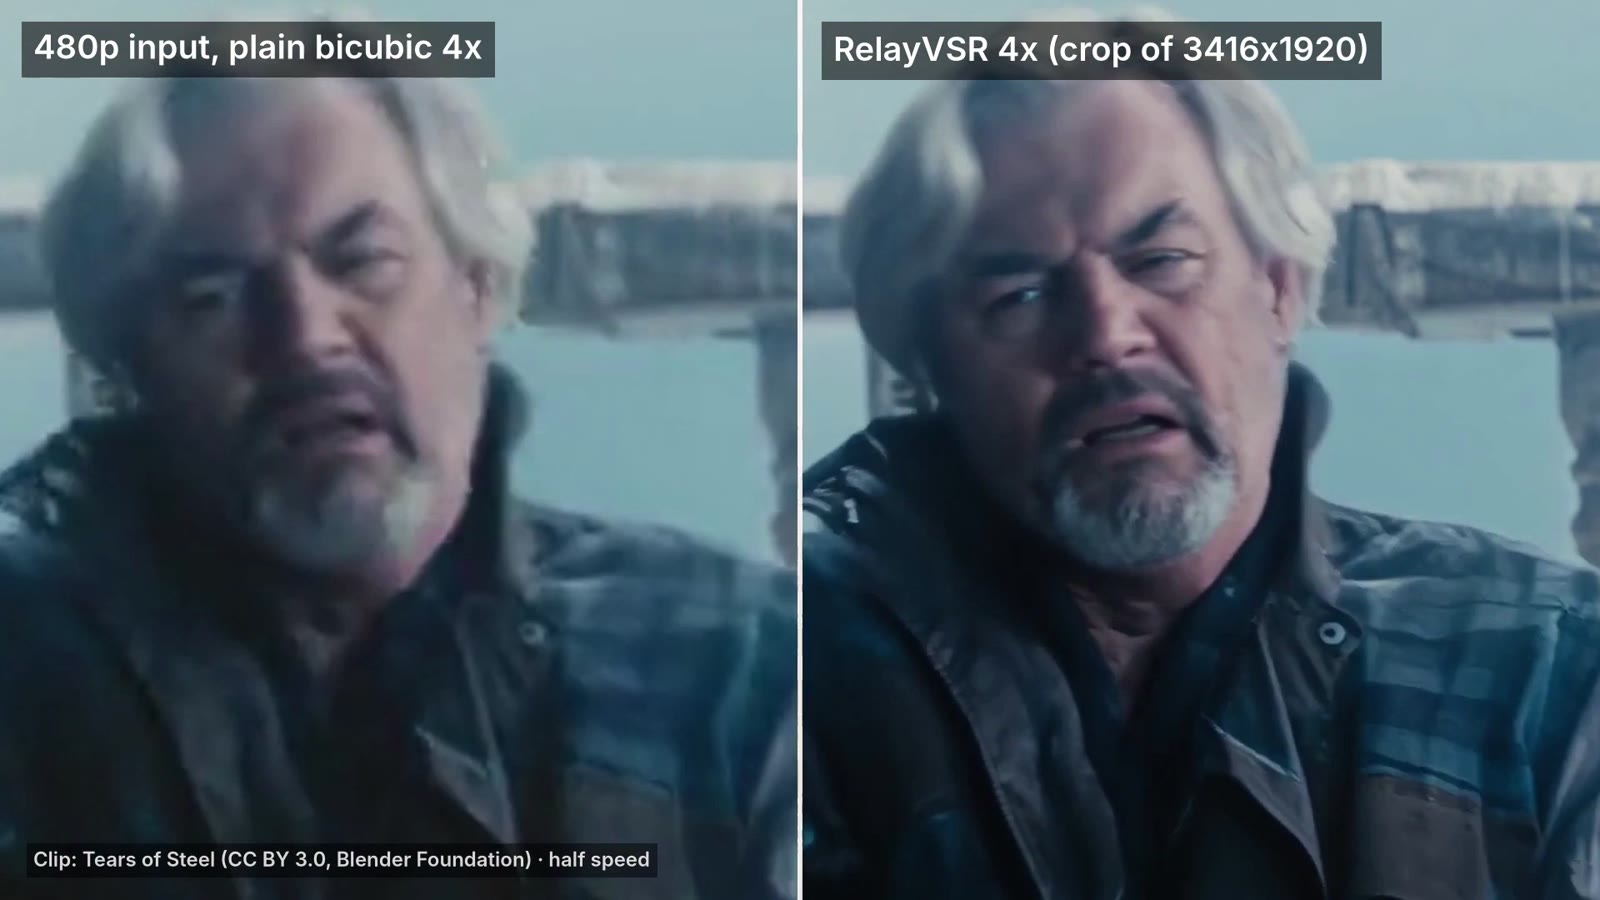
L'extrait faisait 72 images de Tears of Steel, le court métrage ouvert de la Blender Foundation, réduit à 854 x 480. On y voit un homme barbu en veste à carreaux qui tourne la tête. Nous avons aussi fait tourner l'extrait de démo en 360p des auteurs pour une sortie en 1440p. Chaque chiffre ici est le temps GPU des deux modèles, mesuré comme le font les auteurs, après un extrait de chauffe, avec une requête à la fois sur une carte par ailleurs inactive. Nous n'avons pas testé d'extraits simultanés.
| RTX 4090, une image clé toutes les 15 images | Sortie | Images par seconde | Pic de mémoire |
|---|---|---|---|
| 480p en entrée | 3416 x 1920 | 7,33 | 20,4 GiB |
| 360p en entrée (extrait des auteurs) | 2496 x 1440 | 12,27 | 15,5 GiB |
| 270p en entrée | 1920 x 1080 | 23,85 | 13,1 GiB |
En 1080p, la 4090 a atteint environ 80 % du chiffre des auteurs sur A100, au même intervalle et à la même taille de sortie, sur un extrait plus court.
La sortie est nettement plus nette qu'un simple agrandissement bicubique 4x, le filtre de redimensionnement standard. Les visages, les cheveux, la barbe et le tissu de la veste gagnent un détail convaincant. L'échantillon en écran partagé le montre au ralenti, à mi-vitesse.
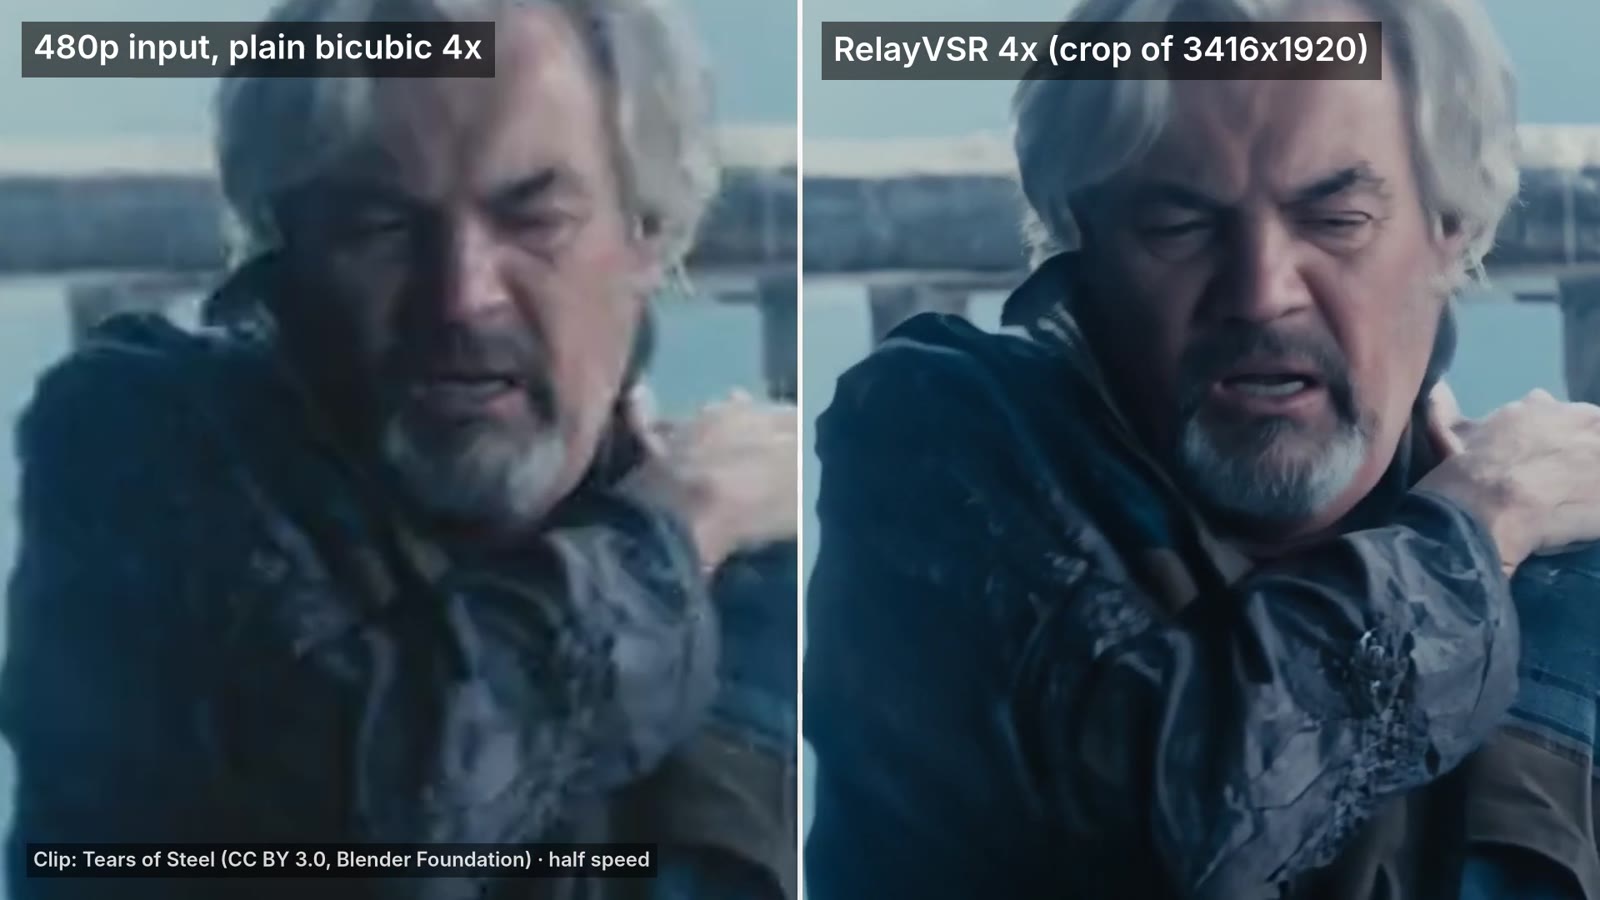
C'est une vérification visuelle sur un seul extrait, pas un benchmark de qualité : nous avons regardé des images fixes et comparé uniquement au bicubique. Le détail ajouté est généré, plausible plutôt que retrouvé, donc vérifiez-le avant de l'utiliser là où la fidélité compte. L'entrée était un film HD propre réduit en taille, donc de vraies images anciennes ou abîmées restent non testées.
Une image clé toutes les 31 images va un quart plus vite, et floute davantage les mouvements rapides
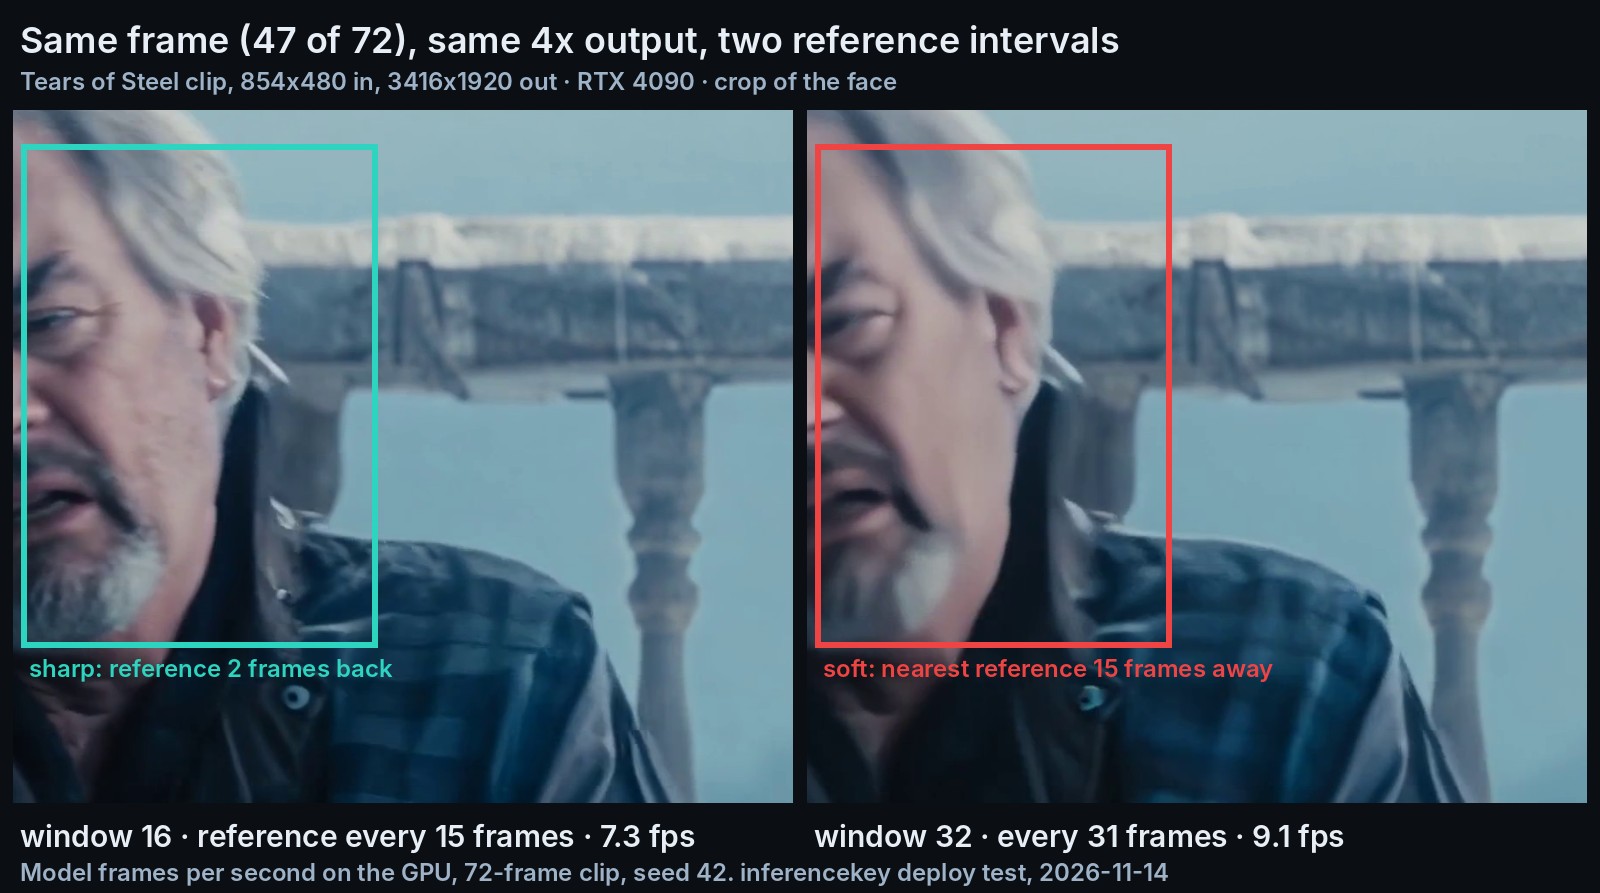
Espacer les images clés deux fois plus a fait passer l'extrait de 3 secondes d'environ 10 à environ 8 secondes de temps GPU (de 7,33 à 9,10 images par seconde). Le prix se voit sur le mouvement. C'est un seul réglage par requête : une image clé toutes les 15 images par défaut, ou toutes les 31.
Regardez l'image 47 en haut de la page. Avec le réglage par défaut, la dernière image clé se trouvait 2 images plus tôt, et le visage est net. Avec une image clé toutes les 31 images, la plus proche est à 15 images, au milieu d'un mouvement de tête, et le visage devient flou. L'intervalliste a porté le détail aussi loin qu'il le pouvait, et sur un visage en mouvement, 15 images, c'était trop. À l'image 38, à 7 images d'une image clé dans les deux modes, les deux sorties se ressemblent.
D'après ce seul extrait, notre hypothèse est que les scènes plus lentes supportent l'intervalle long, tandis que les mouvements rapides et les visages devraient garder le réglage par défaut.
Quel GPU : 24 GB pour une entrée en 480p, un budget de 16 GB seulement pour une sortie en 1080p
La plus petite vraie carte qui a fonctionné faisait 24 GB. La RTX 4090 comme la RTX 3090 ont agrandi du 480p en 3416 x 1920. La 3090 est la carte plus ancienne et moins chère, et elle a tourné à environ la moitié de la vitesse : 3,76 images par seconde, 19 secondes de temps GPU pour l'extrait de 3 secondes. En sortie 1080p, il lui a fallu environ 7 secondes pour l'extrait (10,69 images/s).
Les budgets plus petits, nous n'avons pu que les émuler. Nous avons essayé d'obtenir une vraie carte de 16 GB sur notre cloud, et chaque option de 16 GB essayée était en rupture de stock. Nous avons donc plafonné la part de mémoire de la 4090 que le modèle pouvait utiliser. Un plafond de 15,2 GiB tient lieu de carte de 16 GB, et 11,2 GiB d'une carte de 12 GB (un GiB est un gigaoctet un peu plus grand, environ 1,07 GB). Le code des auteurs n'a aucune option pour sortir des parties du modèle du GPU, donc le seul levier était la taille de l'entrée.
| Carte ou budget mémoire (les budgets sont des plafonds sur la 4090) | Entrée vers sortie | Résultat |
|---|---|---|
| RTX 3090 24 GB, vraie carte | 480p vers 1920p | 3,76 images/s |
| Budget de 16 GB | 480p vers 1920p | mémoire insuffisante |
| Budget de 16 GB | 360p vers 1440p | mémoire insuffisante |
| Budget de 16 GB | 270p vers 1080p | tient, même sortie que sans plafond |
| Budget de 12 GB | 270p vers 1080p | mémoire insuffisante |
Rien n'a tenu sous le plafond de 12 GB : le gros modèle prend à lui seul 9,6 GiB, ce qui laisse trop peu pour les images.
Ce que nous n'avons pas essayé : des formats numériques plus petits qui économisent de la mémoire, et des extraits de plus de 72 images. La 1440p a culminé à 15,5 GiB, au-dessus de notre plafond mais sous le total d'une carte de 16 GB, donc la question de savoir si elle tient sur une vraie carte reste ouverte.
Sur InferenceKey : prêt en 71 secondes, et le GPU n'est pas la partie lente
La carte est à vous à l'heure, et le modèle servait des requêtes 71,2 secondes après que nous l'avons demandé. Ces secondes couvrent la construction de l'environnement Python, le chargement de 10,2 GB de poids sur le GPU et un court extrait de chauffe, avec les poids déjà déposés sur le disque local de la machine. Sur la 3090, le même parcours a pris 165,8 secondes, ralenti par les téléchargements de cette machine. C'était une copie locale de notre stack, pas le service hébergé.
Rien d'intégré ne sert un agrandisseur vidéo, nous avons donc écrit un backend personnalisé. C'est un petit fichier Python qui indique à la plateforme comment charger le modèle et répondre aux requêtes. Il exécute une version figée du code des auteurs, avec leurs réglages. Vous envoyez l'extrait dans une requête d'API standard, et la réponse contient la vidéo 4x et ses temps.
Le problème que vous rencontrerez, c'est le temps CPU, pas le GPU. Un extrait de 72 images en 1920p a mis de 26 à 41 secondes entre la requête et la réponse, pour 8 à 10 secondes de travail GPU. Le reste, c'est la compression de 72 grandes images en MP4 sur le processeur. La réponse doit aussi tenir dans un seul message de 8 MB, donc un extrait en 1920p est compressé deux fois. En 1080p, il tient du premier coup, et l'aller-retour complet a pris de 6,4 à 7,2 secondes. Statut : ouvert. Cela vient du renvoi de la vidéo à l'intérieur de la réponse. Le README de l'exemple conseille d'envoyer les vidéos longues par morceaux de 2 à 3 secondes, et renvoyer plutôt un lien de téléchargement supprimerait la seconde passe.
Faut-il l'utiliser ? Une carte de 24 GB, l'intervalle par défaut, des extraits courts
- Agrandir du 480p en 1920p : une carte de 24 GB, une 4090 ou, à mi-vitesse, une 3090.
- Sortie 1080p à partir d'extraits basse résolution : un budget de 16 GB a suffi (émulé).
- Mouvements rapides et visages : gardez une image clé toutes les 15 images.
- Scènes lentes, quand la vitesse compte le plus : toutes les 31 images fait gagner environ un quart de vitesse.
- Un budget de 12 GB : rien n'a tenu sous notre plafond émulé.
- Audio : il n'est pas copié, remettez-le vous-même.
Pour agrandir votre propre extrait sur votre propre GPU, lancez python main.py my-clip.mp4 depuis l'exemple RelayVSR du SDK. Il faut une carte NVIDIA de 24 GB et environ 25 GB de disque, et il écrit les deux intervalles d'images clés dans outputs/.
Pour les ingénieurs
Crédits
- Xijun Wang, Xin Li, Zirui Lang, Suhang Yao, Haoran Li et Zhibo Chen (University of Science and Technology of China) : RelayVSR, l'article "RelayVSR: Large-Small Model Collaboration for Efficient Real-World Video Super-Resolution" (arXiv 2609.37850, soumis le 29 sept. 2026), les poids (Apache-2.0), le code avec
inference.pyetrefvsr_inference, et la page du projet. - Wan-AI : Wan2.2-TI2V-5B (Apache-2.0), la base du générateur de références.
- FlashVSR (OpenImagingLab, Zhuang et al., 2026) : une référence de comparaison dans l'article, remerciée dans le README des auteurs. L'article nomme le petit réseau un Dual-Memory Video Transformer conçu par les auteurs ; dans le code, sa classe est
FlashVSRConditionNet, décrite comme "FlashDecoder-style streaming VSR with configurable persistent conditions" (checkpointflash.safetensors). - Hugging Face Diffusers : diffusers (épinglé en 0.37.1), remercié par les auteurs.
- Blender Foundation : Tears of Steel (CC) Blender Foundation | mango.blender.org, CC BY 3.0, notre extrait de test.
- AI Search : là où nous l'avons repéré (AI NEWS, 2026-11-08, chapitre à 02:32).
- Notre part : le backend personnalisé, le déploiement via la plateforme, les temps, l'échelle de mémoire, les vérifications visuelles, l'exemple du SDK et la vidéo de démo.
Modèle et méthode
kopper/RelayVSR: sha751954dc8adf34aa1d636a39fc548b9089703c85, lastModified 2026-11-13T05:04:59Z, sans accès restreint, apache-2.0, modèle de baseWan-AI/Wan2.2-TI2V-5B. Fichiers :wan.safetensors10 066 399 024 B (générateur de références adapté de Wan2.2-TI2V-5B, embeddings de prompt inclus) etflash.safetensors127 759 784 B (le réseau VSR léger ; le réglage par défaut des auteurs est "S, step 60000, EMA").- Mécanisme, "Sparse Generative Relay" : le gros modèle produit des latents de référence uniquement pour des images clés espacées ; un "Dual-Memory Video Transformer" léger super-résout chaque image à partir de ces références et de la vidéo basse résolution.
- Dans le code,
CollaborativeFrameStream(refvsr_inference/runtime/streaming.py) exécute le générateur Wan une fois par extrémité (une étape au timestep 1000, guidance 1,0) sur la première et la dernière image de chaque fenêtre, avec des extrémités qui se chevauchent. Le petit réseau décode chaque image de la fenêtre conditionnée par les latents des deux extrémités (dual-endpoint), avec une fenêtre d'attention vidéo de deux images (l'image courante et une précédente). Un extrait de 72 images reçoit 6 références avec la fenêtre 16 et 4 avec la fenêtre 32. - Tableau 5 de l'article (les "32 millions de paramètres" du récit sont des paramètres entraînables) : Wan2.2-TI2V-5B avec une LoRA de rang 512 (1,32B de paramètres entraînables, LoRA plus projection LR). Petit réseau : 10 blocs transformer de largeur 512, fenêtre d'attention vidéo de 2 images (24 x 24 en spatial), 31,9M de paramètres entraînables.
- L'entraînement du gros modèle se termine par la Video-Aware Reference Optimization (VARO), une étape d'apprentissage par renforcement avec deux récompenses : une récompense au niveau du système sur la vidéo produite par le petit réseau figé, et une récompense au niveau des références sur la qualité des images clés décodées.
- Page de Wan2.2-TI2V-5B : VAE de compression 16 x 16 x 4, 720p à 24 fps, un seul GPU grand public comme une 4090 (au moins 24 GB avec les options d'offload).
- Options des auteurs :
--window-sizepar défaut 16 ("Reference interval + 1" ; elle compte les deux extrémités, donc les images clés tombent toutes les 15 images, et la fenêtre 32 en donne une toutes les 31 ; le README dit de l'augmenter "to let the small model process more intermediate frames"),--dtype bf16|fp16|fp32(bf16 par défaut),--max-frames,--fps,--seed 42,--start-frame,--cpu-threads 8. La sortie fait exactement 4x l'entrée, FPS conservés, audio non copié. Versions épinglées : torch 2.10.0 (extra cu128), diffusers 0.37.1, accelerate 1.15.0, triton 3.6, av. Python 3.11 à 3.13, Linux, GPU NVIDIA. Aucune option d'offload ni de mode faible VRAM.
Chiffres des auteurs (tableau 8 de l'article, 201 images, 4x, une A100 80 GB, intervalle 15 ; non reproduits par nous sauf mention contraire) :
| Sortie | Dual-endpoint fps / GB | First-keyframe fps |
|---|---|---|
| 720p | 58,32 / 11,92 | 68,59 |
| 1080p | 29,29 / 13,82 (première image 0,327 s) | 35,89 |
| 1440p | 17,59 / 16,47 | 21,44 |
| 2160p | 8,23 / 24,25 | 10,05 |
Références de comparaison en 1080p dans le même tableau (fps / GB) : SwiftVR 23,48 / 31,36, FlashVSR 7,80 / 24,45, Stream-DiffVSR 0,85 / 25,92, SeedVR2-3B 0,79 / 73,89, DOVE 0,56 / 41,08, SparkVSR 0,56 / 41,30, RealBasicVSR 18,50 / 24,81, RealViformer 14,87 / 12,36.
Tableau 9 (A100, dual-endpoint) par intervalle d'images clés 5 / 10 / 15 / 20 / 25 : 1080p 18,10 / 25,60 / 29,29 / 32,20 / 34,13 fps ; 2160p 4,91 / 7,12 / 8,23 / 9,17 / 9,69 fps.
Les deux agrandisseurs plus lourds cités dans le récit sont SeedVR2-3B et DOVE.
Tableau 11 (étude utilisateurs bon-égal-mauvais, une valeur positive favorise RelayVSR), qualité globale : +26,7 contre SwiftVR, -3,3 contre FlashVSR (quasi neutre), +46,8 contre SeedVR2, +53,6 contre DOVE. Face à DOVE, fidélité au contenu -8,9 et stabilité temporelle -8,7 : c'est DOVE qui est mieux noté sur ces deux critères.
Installation et pourquoi
- GPU : une RTX 4090 24 GB sur notre cloud (InferenceKey Cloud) pour l'exécution principale et l'échelle de mémoire (24 564 MiB, 450 W). Puis une vraie RTX 3090 24 GB sur notre cloud (24 576 MiB, 350 W) comme seconde carte grand public. Les deux sont les variantes standard de 24 GB. Une carte de 16 GB était visée pour un troisième échelon, mais chaque option de 16 GB essayée a renvoyé "no stock" (RTX 4080 SUPER, RTX 4080, RTX 5080, RTX 2000 Ada, RTX A4000, V100 16 GB), et les RTX 4000 Ada et RTX A4500 de 20 GB ont renvoyé la même chose.
- Backend : un nouveau backend Python personnalisé,
relayvsr-video-upscale0.1.0 (RelayVSRBackend), CPython 3.12.setup()récupère l'archive des sources des auteurs au commite856773350f53036d825404c9ea9228e6dffadca(seulementrefvsr_inference/, l'extrait de démo et LICENSE), télécharge les deux checkpoints à la révision épinglée, construitload_checkpoints+WanVSRPipelineexactement commeinference.py, et lance une chauffe de 17 images en 128 x 224.process()décode l'extrait, le fait passer en streaming dansCollaborativeFrameStream, additionne les tempsDeviceSpandes auteurs par étape, encode en H.264 à CRF 18 et augmente le CRF (18, 22, 26, 30, 34) jusqu'à ce que le base64 tienne dans 7,5 MB. Pourquoi un backend personnalisé : aucun backend intégré ne sert un modèle vidéo en entrée, vidéo en sortie. Pourquoi le code des auteurs : leurs chiffres sont mesurés dessus, et c'est le seul chemin qui fait tourner les deux modèles ensemble. - Transport : le SDK n'a pas de type de tâche vidéo pour les backends personnalisés, donc le paquet et le workload sont étiquetés
text2imageet la vidéo voyage en JSON base64 sur la route de chat (/v1/chat/completions). - Stack : un manager InferenceKey local, nats-proxy et un worker compilés depuis main. La production n'a jamais été touchée.
- Poids sur le worker : pré-téléchargés sur le disque local du worker (8,6 s sur la machine de la 4090, 83,5 s sur celle de la 3090) pendant que le worker construisait le venv.
Pas à pas avec l'exemple du SDK
L'exemple correspond au commit c06208ce sur la branche main de inferencekey-sdk : backend.py, publish.py, main.py, requirements.txt, README.md, .env.example.
Il vous faut un token SDK (ik_sdk_), une clé d'API (ik_live_), le slug du projet, l'id d'un worker NVIDIA privé assigné au projet (IK_WORKER_ID), ainsi que votre id de tenant et un token de session du tableau de bord pour publish.py et pour activer la route de chat (ou faites les deux dans le tableau de bord). Le worker a besoin d'environ 25 GB de disque (venv d'environ 7 GB, poids de 10,2 GB) et de gcc (Triton et FlexAttention compilent des kernels à la première utilisation).
Le SDK n'est pas encore sur PyPI, donc le client utilise la version compilée localement dans le dépôt (examples/CONTRIBUTING.md, section 4). Dans .env.example, INFERENCEKEY_TENANT_ID et INFERENCEKEY_USER_TOKEN sont commentés : décommentez-les et renseignez-les pour publish.py et la route de chat, ou faites les deux étapes dans le tableau de bord.
git clone https://github.com/inferencekey/inferencekey-sdk.git
cd inferencekey-sdk/examples/relayvsr-video-upscale-custom-backend-private-nvidia
python -m venv .venv && . .venv/bin/activate
pip install maturin requests
( cd ../../bindings/python && maturin develop --release )   # local SDK build into this venv
cp .env.example .env         # INFERENCEKEY_SDK_TOKEN, INFERENCEKEY_API_KEY,
                             # INFERENCEKEY_PROJECT, IK_WORKER_ID, and uncomment
                             # INFERENCEKEY_TENANT_ID, INFERENCEKEY_USER_TOKEN
python publish.py            # once: packages backend.py and uploads it to your tenant
python main.py my-clip.mp4   # or no argument: the authors' 360p demo clip
main.py appelle ensure() pour un workload fixe sur IK_WORKER_ID (ready_timeout_secs 2400, request_timeout_secs 900), active l'endpoint de chat, attend avec wait_until_ready(2400), agrandit l'extrait avec la fenêtre 16 et la fenêtre 32 et écrit outputs/x4-w16.mp4 et outputs/x4-w32.mp4. Il supprime le workload en sortant, sauf si IK_KEEP_ALIVE=1. RVSR_CLIP_FRAMES (72 par défaut) fixe le nombre d'images par appel.
Une requête est du JSON dans le dernier message utilisateur :
{"video_b64": "<base64 MP4, up to 5 MB>", "window_size": 16, "max_frames": 72, "seed": 42}
video_url (https) ou "demo": true fonctionnent à la place de video_b64. window_size doit être entre 2 et 64. Images d'entrée jusqu'à 960 x 544 (RVSR_MAX_PIXELS), jusqu'à 241 images (RVSR_MAX_FRAMES). Le contenu du message de réponse est du JSON : video_b64 (H.264, sans audio), width, height, frames, fps, keyframes, crf et timings (model_fps, wan_ms, flash_ms, first_frame_ms, wall_s, peak_vram_mib). L'endpoint est POST /endpoint/<project>/relayvsr/v1/chat/completions.
Réglages du backend, passés par l'env du workload : RVSR_VRAM_LIMIT_GIB (plafonne la mémoire GPU du backend avec torch.cuda.set_per_process_memory_fraction), RVSR_DTYPE, RVSR_MAX_FRAMES, RVSR_MAX_PIXELS, RVSR_OUTPUT_DIR (garde une copie en CRF 18 sur le worker) et RVSR_WARMUP.
Mesures complètes
Temps jusqu'à prêt :
- RTX 4090 : "ready after 71.2 s" d'après le SDK. Log du backend :
download 20.1s, load 8.4s, warmup 4.2s, weights in VRAM 9.62 GiB. - RTX 3090 : "ready after 165.8 s" (venv d'environ 2 min sur cet hôte).
Via l'endpoint, appels à chaud, seed 42. Model fps = images / temps modèle (temps GPU des deux modèles, la mesure des auteurs). Aller-retour depuis le client HTTP jusqu'au manager local.
| Carte | Entrée vers sortie | Fenêtre | Images | Réf. | Modèle s | Model fps | Wan ms | Petit réseau ms | Première image ms | Pic MiB | Aller-retour s |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 4090 | 854x480 vers 3416x1920 | 16 | 72 | 6 | 9,82 / 9,84 | 7,33 / 7,31 | 4 842 | 4 747 | 1 565 | 20 880 | 41,2 / 40,3 |
| 4090 | 854x480 vers 3416x1920 | 32 | 72 | 4 | 7,91 | 9,10 | 3 104 | 4 630 | 1 571 | 20 880 | 25,7 |
| 4090 | 480x270 vers 1920x1080 | 16 | 72 | 6 | 3,02 (8,11 au premier) | 23,85 | 1 404 | 1 528 | 472 | 13 364 | 7,2 |
| 4090 | 480x270 vers 1920x1080 | 32 | 72 | 4 | 2,47 | 29,1 | 902 | 1 502 | 477 | 13 364 | 6,4 |
| 4090 | 624x360 vers 2496x1440 | 16 | 48 | 5 | 3,91 (9,28 au premier) | 12,27 | 2 108 | 1 693 | 822 | 15 887 | 10,0 |
| 4090 | 624x360 vers 2496x1440 | 32 | 48 | 3 | 2,94 | 16,31 | 1 242 | 1 630 | 888 | 15 801 | 9,4 |
| 3090 | 854x480 vers 3416x1920 | 16 | 72 | 6 | 19,16 | 3,76 | 8 674 | 10 001 | 2 862 | 20 880 | 41,6 |
| 3090 | 854x480 vers 3416x1920 | 32 | 72 | 4 | 15,74 | 4,58 | 5 575 | 9 810 | 2 832 | 20 880 | 38,0 |
| 3090 | 480x270 vers 1920x1080 | 16 | 72 | 6 | 6,74 (14,81 au premier) | 10,69 | 2 996 | 3 528 | 998 | 13 364 | 13,5 |
| 3090 | 624x360 vers 2496x1440 | 16 | 48 | 5 | 8,15 (16,77 au premier) | 5,89 | 4 134 | 3 781 | 1 719 | 15 887 | 18,5 |
- Pic de mémoire réservée : 21 408 MiB (1920p), 16 112 MiB (1440p), 13 520 MiB (1080p). Pic de la carte dans nvidia-smi (échantillonnage à 1 s) : 21 900 MiB sur la 4090, 21 750 MiB sur la 3090.
- Premier appel à une nouvelle taille d'image (Triton et FlexAttention compilent pour cette géométrie), 4090 : 4,71 contre 7,33 fps en 1920p, 8,88 contre 23,85 fps en 1080p. 3090 : 2,59 fps en 1920p au premier appel.
- Où passe l'aller-retour en 1920p (4090, fenêtre 16) : décodage 2,1 s, boucle de streaming avec encodage H.264 CRF 18 sur CPU 15,0 s (dont 9,8 s de modèle), réencodage en CRF 22 22,0 s parce que le fichier en CRF 18 dépassait la limite de 7,5 MB en base64 ; temps total du backend 40,1 s. Les extraits en 1920p sont revenus en CRF 22, environ 4,9 MB.
- 1080p face aux auteurs : 23,85 fps (fenêtre 16) sur la 4090 contre leurs 29,29 fps sur une A100 80 GB ; la fenêtre 32 donne 29,1 sur la 4090. Leur pic en 1080p est de 13,82 GB, le nôtre de 13 364 MiB (14,0 GB).
Échelle de VRAM. Les échelons émulés ont tourné sur la 4090 après suppression du workload, dans le venv du backend, un processus par échelon, RVSR_VRAM_LIMIT_GIB relié à torch.cuda.set_per_process_memory_fraction, mêmes extraits, seed 42.
| GPU ou plafond | Configuration | Pic de VRAM | Vitesse | Sortie | Réel ou émulé |
|---|---|---|---|---|---|
| RTX 4090 24 GB | bf16, 480p en entrée, 3416x1920 en sortie, fenêtre 16, via la plateforme | 20 880 MiB (carte 21 900) | 7,33 fps (9,82 s pour 72 images) | ok, référence | réel |
| RTX 3090 24 GB | pareil, via la plateforme | 20 880 MiB (carte 21 750) | 3,76 fps (19,16 s pour 72 images) | ok | réel |
| Plafond de 15,2 GiB (carte de 16 GB) | 480p en entrée, 1920p en sortie, fenêtre 16 | OutOfMemoryError: CUDA out of memory. Tried to allocate 38.00 MiB ... 15.20 GiB allowed | émulé | ||
| Plafond de 15,2 GiB | 360p en entrée (extrait des auteurs), 1440p en sortie, fenêtre 16 | Tried to allocate 96.00 MiB ... 15.20 GiB allowed | émulé | ||
| Plafond de 15,2 GiB | 270p en entrée, 1080p en sortie, fenêtre 16 / 32 | 13 355 MiB (réservé 15 518) | 23,91 / 29,58 fps | ok, identique octet pour octet à l'exécution sans plafond (PSNR ffmpeg inf) | émulé |
| Plafond de 11,2 GiB (carte de 12 GB) | 270p en entrée, 1080p en sortie, fenêtre 16 / 32 | Tried to allocate 56.00 MiB ... 11.20 GiB allowed (poids du générateur seuls 9,62 GiB) | émulé |
Non essayé : une vraie carte de 16 GB ou de 12 GB (pas de stock), 12 GB avec un quelconque offload (le code n'en a pas), fp8 ou int8, le mode first-keyframe, des extraits de plus de 72 images. Une vraie carte de 16 GB ajoute un surcoût de pilote et de contexte que le plafond ne modélise pas, donc l'échelon de 16 GB est un budget, pas une carte.
Extraits de test et notes de qualité (inspection visuelle, une seule seed, pas un benchmark)
- Chaque chiffre du récit est un appel à chaud (après un extrait de chauffe à cette taille d'image) avec la seed 42.
- Extraits : (a) 3 s de Tears of Steel à partir de 00:02:09, recadrés en 950 x 534, réduits en 854 x 480, x264 CRF 28, 72 images à 24 fps ; (b) le même extrait en 480 x 270 ; (c) la démo des auteurs
assets/demo/input.mp4(624 x 360, 16 fps), 48 premières images. - 480p vers 1920p, fenêtre 16 : visage, barbe, mèches de cheveux et veste à carreaux nettement plus nets que le bicubique 4x ; la balustrade en pierre gagne de la texture. Aucun artefact évident sur les images vérifiées (36, 38, 47).
- Fenêtre 32 contre 16 à l'image 47 (référence de la fenêtre 16 à 45, références de la fenêtre 32 à 31 et 62) : la fenêtre 32 est visiblement floue sur le visage pendant le mouvement de tête. Image 38, à 7 images d'une référence dans les deux cas : pareilles.
- Aucune métrique de qualité quantitative de notre part, pas d'audio. Nous avons vérifié des images fixes, pas le scintillement aux frontières des images clés en mouvement, et le bicubique était la seule comparaison (ni Real-ESRGAN ni RealBasicVSR sur la même carte).
- Unités : les chiffres de mémoire sont en MiB ou GiB (1 GiB vaut environ 1,07 GB) ; le pic de 20,4 GiB correspond à 20 880 MiB, environ 21,9 GB.
Sortie complète de RelayVSR, 3416 x 1920, fenêtre 16, 72 images, CRF 22 telle que renvoyée par l'endpoint :
Vidéo de démo
Une présentation commentée de 3 minutes (188,5 s) : ce qu'est RelayVSR, avec les exemples et les figures des auteurs crédités ; le panneau qui le sert sur la RTX 4090 ; nos chiffres de vitesse, la comparaison clé et l'échelle de mémoire.
Problèmes restants
- Aller-retour dominé par l'encodage CPU : de 26 à 41 s pour un extrait de 72 images en 1920p contre 8 à 10 s de temps GPU, dont un second encodage en CRF 22 pour tenir dans le message de 8 MB. Statut : ouvert, une limite de conception liée au renvoi de la vidéo dans la réponse ; une URL de sortie dans un object store éviterait le réencodage. Envoyez les vidéos longues par morceaux de 2 à 3 secondes.
- Pas de type de tâche vidéo pour les backends personnalisés : le backend est étiqueté
text2imageet la vidéo passe par la route de chat en JSON base64. Statut : ouvert dans le SDK, documenté dans l'exemple. - Object store local partagé plein : la publication du backend sur le MinIO partagé de notre VM de dev a renvoyé
put custom backend to S3 ... (XMinioStorageFull)parce que le disque racine de la VM était à 100 %. Statut : contourné pour le test avec un MinIO privé sur/dev/shm; le disque de la VM de dev demande encore de l'attention. Cela n'affecte pas le service hébergé. - Enregistreur de démo : le
Page.gotovers/loginde l'enregistreur du panneau a expiré trois fois (Timeout 30000ms exceeded). Statut : corrigé avec unstart_urlde storyboard àabout:blank. - Mineur : le worker a journalisé
NATS connection establisheddeux fois au démarrage, sans conséquence.
Sources
- Page du modèle
- Code (commit
e856773350f53036d825404c9ea9228e6dffadca) - Article, arXiv 2609.37850
- Page du projet
- Modèle de base, Wan2.2-TI2V-5B
- FlashVSR, une référence de comparaison dans l'article, remerciée par les auteurs
- Là où nous l'avons repéré, AI Search
- Exemple du SDK