Avec deux agents par utilisateur intensif, une machine 4x B200 absorbe la charge Claude Code d'environ 200 abonnements pour environ 30 % de moins
DeepInfer et le cache inferencekey sur 4x B200 : 100 agents à 450K tokens, la moitié des réponses en 2,5 s, 0 erreur, 30 % de moins que les abonnements.
Une seule machine peut-elle faire le travail Claude Code de 200 abonnements ? Nous avons mesuré 100 agents. Les 200 sont modélisés à partir de ces essais. Un serveur équipé de quatre cartes graphiques NVIDIA B200 dans le cloud inferencekey a fait tourner DeepSeek V4.1 Flash sur DeepInfer, le moteur que DeepSeek a publié en open source en octobre. Nous avons ajouté la pièce avec laquelle le moteur n'est pas livré : un cache. Cent agents synthétiques, dimensionnés comme de vraies sessions Claude Code, ont travaillé en même temps, chacun portant près d'un demi-million de tokens de conversation. La moitié de leurs réponses a démarré en 2,5 secondes environ, et pas une seule requête n'a échoué. Un simulateur calibré sur ces essais situe la machine à environ 400 agents simultanés. Si vos utilisateurs intensifs font tourner deux agents chacun, cela représente la charge d'environ 200 abonnements, pour environ 30 % de moins.
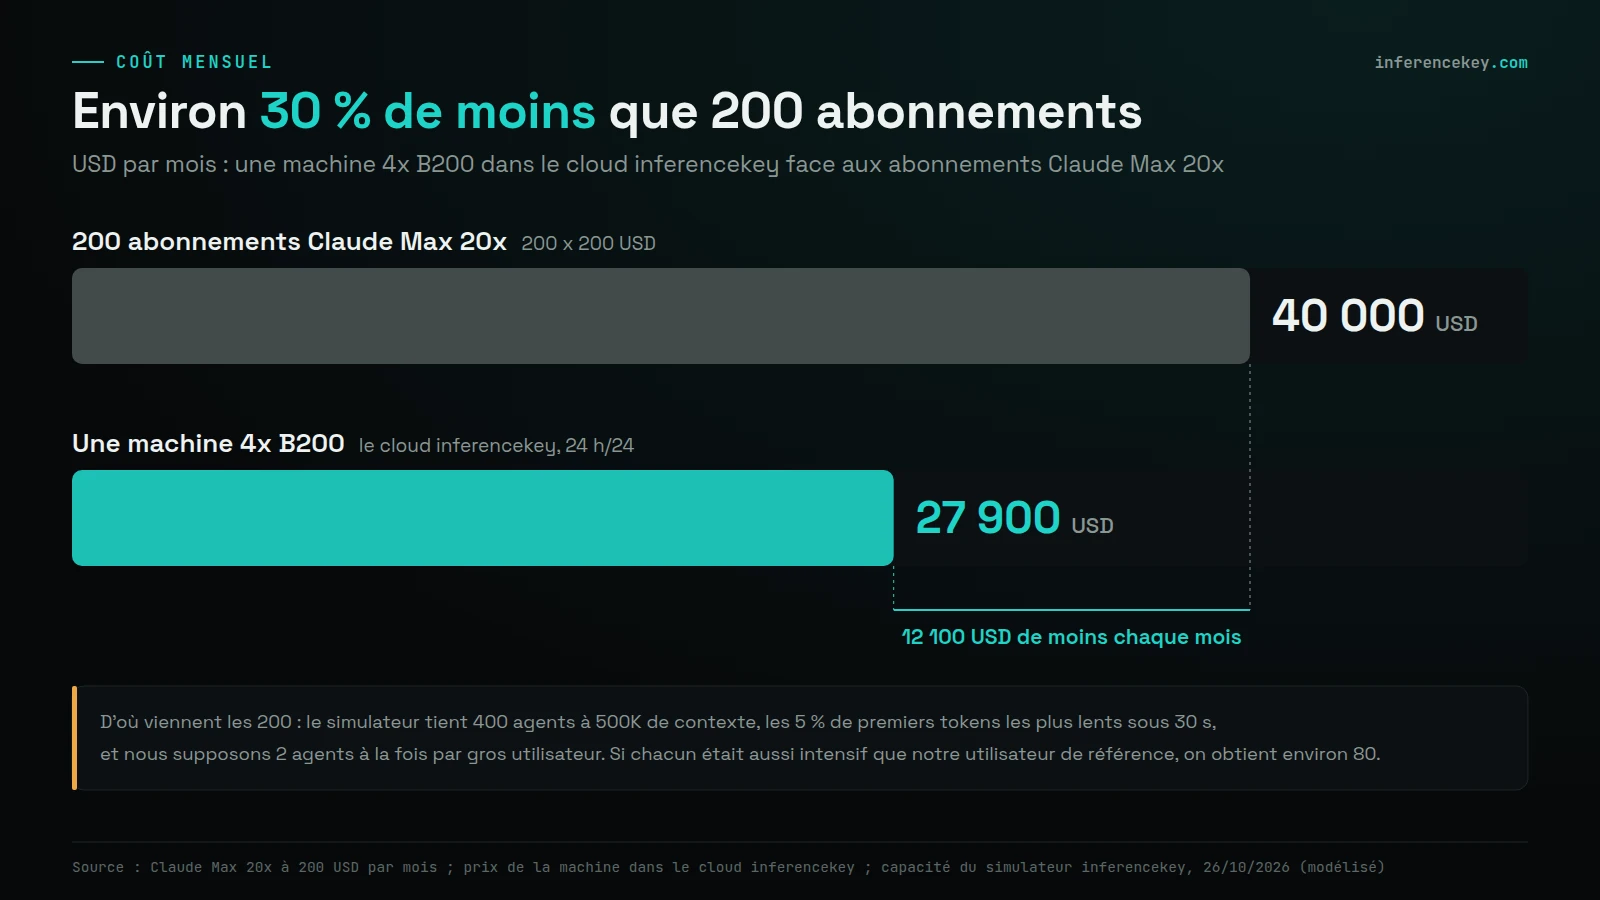
Les 200 abonnements supposent 2 agents simultanés par utilisateur intensif (400 agents, modélisé). Si chaque utilisateur était aussi intensif que notre utilisateur de référence, le simulateur donne environ 80.
| 200 abonnements Claude Max 20x | 40 000 USD par mois |
| Une machine 4x B200 dans le cloud inferencekey | 27 900 USD par mois, environ 30 % de moins |
| Seuil de rentabilité face à Claude Max 20x | environ 140 abonnements |
| Mesuré : 100 agents à environ 450K tokens chacun | la moitié des réponses démarre en 2,55 s, 0 erreur |
| Mesuré : tokens lus par seconde avec le cache | environ 1,8 million, dont 96 % depuis le cache |
| Mesuré : 397 nouvelles conversations de 440K, rien en cache, lancées 16 par 16 | 176 millions de tokens lus en moins de 15 minutes, 0 erreur |
| Modélisé : agents simultanés, les 5 % les plus lents démarrant en 30 s | environ 400 |
| Prix par million de tokens lus | environ 0,006 USD, environ 80 fois moins que l'API Claude |
| Modifications nécessaires dans Claude Code | aucune, quelques variables d'environnement (endpoint, clé, nom du modèle) |
Un agent de code relit surtout, et le cache rend la relecture presque gratuite
Chaque fois que Claude Code fait une étape (ouvrir un fichier, lancer un test, modifier une ligne), il renvoie au modèle toute la conversation. Dans nos tests, cette conversation faisait environ 450 000 tokens, à peu près un livre de 1 300 pages. Le modèle écrit quelques centaines de tokens de réponse et, à l'étape suivante, l'agent renvoie le livre entier, plus une nouvelle page.
Dans notre dernier article de recherche, nous avons mesuré un développeur très intensif pendant un mois et trouvé la même chose : 96,8 % de ce que lisait son agent avait déjà été lu. Imaginez une étagère à côté du modèle. Ce qu'il a lu une fois reste sur l'étagère, et la fois suivante il le reprend tout prêt au lieu de le relire.
DeepInfer est livré sans cette étagère. La page du projet chez DeepSeek range le cache parmi les pièces à construire soi-même. Sans lui, notre machine lisait moins d'un demi-livre par seconde, chaque conversation depuis zéro. Avec le cache inferencekey, elle lisait quatre livres par seconde. La facture des agents de code est surtout une facture de relecture, et celui qui tient l'étagère fixe le prix.
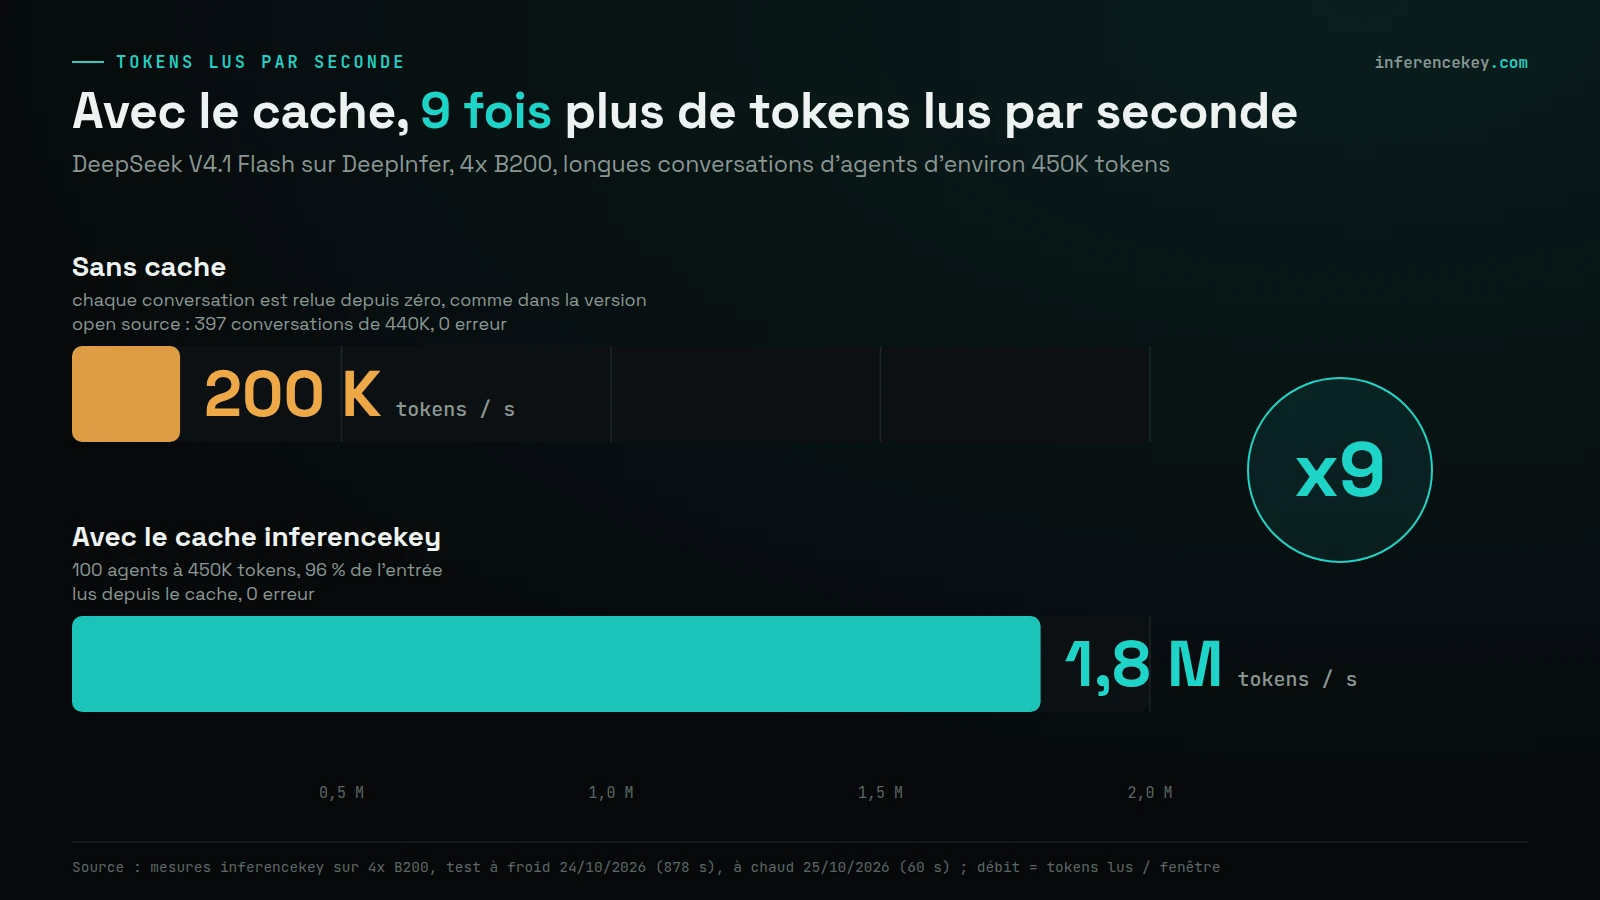
Même machine, même modèle : le cache transforme environ 200 K tokens lus par seconde en environ 1,8 M.
Claude Code n'a besoin que de quelques variables d'environnement, et a terminé une vraie tâche en 39 secondes
Quelques variables d'environnement indiquent à Claude Code où envoyer ses requêtes, quelle clé utiliser et quel modèle demander. Pointez-les vers votre endpoint inferencekey et il parle à DeepSeek V4.1 Flash au lieu d'Anthropic, avec les mêmes commandes et les mêmes outils.
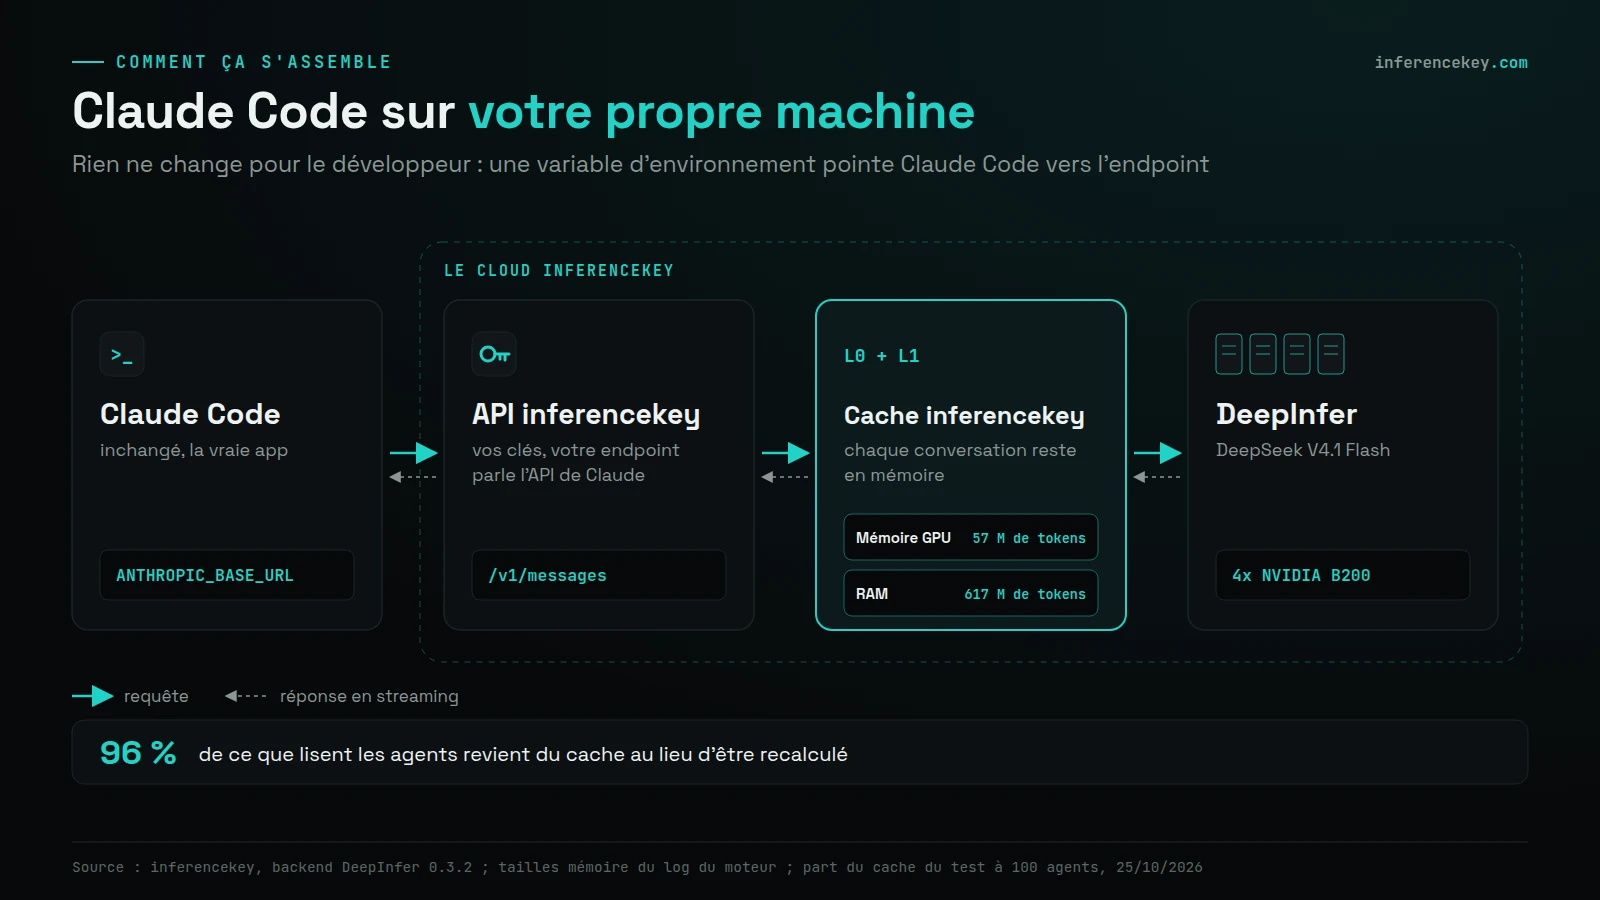
Des variables d'environnement pointent Claude Code vers votre endpoint. Le cache inferencekey garde chaque conversation en mémoire GPU et en RAM.
L'étagère a deux niveaux. Le rapide se trouve dans la mémoire même des cartes graphiques et contient environ 57 millions de tokens, à peu près 120 conversations de notre taille. Derrière se trouve un second niveau dans la mémoire ordinaire du serveur, environ dix fois plus grand avec 617 millions de tokens, pour les conversations qui se sont mises en pause un instant.
Le 24 octobre, Claude Code 2.1.310 configuré ainsi a terminé une petite tâche réelle en 39 secondes. Il s'agissait d'implémenter une fonction appelée parse_duration pour qu'un fichier de 15 tests passe. L'agent a fait 14 appels d'outils (lire des fichiers, lancer les tests, modifier le code) et les 15 tests sont passés.
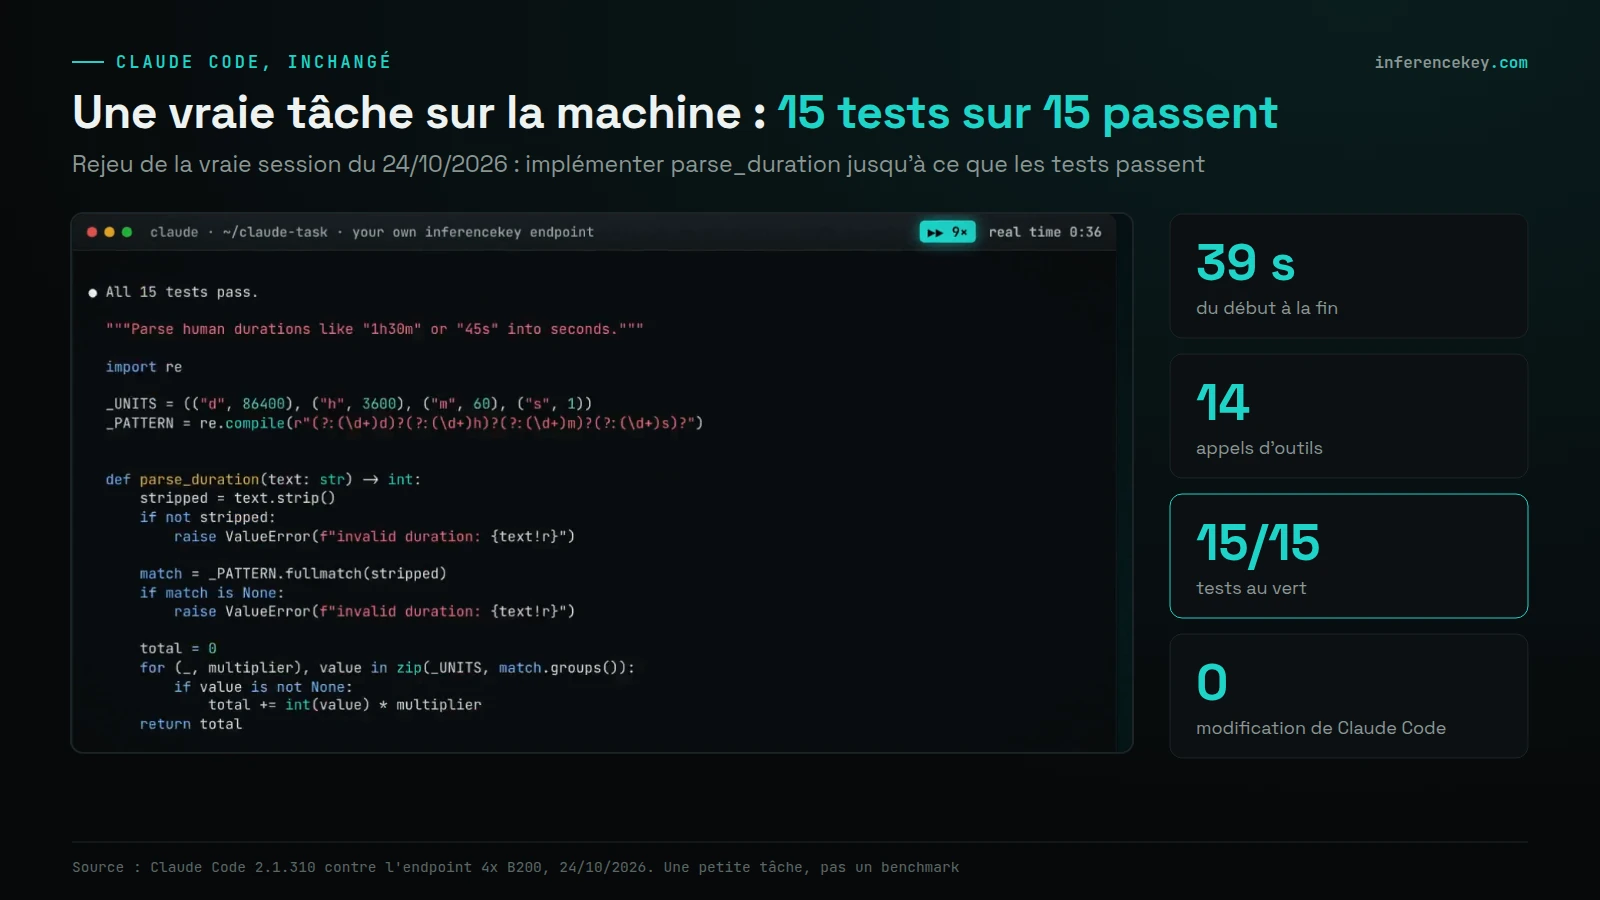
Claude Code 2.1.310, inchangé, sur notre endpoint : une vraie tâche faite en 39 s avec 14 appels d'outils et 15 tests sur 15 au vert. Une petite tâche, pas un benchmark.
La scène de la vidéo ci-dessus montre la vraie application refaisant cette tâche, en rejouant les réponses du modèle enregistrées ce jour-là pendant que les outils s'exécutent réellement.
Le mérite est partagé. L'équipe de DeepSeek a entraîné DeepSeek V4.1 Flash, écrit DeepInfer et l'a publié sous licence Apache 2.0. L'outil aiperf de NVIDIA a testé notre simulateur en charge. Claude Code d'Anthropic tournait par-dessus. Notre part, c'est le cache, l'adaptateur qui permet à inferencekey de faire tourner DeepInfer, l'API qui parle la langue de Claude Code avec vos propres clés, et les mesures.
100 agents à un demi-million de tokens chacun : la moitié des réponses démarre en 2,5 secondes, zéro erreur
Avec 100 agents simultanés, chacun avec environ 450 000 tokens déjà sur l'étagère, la moitié des réponses a démarré en 2,55 secondes et aucune n'a échoué. C'est la taille d'une longue session Claude Code en fin de journée. Nous l'avons lancé le 25 octobre et, sur une fenêtre d'une minute, la machine a traité 237 tours d'agent. La réponse de chaque agent arrivait à environ 135 tokens par seconde, une page en quelques secondes.
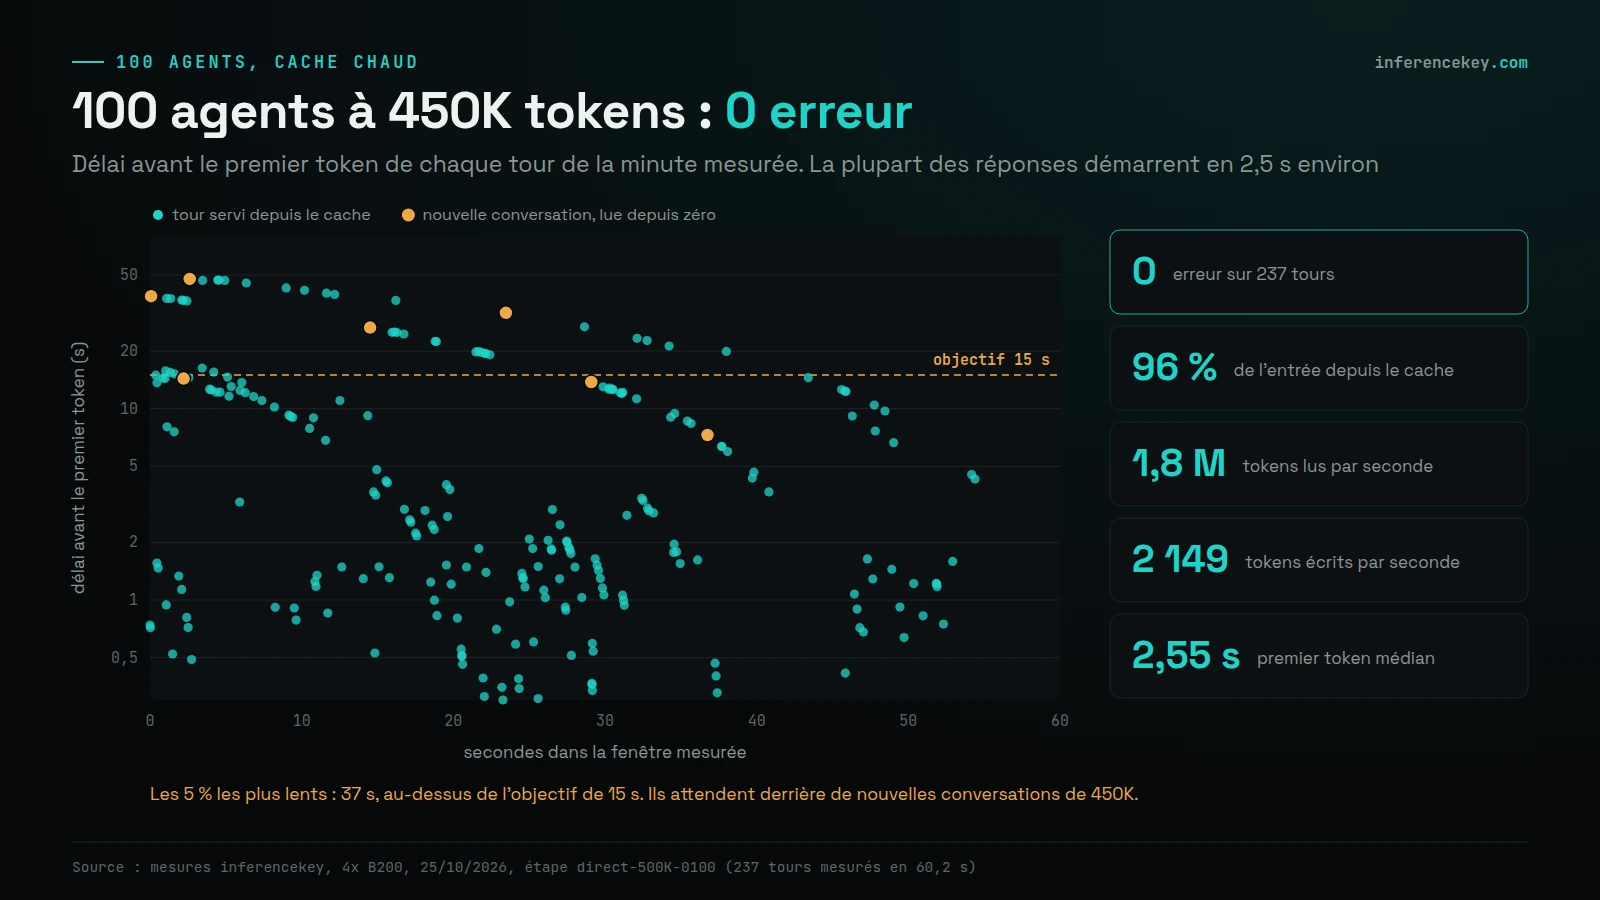
100 agents, cache chaud : 0 erreur et des réponses qui démarrent en 2,5 s environ. Les 5 % les plus lents attendent derrière de nouvelles conversations de 450K et manquent l'objectif de 15 s.
Passons à ce qui n'a pas réussi. Notre barre est stricte : 95 % des tours doivent commencer à répondre en 15 secondes. Seuls 2 de nos 8 essais l'ont franchie. Les 8 ont eu zéro erreur. Dans cet essai, 83 % des tours dont la conversation était déjà sur l'étagère ont démarré en 15 secondes. Les 5 % les plus lents ont attendu 37 secondes ou plus, donc l'essai a échoué. Sept conversations toutes neuves sont arrivées pendant cette minute, et chacune devait lire ses 450 000 tokens depuis zéro. Les tours en attente ont fait la queue derrière elles, comme un groupe qui attend que le précédent remballe tout son matériel. Donner la priorité aux tours déjà sur l'étagère, ou limiter le nombre de nouvelles conversations qui démarrent en même temps, aiderait probablement. Nous ne l'avons pas testé.
Test de stress à froid : 176 millions de tokens lus depuis zéro en moins de 15 minutes, zéro erreur
L'étagère vide, la machine a lu des conversations depuis zéro à un rythme régulier de 200 000 tokens par seconde sans une seule erreur. Le 24 octobre, nous lui avons donné 399 nouvelles conversations d'environ 440 000 tokens chacune, 16 à la fois, avec un cache vide. C'est plus dur que n'importe quel vrai matin, où les sessions commencent petites.
En 14,6 minutes, 397 d'entre elles étaient lues en entier et répondaient : 176 millions de tokens. Compté à partir de l'admission de chacune, la première réponse prenait environ 14 secondes (médiane). Compté depuis le début du test, la moitié a attendu plus de six minutes et la dernière près de 15. Les deux dernières étaient encore dans la file quand notre limite de 15 minutes a expiré. Si toute une équipe arrivait en même temps avec des conversations géantes, le problème serait la file d'attente, pas les erreurs.
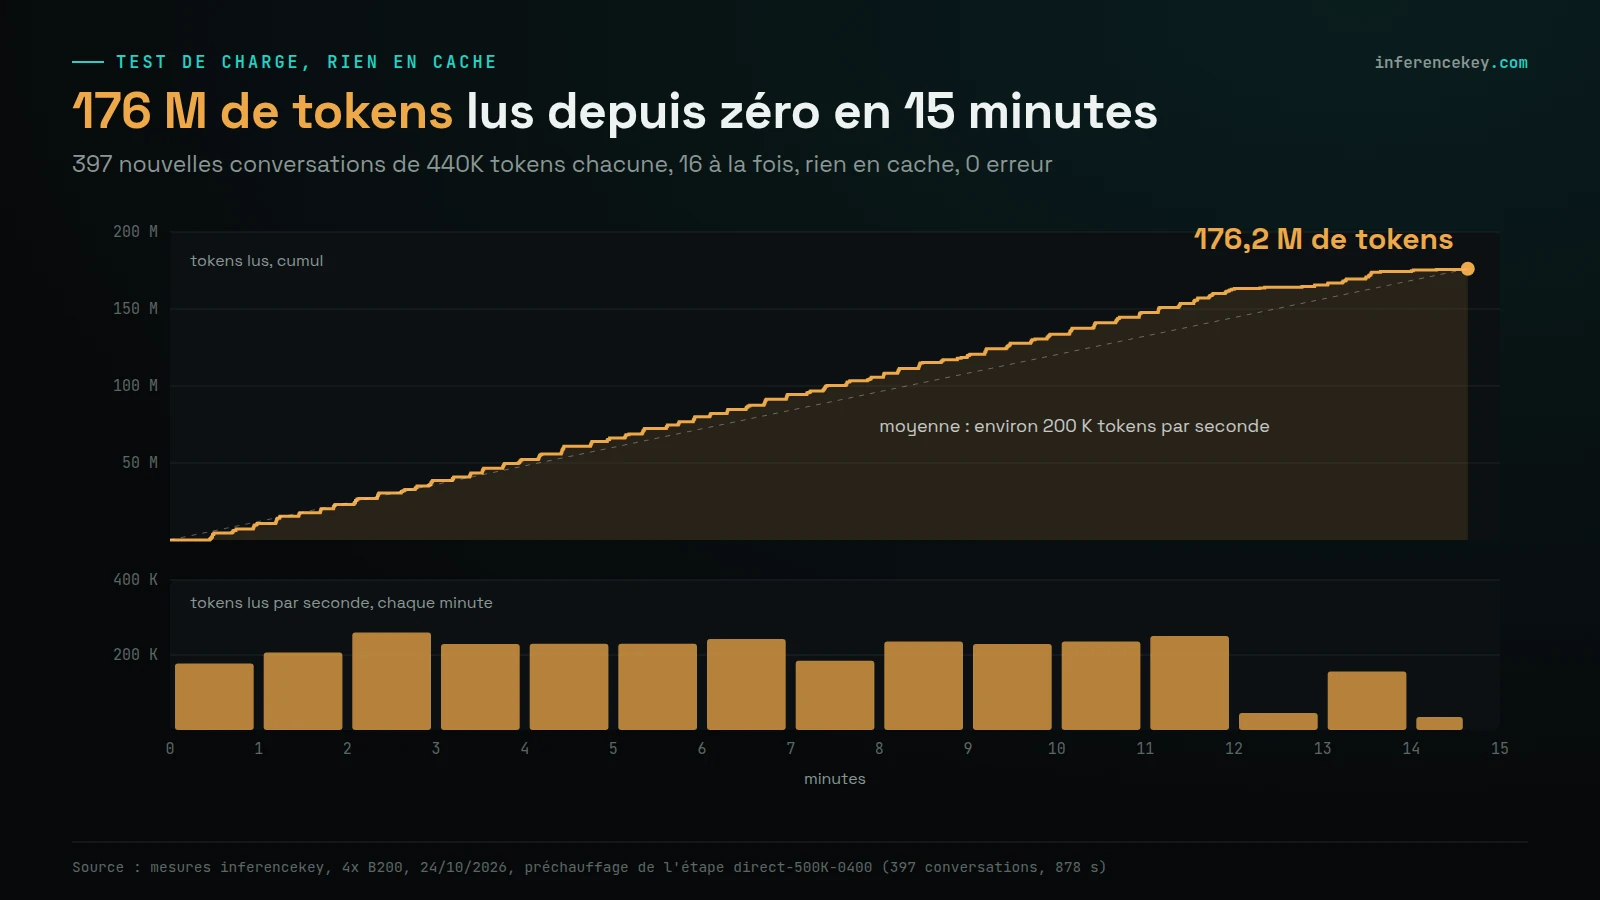
Test de stress sans rien en cache : 397 conversations de 440K tokens, 176 M de tokens lus depuis zéro en moins de 15 minutes, 0 erreur.
Au quotidien, environ 400 agents tiennent, selon un simulateur construit sur 7 879 tours réels
Tout ce qui précède est mesuré. Cette section est modélisée, et la différence compte.
Environ 250 agents tiennent si 95 % des réponses doivent démarrer en 15 secondes, environ 400 si 30 secondes suffisent. À 400, une réponse typique met environ 21 secondes à démarrer, et 1 sur 20 attend environ 30 secondes ou plus.
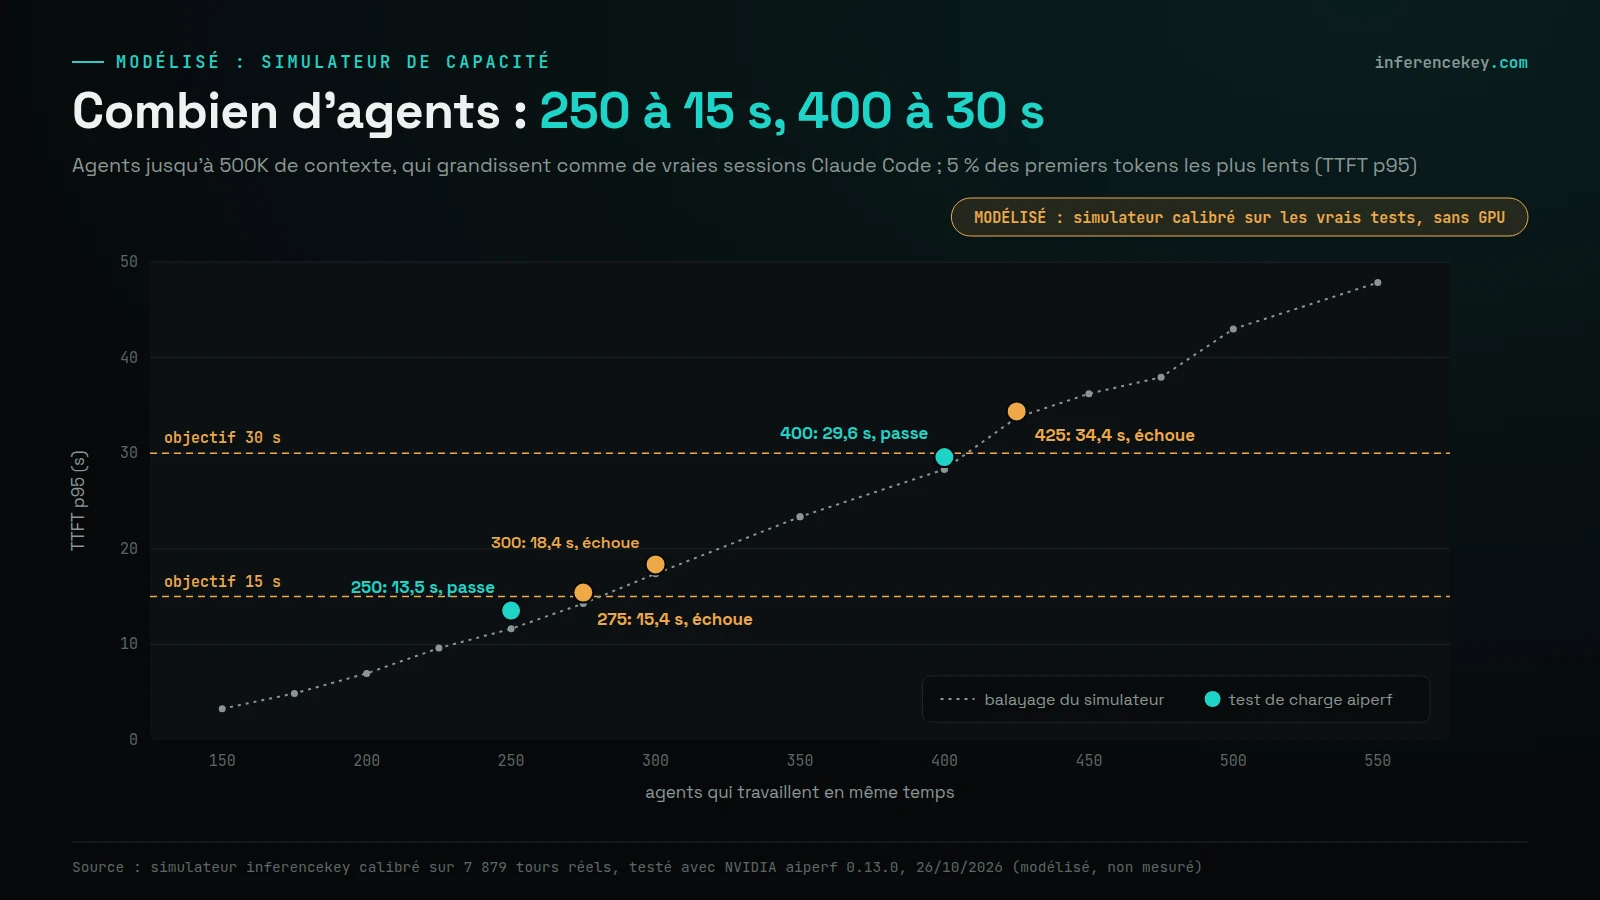
Modélisé : un simulateur calibré sur 7 879 tours réels accepte 250 agents si 95 % des réponses démarrent en 15 s, et 400 en 30 s.
Nos tests mesurés étaient volontairement durs : chaque agent ne faisait que trois secondes de pause entre deux étapes. Les vraies sessions sont plus calmes, alors nous avons construit un simulateur de cette machine. Nous l'avons calibré sur chaque tour des deux campagnes de test jusqu'à ce qu'il reproduise ce qu'a fait la vraie machine, y compris son point de rupture. Puis nous l'avons alimenté avec 30 jours d'usage de Claude Code de notre utilisateur de référence : 140 300 appels au modèle, avec leurs vraies pauses.
La machine ne fait pas plus de travail à 400 qu'à 250. Elle répond à environ 450 appels au modèle par minute dans les deux cas. Avec plus d'agents, chacun attend simplement plus longtemps et appelle moins souvent, toutes les 52 secondes au lieu de toutes les 34.
200 abonnements si les utilisateurs intensifs font tourner deux agents chacun, et en dessous d'environ 140 la machine coûte plus cher
Les 200 du titre reposent sur une hypothèse : un utilisateur intensif fait tourner deux agents en même temps, toute la journée. Les 400 agents du simulateur divisés par deux donnent environ 200 abonnements.
Le hic, c'est la vitesse. Sur Claude, les agents de notre utilisateur de référence appellent le modèle toutes les 27 secondes en moyenne. À 400 agents sur cette machine, chacun appelle toutes les 52 secondes. Une tâche prendrait presque deux fois plus de temps.
Il existe une façon plus stricte de compter. Notre utilisateur de référence est l'un de nos utilisateurs très intensifs. Pendant une heure de pointe moyenne, il appelle le modèle environ toutes les 11 secondes. À 450 appels par minute, la machine garde environ 80 personnes comme lui à pleine vitesse. La machine ne coûte moins cher que les abonnements Claude Max 20x qu'au-delà d'environ 140 abonnements. Au compte strict de 80, elle coûte 27 900 USD par mois contre 16 000 en abonnements, environ 75 % de plus.
Notre utilisateur de référence n'est cependant pas typique. En plus de ses propres sessions, il fait tourner des agents autonomes pour des workflows et des tâches métier, donc un utilisateur ordinaire de Claude Max charge moins la machine. Les logs Claude Code de votre équipe peuvent vous dire où vous vous situez.
Environ 0,006 USD par million de tokens, 80 fois moins que l'API Claude
L'autre comparaison est l'API. Le vrai mois de Claude Code de notre utilisateur de référence, au tarif public de l'API Claude, est revenu à 12 365 USD pour 26,2 milliards de tokens, soit 0,47 USD par million. La machine revient environ 80 fois moins cher par token lu. Cela repose sur les 1,8 million de tokens par seconde d'une minute chargée de notre test le plus dur, étirés sur les 730 heures d'un mois, donc considérez-le comme le meilleur cas.
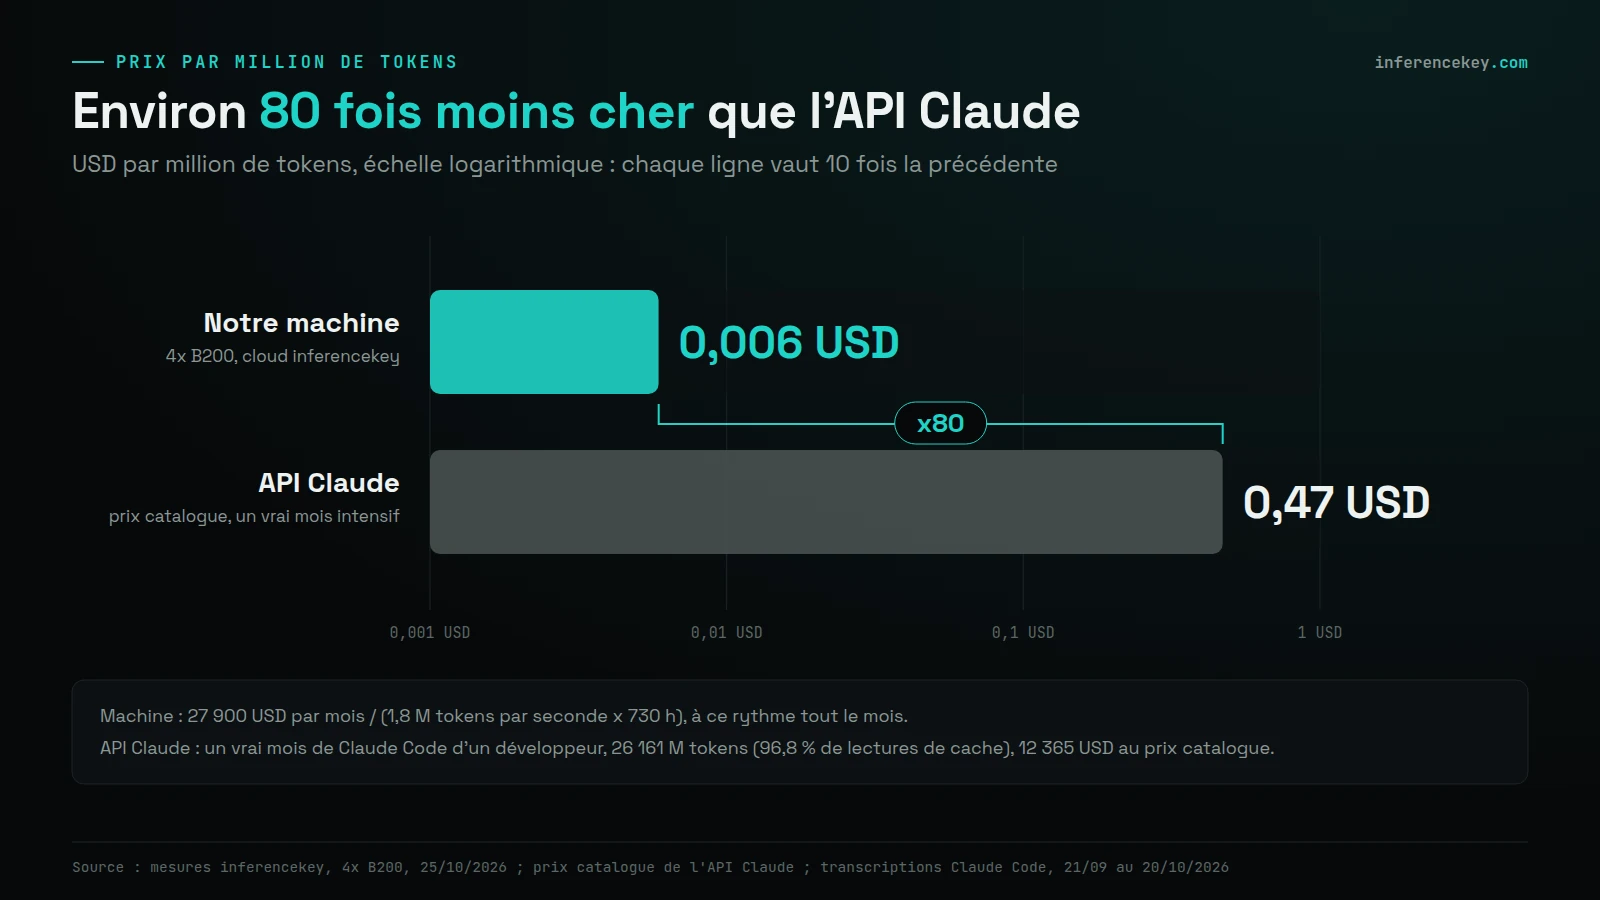
27 900 USD par mois à 1,8 M de tokens par seconde, c'est environ 0,006 USD par million de tokens. Soit environ 80 fois moins qu'un vrai mois intensif sur l'API Claude.
La comparaison est juste parce que les deux côtés relisent surtout : 96 % depuis le cache dans notre test, 96,8 % dans le vrai mois Claude. Une équipe qui dort la nuit paie plus par token utile. Les 30 % et les 80 fois répondent à des questions différentes, donc ne les multipliez pas.
Qualité : premier sur LiveBench agentic coding, et les réponses en cache correspondent aux réponses fraîches
Sur un benchmark de code externe, DeepSeek V4.1 Flash arrive premier. LiveBench a une catégorie agentic coding, où un modèle doit terminer une vraie tâche de programmation étape par étape. Le 10 octobre, DeepSeek V4.1 Flash a obtenu 77,3 et s'est classé premier sur 69 modèles. Claude Opus 5.5 a obtenu 71,7. Nous n'avons pas lancé ce benchmark nous-mêmes.
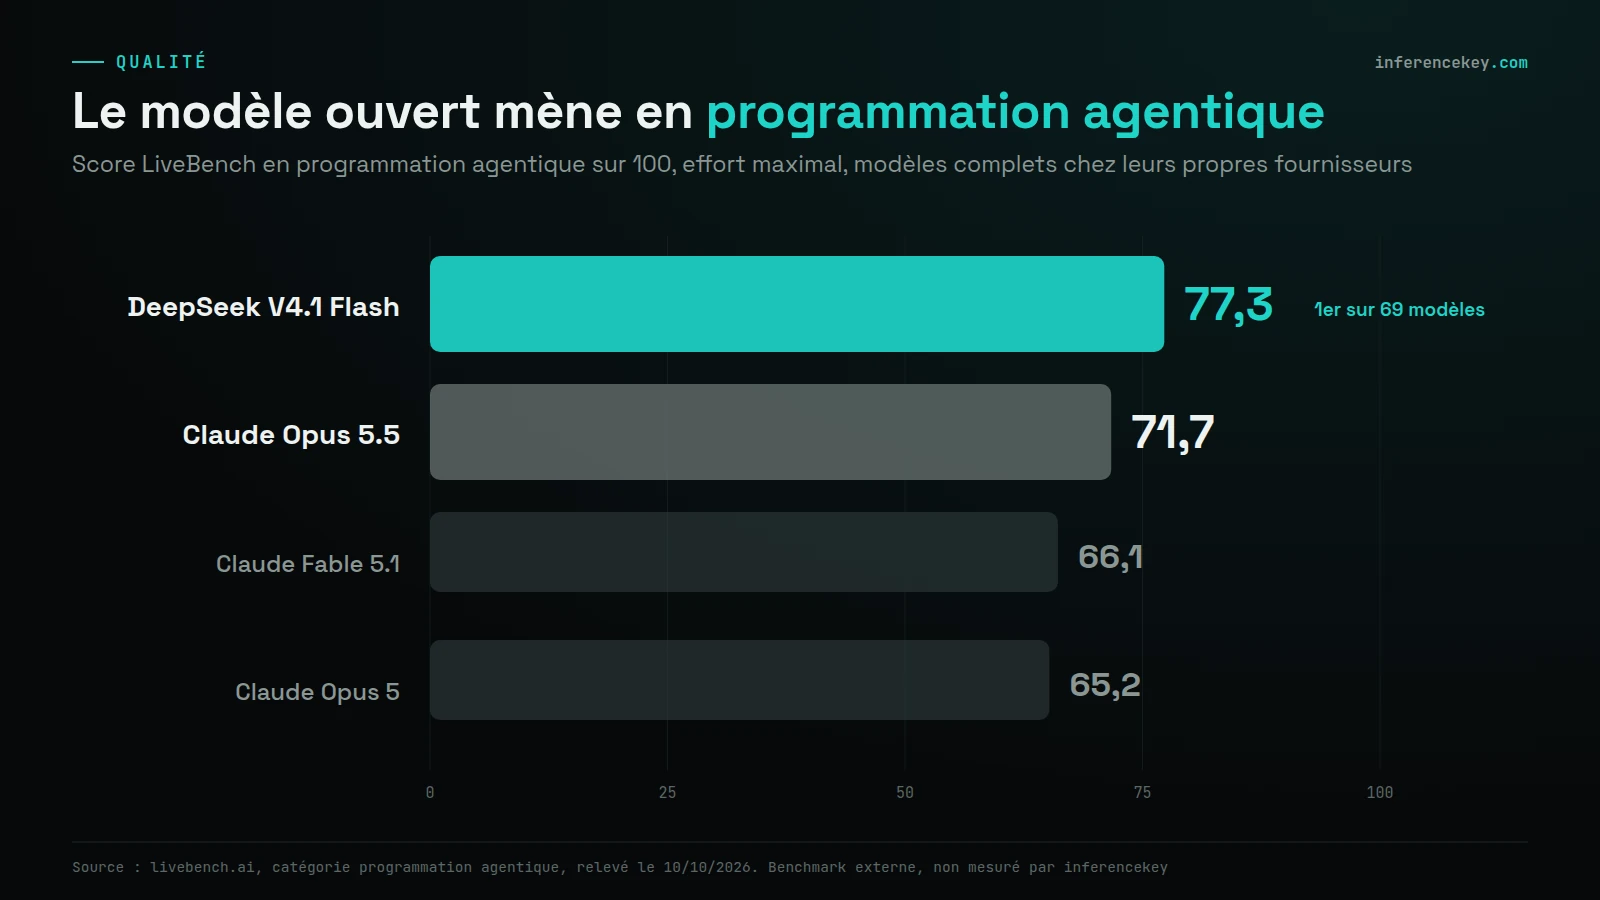
LiveBench agentic coding (livebench.ai, 10/10/2026) : DeepSeek V4.1 Flash 77,3 contre Claude Opus 5.5 71,7. Benchmark externe, non mesuré par nous.
Un indice plus large d'Artificial Analysis va dans l'autre sens : Opus 5.5 obtient 58 et Flash 39. Pour une équipe qui vient d'Opus, cet écart est la réserve honnête, alors essayez Flash sur vos propres tâches avant de changer.
Notre propre vérification, c'est que l'étagère ne change pas les réponses. Nous avons caché un fait dans un long document, jusqu'à 200 000 tokens, et l'avons demandé deux fois : une fois lu depuis zéro, une fois servi depuis le cache. Cinq documents sur cinq ont donné la même bonne réponse dans les deux cas. La version en cache a répondu en moins d'une seconde. Celle de 200 000 tokens a pris 13 secondes lue depuis zéro.
Cette vérification a mérité sa place. Une version antérieure de notre adaptateur ne servait rien depuis le cache, et cette vérification l'a repéré avant tout test de charge. Nous l'avons corrigé, et la version corrigée servait les répétitions à 95 à 99 % depuis le cache. Chaque chiffre mesuré de cet article en vient.
Votre code va là où vous le décidez
Avec Claude, ou avec l'API de DeepSeek, votre code et les données qu'il touche finissent chez un fournisseur de modèles. Avec inferencekey sur vos propres GPU, il ne quitte jamais votre réseau. Avec le cloud inferencekey, où ces tests ont tourné, il va sur nos GPU, pas chez Anthropic ni chez OpenAI. Dans les deux cas, les clés d'API restent de votre côté, dans votre réseau. Si l'une fuit, vous la renouvelez là. Le prix et les tests présentés ici concernent le cloud inferencekey. Nous n'avons ni chiffré ni testé le cas on-premise.
200 agents à 500K débordent le niveau rapide, donc environ 120 est le plafond à cette taille
Avec des conversations de 500 000 tokens, le niveau rapide de l'étagère est le plafond. Avec 200 agents qui demandaient tous en même temps, leurs conversations ne tenaient pas dans la mémoire des cartes graphiques. L'essai s'est effondré : la moitié des réponses a mis plus de deux minutes à démarrer. Rien n'a été perdu et rien n'a échoué, mais c'était inutilisable. À ce rythme dur, environ 120 conversations de cette taille peuvent être servies en même temps.
La plupart des tests ont contourné l'API inferencekey et appelé le moteur directement. Celui qui l'a utilisée a eu zéro erreur, mais ses réponses les plus lentes ont mis 22 secondes à démarrer, pas 15. C'était une seule fenêtre courte, donc nous ne pouvons pas encore dire combien coûte le saut supplémentaire sur les longues conversations.
Rentable au-delà d'environ 140 abonnements, si des réponses plus lentes aux heures de pointe sont acceptables
Au-delà d'environ 140 abonnements Claude Max 20x, une machine est une facture fixe sans plafond d'usage par personne. Le plafond est partagé, environ 400 agents, et vous gardez Claude Code. En dessous d'environ 140, les abonnements coûtent moins cher. Si votre code ne peut pas quitter le bâtiment, la même installation peut tourner sur vos propres GPU. Si vous avez dix développeurs, les abonnements ou l'API de DeepSeek restent le choix le plus simple.
Essayez vous-même
Suivez le guide DeepInfer sur 4x B200 pour servir DeepSeek V4.1 Flash et y pointer Claude Code. Il vous faut quatre cartes B200, ou un workload dans le cloud inferencekey, et une clé d'API inferencekey. Avec les poids sur disque, notre workload était prêt en moins de deux minutes.
Pour les ingénieurs
Chiffres exacts, méthode et limites derrière le récit. Tous les essais mesurés ont utilisé DeepSeek-V4.1-Flash sur DeepInfer, 4x NVIDIA B200 dans le cloud inferencekey. Dates en UTC.
Matériel et logiciel
| Élément | Valeur |
|---|---|
| GPU | 4x NVIDIA B200 |
| Modèle | DeepSeek-V4.1-Flash, poids de 476 GB, chargés depuis le disque local du conteneur |
| Moteur | DeepInfer, empaqueté comme backend Python personnalisé inferencekey deepinfer-v41-flash, 4 ranks, parallélisme d'experts |
| Version du backend | 0.3.2 pour chaque étape mesurée (correctif dans le commit 66bf620 du SDK inferencekey) |
| Pool KV GPU | 57 065 472 tokens (14,27 M par rank) |
| Niveau L1 en RAM de l'hôte | 128 GiB par rank, 617 009 664 tokens au total |
| Longueur maximale du modèle | 1 064 960 tokens |
| Chemins de l'endpoint | OpenAI /v1/chat/completions et Anthropic /v1/messages |
| Préparation de la machine | poids plus installation de DeepInfer 5 min (b200-final) et 4 min (b200-500k), 11 min sur une machine antérieure |
| Déploiement du workload via inferencekey | prêt en 105 s |
Déployer et connecter
Le déploiement utilise le SDK inferencekey :
package_backend:deepinfer-v41-flash0.3.2, entrypointdeepinfer_backend:DeepInferBackend, apiopenai-chat.publish_custom_backendvers le tenant.ManagementClient.ensure(WorkloadSpec(slug="deepinfer-v41-flash", model="deepseek-v4.1-flash", backend="deepinfer-v41-flash", ...))avec la configurationengine=deepinfer,ep=4,CUDA_VISIBLE_DEVICES=0,1,2,3.wait_until_ready.
Le manager sert /endpoint/<project>/<workload>/v1/messages (Anthropic) à côté de /v1/chat/completions et /v1/models. L'authentification est Authorization: Bearer, avec x-api-key en repli. Des valeurs différentes dans les deux en-têtes donnent un 401. /v1/messages nécessite un workload de chat sur GPU local. Claude Code ajoute /v1/messages lui-même :
export ANTHROPIC_BASE_URL=https://api.inferencekey.com/endpoint/<project>/<workload>
export ANTHROPIC_AUTH_TOKEN=ik_live_...
export ANTHROPIC_MODEL=deepseek-v4.1-flash
export ANTHROPIC_DEFAULT_HAIKU_MODEL=deepseek-v4.1-flash
export ANTHROPIC_DEFAULT_SONNET_MODEL=deepseek-v4.1-flash
export ANTHROPIC_DEFAULT_OPUS_MODEL=deepseek-v4.1-flash
export CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1
claude
Test de fumée avant la campagne : chat OpenAI, streaming et Anthropic /v1/messages avec un outil ont tous répondu correctement (stop_reason: tool_use avec un appel Read). Étape par étape, avec le code du backend, dans le guide de la documentation.
Charge de travail et critères de réussite
Chaque utilisateur est une session d'agent qui démarre à la taille du palier (palier 128K : 96 000 tokens, compacte à 128 000. Palier 500K : 440 000, compacte à 500 000. Palier 1M : 940 000, compacte à 1 000 000). Nouvelle entrée par tour p50 / p90 / p99 1 100 / 5 500 / 51 000 tokens, sortie p50 / p90 423 / 1 700 (plafonnée à 1 700), tirées de percentiles réels de Claude Code. Temps de réflexion moyen 3 s, montée en charge 16 sessions à la fois, température 0,6.
Une étape réussit lorsque, sur les tours mesurés à chaud : TTFT p95 <= 15 s, tok/s par utilisateur p50 >= 20 et p10 >= 10, erreurs <= 1 %, taux de cache >= 90 %.
Toutes les étapes mesurées
| Étape | Chemin | Verdict | Tours (à froid) | TTFT p50 / p95 (s) | tok/s p50 / p10 | Cache | Goodput | Erreurs |
|---|---|---|---|---|---|---|---|---|
| 500K x 50 | direct | RÉUSSI | 75 (0) | 2,47 / 4,41 | 162,9 / 99,5 | 100 % | 100 % | 0 |
| 500K x 100 | direct | ÉCHEC (TTFT p95) | 237 (7) | 2,55 / 36,98 | 134,6 / 39,1 | 99 % | 83 % | 0 |
| 500K x 200 | direct | ÉCHEC | 17 (0) | 151,09 / 160,74 | 26,2 / 9,2 | 41 % | 0 % | 0 |
| 128K x 300 | direct | RÉUSSI | 521 (48) | 5,57 / 14,76 | 35,4 / 16,3 | 98 % | 91 % | 0 |
| 128K x 350 | direct | ÉCHEC | 676 (85) | 7,39 / 20,98 | 22,3 / 8,4 | 98 % | 76 % | 0 |
| 128K x 400 | direct | ÉCHEC | 652 (52) | 7,27 / 16,93 | 29,1 / 9,5 | 98 % | 80 % | 0 |
| 1M x 48 | direct | ÉCHEC (TTFT p95) | 100 (3) | 3,64 / 28,85 | 69,4 / 22,4 | 100 % | 80 % | 0 |
| 128K x 300 | inferencekey | ÉCHEC (TTFT p95) | 479 (28) | 5,61 / 22,17 | 40,1 / 13,8 | 98 % | 83 % | 0 |
TTFT, tok/s et Cache portent sur les tours mesurés à chaud, c'est pourquoi 500K x 100 affiche ici 99 % contre 96,1 % sur l'ensemble des tokens d'entrée mesurés (tours à froid compris) dans le récit. Le goodput est la part des tours à chaud avec TTFT <= 15 s et tok/s >= 10. À 128K, la limite est le calcul du nouveau prefill (au-delà d'environ 100 à 116 K nouveaux tokens/s, le premier token grimpe). À 500K, la limite est la mémoire KV du GPU.
L'essai à chaud avec 100 agents (direct-500K-0100-01, 25/10/2026)
237 tours mesurés (7 à froid), 0 erreur, fenêtre de 60,2 s (du début du premier tour mesuré à la fin du dernier). Entrée de 108 173 087 tokens, dont 103 989 632 en cache (96,1 %) : 1 797 048 tok/s en entrée. Sortie de 129 332 tokens : 2 149 tok/s. Nouveau prefill 69 499 tok/s. TTFT à chaud p50 2,55 s, p95 36,98 s. TTFT à froid dans la fenêtre p50 26,55 s. tok/s par utilisateur p50 134,61, p10 39,07. Ratio KV 0,79. Ces débits sont des sommes de tokens sur la fenêtre, pas des compteurs du moteur. Les tours lents à chaud ont fait la queue derrière les 7 prefills à froid de 450K, pas derrière L1. Prioriser les tours à chaud ou limiter les sessions à froid simultanées aiderait probablement (non testé). Le simulateur attribue la traîne lente à une rafale de compactages simultanés, parce que toutes les sessions de la campagne ont démarré ensemble à 440K.
Le test de stress à froid (direct-500K-0400-00, 24/10/2026)
399 nouvelles sessions d'environ 440K lancées 16 par 16, rien en cache. 397 ont terminé avec 0 erreur avant que l'étape n'atteigne max_step_s 900 s, donc son verdict formel est "warmup timeout" et elle n'a pas de phase mesurée. Prompt p50 440 993. Entrée de 176 154 816 tokens (0 en cache), sortie de 222 439. Fenêtre de 878,2 s (14,64 min) : environ 200,6 K tok/s en entrée. Débit de lecture par minute, regroupé par premier token, de 206 à 237 K tok/s pendant les 12 premières minutes, puis en baisse à mesure que les dernières sessions se terminent. TTFT p50 13,72 s, p95 28,73 s, compté depuis le lancement de chaque session après la file de 16 par 16. Compté depuis le début de l'étape, les premiers tokens sont arrivés en médiane à 381 s et au plus tard à 874,7 s. L1 actif, 58 GB utilisés par rank, promotions à 4,1 GB/s. Prefill à froid dans les autres montées en charge à 500K : 191,7 K tok/s (50 sessions), 214,3 K (100), 244,6 K (200), TTFT à froid p50 de 12,5 à 12,8 s.
Pourquoi 500K x 200 s'est effondré
Environ 50 requêtes en cours par rank à environ 445K tokens chacune, cela fait environ 22 M de tokens, contre 14,27 M de KV GPU par rank. L1 n'a rien perdu (dropped = 0) et a enregistré de 54 à 56 timeouts de promotion par rank : une session promue depuis L1 attendait jusqu'à 2 s de la place sur le GPU, puis était recalculée. L1 aide les sessions au repos, pas les sessions toutes en cours en même temps. Avec 3 s de temps de réflexion, environ 120 sessions de 450K est le maximum qui peut décoder en même temps (57,1 M / 0,45 M, avec un peu de réserve).
Simulateur (modélisé)
Modèle à événements de DeepInfer 0.3.2 sur 4x B200 : routage par affinité de session vers un rank, cache GPU de 14 266 368 et L1 de 154 252 416 tokens par rank, lockstep EP, prefill découpé qui partage les étapes avec le décodage, promotion L1 avec une attente de 2,0 s, et une file d'entrée par GPU inférée. Calibré en rejouant les 7 879 tours enregistrés des deux campagnes et ajusté sur les tours mesurés à chaud de 6 étapes directes. Il reproduit l'effondrement de 500K x 200 en boucle fermée (modèle environ 200 s de TTFT p50, réel 151 s). Durée de l'essai à froid : 822 s modélisés contre 878 s réels.
Charge de travail : 30 jours de transcriptions Claude Code de l'utilisateur de référence, 140 300 appels de 3 912 agents. Le contexte grandit en moyenne de 2 597 tokens par appel (médiane 1 406), sortie moyenne 663 tokens, pause moyenne 13,9 s (pauses de plus de 600 s exclues), compactage à 500K ramené à environ 43K.
NVIDIA aiperf 0.13.0 contre le simulateur, boucle fermée à calendrier fixe, 600 s mesurées après 90 s de montée en charge, un essai par point :
| Agents | SLO | TTFT p50 / p95 (s) | req/s | Intervalle par agent (s) | Erreurs | Verdict |
|---|---|---|---|---|---|---|
| 250 | 15 s | 3,68 / 13,54 | 7,428 | 33,65 | 0 | RÉUSSI |
| 275 | 15 s | 6,63 / 15,42 | 7,525 | 36,54 | 0 | ÉCHEC (de peu) |
| 300 | 15 s | 7,97 / 18,37 | 7,652 | 39,21 | 0 | ÉCHEC |
| 400 | 30 s | 20,82 / 29,59 | 7,632 | 52,41 | 0 | RÉUSSI |
| 425 | 30 s | 22,63 / 34,37 | 7,613 | 55,82 | 0 | ÉCHEC |
Le débit sature près de 7,5 req/s, quel que soit le SLO.
Des agents aux abonnements (dérivé du modélisé)
- Environ 200 : 400 agents (TTFT p95 <= 30 s) / 2 agents simultanés par utilisateur intensif, toute la journée (notre hypothèse). Chaque agent appelle toutes les 52 s, contre 27 s sur Claude pour l'utilisateur de référence.
- Environ 80 : 7,5 req/s / 0,092 appel/s, le taux d'appels moyen de l'utilisateur de référence à l'heure de pointe. Identique pour les deux SLO.
- Autres comptes : environ 170 en comptant les 2,3 agents actifs de l'utilisateur de référence en pointe (400 / 2,3), environ 140 sur sa moyenne mensuelle de 0,054 appel/s (non valable pour le dimensionnement), environ 38 si tout le monde est en même temps dans son heure la plus chargée (0,198 appel/s).
- L'utilisateur de référence inclut des agents autonomes, donc un utilisateur typique de Claude Max charge moins la machine. Les taux d'appels viennent de notre analyse interne de ses transcriptions. Aucun script sauvegardé ne les reproduit, mais la division tombe juste.
Coût (dérivé)
- Machine : 27 900 USD par mois, prix public de la machine 4x B200 dans le cloud inferencekey.
- Abonnements : 200 x 200 USD (Claude Max 20x) = 40 000 USD. 1 - 27 900 / 40 000 = 30,25 %, 12 100 USD de moins par mois. Seuil de rentabilité face à Max 20x à 27 900 / 200 = environ 140 abonnements. Au compte strict de 80 : 16 000 USD en abonnements, donc la machine coûte environ 75 % de plus.
- Par million de tokens d'entrée : 27 900 / (1,8 M x 3 600 x 730 / 1e6) = 0,0059 USD, environ 0,006, à pleine utilisation pendant 730 h. Cela chiffre uniquement les tokens d'entrée, avec un mélange très chargé en cache (96,1 % ici, 96,8 % de lectures de cache dans le vrai mois Claude).
- API Claude, le mois d'un développeur très intensif (du 21/09/2026 au 20/10/2026) : 12 365 USD / 26 161 M de tokens = 0,47 USD par million. 0,47 / 0,006 = environ 80 fois. C'est une autre fenêtre de 30 jours que le mois de référence du simulateur, même utilisateur.
- API DeepSeek, même mois : 274 USD, environ 0,0105 USD par million, presque le double de notre machine. C'est l'option hébergée bon marché, mais le code va toujours chez un fournisseur de modèles.
- Les 30 % (face aux abonnements) et les 80 fois (par token, face à l'API) répondent à des questions différentes. Ne les combinez pas.
Qualité
- Contrôle qualité (
quality_check.py) : un fait caché dans du remplissage à une profondeur donnée, envoyé à froid puis depuis le cache de préfixes à température 0. Essai 3 (25/10/2026, backend 0.3.2) :
| Cas | Tokens du prompt | Tokens en cache | À froid (s) | En cache (s) | Réponse |
|---|---|---|---|---|---|
| 16K, fait à 50 % | 15 570 | 15 232 | 1,25 | 0,79 | identique |
| 64K, fait à 10 % | 63 767 | 63 488 | 3,93 | 0,78 | identique |
| 64K, fait à 50 % | 63 667 | 63 360 | 4,31 | 0,80 | identique |
| 64K, fait à 90 % | 63 715 | 63 360 | 3,91 | 0,79 | identique |
| 200K, fait à 30 % | 200 542 | 200 192 | 12,97 | 0,80 | identique |
L'essai 2 (24/10/2026, 0.3.2) a aussi réussi 5/5. Le contrôle vérifie seulement la récupération du fait, pas la qualité du code. L'équivalence des réponses avec L1 n'a été vérifiée qu'avec des poids synthétiques dans un test sur 1x B200.
- Le backend 0.3.1 servait 0 token en cache sur 4 ranks : la boucle du rank appelait
cache.forget()sur la dernière sortie, mais DeepInfer finalise la séquence une étape plus tard. Corrigé dans le commit66bf620du SDK (output_finishedplus un nettoyage après 30 s), livré en 0.3.2, qui servait les répétitions à 95 à 99 % depuis le cache. - LiveBench agentic coding (10/10/2026, effort maximal, modèles complets chez leurs propres fournisseurs) : DeepSeek-V4.1-Flash 77,3 (1er sur 69), Claude Opus 5.5 71,7, Claude Fable 5.1 66,1, Claude Opus 5 65,2. Artificial Analysis Intelligence Index (16/10/2026) : Opus 5.5 58, Flash 39. Cité de notre article du 20/10/2026, non revérifié.
Tâche Claude Code (24/10/2026)
Claude Code 2.1.310, inchangé, ANTHROPIC_BASE_URL sur l'endpoint, modèle deepseek-v4.1-flash. Tâche : implémenter parse_duration dans durations.py pour que test_durations.py passe. 15/15 tests, 39 s au total, 37,3 s dans Claude Code (temps d'API 32,0 s, premier token 2,6 s). 14 appels d'outils (Read 7, Bash 4, Edit 2, Write 1, un appel Bash refusé par les permissions), 15 tours, 22 117 tokens d'entrée, 173 696 de lecture de cache et 3 549 de sortie. La scène Claude Code de la vidéo est la vraie application filmée en train de refaire la même tâche contre un serveur local Anthropic Messages qui renvoie en streaming les réponses du modèle enregistrées pendant cette session, avec les outils qui s'exécutent réellement.
Limites
- Chaque étape mesurée a utilisé un temps de réflexion moyen de 3 s, donc presque tous les agents étaient actifs en même temps. Ce sont des charges d'agents au pire cas, pas un rythme humain. Aucun essai à rythme humain n'a été mesuré, donc le bénéfice de L1 pour les sessions au repos n'est pas mesuré.
- Les chiffres de débit sont des sommes de tokens sur des fenêtres courtes (22 à 175 s), pas des compteurs du moteur. L'essai à froid n'a terminé que la montée en charge, donc son débit est un débit de prefill.
- Le chemin via la passerelle inferencekey a eu une étape de confirmation (128K x 300 : TTFT p95 22,17 s contre 14,76 s en direct), 479 tours sur une fenêtre de 59 s. Son surcoût sur la latence en contexte long n'est pas établi. Le palier 1M n'est pas passé par la passerelle (il nécessite
max_model_len1 068 000, au-dessus des 1 064 960 configurés). - Tous les comptes d'agents et d'abonnements sont modélisés. La file d'entrée du simulateur est inférée et fixe le plafond d'environ 7,5 req/s. La vitesse de décodage dans le modèle est pessimiste à 128K et 500K et optimiste à 1M, et elle sous-estime la traîne lente (p95 en boucle fermée de 5,90 s contre 36,98 s réels à 500K x 100). Son contexte simulé tourne autour de 270K par appel contre environ 200K pour l'utilisateur de référence. Un essai aiperf par point, sans intervalles de confiance.
- Le prix par million suppose 730 h de pleine utilisation et ne couvre que les tokens d'entrée.
- La tâche Claude Code est une petite tâche, pas un benchmark. La qualité du code sur votre propre base de code n'a pas été mesurée.
- Non mesuré : 500K x 300 (arrêté pendant la montée en charge), 1M x 36 (ignoré).
Sources
Dossier d'ingénierie interne docs/deepinfer-4xb200/ dans le dépôt inferencekey (README.md, real-tests.md, simulation.md, cost-and-quality.md, methodology.md, data/). Fichiers bruts des étapes des campagnes b200-final et b200-500k, à partir desquels nous avons recalculé les chiffres des 100 agents et de l'essai à froid. Sorties du simulateur rehearsal/sim500k/runs/aiperf_results.json (SLO de 15 s) et rehearsal/sim500k/runs/aiperf_results_ttft30.json (SLO de 30 s). DeepInfer (Apache 2.0). LiveBench. Artificial Analysis. Tarifs de Claude. Notre article précédent sur ce que coûte un mois d'agent de code.