Mit zwei Agenten pro Power-User trägt eine 4x-B200-Maschine die Claude-Code-Last von rund 200 Abos, für rund 30 % weniger
DeepInfer und der inferencekey Cache auf 4x B200: 100 Agenten mit 450K Tokens, die Hälfte der Antworten in 2,5 s, 0 Fehler, rund 30 % günstiger als Abos.
Kann eine einzige Maschine die Claude-Code-Arbeit von 200 Abos leisten? Gemessen haben wir 100 Agenten. Die 200 sind aus diesen Läufen modelliert. Ein Server mit vier NVIDIA-B200-Grafikkarten in der inferencekey Cloud hat DeepSeek V4.1 Flash auf DeepInfer betrieben, der Engine, die DeepSeek im Oktober als Open Source veröffentlicht hat. Wir haben das Teil ergänzt, ohne das die Engine ausgeliefert wird: einen Cache. Hundert synthetische Agenten, so dimensioniert wie echte Claude-Code-Sessions, arbeiteten gleichzeitig, jeder mit fast einer halben Million Tokens Gesprächsverlauf. Die Hälfte ihrer Antworten begann innerhalb von etwa 2,5 Sekunden, und keine einzige Anfrage schlug fehl. Ein auf diesen Läufen kalibrierter Simulator setzt die Maschine bei etwa 400 gleichzeitigen Agenten an. Wenn deine Power-User je zwei Agenten nutzen, ist das die Last von rund 200 Abos, für rund 30 % weniger.
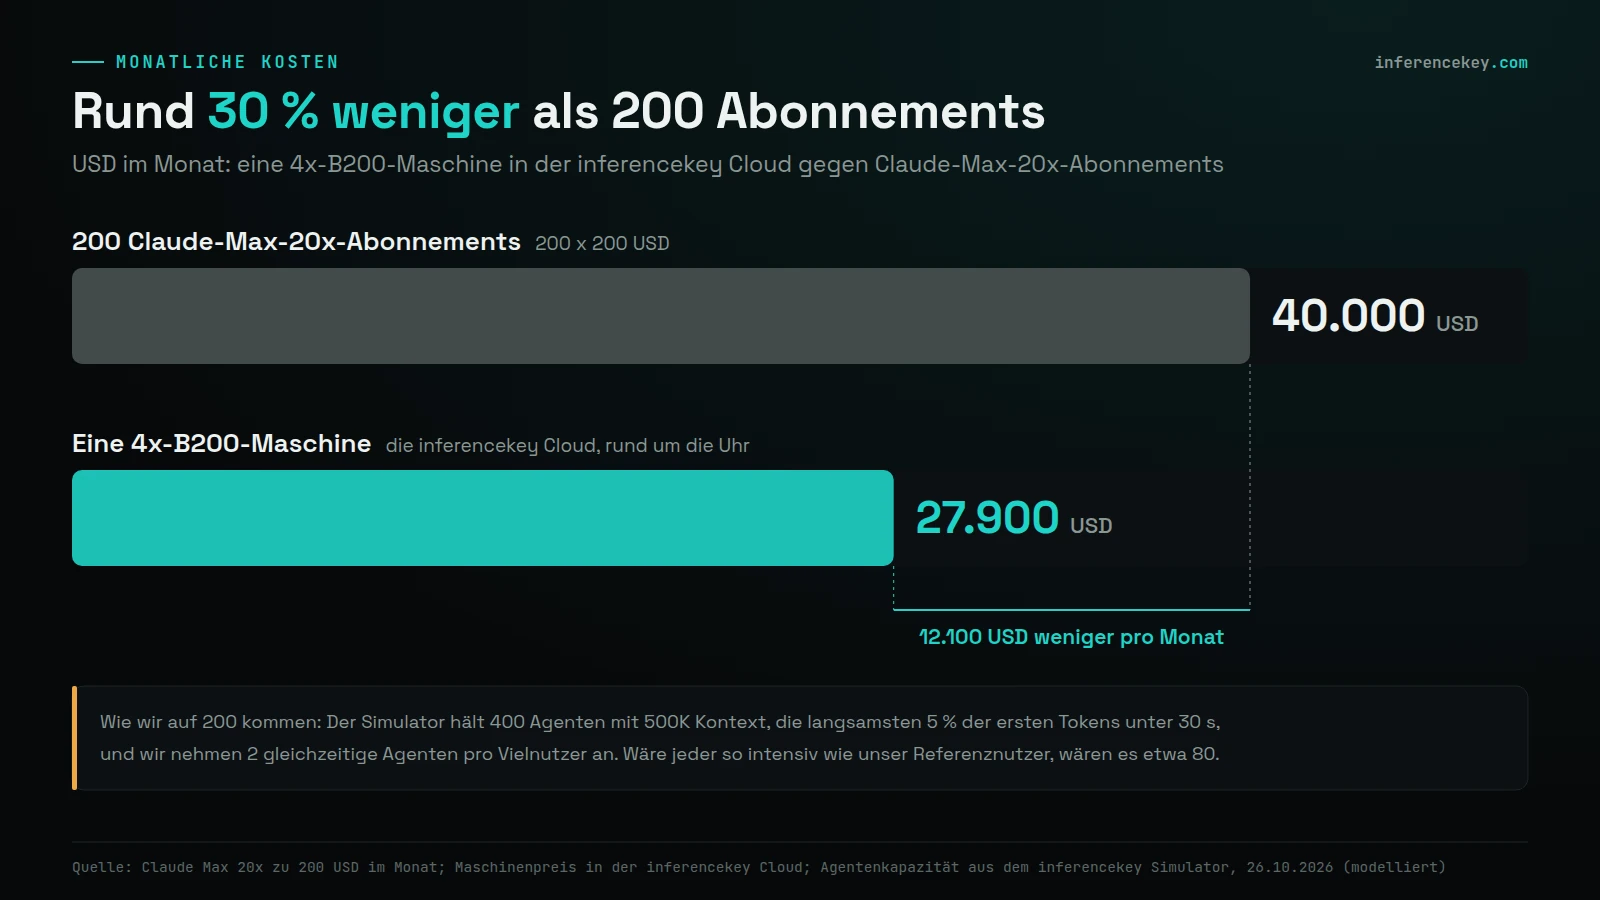
200 Abos setzen 2 gleichzeitige Agenten pro Power-User voraus (400 Agenten, modelliert). Wäre jeder Nutzer so intensiv wie unser Referenznutzer, ergibt der Simulator etwa 80.
| 200 Claude-Max-20x-Abos | 40.000 USD pro Monat |
| Eine 4x-B200-Maschine in der inferencekey Cloud | 27.900 USD pro Monat, rund 30 % weniger |
| Break-even gegenüber Claude Max 20x | etwa 140 Abos |
| Gemessen: 100 Agenten mit je etwa 450K Tokens | die Hälfte der Antworten beginnt innerhalb von 2,55 s, 0 Fehler |
| Gemessen: gelesene Tokens pro Sekunde mit Cache | etwa 1,8 Millionen, 96 % davon aus dem Cache |
| Gemessen: 397 neue Gespräche mit 440K, nichts im Cache, je 16 auf einmal gestartet | 176 Millionen Tokens in unter 15 Minuten gelesen, 0 Fehler |
| Modelliert: gleichzeitige Agenten, langsamste 5 % starten innerhalb von 30 s | etwa 400 |
| Preis pro Million gelesener Tokens | etwa 0,006 USD, rund 80-mal weniger als die Claude API |
| Nötige Änderungen an Claude Code | keine, ein paar Umgebungsvariablen (Endpoint, Key, Modellname) |
Ein Coding-Agent liest vor allem erneut, und der Cache macht das erneute Lesen fast kostenlos
Jedes Mal, wenn Claude Code einen Schritt macht (eine Datei öffnen, einen Test ausführen, eine Zeile ändern), schickt es dem Modell erneut das ganze Gespräch. In unseren Tests waren das etwa 450.000 Tokens, ungefähr ein Buch mit 1.300 Seiten. Das Modell schreibt ein paar hundert Tokens Antwort, und beim nächsten Schritt schickt der Agent wieder das ganze Buch, plus eine neue Seite.
In unserem letzten Research-Beitrag haben wir einen sehr intensiven Entwickler einen Monat lang gemessen und dasselbe gefunden: 96,8 % dessen, was sein Agent las, hatte er schon einmal gelesen. Stell dir ein Regal neben dem Modell vor. Was es einmal gelesen hat, bleibt im Regal, und beim nächsten Mal nimmt es das fertig heraus, statt es neu zu lesen.
DeepInfer wird ohne dieses Regal ausgeliefert. Auf DeepSeeks eigener Projektseite steht der Cache unter den Teilen, die man selbst bauen muss. Ohne ihn las unsere Maschine weniger als ein halbes Buch pro Sekunde, jedes Gespräch von vorn. Mit dem inferencekey Cache las sie vier Bücher pro Sekunde. Die Rechnung für Coding-Agenten ist vor allem eine Rechnung für erneutes Lesen, und wer das Regal hat, bestimmt den Preis.
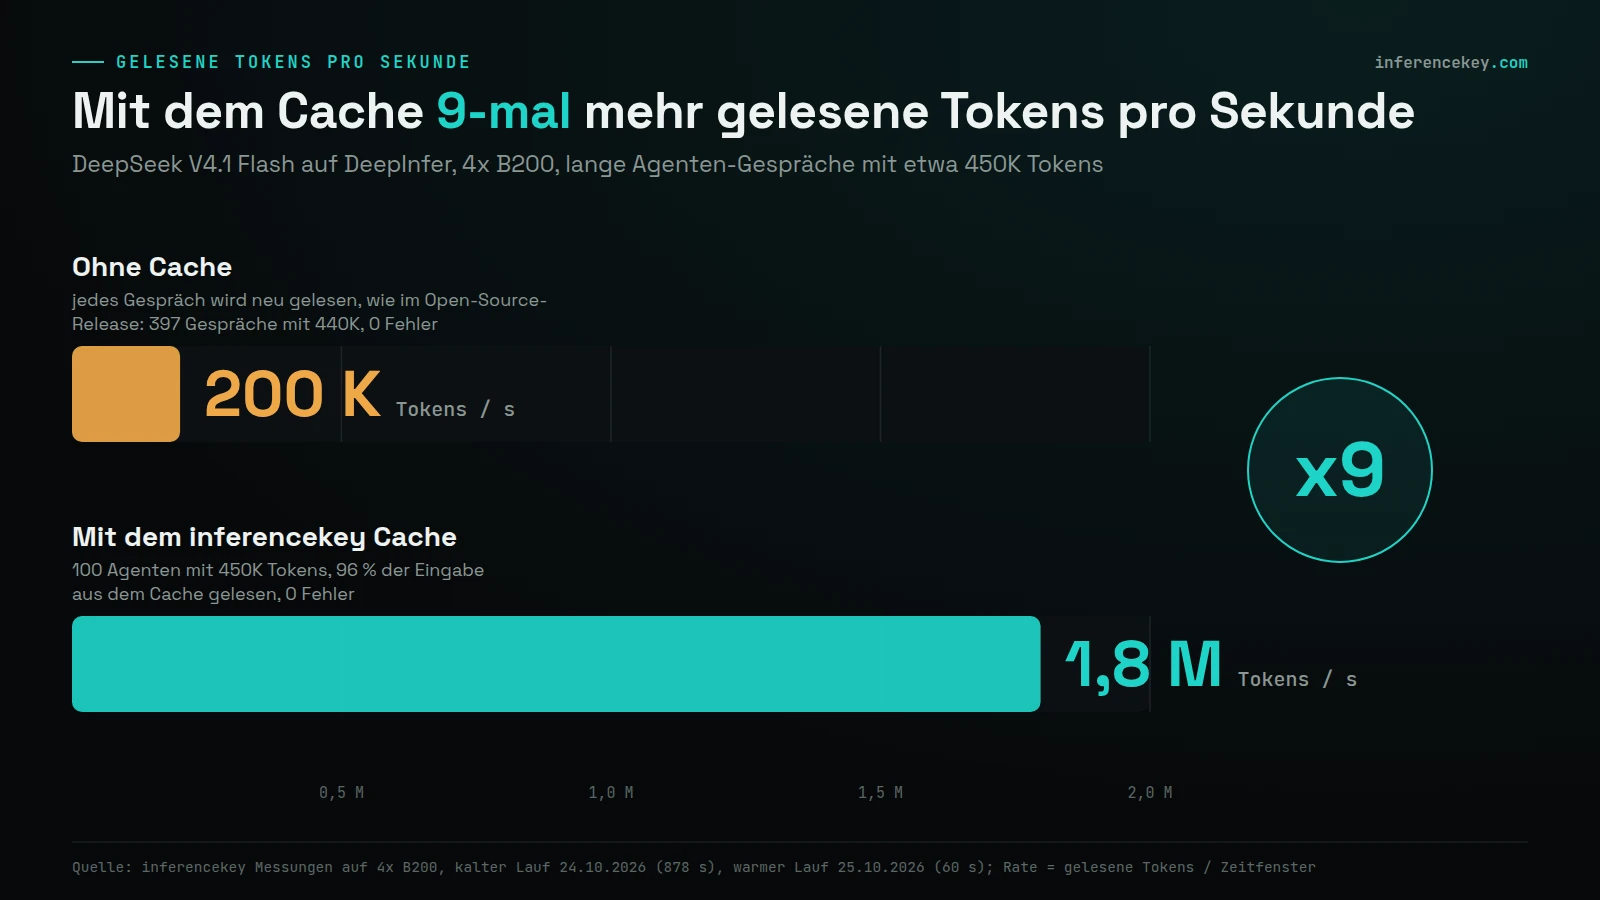
Gleiche Maschine, gleiches Modell: Der Cache macht aus rund 200 K gelesenen Tokens pro Sekunde rund 1,8 M.
Claude Code braucht nur ein paar Umgebungsvariablen und hat eine echte Aufgabe in 39 Sekunden erledigt
Ein paar Umgebungsvariablen sagen Claude Code, wohin es seine Anfragen schicken, welchen Key es nutzen und welches Modell es anfragen soll. Richte sie auf deinen inferencekey Endpoint, und es spricht mit DeepSeek V4.1 Flash statt mit Anthropic, mit denselben Befehlen und denselben Tools.
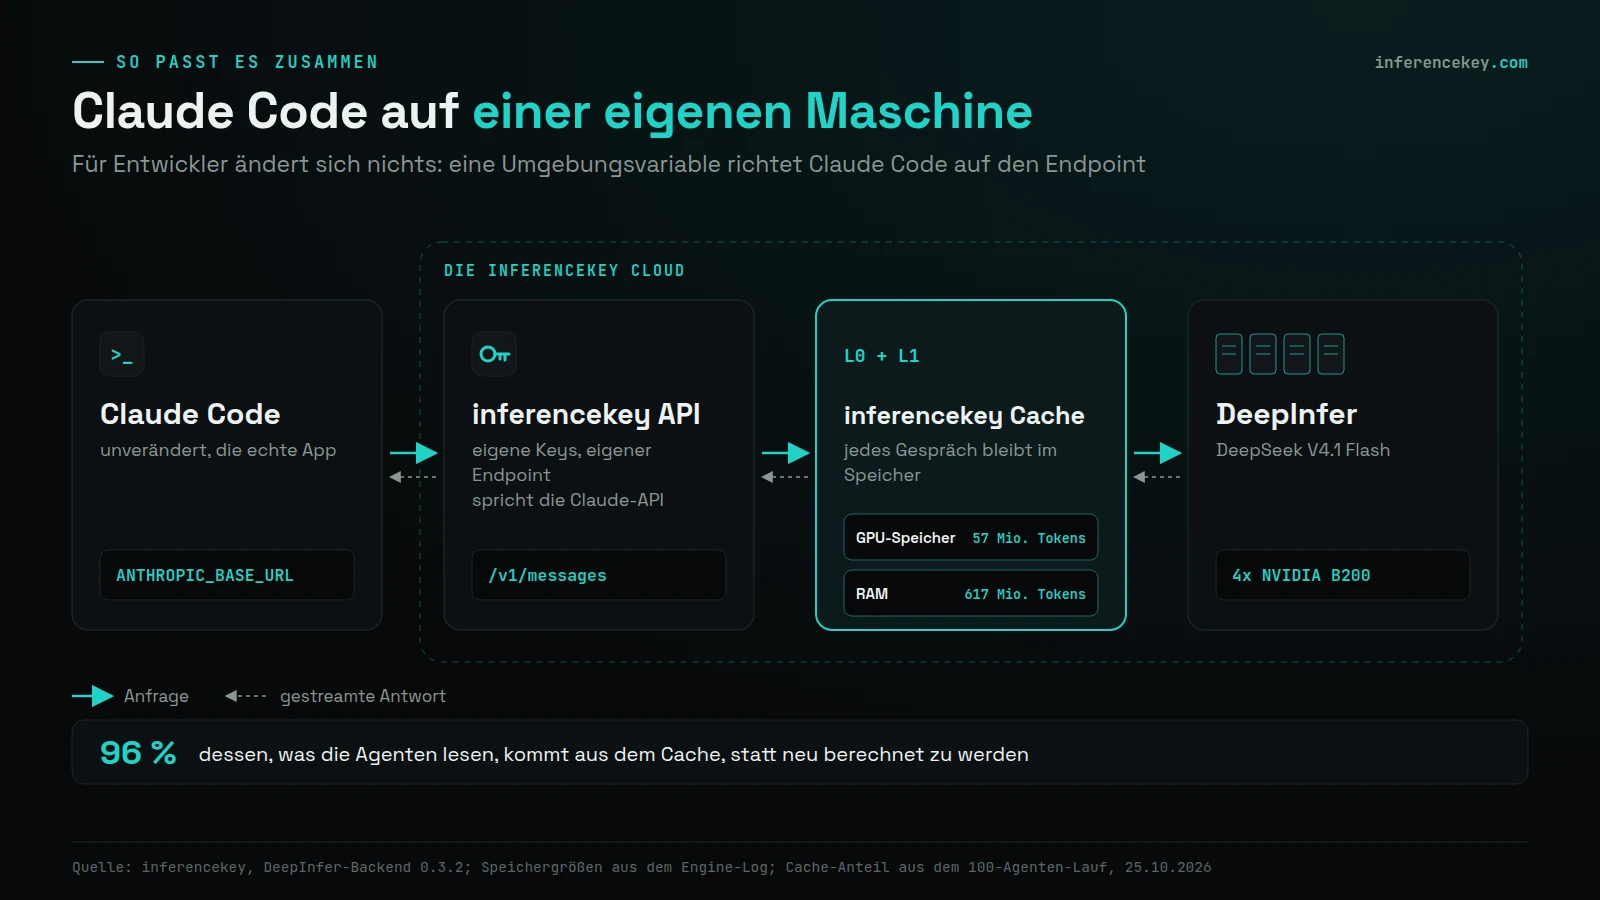
Umgebungsvariablen richten Claude Code auf deinen Endpoint. Der inferencekey Cache hält jedes Gespräch im GPU-Speicher und im RAM.
Das Regal hat zwei Böden. Der schnelle liegt im Speicher der Grafikkarten selbst und fasst etwa 57 Millionen Tokens, ungefähr 120 Gespräche unserer Größe. Dahinter liegt ein zweiter Boden im normalen Arbeitsspeicher des Servers, etwa zehnmal größer mit 617 Millionen Tokens, für Gespräche, die gerade einen Moment ruhen.
Am 24. Oktober hat Claude Code 2.1.310, so eingerichtet, eine kleine echte Aufgabe in 39 Sekunden erledigt. Die Aufgabe war, eine Funktion namens parse_duration so zu implementieren, dass eine Datei mit 15 Tests durchläuft. Der Agent machte 14 Tool-Aufrufe (Dateien lesen, Tests ausführen, Code ändern), und alle 15 Tests liefen durch.
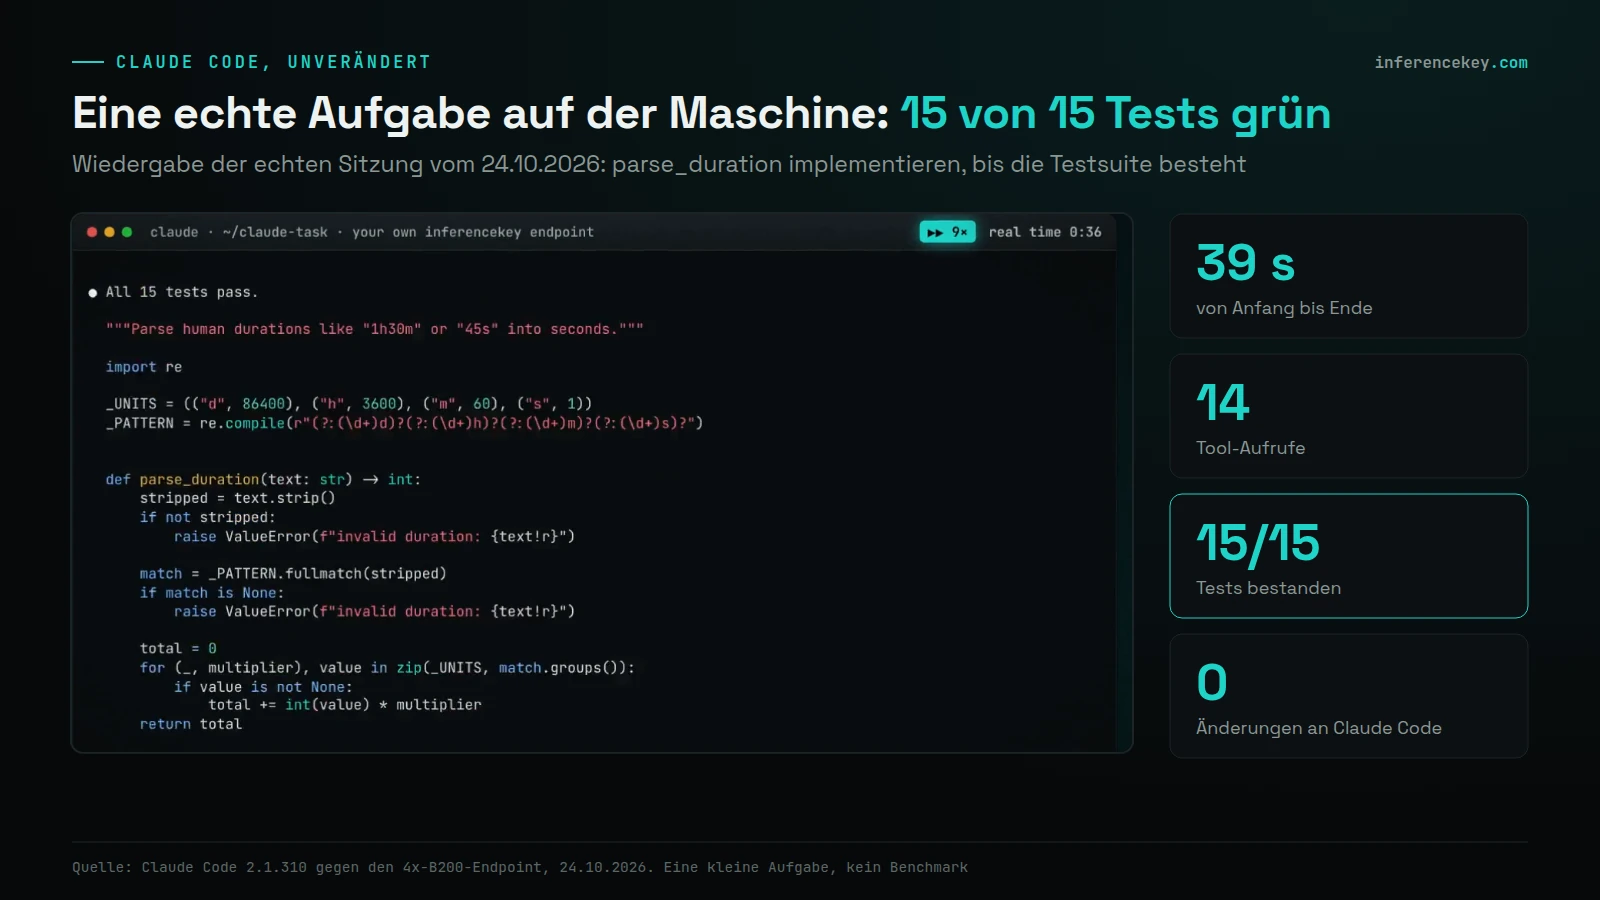
Claude Code 2.1.310, unverändert, auf unserem Endpoint: eine echte Aufgabe in 39 s mit 14 Tool-Aufrufen und 15 von 15 grünen Tests. Eine kleine Aufgabe, kein Benchmark.
Die Szene im Video oben zeigt die echte App, die diese Aufgabe noch einmal erledigt. Sie spielt die an jenem Tag aufgezeichneten Modellantworten ab, während die Tools wirklich laufen.
Der Verdienst ist geteilt. DeepSeeks Team hat DeepSeek V4.1 Flash trainiert, DeepInfer geschrieben und es unter der Apache-2.0-Lizenz veröffentlicht. NVIDIAs Tool aiperf hat unseren Simulator unter Last getestet. Anthropics Claude Code lief obendrauf. Unser Teil ist der Cache, der Adapter, mit dem inferencekey DeepInfer betreibt, die API, die die Sprache von Claude Code mit deinen eigenen Keys spricht, und die Messungen.
100 Agenten mit je einer halben Million Tokens: Die Hälfte der Antworten beginnt in 2,5 Sekunden, null Fehler
Mit 100 gleichzeitigen Agenten, jeder mit etwa 450.000 Tokens schon im Regal, begann die Hälfte der Antworten innerhalb von 2,55 Sekunden, und keine schlug fehl. Das ist die Größe einer langen Claude-Code-Session am Ende des Tages. Wir haben den Lauf am 25. Oktober gemacht, und in einem Fenster von einer Minute bediente die Maschine 237 Agenten-Turns. Die Antwort jedes Agenten kam mit etwa 135 Tokens pro Sekunde, eine Seite in wenigen Sekunden.
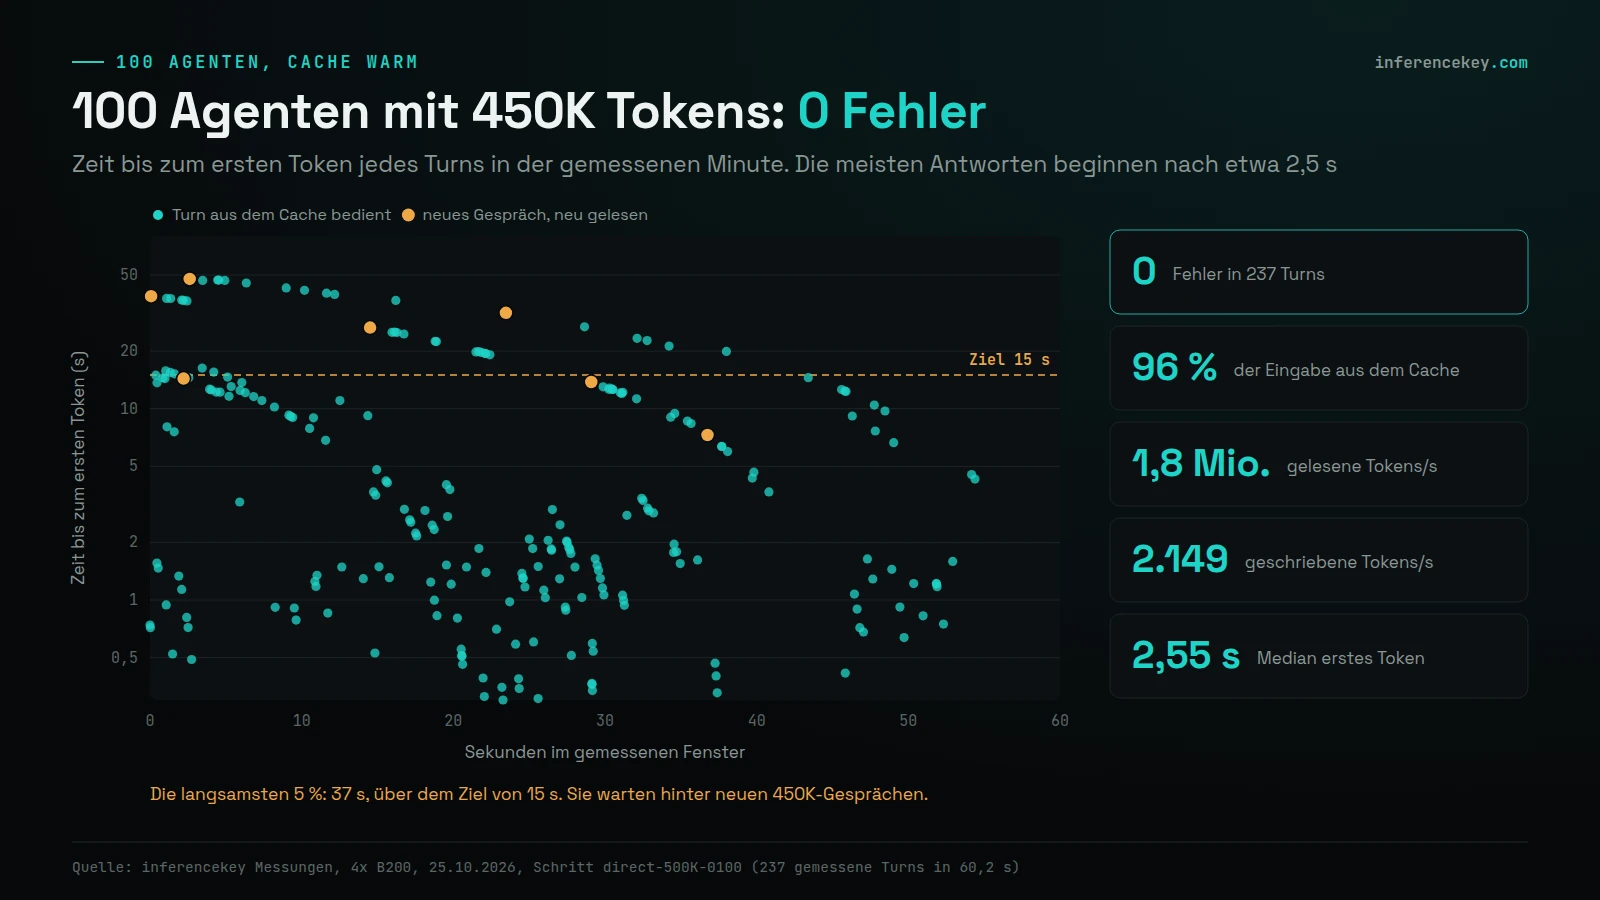
100 Agenten, Cache warm: 0 Fehler und Antworten, die in etwa 2,5 s beginnen. Die langsamsten 5 % warten hinter neuen 450K-Gesprächen und verfehlen das 15-s-Ziel.
Jetzt der Teil, der nicht bestanden hat. Unsere Latte ist streng: 95 % der Turns müssen innerhalb von 15 Sekunden mit der Antwort beginnen. Nur 2 unserer 8 Testläufe haben das geschafft. Alle 8 hatten null Fehler. In diesem Lauf begannen 83 % der Turns, deren Gespräch schon im Regal lag, innerhalb von 15 Sekunden. Die langsamsten 5 % warteten 37 Sekunden oder länger, also hat der Lauf nicht bestanden. In dieser Minute kamen sieben brandneue Gespräche an, und jedes musste seine vollen 450.000 Tokens von vorn lesen. Die wartenden Turns standen hinter ihnen in der Schlange, wie eine Band, die wartet, bis die vorige ihr ganzes Equipment abgebaut hat. Turns, die schon im Regal liegen, Vorrang zu geben oder zu begrenzen, wie viele neue Gespräche gleichzeitig starten, würde wahrscheinlich helfen. Getestet haben wir das nicht.
Stresstest aus dem Kalten: 176 Millionen Tokens in unter 15 Minuten von Grund auf gelesen, null Fehler
Mit leerem Regal las die Maschine Gespräche von Grund auf mit gleichmäßig 200.000 Tokens pro Sekunde, ohne einen einzigen Fehler. Am 24. Oktober haben wir ihr 399 neue Gespräche mit je etwa 440.000 Tokens gegeben, 16 auf einmal, mit leerem Cache. Das ist härter als jeder echte Morgen, an dem Sessions klein anfangen.
In 14,6 Minuten waren 397 davon vollständig gelesen und antworteten: 176 Millionen Tokens. Ab dem Moment gezählt, in dem jedes eingelassen wurde, kam die erste Antwort nach etwa 14 Sekunden (Median). Ab dem Start des Tests gezählt, wartete die Hälfte mehr als sechs Minuten und das letzte fast 15. Die letzten zwei standen noch in der Schlange, als unser 15-Minuten-Limit ablief. Käme ein ganzes Team gleichzeitig mit riesigen Gesprächen, wäre die Schlange das Problem, nicht Fehler.
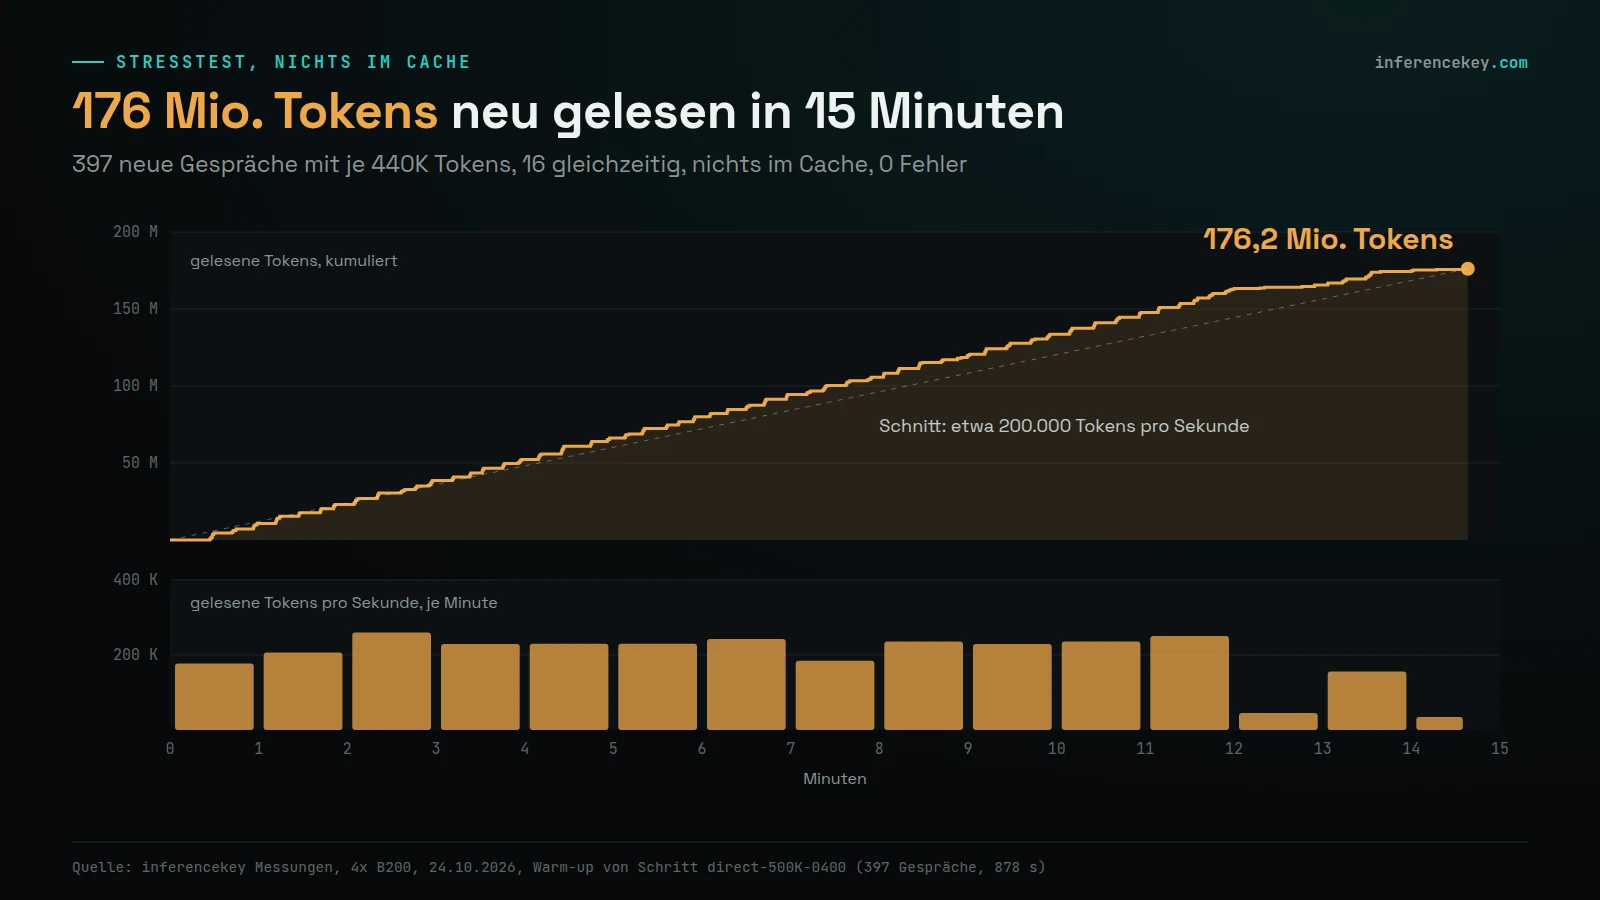
Stresstest ohne Cache-Inhalt: 397 Gespräche mit 440K Tokens, 176 M Tokens in unter 15 Minuten von Grund auf gelesen, 0 Fehler.
Im Alltag passen etwa 400 Agenten, laut einem Simulator auf Basis von 7.879 echten Turns
Alles bisher ist gemessen. Dieser Abschnitt ist modelliert, und der Unterschied zählt.
Etwa 250 Agenten passen, wenn 95 % der Antworten innerhalb von 15 Sekunden beginnen müssen, etwa 400, wenn 30 Sekunden in Ordnung sind. Bei 400 braucht eine typische Antwort etwa 21 Sekunden bis zum Start, und 1 von 20 wartet etwa 30 Sekunden oder länger.
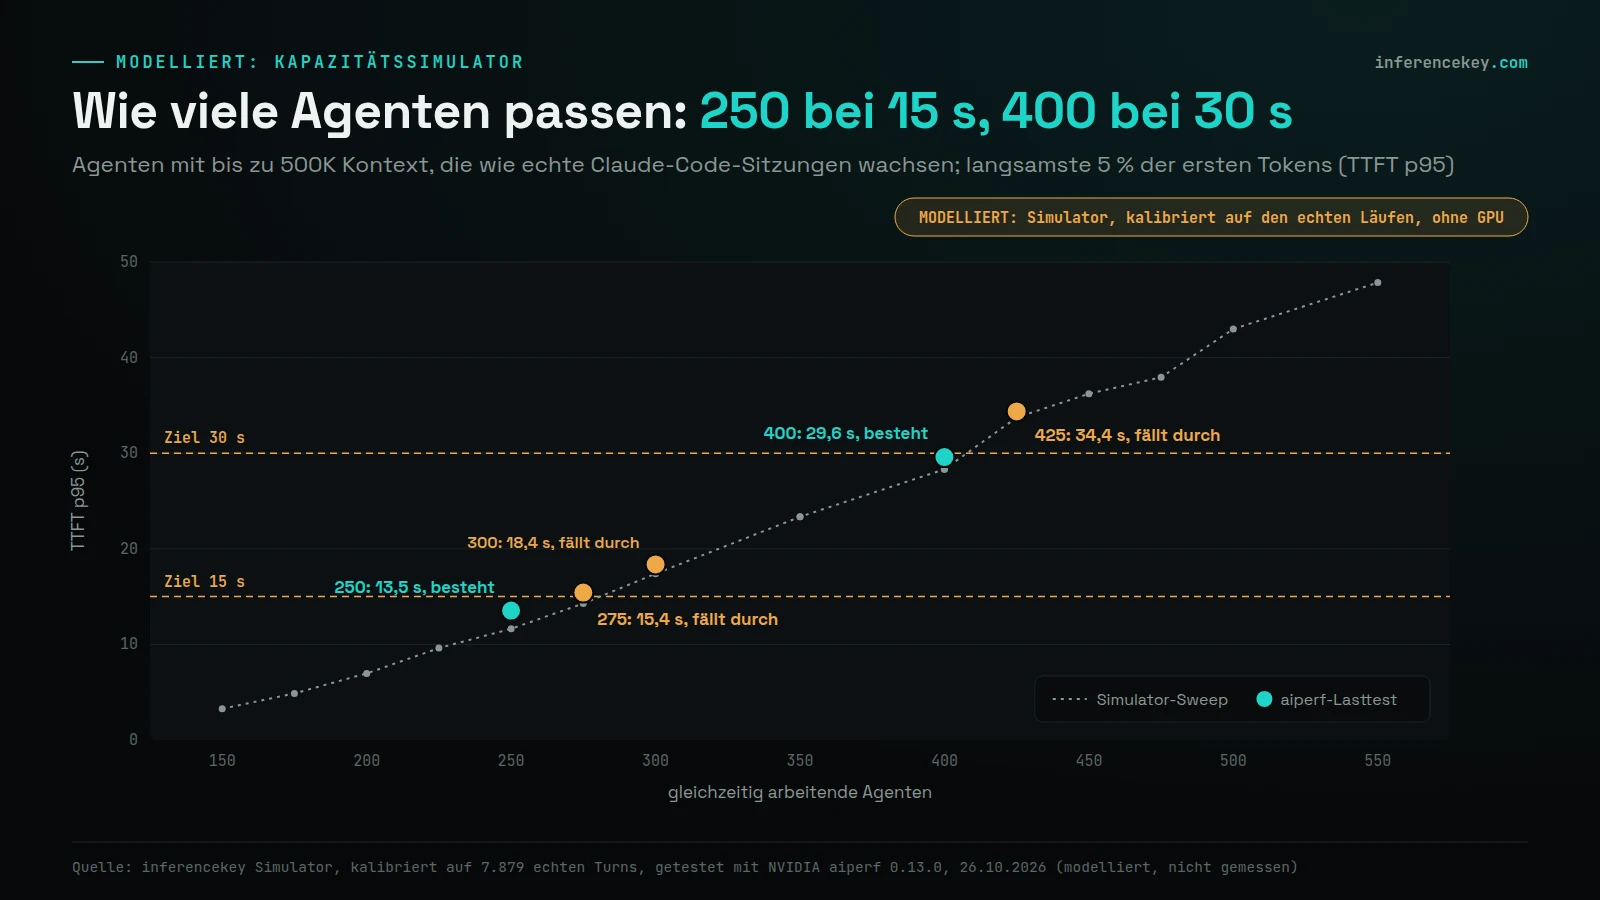
Modelliert: Ein auf 7.879 echten Turns kalibrierter Simulator schafft 250 Agenten, wenn 95 % der Antworten innerhalb von 15 s beginnen, und 400 innerhalb von 30 s.
Unsere gemessenen Tests waren absichtlich hart: Jeder Agent pausierte nur drei Sekunden zwischen den Schritten. Echte Sessions sind ruhiger, also haben wir einen Simulator dieser Maschine gebaut. Wir haben ihn mit jedem Turn aus beiden Testkampagnen kalibriert, bis er reproduzierte, was die echte Maschine tat, einschließlich ihres Bruchpunkts. Dann haben wir ihn mit 30 Tagen Claude-Code-Nutzung unseres Referenznutzers gefüttert: 140.300 Modellaufrufe mit ihren echten Pausen.
Die Maschine leistet bei 400 nicht mehr als bei 250. Sie beantwortet in beiden Fällen etwa 450 Modellaufrufe pro Minute. Mit mehr Agenten wartet jeder einfach länger und ruft seltener auf, alle 52 Sekunden statt alle 34.
200 Abos, wenn Power-User je zwei Agenten nutzen, und unter etwa 140 kostet die Maschine mehr
Die 200 im Titel beruhen auf einer Annahme: Ein Power-User nutzt zwei Agenten gleichzeitig, den ganzen Tag. Die 400 Agenten des Simulators geteilt durch zwei ergeben etwa 200 Abos.
Der Haken ist die Geschwindigkeit. Bei Claude rufen die Agenten unseres Referenznutzers das Modell im Schnitt alle 27 Sekunden auf. Bei 400 Agenten auf dieser Maschine ruft jeder alle 52 Sekunden auf. Eine Aufgabe würde fast doppelt so lange dauern.
Man kann auch strenger zählen. Unser Referenznutzer ist einer unserer sehr intensiven Nutzer. In einer durchschnittlichen Spitzenstunde ruft er das Modell etwa alle 11 Sekunden auf. Bei 450 Aufrufen pro Minute hält die Maschine etwa 80 Leute wie ihn auf voller Geschwindigkeit. Die Maschine kostet erst ab etwa 140 Abos weniger als Claude-Max-20x-Abos. Bei der strengeren Zählung von 80 kostet sie 27.900 USD pro Monat gegenüber 16.000 für Abos, rund 75 % mehr.
Unser Referenznutzer ist allerdings nicht typisch. Neben seinen eigenen Sessions betreibt er autonome Agenten für Workflows und Geschäftsaufgaben, also belastet ein gewöhnlicher Claude-Max-Nutzer die Maschine weniger. Die Claude-Code-Logs deines Teams zeigen dir, wo ihr steht.
Etwa 0,006 USD pro Million Tokens, 80-mal weniger als die Claude API
Der andere Vergleich ist die API. Der echte Claude-Code-Monat unseres Referenznutzers, zu den Listenpreisen der Claude API bepreist, kam auf 12.365 USD für 26,2 Milliarden Tokens, also 0,47 USD pro Million. Die Maschine ist pro gelesenem Token etwa 80-mal günstiger. Das beruht auf den 1,8 Millionen Tokens pro Sekunde aus einer ausgelasteten Minute unseres härtesten Tests, gestreckt auf alle 730 Stunden eines Monats, also sieh es als besten Fall.
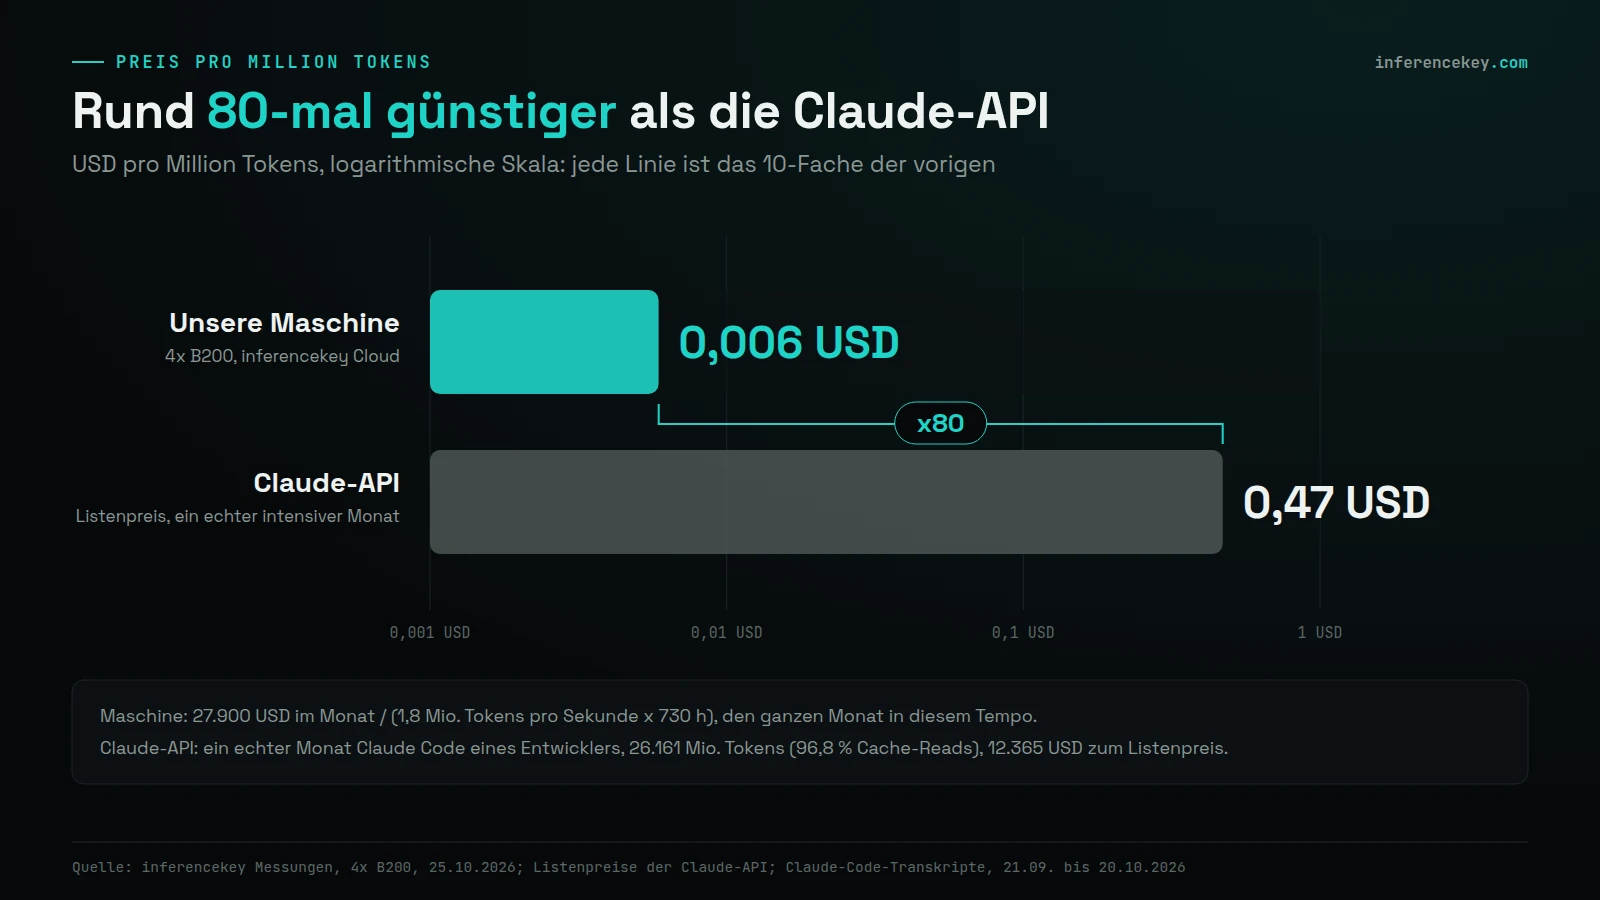
27.900 USD pro Monat bei 1,8 M Tokens pro Sekunde sind etwa 0,006 USD pro Million Tokens. Das ist rund 80-mal weniger als ein echter intensiver Monat auf der Claude API.
Der Vergleich ist fair, weil beide Seiten vor allem erneut lesen: 96 % aus dem Cache in unserem Test, 96,8 % im echten Claude-Monat. Ein Team, das nachts schläft, zahlt mehr pro nützlichem Token. Die 30 % und das 80-fache beantworten verschiedene Fragen, also multipliziere sie nicht.
Qualität: Platz eins bei LiveBench Agentic Coding, und Antworten aus dem Cache stimmen mit frischen überein
In einem externen Coding-Benchmark liegt DeepSeek V4.1 Flash auf Platz eins. LiveBench hat eine Kategorie Agentic Coding, in der ein Modell eine echte Programmieraufgabe Schritt für Schritt erledigen muss. Am 10. Oktober erreichte DeepSeek V4.1 Flash 77,3 und lag auf Platz eins von 69 Modellen. Claude Opus 5.5 erreichte 71,7. Diesen Benchmark haben wir nicht selbst ausgeführt.
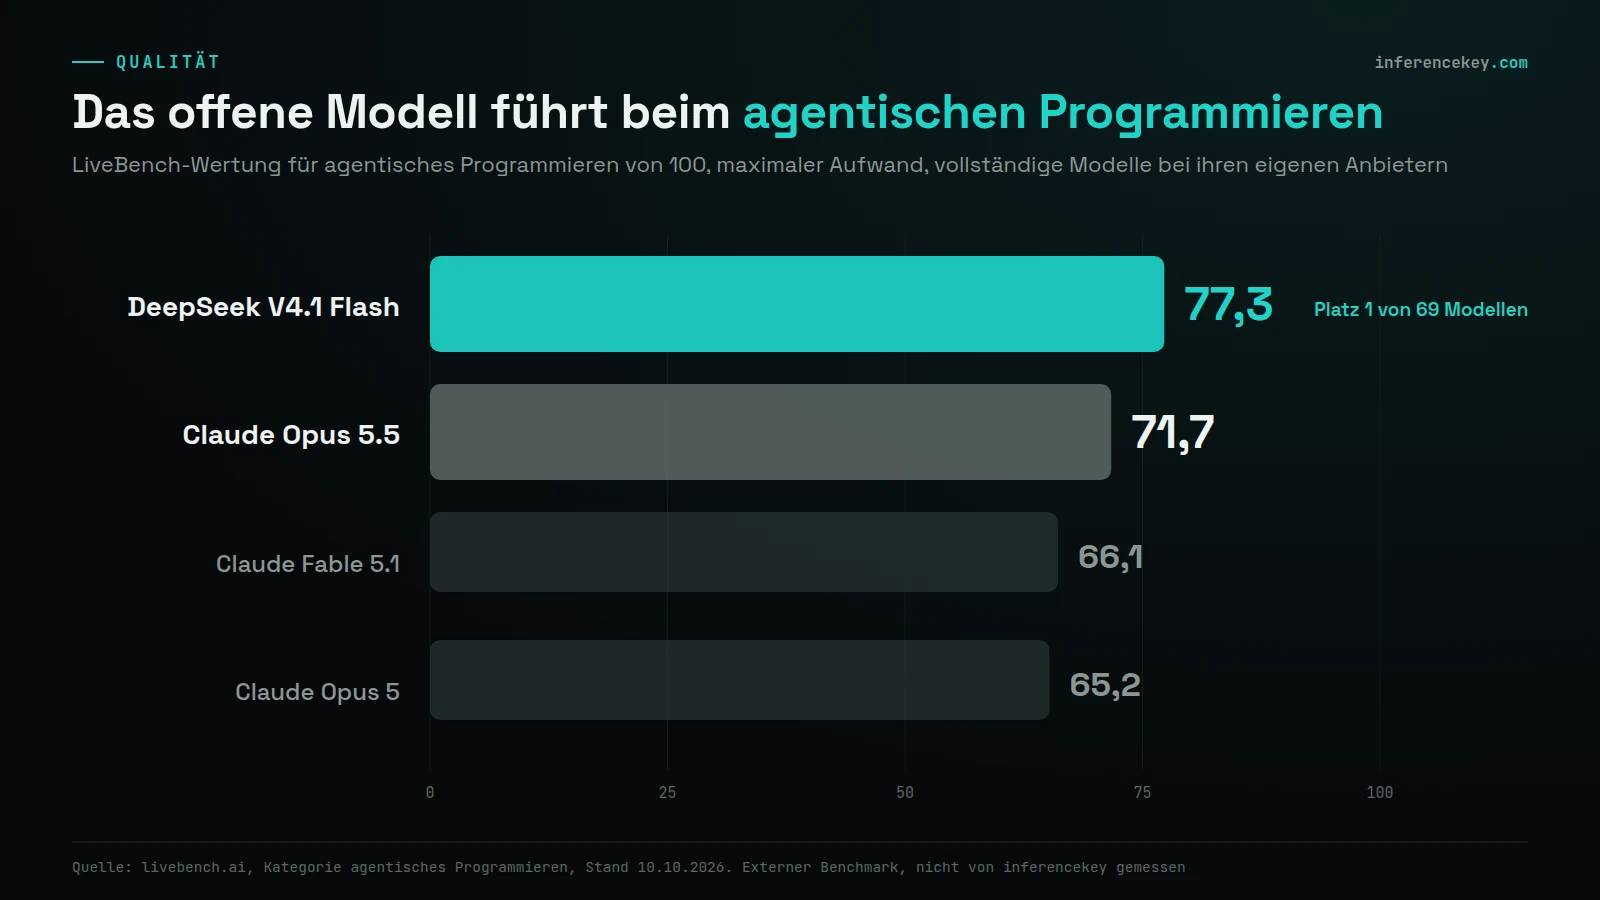
LiveBench Agentic Coding (livebench.ai, 10.10.2026): DeepSeek V4.1 Flash 77,3 gegen Claude Opus 5.5 71,7. Externer Benchmark, nicht von uns gemessen.
Ein breiterer Index von Artificial Analysis zeigt in die andere Richtung: Opus 5.5 kommt auf 58, Flash auf 39. Für ein Team, das von Opus wechselt, ist diese Lücke der ehrliche Vorbehalt, also teste Flash mit deinen eigenen Aufgaben, bevor du umsteigst.
Unsere eigene Prüfung ist, dass das Regal die Antworten nicht verändert. Wir haben eine Tatsache in einem langen Dokument versteckt, bis zu 200.000 Tokens, und zweimal danach gefragt: einmal von Grund auf gelesen, einmal aus dem Cache bedient. Fünf von fünf Dokumenten lieferten auf beiden Wegen dieselbe richtige Antwort. Die Cache-Version antwortete in unter einer Sekunde. Das Dokument mit 200.000 Tokens brauchte von Grund auf gelesen 13 Sekunden.
Diese Prüfung hat ihren Platz verdient. Eine frühere Version unseres Adapters bediente gar nichts aus dem Cache, und diese Prüfung hat das erwischt, bevor ein Lasttest lief. Wir haben es behoben, und die korrigierte Version bediente Wiederholungen zu 95 bis 99 % aus dem Cache. Jede gemessene Zahl in diesem Beitrag stammt von ihr.
Dein Code geht dorthin, wo du entscheidest
Mit Claude oder mit DeepSeeks API landen dein Code und die Daten, die er berührt, bei einem Modellanbieter. Mit inferencekey auf deinen eigenen GPUs verlässt er nie dein Netzwerk. Mit der inferencekey Cloud, in der diese Tests liefen, geht er an unsere GPUs, nicht an Anthropic oder OpenAI. In beiden Fällen bleiben die API-Keys auf deiner Seite, in deinem Netzwerk. Wenn einer leakt, rotierst du ihn dort. Preis und Tests hier gelten für die inferencekey Cloud. Den On-Premise-Fall haben wir weder bepreist noch getestet.
200 Agenten mit 500K überlaufen den schnellen Boden, also sind etwa 120 die Obergrenze bei dieser Größe
Bei Gesprächen mit 500.000 Tokens ist der schnelle Boden die Obergrenze. Mit 200 Agenten, die alle gleichzeitig fragten, passten ihre Gespräche nicht in den Speicher der Grafikkarten. Der Lauf brach ein: Die Hälfte der Antworten brauchte über zwei Minuten bis zum Start. Nichts ging verloren und nichts schlug fehl, aber es war unbrauchbar. Bei diesem harten Tempo lassen sich etwa 120 Gespräche dieser Größe gleichzeitig bedienen.
Die meisten Tests haben die inferencekey API übersprungen und die Engine direkt aufgerufen. Der eine, der sie nutzte, hatte null Fehler, aber seine langsamsten Antworten brauchten 22 Sekunden bis zum Start, nicht 15. Es war ein einziges kurzes Fenster, also können wir noch nicht sagen, was der zusätzliche Hop bei langen Gesprächen kostet.
Lohnt sich ab etwa 140 Abos, wenn langsamere Antworten zur Spitzenzeit akzeptabel sind
Ab etwa 140 Claude-Max-20x-Abos ist eine Maschine eine feste Rechnung ohne Nutzungsgrenze pro Person. Die Obergrenze ist geteilt, etwa 400 Agenten, und du behältst Claude Code. Unter etwa 140 kosten Abos weniger. Wenn dein Code das Gebäude nicht verlassen darf, läuft dasselbe Setup auch auf deinen eigenen GPUs. Wenn du zehn Entwickler hast, sind Abos oder DeepSeeks API weiterhin die einfachere Wahl.
Selbst ausprobieren
Folge der Anleitung zu DeepInfer auf 4x B200, um DeepSeek V4.1 Flash bereitzustellen und Claude Code darauf zu richten. Du brauchst vier B200-Karten oder einen Workload in der inferencekey Cloud, und einen inferencekey API-Key. Mit den Gewichten auf der Platte war unser Workload in unter zwei Minuten bereit.
Für Ingenieure
Exakte Zahlen, Methode und Grenzen hinter der Erzählung. Alle gemessenen Läufe nutzten DeepSeek-V4.1-Flash auf DeepInfer, 4x NVIDIA B200 in der inferencekey Cloud. Datumsangaben in UTC.
Hardware und Software
| Punkt | Wert |
|---|---|
| GPUs | 4x NVIDIA B200 |
| Modell | DeepSeek-V4.1-Flash, Gewichte 476 GB, von der lokalen Container-Platte geladen |
| Engine | DeepInfer, verpackt als eigenes Python-Backend von inferencekey deepinfer-v41-flash, 4 Ranks, Expert Parallelism |
| Backend-Version | 0.3.2 für jeden gemessenen Schritt (Fix im inferencekey-SDK-Commit 66bf620) |
| GPU-KV-Pool | 57.065.472 Tokens (14,27 M pro Rank) |
| L1-Stufe im Host-RAM | 128 GiB pro Rank, 617.009.664 Tokens insgesamt |
| Maximale Modelllänge | 1.064.960 Tokens |
| Endpoint-Pfade | OpenAI /v1/chat/completions und Anthropic /v1/messages |
| Maschinen-Setup | Gewichte plus DeepInfer-Installation 5 min (b200-final) und 4 min (b200-500k), 11 min auf einer früheren Maschine |
| Workload-Deploy über inferencekey | bereit in 105 s |
Deployen und verbinden
Das Deployment nutzt das inferencekey SDK:
package_backend:deepinfer-v41-flash0.3.2, Entrypointdeepinfer_backend:DeepInferBackend, apiopenai-chat.publish_custom_backendan den Tenant.ManagementClient.ensure(WorkloadSpec(slug="deepinfer-v41-flash", model="deepseek-v4.1-flash", backend="deepinfer-v41-flash", ...))mit der Konfigurationengine=deepinfer,ep=4,CUDA_VISIBLE_DEVICES=0,1,2,3.wait_until_ready.
Der Manager stellt /endpoint/<project>/<workload>/v1/messages (Anthropic) neben /v1/chat/completions und /v1/models bereit. Die Authentifizierung ist Authorization: Bearer, mit x-api-key als Fallback. Unterschiedliche Werte in beiden Headern ergeben einen 401. /v1/messages braucht einen lokalen GPU-Chat-Workload. Claude Code hängt /v1/messages selbst an:
export ANTHROPIC_BASE_URL=https://api.inferencekey.com/endpoint/<project>/<workload>
export ANTHROPIC_AUTH_TOKEN=ik_live_...
export ANTHROPIC_MODEL=deepseek-v4.1-flash
export ANTHROPIC_DEFAULT_HAIKU_MODEL=deepseek-v4.1-flash
export ANTHROPIC_DEFAULT_SONNET_MODEL=deepseek-v4.1-flash
export ANTHROPIC_DEFAULT_OPUS_MODEL=deepseek-v4.1-flash
export CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1
claude
Smoke-Test vor der Kampagne: OpenAI-Chat, Streaming und Anthropic /v1/messages mit einem Tool antworteten korrekt (stop_reason: tool_use mit einem Read-Aufruf). Schritt für Schritt, mit dem Backend-Code, in der Anleitung in der Dokumentation.
Workload und Bestehenskriterien
Jeder Nutzer ist eine Agenten-Session, die bei der Stufengröße startet (Stufe 128K: 96.000 Tokens, kompaktiert bei 128.000. Stufe 500K: 440.000, kompaktiert bei 500.000. Stufe 1M: 940.000, kompaktiert bei 1.000.000). Neuer Input pro Turn p50 / p90 / p99 1.100 / 5.500 / 51.000 Tokens, Output p50 / p90 423 / 1.700 (gedeckelt bei 1.700), aus echten Claude-Code-Perzentilen gezogen. Denkzeit im Schnitt 3 s, Aufwärmen mit 16 Sessions gleichzeitig, Temperatur 0,6.
Ein Schritt besteht, wenn über die warmen gemessenen Turns gilt: TTFT p95 <= 15 s, tok/s pro Nutzer p50 >= 20 und p10 >= 10, Fehler <= 1 %, Cache-Treffer >= 90 %.
Alle gemessenen Schritte
| Schritt | Pfad | Ergebnis | Turns (kalt) | TTFT p50 / p95 (s) | tok/s p50 / p10 | Cache | Goodput | Fehler |
|---|---|---|---|---|---|---|---|---|
| 500K x 50 | direkt | BESTANDEN | 75 (0) | 2,47 / 4,41 | 162,9 / 99,5 | 100 % | 100 % | 0 |
| 500K x 100 | direkt | NICHT BESTANDEN (TTFT p95) | 237 (7) | 2,55 / 36,98 | 134,6 / 39,1 | 99 % | 83 % | 0 |
| 500K x 200 | direkt | NICHT BESTANDEN | 17 (0) | 151,09 / 160,74 | 26,2 / 9,2 | 41 % | 0 % | 0 |
| 128K x 300 | direkt | BESTANDEN | 521 (48) | 5,57 / 14,76 | 35,4 / 16,3 | 98 % | 91 % | 0 |
| 128K x 350 | direkt | NICHT BESTANDEN | 676 (85) | 7,39 / 20,98 | 22,3 / 8,4 | 98 % | 76 % | 0 |
| 128K x 400 | direkt | NICHT BESTANDEN | 652 (52) | 7,27 / 16,93 | 29,1 / 9,5 | 98 % | 80 % | 0 |
| 1M x 48 | direkt | NICHT BESTANDEN (TTFT p95) | 100 (3) | 3,64 / 28,85 | 69,4 / 22,4 | 100 % | 80 % | 0 |
| 128K x 300 | inferencekey | NICHT BESTANDEN (TTFT p95) | 479 (28) | 5,61 / 22,17 | 40,1 / 13,8 | 98 % | 83 % | 0 |
TTFT, tok/s und Cache beziehen sich auf warme gemessene Turns, deshalb zeigt 500K x 100 hier 99 % gegenüber 96,1 % über alle gemessenen Input-Tokens (kalte Turns eingeschlossen) in der Erzählung. Goodput ist der Anteil warmer Turns mit TTFT <= 15 s und tok/s >= 10. Bei 128K ist die Grenze die Rechenleistung für neuen Prefill (über etwa 100 bis 116 K neue Tokens/s steigt das erste Token an). Bei 500K ist die Grenze der GPU-KV-Speicher.
Der warme Lauf mit 100 Agenten (direct-500K-0100-01, 25.10.2026)
237 gemessene Turns (7 kalt), 0 Fehler, Fenster von 60,2 s (Start des ersten gemessenen Turns bis Ende des letzten). Input 108.173.087 Tokens, davon 103.989.632 aus dem Cache (96,1 %): 1.797.048 Input-tok/s. Output 129.332 Tokens: 2.149 tok/s. Neuer Prefill 69.499 tok/s. Warme TTFT p50 2,55 s, p95 36,98 s. Kalte TTFT im Fenster p50 26,55 s. tok/s pro Nutzer p50 134,61, p10 39,07. KV-Verhältnis 0,79. Diese Raten sind Token-Summen über das Fenster, keine Engine-Zähler. Die langsamen warmen Turns standen hinter den 7 kalten 450K-Prefills an, nicht hinter L1. Warme Turns zu priorisieren oder gleichzeitige kalte Sessions zu begrenzen, würde wahrscheinlich helfen (ungetestet). Der Simulator führt den langsamen Ausläufer auf eine Welle gleichzeitiger Kompaktierungen zurück, weil jede Session der Kampagne gemeinsam bei 440K startete.
Der kalte Stresstest (direct-500K-0400-00, 24.10.2026)
399 neue Sessions mit etwa 440K, je 16 auf einmal gestartet, nichts im Cache. 397 wurden mit 0 Fehlern fertig, bevor der Schritt max_step_s 900 s erreichte, deshalb lautet sein formales Ergebnis "warmup timeout", und er hat keine gemessene Phase. Prompt p50 440.993. Input 176.154.816 Tokens (0 aus dem Cache), Output 222.439. Fenster 878,2 s (14,64 min): etwa 200,6 K Input-tok/s. Leserate pro Minute, nach erstem Token gruppiert, 206 bis 237 K tok/s in den ersten 12 Minuten, danach fallend, während die letzten Sessions fertig werden. TTFT p50 13,72 s, p95 28,73 s, gezählt ab dem Start jeder Session nach der 16er-Warteschlange. Ab dem Start des Schritts gezählt, kamen erste Tokens im Median nach 381 s und spätestens nach 874,7 s. L1 aktiv, 58 GB pro Rank belegt, Promotions mit 4,1 GB/s. Kalter Prefill in den anderen 500K-Aufwärmphasen: 191,7 K tok/s (50 Sessions), 214,3 K (100), 244,6 K (200), kalte TTFT p50 12,5 bis 12,8 s.
Warum 500K x 200 eingebrochen ist
Etwa 50 laufende Anfragen pro Rank mit je etwa 445K Tokens sind etwa 22 M Tokens, gegenüber 14,27 M GPU-KV pro Rank. L1 hat nichts verloren (dropped = 0) und 54 bis 56 Promotion-Timeouts pro Rank protokolliert: Eine aus L1 hochgestufte Session wartete bis zu 2 s auf Platz auf der GPU und wurde dann neu berechnet. L1 hilft ruhenden Sessions, nicht Sessions, die alle gleichzeitig laufen. Bei 3 s Denkzeit sind etwa 120 Sessions mit 450K das Maximum, das gleichzeitig decodieren kann (57,1 M / 0,45 M, mit etwas Reserve).
Simulator (modelliert)
Ereignisgesteuertes Modell von DeepInfer 0.3.2 auf 4x B200: Routing mit Session-Affinität auf einen Rank, GPU-Cache 14.266.368 und L1 154.252.416 Tokens pro Rank, EP-Lockstep, Chunked Prefill, der sich Schritte mit dem Decode teilt, L1-Promotion mit 2,0 s Wartezeit und eine abgeleitete Eingangswarteschlange pro GPU. Kalibriert durch Wiedergabe aller 7.879 aufgezeichneten Turns beider Kampagnen und angepasst an die warmen gemessenen Turns von 6 direkten Schritten. Er reproduziert den Einbruch von 500K x 200 im geschlossenen Kreis (Modell etwa 200 s TTFT p50, real 151 s). Dauer des kalten Laufs 822 s modelliert gegenüber 878 s real.
Workload: 30 Tage Claude-Code-Transkripte des Referenznutzers, 140.300 Aufrufe von 3.912 Agenten. Der Kontext wächst im Mittel um 2.597 Tokens pro Aufruf (Median 1.406), mittlerer Output 663 Tokens, mittlere Pause 13,9 s (Pausen über 600 s ausgeschlossen), Kompaktierung bei 500K zurück auf etwa 43K.
NVIDIA aiperf 0.13.0 gegen den Simulator, geschlossener Kreis mit festem Zeitplan, 600 s gemessen nach 90 s Aufwärmen, ein Lauf pro Punkt:
| Agenten | SLO | TTFT p50 / p95 (s) | req/s | Intervall pro Agent (s) | Fehler | Ergebnis |
|---|---|---|---|---|---|---|
| 250 | 15 s | 3,68 / 13,54 | 7,428 | 33,65 | 0 | BESTANDEN |
| 275 | 15 s | 6,63 / 15,42 | 7,525 | 36,54 | 0 | NICHT BESTANDEN (knapp) |
| 300 | 15 s | 7,97 / 18,37 | 7,652 | 39,21 | 0 | NICHT BESTANDEN |
| 400 | 30 s | 20,82 / 29,59 | 7,632 | 52,41 | 0 | BESTANDEN |
| 425 | 30 s | 22,63 / 34,37 | 7,613 | 55,82 | 0 | NICHT BESTANDEN |
Der Durchsatz sättigt sich bei etwa 7,5 req/s, unabhängig vom SLO.
Von Agenten zu Abos (aus Modelliertem abgeleitet)
- Etwa 200: 400 Agenten (TTFT p95 <= 30 s) / 2 gleichzeitige Agenten pro Power-User, den ganzen Tag (unsere Annahme). Jeder Agent ruft alle 52 s auf, gegenüber 27 s bei Claude für den Referenznutzer.
- Etwa 80: 7,5 req/s / 0,092 Aufrufe/s, die mittlere Aufrufrate des Referenznutzers in der Spitzenstunde. Gleich für beide SLOs.
- Andere Zählungen: etwa 170 mit den 2,3 aktiven Agenten des Referenznutzers zur Spitzenzeit (400 / 2,3), etwa 140 mit seinem Monatsmittel von 0,054 Aufrufen/s (für die Dimensionierung nicht gültig), etwa 38, wenn alle gleichzeitig in ihrer stärksten Stunde sind (0,198 Aufrufe/s).
- Der Referenznutzer umfasst autonome Agenten, also belastet ein typischer Claude-Max-Nutzer die Maschine weniger. Die Aufrufraten stammen aus unserer internen Analyse seiner Transkripte. Kein gespeichertes Skript reproduziert sie, die Division geht aber auf.
Kosten (abgeleitet)
- Maschine: 27.900 USD pro Monat, öffentlicher Preis der 4x-B200-Maschine in der inferencekey Cloud.
- Abos: 200 x 200 USD (Claude Max 20x) = 40.000 USD. 1 - 27.900 / 40.000 = 30,25 %, 12.100 USD weniger pro Monat. Break-even gegenüber Max 20x bei 27.900 / 200 = etwa 140 Abos. Bei der strengeren Zählung von 80: 16.000 USD für Abos, also kostet die Maschine rund 75 % mehr.
- Pro Million Input-Tokens: 27.900 / (1,8 M x 3.600 x 730 / 1e6) = 0,0059 USD, etwa 0,006, bei voller Auslastung über 730 h. Das bepreist nur Input-Tokens, mit einem cache-lastigen Mix (hier 96,1 %, 96,8 % Cache-Reads im echten Claude-Monat).
- Claude API, der Monat eines sehr intensiven Entwicklers (21.09.2026 bis 20.10.2026): 12.365 USD / 26.161 M Tokens = 0,47 USD pro Million. 0,47 / 0,006 = etwa 80-fach. Das ist ein anderes 30-Tage-Fenster als der Referenzmonat des Simulators, derselbe Nutzer.
- DeepSeek API, derselbe Monat: 274 USD, etwa 0,0105 USD pro Million, fast das Doppelte unserer Maschine. Es ist die günstige gehostete Option, aber der Code geht weiterhin an einen Modellanbieter.
- Die 30 % (gegenüber Abos) und das 80-fache (pro Token, gegenüber der API) beantworten verschiedene Fragen. Kombiniere sie nicht.
Qualität
- Quality Gate (
quality_check.py): eine Tatsache in Fülltext in einer bestimmten Tiefe versteckt, kalt und dann aus dem Prefix-Cache bei Temperatur 0 gesendet. Lauf 3 (25.10.2026, Backend 0.3.2):
| Fall | Prompt-Tokens | Tokens aus dem Cache | Kalt (s) | Aus dem Cache (s) | Antwort |
|---|---|---|---|---|---|
| 16K, Fakt bei 50 % | 15.570 | 15.232 | 1,25 | 0,79 | stimmt überein |
| 64K, Fakt bei 10 % | 63.767 | 63.488 | 3,93 | 0,78 | stimmt überein |
| 64K, Fakt bei 50 % | 63.667 | 63.360 | 4,31 | 0,80 | stimmt überein |
| 64K, Fakt bei 90 % | 63.715 | 63.360 | 3,91 | 0,79 | stimmt überein |
| 200K, Fakt bei 30 % | 200.542 | 200.192 | 12,97 | 0,80 | stimmt überein |
Lauf 2 (24.10.2026, 0.3.2) bestand ebenfalls 5/5. Das Gate prüft nur das Wiederfinden des Fakts, nicht die Coding-Qualität. Die Gleichwertigkeit der Antworten mit L1 wurde nur mit synthetischen Gewichten in einem 1x-B200-Test geprüft.
- Backend 0.3.1 bediente auf 4 Ranks 0 Tokens aus dem Cache: Die Rank-Schleife rief
cache.forget()beim letzten Output auf, DeepInfer finalisiert die Sequenz aber einen Schritt später. Behoben im SDK-Commit66bf620(output_finishedplus Aufräumen nach 30 s), ausgeliefert als 0.3.2, das Wiederholungen zu 95 bis 99 % aus dem Cache bediente. - LiveBench Agentic Coding (10.10.2026, maximaler Aufwand, vollständige Modelle bei ihren eigenen Anbietern): DeepSeek-V4.1-Flash 77,3 (Platz 1 von 69), Claude Opus 5.5 71,7, Claude Fable 5.1 66,1, Claude Opus 5 65,2. Artificial Analysis Intelligence Index (16.10.2026): Opus 5.5 58, Flash 39. Zitiert aus unserem Beitrag vom 20.10.2026, nicht erneut geprüft.
Claude-Code-Aufgabe (24.10.2026)
Claude Code 2.1.310, unverändert, ANTHROPIC_BASE_URL auf den Endpoint, Modell deepseek-v4.1-flash. Aufgabe: parse_duration in durations.py implementieren, sodass test_durations.py durchläuft. 15/15 Tests, 39 s Gesamtzeit, 37,3 s innerhalb von Claude Code (API-Zeit 32,0 s, erstes Token 2,6 s). 14 Tool-Aufrufe (Read 7, Bash 4, Edit 2, Write 1, ein Bash-Aufruf durch Berechtigungen abgelehnt), 15 Turns, 22.117 Input-, 173.696 Cache-Read- und 3.549 Output-Tokens. Die Claude-Code-Szene im Video ist die echte App, gefilmt bei derselben Aufgabe, gegen einen lokalen Anthropic-Messages-Server, der die in dieser Session aufgezeichneten Modellantworten zurückstreamt, während die Tools wirklich laufen.
Grenzen
- Jeder gemessene Schritt nutzte eine mittlere Denkzeit von 3 s, sodass fast jeder Agent gleichzeitig aktiv war. Das sind Worst-Case-Agentenlasten, kein menschliches Tempo. Kein Lauf in menschlichem Tempo wurde gemessen, also ist der Nutzen von L1 für ruhende Sessions ungemessen.
- Durchsatzzahlen sind Token-Summen über kurze Fenster (22 bis 175 s), keine Engine-Zähler. Der kalte Lauf hat nur das Aufwärmen abgeschlossen, also ist seine Rate eine Prefill-Rate.
- Der Pfad über das inferencekey Gateway hatte einen Bestätigungsschritt (128K x 300: TTFT p95 22,17 s gegenüber 14,76 s direkt), 479 Turns in einem 59-s-Fenster. Sein Overhead auf die Latenz bei langem Kontext ist nicht ermittelt. Die 1M-Stufe lief nicht über das Gateway (sie braucht
max_model_len1.068.000, über den konfigurierten 1.064.960). - Alle Agenten- und Abozahlen sind modelliert. Die Eingangswarteschlange des Simulators ist abgeleitet und setzt die Obergrenze von etwa 7,5 req/s. Die Decode-Geschwindigkeit im Modell ist bei 128K und 500K pessimistisch und bei 1M optimistisch, und sie unterschätzt den langsamen Ausläufer (p95 im geschlossenen Kreis 5,90 s gegenüber 36,98 s real bei 500K x 100). Sein simulierter Kontext liegt im Schnitt bei etwa 270K pro Aufruf gegenüber etwa 200K beim Referenznutzer. Ein aiperf-Lauf pro Punkt, keine Konfidenzintervalle.
- Der Preis pro Million setzt 730 h volle Auslastung voraus und deckt nur Input-Tokens ab.
- Die Claude-Code-Aufgabe ist eine kleine Aufgabe, kein Benchmark. Die Coding-Qualität auf deiner Codebasis wurde nicht gemessen.
- Nicht gemessen: 500K x 300 (während des Aufwärmens gestoppt), 1M x 36 (ausgelassen).
Quellen
Interne Engineering-Dokumentation docs/deepinfer-4xb200/ im inferencekey Repository (README.md, real-tests.md, simulation.md, cost-and-quality.md, methodology.md, data/). Rohdateien der Schritte der Kampagnen b200-final und b200-500k, aus denen wir die Zahlen für 100 Agenten und den kalten Lauf neu berechnet haben. Simulator-Ausgaben rehearsal/sim500k/runs/aiperf_results.json (15-s-SLO) und rehearsal/sim500k/runs/aiperf_results_ttft30.json (30-s-SLO). DeepInfer (Apache 2.0). LiveBench. Artificial Analysis. Claude-Preise. Unser früherer Beitrag dazu, was ein Monat Coding-Agent kostet.