Con dos agentes por usuario intensivo, una máquina 4x B200 asume la carga de Claude Code de unas 200 suscripciones por un 30 % menos
DeepInfer y la caché de inferencekey en 4x B200: 100 agentes con 450K tokens, la mitad de las respuestas en 2,5 s, 0 errores, un 30 % menos que suscripciones.
¿Puede una sola máquina hacer el trabajo de Claude Code de 200 suscripciones? Medimos 100 agentes. Los 200 salen de un modelo construido sobre esas pruebas. Un servidor con cuatro tarjetas gráficas NVIDIA B200 en la nube de inferencekey corrió DeepSeek V4.1 Flash sobre DeepInfer, el motor que DeepSeek publicó como código abierto en octubre. Le añadimos la pieza con la que el motor no viene: una caché. Cien agentes sintéticos, dimensionados como sesiones reales de Claude Code, trabajaron a la vez, cada uno con casi medio millón de tokens de conversación encima. La mitad de sus respuestas empezó en unos 2,5 segundos y no falló ni una sola petición. Un simulador calibrado con esas pruebas sitúa la máquina en unos 400 agentes a la vez. Si vuestros usuarios intensivos usan dos agentes cada uno, eso es la carga de unas 200 suscripciones, por un 30 % menos.
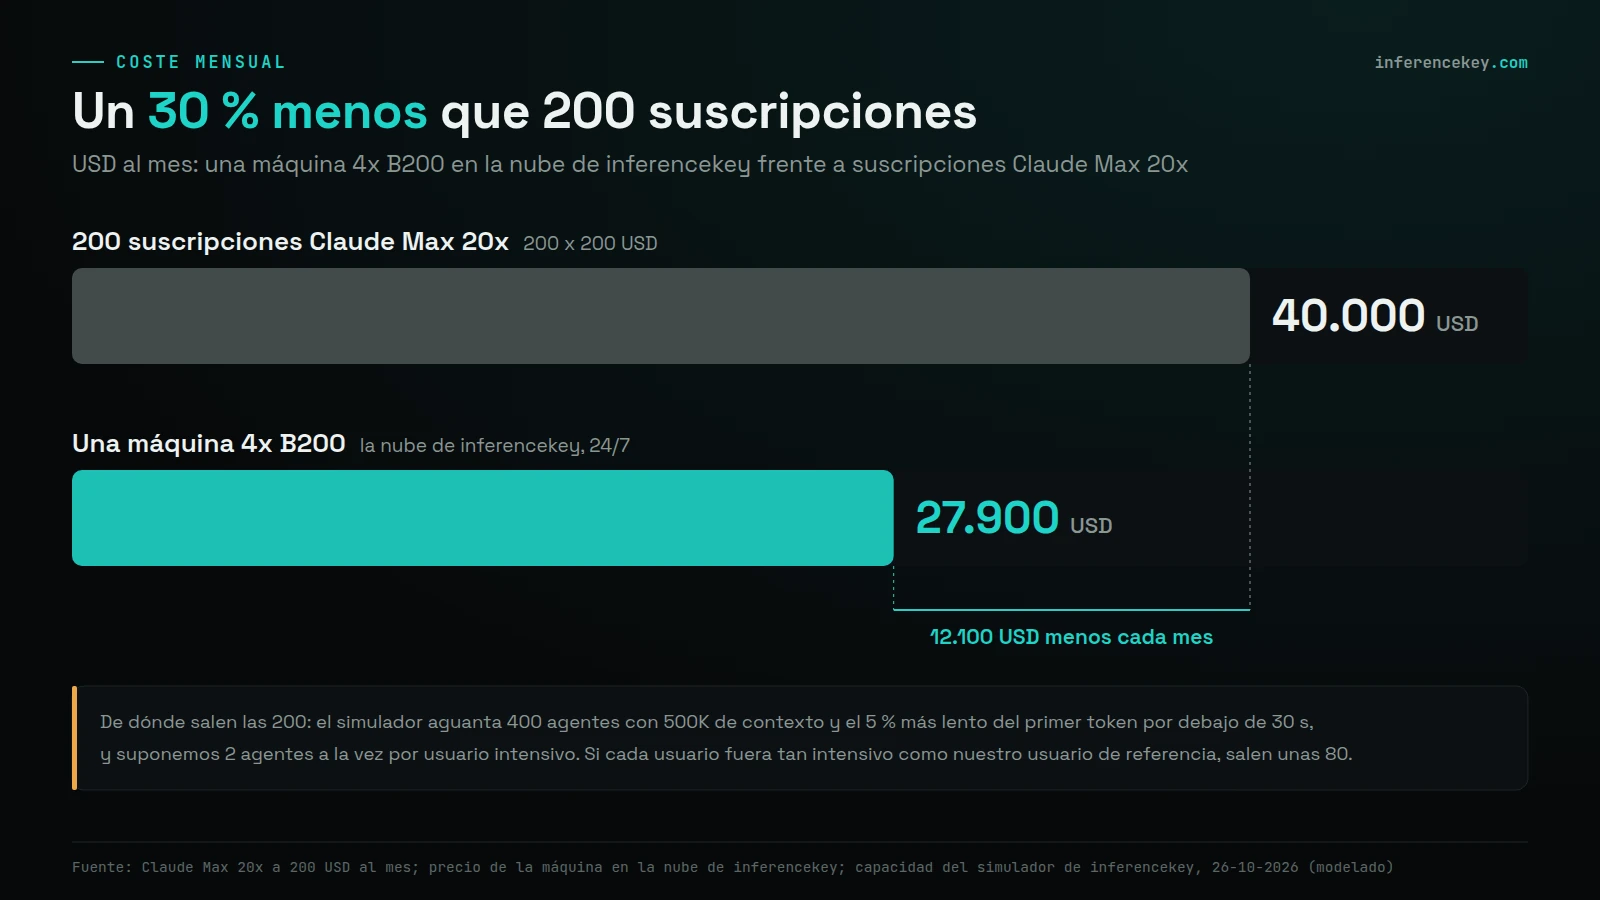
Las 200 suscripciones suponen 2 agentes a la vez por usuario intensivo (400 agentes, modelado). Si todos los usuarios fueran tan intensivos como nuestro usuario de referencia, el simulador da unas 80.
| 200 suscripciones de Claude Max 20x | 40.000 USD al mes |
| Una máquina 4x B200 en la nube de inferencekey | 27.900 USD al mes, un 30 % menos |
| Punto de equilibrio frente a Claude Max 20x | unas 140 suscripciones |
| Medido: 100 agentes con unos 450K tokens cada uno | la mitad de las respuestas empieza en 2,55 s, 0 errores |
| Medido: tokens leídos por segundo con la caché | unos 1,8 millones, el 96 % desde la caché |
| Medido: 397 conversaciones nuevas de 440K, nada en caché, lanzadas de 16 en 16 | 176 millones de tokens leídos en menos de 15 minutos, 0 errores |
| Modelado: agentes a la vez con el 5 % más lento empezando en 30 s | unos 400 |
| Precio por millón de tokens leídos | unos 0,006 USD, unas 80 veces menos que la API de Claude |
| Cambios necesarios en Claude Code | ninguno, unas pocas variables de entorno (endpoint, clave, nombre del modelo) |
Un agente de código sobre todo relee, y la caché hace que releer salga casi gratis
Cada vez que Claude Code da un paso (abrir un fichero, ejecutar un test, editar una línea), le manda al modelo la conversación entera otra vez. En nuestras pruebas esa conversación rondaba los 450.000 tokens, más o menos un libro de 1.300 páginas. El modelo escribe unos cientos de tokens de respuesta y, en el paso siguiente, el agente vuelve a mandar el libro entero, más una página nueva.
En nuestro último artículo de research medimos a un desarrollador muy intensivo durante un mes y vimos lo mismo: el 96,8 % de lo que leía su agente era material que ya había leído. Imaginad una estantería al lado del modelo. Lo que ha leído una vez se queda en la estantería y, la próxima vez, lo coge ya listo en lugar de volver a leerlo.
DeepInfer viene sin esa estantería. La propia página del proyecto de DeepSeek pone la caché entre las piezas que tenéis que construir vosotros. Sin ella, nuestra máquina leía menos de medio libro por segundo, cada conversación desde cero. Con la caché de inferencekey, leía cuatro libros por segundo. La factura de los agentes de código es sobre todo una factura por releer, y quien tiene la estantería pone el precio.
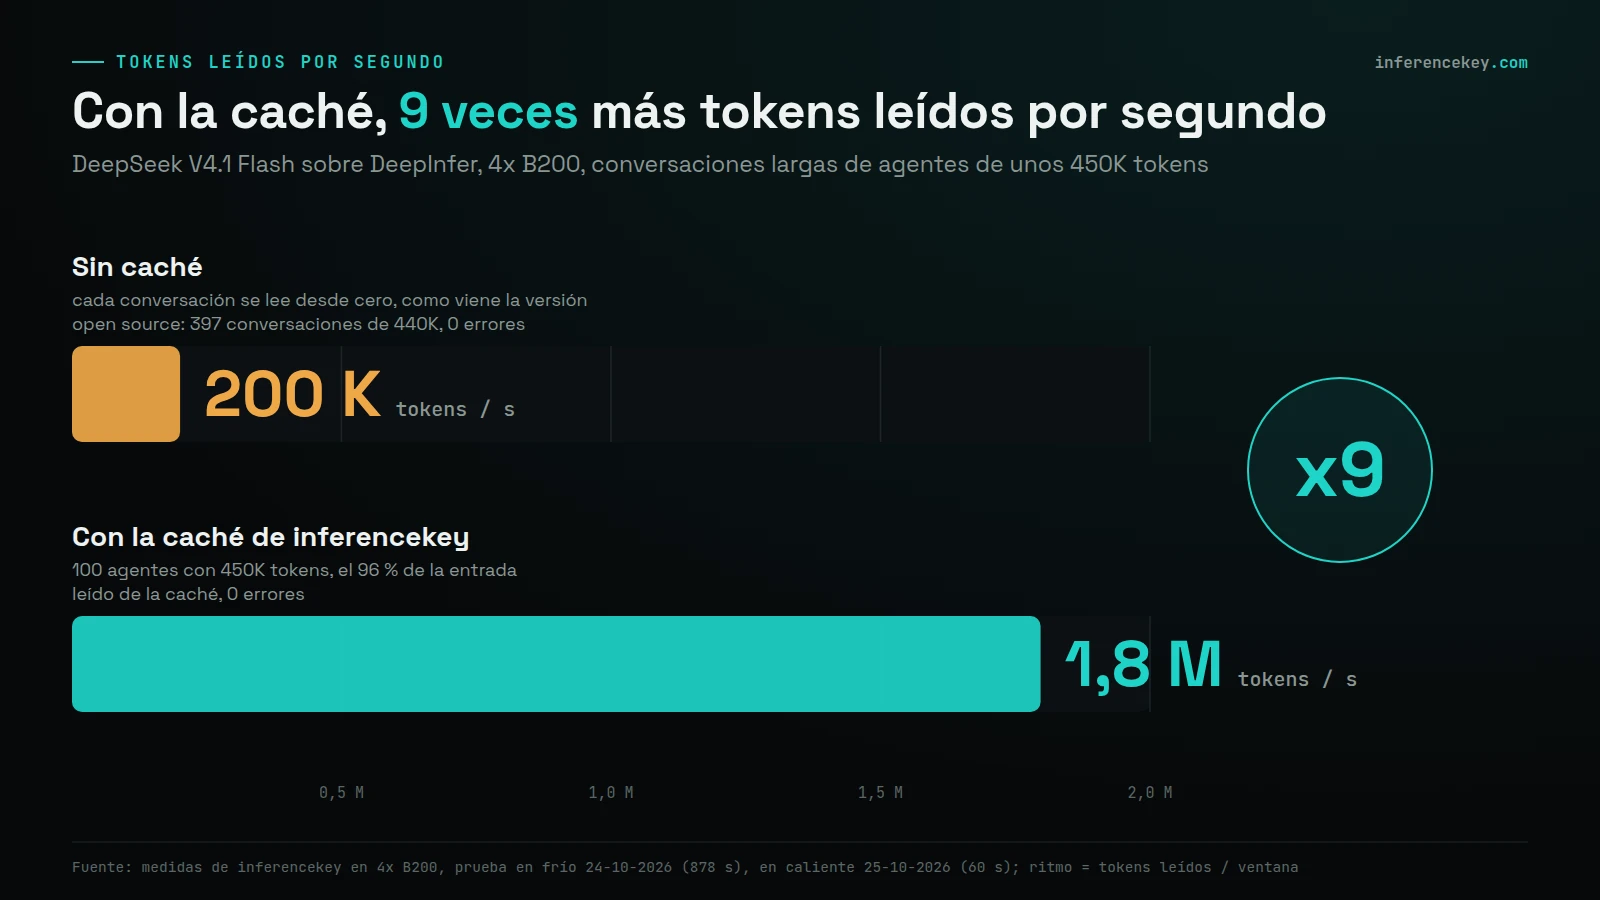
Misma máquina, mismo modelo: la caché convierte unos 200 K tokens leídos por segundo en unos 1,8 M.
Claude Code solo necesita unas pocas variables de entorno, y terminó una tarea real en 39 segundos
Unas pocas variables de entorno le dicen a Claude Code adónde mandar sus peticiones, qué clave usar y qué modelo pedir. Apuntadlas a vuestro endpoint de inferencekey y hablará con DeepSeek V4.1 Flash en lugar de con Anthropic, con los mismos comandos y las mismas herramientas.
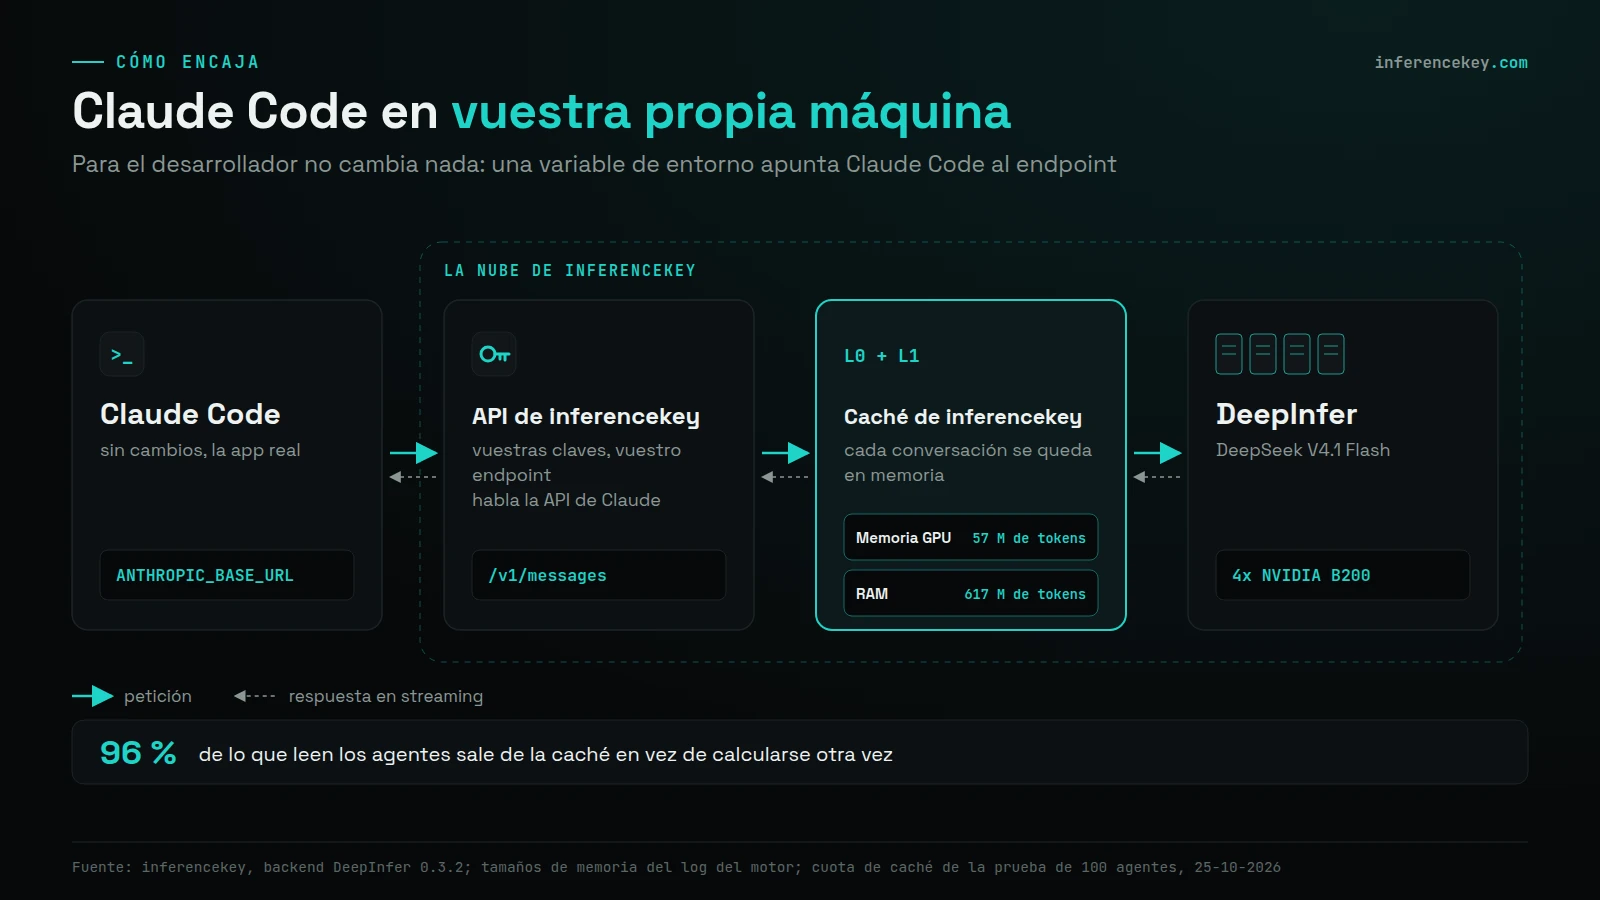
Las variables de entorno apuntan Claude Code a vuestro endpoint. La caché de inferencekey guarda cada conversación en memoria de GPU y en RAM.
La estantería tiene dos baldas. La rápida vive en la propia memoria de las tarjetas gráficas y guarda unos 57 millones de tokens, más o menos 120 conversaciones de nuestro tamaño. Detrás hay una segunda balda en la memoria normal del servidor, unas diez veces más grande, con 617 millones de tokens, para las conversaciones que se han quedado quietas un momento.
El 24 de octubre, Claude Code 2.1.310 configurado así terminó una tarea real pequeña en 39 segundos. La tarea era implementar una función llamada parse_duration para que pase un fichero de 15 tests. El agente hizo 14 llamadas a herramientas (leer ficheros, ejecutar los tests, editar el código) y pasaron los 15 tests.
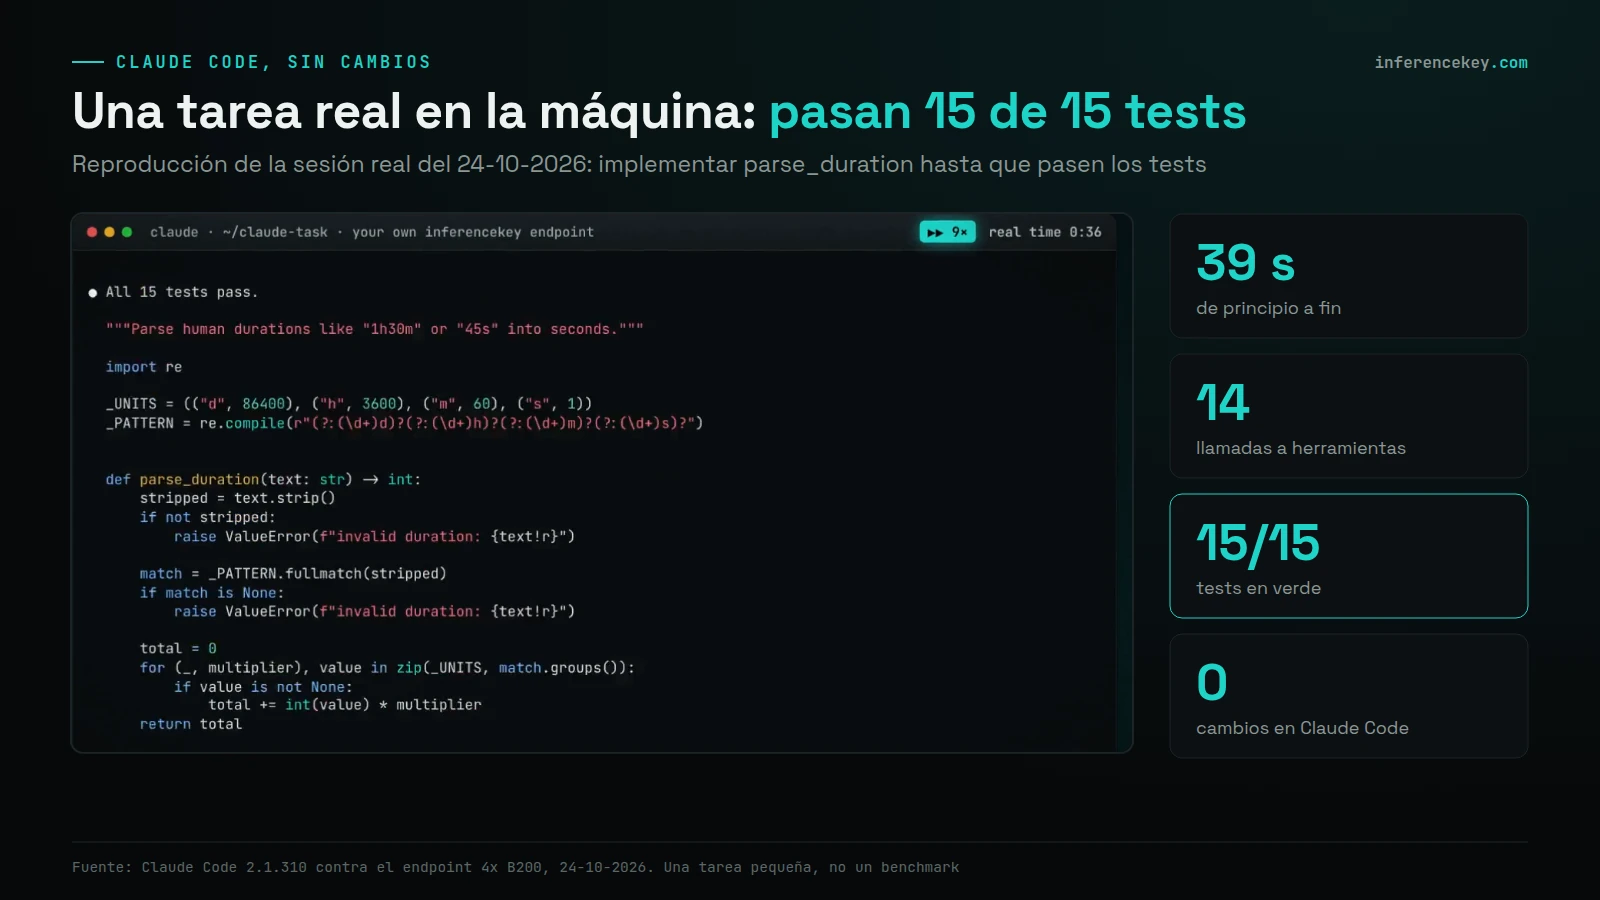
Claude Code 2.1.310, sin cambios, en nuestro endpoint: una tarea real hecha en 39 s con 14 llamadas a herramientas y 15 de 15 tests en verde. Una tarea pequeña, no un benchmark.
La escena del vídeo de arriba es la aplicación real haciendo esa tarea otra vez, reproduciendo las respuestas del modelo grabadas ese día mientras las herramientas se ejecutan de verdad.
El mérito es compartido. El equipo de DeepSeek entrenó DeepSeek V4.1 Flash, escribió DeepInfer y lo publicó con licencia Apache 2.0. La herramienta aiperf de NVIDIA puso a prueba nuestro simulador. Claude Code, de Anthropic, corrió encima. Lo nuestro es la caché, el adaptador que permite a inferencekey correr DeepInfer, la API que habla el idioma de Claude Code con vuestras propias claves y las mediciones.
100 agentes con medio millón de tokens cada uno: la mitad de las respuestas empieza en 2,5 segundos, cero errores
Con 100 agentes a la vez, cada uno con unos 450.000 tokens ya en la estantería, la mitad de las respuestas empezó en 2,55 segundos y ninguna falló. Ese es el tamaño de una sesión larga de Claude Code a última hora del día. Lo corrimos el 25 de octubre y, en una ventana de un minuto, la máquina atendió 237 turnos de agente. La respuesta de cada agente salía a unos 135 tokens por segundo, una página en pocos segundos.
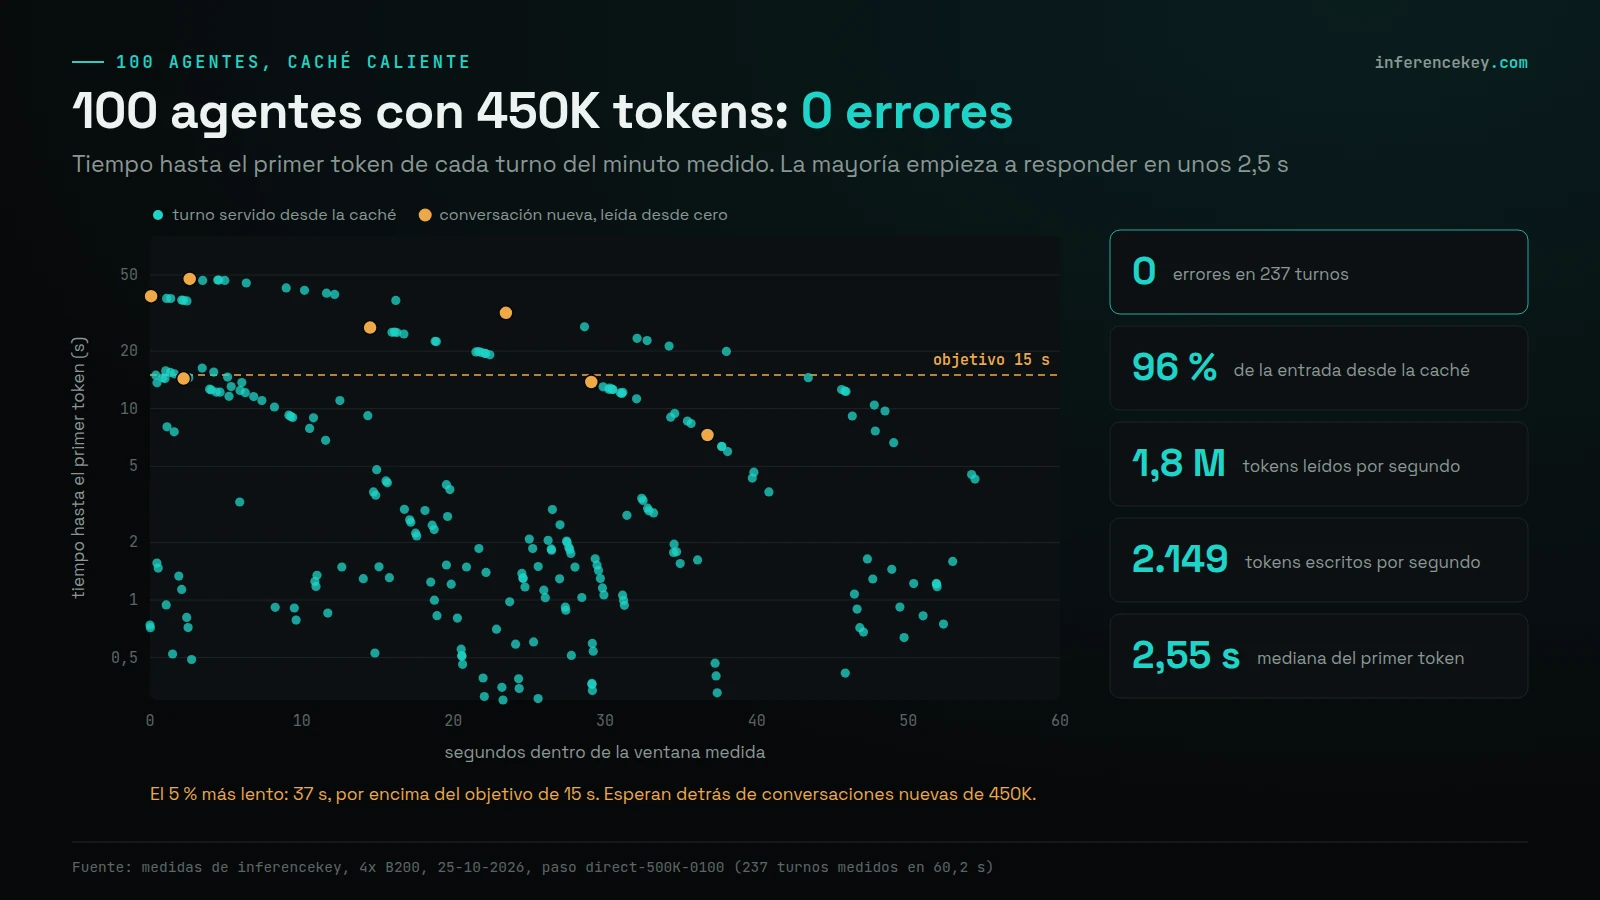
100 agentes con la caché caliente: 0 errores y respuestas que empiezan en unos 2,5 s. El 5 % más lento espera detrás de conversaciones nuevas de 450K y se pasa del objetivo de 15 s.
Ahora, la parte que no pasó. Nuestro listón es estricto: el 95 % de los turnos tiene que empezar a responder en 15 segundos. Solo 2 de nuestras 8 pruebas lo superaron. Las 8 tuvieron cero errores. En esta prueba, el 83 % de los turnos cuya conversación ya estaba en la estantería empezó en 15 segundos. El 5 % más lento esperó 37 segundos o más, así que la prueba no pasó. En ese minuto llegaron siete conversaciones nuevas, y cada una necesitaba leer desde cero sus 450.000 tokens. Los turnos en espera se quedaron en cola detrás de ellas, como un grupo esperando a que el anterior recoja todo su equipo. Dar prioridad a los turnos que ya están en la estantería, o limitar cuántas conversaciones nuevas empiezan a la vez, probablemente ayudaría. No lo hemos probado.
Prueba de estrés en frío: 176 millones de tokens leídos desde cero en menos de 15 minutos, cero errores
Sin nada en la estantería, la máquina leyó conversaciones desde cero a un ritmo constante de 200.000 tokens por segundo sin un solo error. El 24 de octubre le dimos 399 conversaciones nuevas de unos 440.000 tokens cada una, de 16 en 16, con la caché vacía. Eso es más duro que cualquier mañana real, en la que las sesiones empiezan pequeñas.
En 14,6 minutos, 397 de ellas estaban leídas enteras y respondiendo: 176 millones de tokens. Contando desde que entraba cada una, la primera respuesta tardaba unos 14 segundos (mediana). Contando desde el inicio de la prueba, la mitad esperó más de seis minutos y la última casi 15. Las dos últimas seguían en la cola cuando se agotó nuestro límite de 15 minutos. Si un equipo entero llegara a la vez con conversaciones gigantes, el problema sería la cola, no los errores.
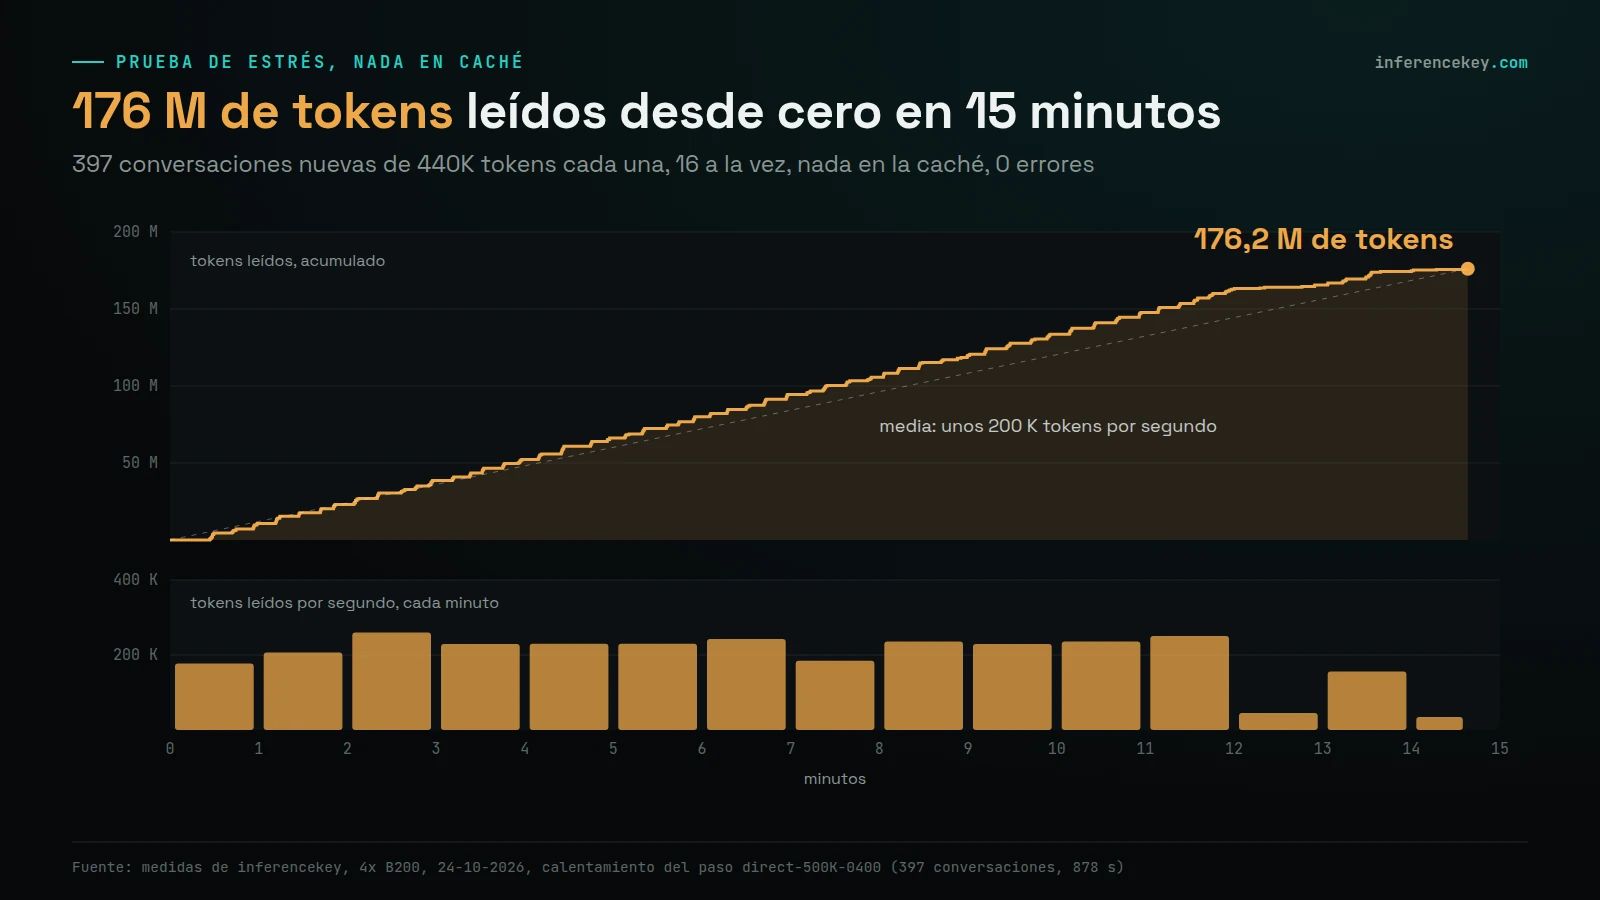
Prueba de estrés sin nada en caché: 397 conversaciones de 440K tokens, 176 M de tokens leídos desde cero en menos de 15 minutos, 0 errores.
En el día a día caben unos 400 agentes, según un simulador construido sobre 7.879 turnos reales
Todo lo anterior está medido. Esta sección está modelada, y la diferencia importa.
Caben unos 250 agentes si el 95 % de las respuestas tiene que empezar en 15 segundos, y unos 400 si valen 30 segundos. Con 400, una respuesta típica tarda unos 21 segundos en empezar, y 1 de cada 20 espera unos 30 segundos o más.
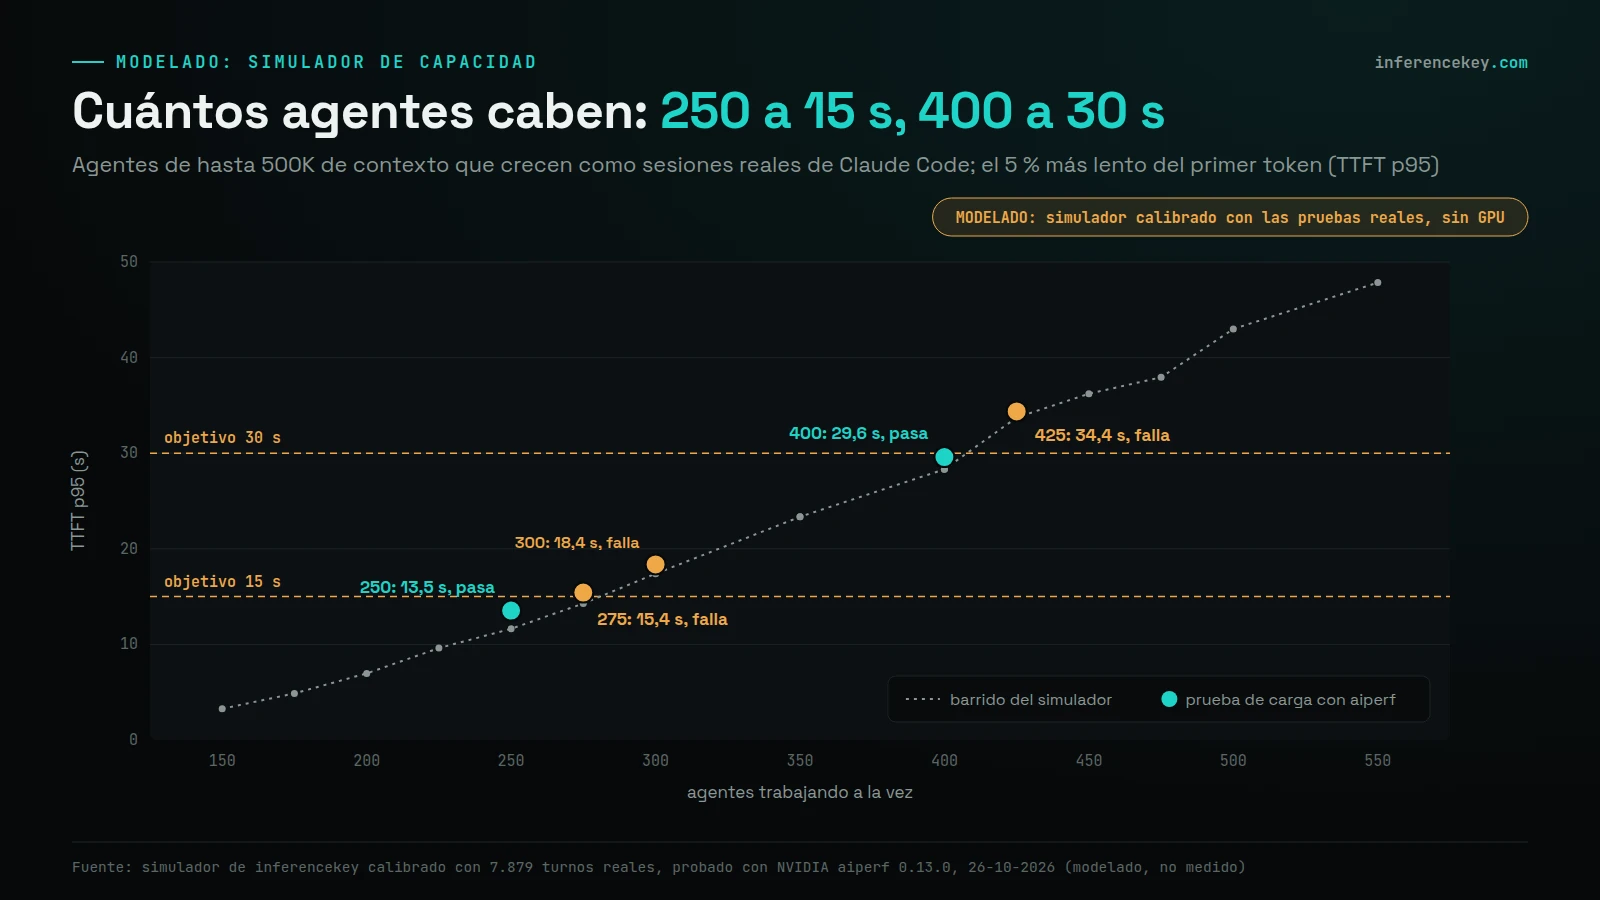
Modelado: un simulador calibrado con 7.879 turnos reales admite 250 agentes si el 95 % de las respuestas empieza en 15 s, y 400 en 30 s.
Nuestras pruebas medidas eran duras a propósito: cada agente paraba solo tres segundos entre paso y paso. Las sesiones reales son más tranquilas, así que construimos un simulador de esta máquina. Lo calibramos con todos los turnos de las dos campañas de pruebas hasta que reprodujo lo que hizo la máquina real, incluido su punto de ruptura. Después lo alimentamos con 30 días de uso de Claude Code de nuestro usuario de referencia: 140.300 llamadas al modelo, con sus pausas reales.
La máquina no hace más trabajo con 400 que con 250. Responde unas 450 llamadas al modelo por minuto en ambos casos. Con más agentes, cada uno simplemente espera más y llama menos a menudo, cada 52 segundos en lugar de cada 34.
200 suscripciones si los usuarios intensivos usan dos agentes cada uno, y por debajo de unas 140 la máquina sale más cara
Los 200 del título se apoyan en una suposición: un usuario intensivo usa dos agentes a la vez, todo el día. Los 400 agentes del simulador divididos entre dos dan unas 200 suscripciones.
La pega es la velocidad. En Claude, los agentes de nuestro usuario de referencia llaman al modelo cada 27 segundos de media. Con 400 agentes en esta máquina, cada uno llama cada 52 segundos. Una tarea tardaría casi el doble.
Hay una forma más estricta de contar. Nuestro usuario de referencia es uno de nuestros usuarios más intensivos. En una hora punta media llama al modelo más o menos cada 11 segundos. A 450 llamadas por minuto, la máquina mantiene a unas 80 personas como él a toda velocidad. La máquina solo cuesta menos que las suscripciones de Claude Max 20x por encima de unas 140 suscripciones. Con la cuenta estricta de 80, cuesta 27.900 USD al mes frente a 16.000 en suscripciones, un 75 % más.
Eso sí, nuestro usuario de referencia no es típico. Además de sus propias sesiones, corre agentes autónomos para flujos de trabajo y tareas de negocio, así que un usuario normal de Claude Max carga menos la máquina. Los logs de Claude Code de vuestro equipo os pueden decir dónde estáis.
Unos 0,006 USD por millón de tokens, 80 veces menos que la API de Claude
La otra comparación es la API. El mes real de Claude Code de nuestro usuario de referencia, a los precios de lista de la API de Claude, salió por 12.365 USD por 26.200 millones de tokens, o 0,47 USD por millón. La máquina sale unas 80 veces más barata por token leído. Eso se apoya en los 1,8 millones de tokens por segundo de un minuto de mucha carga en nuestra prueba más dura, estirados sobre las 730 horas de un mes, así que tomadlo como el mejor caso.
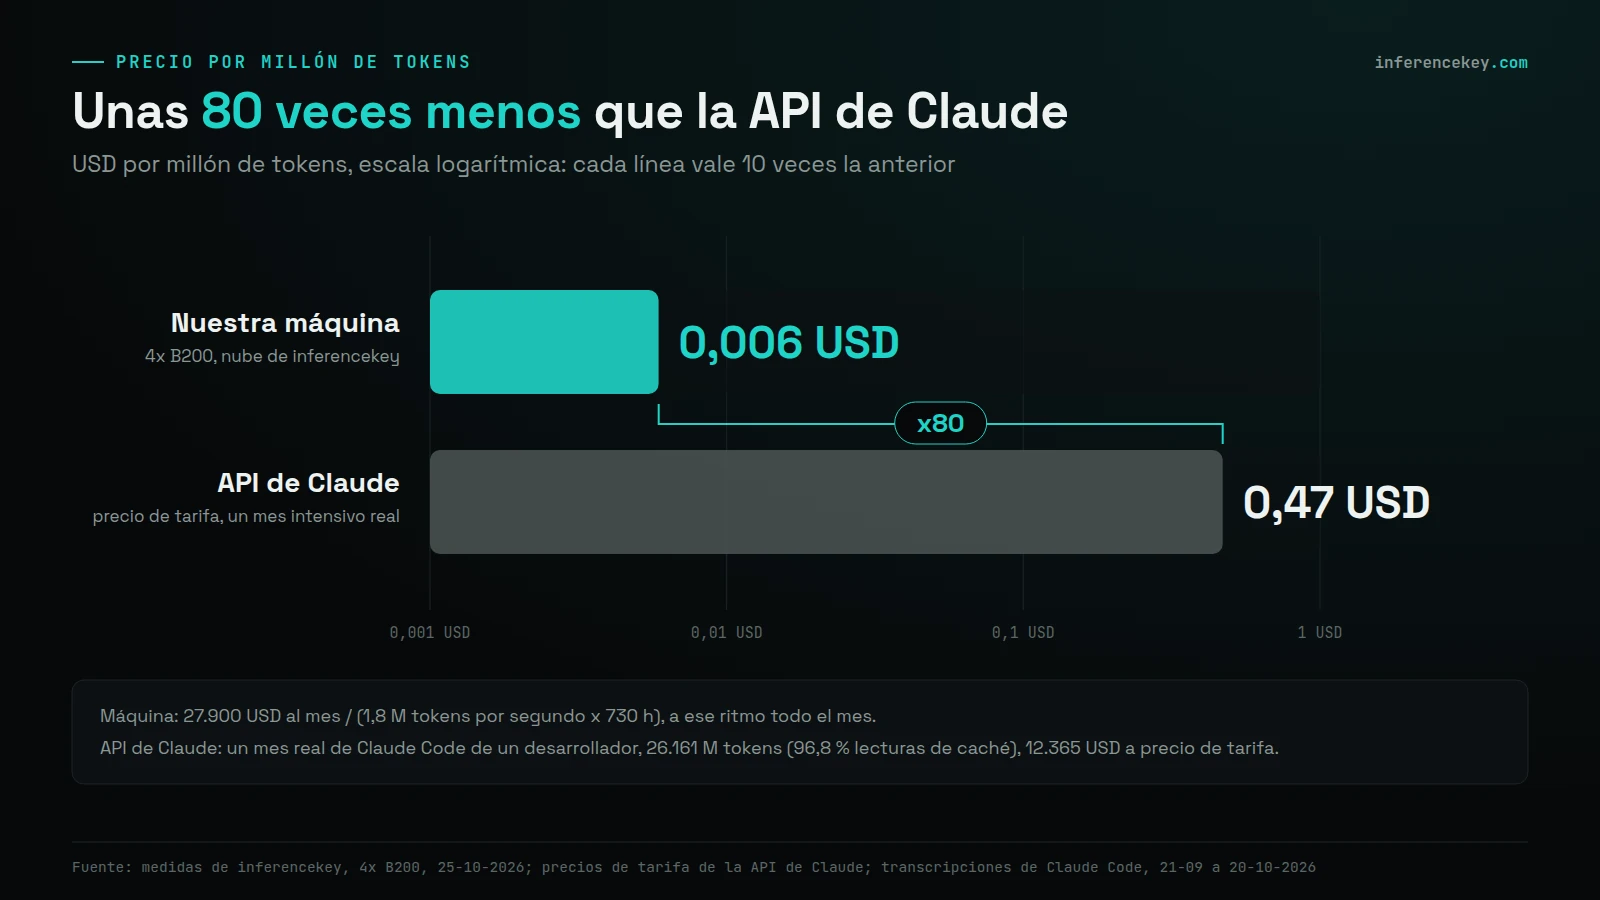
27.900 USD al mes a 1,8 M de tokens por segundo son unos 0,006 USD por millón de tokens. Eso es unas 80 veces menos que un mes real de uso intensivo en la API de Claude.
La comparación es justa porque los dos lados son sobre todo relectura: el 96 % desde la caché en nuestra prueba, el 96,8 % en el mes real con Claude. Un equipo que duerme por la noche paga más por token útil. El 30 % y las 80 veces responden a preguntas distintas, así que no los multipliquéis.
Calidad: primero en LiveBench agentic coding, y las respuestas desde la caché coinciden con las nuevas
En un benchmark externo de código, DeepSeek V4.1 Flash queda primero. LiveBench tiene una categoría de código agéntico (agentic coding), en la que un modelo tiene que terminar una tarea real de programación paso a paso. El 10 de octubre, DeepSeek V4.1 Flash sacó 77,3 y quedó primero de 69 modelos. Claude Opus 5.5 sacó 71,7. Este benchmark no lo corrimos nosotros.
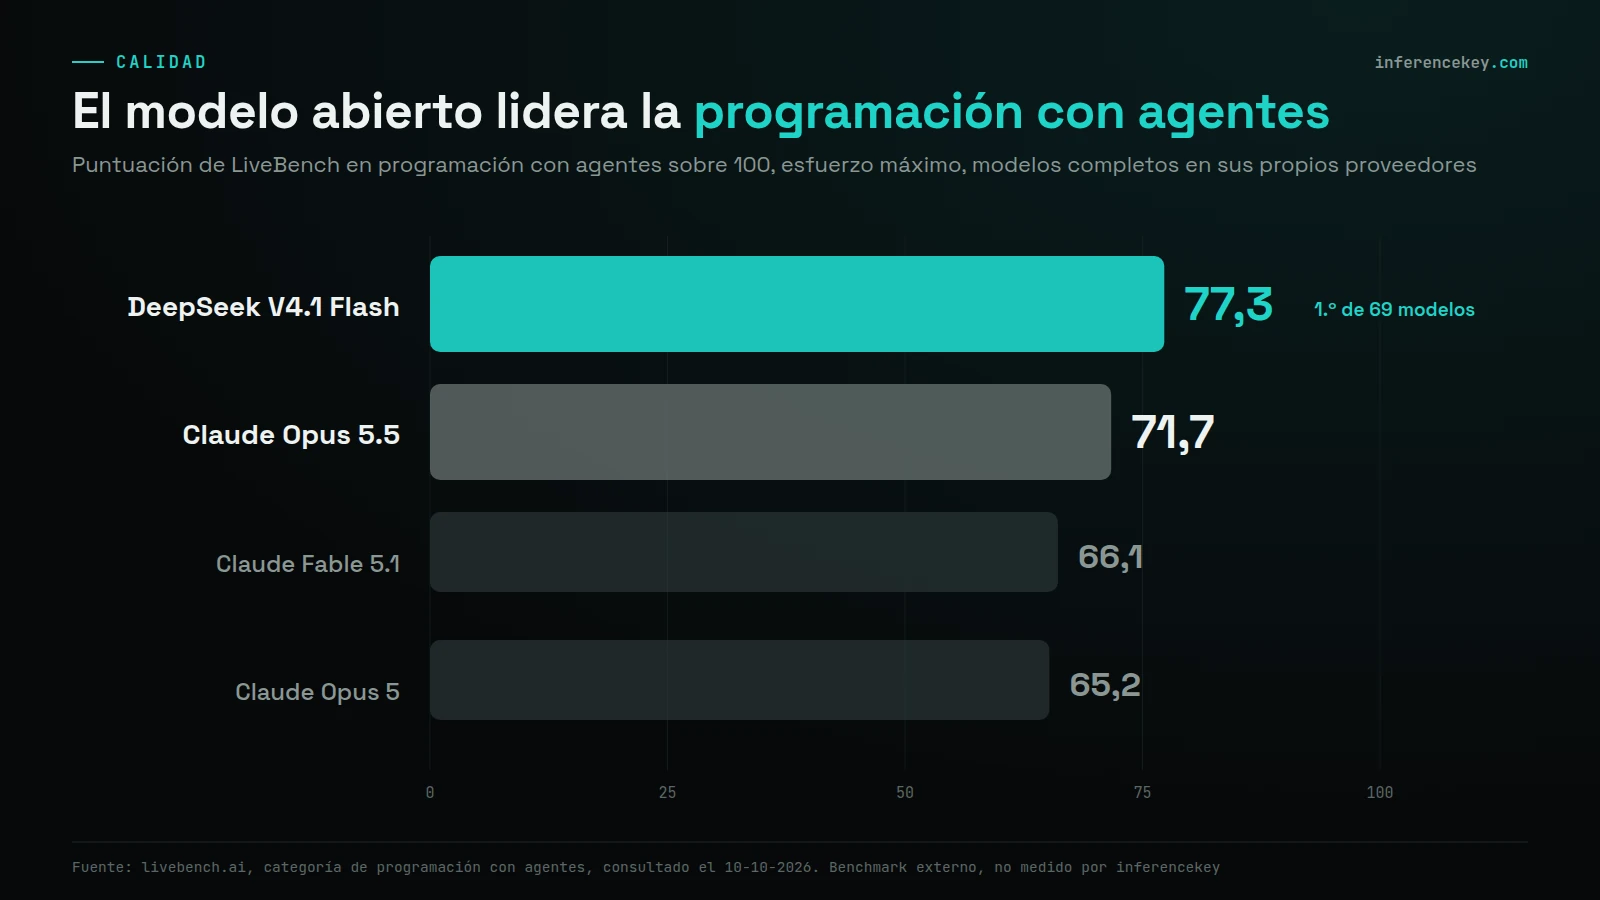
LiveBench agentic coding (livebench.ai, 10-10-2026): DeepSeek V4.1 Flash 77,3 frente a Claude Opus 5.5 71,7. Benchmark externo, no medido por nosotros.
Un índice más amplio de Artificial Analysis apunta en la otra dirección: Opus 5.5 saca 58 y Flash 39. Para un equipo que viene de Opus, esa diferencia es la advertencia honesta, así que probad Flash con vuestras propias tareas antes de cambiar.
Nuestra propia comprobación es que la estantería no cambia las respuestas. Escondimos un dato en un documento largo, de hasta 200.000 tokens, y lo preguntamos dos veces: una leyendo desde cero y otra servida desde la caché. Cinco documentos de cinco dieron la misma respuesta correcta de las dos formas. La versión desde la caché respondió en menos de un segundo. La de 200.000 tokens tardó 13 segundos leyendo desde cero.
Esa comprobación se ganó su sitio. Una versión anterior de nuestro adaptador no servía nada desde la caché, y esta comprobación lo pilló antes de que corriera ninguna prueba de carga. Lo arreglamos, y la versión arreglada servía las repeticiones entre un 95 y un 99 % desde la caché. Todas las cifras medidas de este artículo salen de ella.
Vuestro código va adonde decidáis
Con Claude, o con la API de DeepSeek, vuestro código y los datos que toca acaban en un proveedor de modelos. Con inferencekey en vuestras propias GPU, nunca sale de vuestra red. Con la nube de inferencekey, donde corrieron estas pruebas, va a nuestras GPU, no a Anthropic ni a OpenAI. En los dos casos las claves de API se quedan de vuestro lado, dentro de vuestra red. Si se filtra una, la rotáis allí. El precio y las pruebas de aquí son de la nube de inferencekey. No hemos puesto precio ni probado el caso on-premise.
200 agentes con 500K desbordan la balda rápida, así que unos 120 es el techo con ese tamaño
Con conversaciones de 500.000 tokens, la balda rápida es el techo. Con 200 agentes preguntando todos a la vez, sus conversaciones no cabían en la memoria de las tarjetas gráficas. La prueba se hundió: la mitad de las respuestas tardó más de dos minutos en empezar. No se perdió nada ni hubo errores, pero era inutilizable. A ese ritmo duro, se pueden servir a la vez unas 120 conversaciones de este tamaño.
La mayoría de las pruebas se saltó la API de inferencekey y llamó directamente al motor. La que sí la usó tuvo cero errores, pero sus respuestas más lentas tardaron 22 segundos en empezar, no 15. Fue una sola ventana corta, así que todavía no podemos decir cuánto cuesta el salto extra en conversaciones largas.
Merece la pena por encima de unas 140 suscripciones, si aceptáis respuestas más lentas en hora punta
Por encima de unas 140 suscripciones de Claude Max 20x, una máquina es una factura fija sin límite de uso por persona. El techo es compartido, unos 400 agentes, y seguís usando Claude Code. Por debajo de unas 140, las suscripciones cuestan menos. Si vuestro código no puede salir del edificio, el mismo montaje puede correr en vuestras propias GPU. Si tenéis diez desarrolladores, las suscripciones o la API de DeepSeek siguen siendo la opción más sencilla.
Probadlo vosotros
Seguid la guía de DeepInfer en 4x B200 para servir DeepSeek V4.1 Flash y apuntar Claude Code a él. Necesitáis cuatro tarjetas B200, o un workload en la nube de inferencekey, y una clave de API de inferencekey. Con los pesos en disco, nuestro workload estuvo listo en menos de dos minutos.
Para ingenieros
Cifras exactas, método y límites detrás del relato. Todas las pruebas medidas usaron DeepSeek-V4.1-Flash sobre DeepInfer, 4x NVIDIA B200 en la nube de inferencekey. Las fechas están en UTC.
Hardware y software
| Elemento | Valor |
|---|---|
| GPU | 4x NVIDIA B200 |
| Modelo | DeepSeek-V4.1-Flash, pesos de 476 GB, cargados desde el disco local del contenedor |
| Motor | DeepInfer, empaquetado como backend Python personalizado de inferencekey deepinfer-v41-flash, 4 ranks, paralelismo de expertos |
| Versión del backend | 0.3.2 en todos los pasos medidos (arreglo en el commit 66bf620 del SDK de inferencekey) |
| Pool de KV en GPU | 57.065.472 tokens (14,27 M por rank) |
| Nivel L1 en RAM del host | 128 GiB por rank, 617.009.664 tokens en total |
| Longitud máxima del modelo | 1.064.960 tokens |
| Rutas del endpoint | OpenAI /v1/chat/completions y Anthropic /v1/messages |
| Preparación de la máquina | pesos más instalación de DeepInfer, 5 min (b200-final) y 4 min (b200-500k), 11 min en una máquina anterior |
| Despliegue del workload con inferencekey | listo en 105 s |
Desplegar y conectar
El despliegue usa el SDK de inferencekey:
package_backend:deepinfer-v41-flash0.3.2, entrypointdeepinfer_backend:DeepInferBackend, apiopenai-chat.publish_custom_backendal tenant.ManagementClient.ensure(WorkloadSpec(slug="deepinfer-v41-flash", model="deepseek-v4.1-flash", backend="deepinfer-v41-flash", ...))con la configuraciónengine=deepinfer,ep=4,CUDA_VISIBLE_DEVICES=0,1,2,3.wait_until_ready.
El manager sirve /endpoint/<project>/<workload>/v1/messages (Anthropic) junto a /v1/chat/completions y /v1/models. La autenticación es Authorization: Bearer, con x-api-key como alternativa. Valores distintos en las dos cabeceras dan un 401. /v1/messages necesita un workload de chat en GPU local. Claude Code añade /v1/messages por su cuenta:
export ANTHROPIC_BASE_URL=https://api.inferencekey.com/endpoint/<project>/<workload>
export ANTHROPIC_AUTH_TOKEN=ik_live_...
export ANTHROPIC_MODEL=deepseek-v4.1-flash
export ANTHROPIC_DEFAULT_HAIKU_MODEL=deepseek-v4.1-flash
export ANTHROPIC_DEFAULT_SONNET_MODEL=deepseek-v4.1-flash
export ANTHROPIC_DEFAULT_OPUS_MODEL=deepseek-v4.1-flash
export CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC=1
claude
Prueba de humo antes de la campaña: chat OpenAI, streaming y Anthropic /v1/messages con una herramienta respondieron bien (stop_reason: tool_use con una llamada Read). Paso a paso, con el código del backend, en la guía de la documentación.
Carga de trabajo y criterios para pasar
Cada usuario es una sesión de agente que empieza con el tamaño del nivel (nivel 128K: 96.000 tokens, compacta a 128.000. Nivel 500K: 440.000, compacta a 500.000. Nivel 1M: 940.000, compacta a 1.000.000). Entrada nueva por turno p50 / p90 / p99 1.100 / 5.500 / 51.000 tokens, salida p50 / p90 423 / 1.700 (tope de 1.700), sacadas de percentiles reales de Claude Code. Tiempo de reflexión de 3 s de media, calentamiento de 16 sesiones a la vez, temperatura 0,6.
Un paso pasa cuando, sobre los turnos medidos en caliente: TTFT p95 <= 15 s, tok/s por usuario p50 >= 20 y p10 >= 10, errores <= 1 %, acierto de caché >= 90 %.
Todos los pasos medidos
| Paso | Ruta | Veredicto | Turnos (en frío) | TTFT p50 / p95 (s) | tok/s p50 / p10 | Caché | Goodput | Errores |
|---|---|---|---|---|---|---|---|---|
| 500K x 50 | directa | PASA | 75 (0) | 2,47 / 4,41 | 162,9 / 99,5 | 100 % | 100 % | 0 |
| 500K x 100 | directa | NO PASA (TTFT p95) | 237 (7) | 2,55 / 36,98 | 134,6 / 39,1 | 99 % | 83 % | 0 |
| 500K x 200 | directa | NO PASA | 17 (0) | 151,09 / 160,74 | 26,2 / 9,2 | 41 % | 0 % | 0 |
| 128K x 300 | directa | PASA | 521 (48) | 5,57 / 14,76 | 35,4 / 16,3 | 98 % | 91 % | 0 |
| 128K x 350 | directa | NO PASA | 676 (85) | 7,39 / 20,98 | 22,3 / 8,4 | 98 % | 76 % | 0 |
| 128K x 400 | directa | NO PASA | 652 (52) | 7,27 / 16,93 | 29,1 / 9,5 | 98 % | 80 % | 0 |
| 1M x 48 | directa | NO PASA (TTFT p95) | 100 (3) | 3,64 / 28,85 | 69,4 / 22,4 | 100 % | 80 % | 0 |
| 128K x 300 | inferencekey | NO PASA (TTFT p95) | 479 (28) | 5,61 / 22,17 | 40,1 / 13,8 | 98 % | 83 % | 0 |
TTFT, tok/s y Caché cubren los turnos medidos en caliente, por eso 500K x 100 muestra aquí un 99 % frente al 96,1 % sobre todos los tokens de entrada medidos (turnos en frío incluidos) del relato. El goodput es la proporción de turnos en caliente con TTFT <= 15 s y tok/s >= 10. Con 128K el límite es el cómputo de prefill nuevo (por encima de unos 100 a 116 K tokens nuevos/s el primer token se dispara). Con 500K el límite es la memoria de KV en GPU.
La prueba en caliente de 100 agentes (direct-500K-0100-01, 25-10-2026)
237 turnos medidos (7 en frío), 0 errores, ventana de 60,2 s (del inicio del primer turno medido al final del último). Entrada de 108.173.087 tokens, de los que 103.989.632 en caché (96,1 %): 1.797.048 tok/s de entrada. Salida de 129.332 tokens: 2.149 tok/s. Prefill nuevo de 69.499 tok/s. TTFT en caliente p50 2,55 s, p95 36,98 s. TTFT en frío en la ventana p50 26,55 s. tok/s por usuario p50 134,61, p10 39,07. Ratio de KV 0,79. Estas tasas son sumas de tokens sobre la ventana, no contadores del motor. Los turnos lentos en caliente esperaron en cola detrás de los 7 prefills en frío de 450K, no detrás de L1. Dar prioridad a los turnos en caliente o limitar las sesiones en frío simultáneas probablemente ayudaría (sin probar). El simulador atribuye la cola lenta a una ráfaga de compactaciones simultáneas, porque todas las sesiones de la campaña empezaron a la vez con 440K.
La prueba de estrés en frío (direct-500K-0400-00, 24-10-2026)
399 sesiones nuevas de unos 440K lanzadas de 16 en 16, nada en caché. 397 terminaron con 0 errores antes de que el paso llegara a max_step_s 900 s, así que su veredicto formal es "warmup timeout" y no tiene fase medida. Prompt p50 440.993. Entrada de 176.154.816 tokens (0 en caché), salida de 222.439. Ventana de 878,2 s (14,64 min): unos 200,6 K tok/s de entrada. Ritmo de lectura por minuto, agrupado por primer token, de 206 a 237 K tok/s durante los primeros 12 minutos, y luego baja a medida que terminan las últimas sesiones. TTFT p50 13,72 s, p95 28,73 s, contado desde el lanzamiento de cada sesión tras la cola de 16 en 16. Contado desde el inicio del paso, los primeros tokens llegaron con una mediana de 381 s y como mucho a los 874,7 s. L1 activo, 58 GB usados por rank, promociones a 4,1 GB/s. Prefill en frío en los otros calentamientos de 500K: 191,7 K tok/s (50 sesiones), 214,3 K (100), 244,6 K (200), TTFT en frío p50 de 12,5 a 12,8 s.
Por qué se hundió 500K x 200
Unas 50 peticiones en vuelo por rank con unos 445K tokens cada una son unos 22 M de tokens, frente a 14,27 M de KV en GPU por rank. L1 no perdió nada (dropped = 0) y registró de 54 a 56 timeouts de promoción por rank: una sesión promovida desde L1 esperó hasta 2 s a tener sitio en la GPU y después se recalculó. L1 ayuda a las sesiones en reposo, no a sesiones que están todas en vuelo a la vez. Con 3 s de tiempo de reflexión, unas 120 sesiones de 450K es lo máximo que puede decodificar a la vez (57,1 M / 0,45 M, con algo de holgura).
Simulador (modelado)
Modelo de eventos de DeepInfer 0.3.2 en 4x B200: enrutado por afinidad de sesión a un rank, caché en GPU de 14.266.368 y L1 de 154.252.416 tokens por rank, lockstep de EP, prefill troceado que comparte pasos con la decodificación, promoción desde L1 con una espera de 2,0 s y una cola de entrada por GPU inferida. Calibrado reproduciendo los 7.879 turnos grabados de las dos campañas y ajustado con los turnos medidos en caliente de 6 pasos directos. Reproduce el hundimiento de 500K x 200 en bucle cerrado (modelo, unos 200 s de TTFT p50; real, 151 s). Tiempo de la prueba en frío: 822 s modelados frente a 878 s reales.
Carga de trabajo: 30 días de transcripciones de Claude Code del usuario de referencia, 140.300 llamadas de 3.912 agentes. El contexto crece de media 2.597 tokens por llamada (mediana 1.406), salida media de 663 tokens, pausa media de 13,9 s (excluidas las pausas de más de 600 s), compactación a 500K de vuelta a unos 43K.
NVIDIA aiperf 0.13.0 contra el simulador, bucle cerrado con calendario fijo, 600 s medidos tras 90 s de calentamiento, una ejecución por punto:
| Agentes | SLO | TTFT p50 / p95 (s) | req/s | Intervalo por agente (s) | Errores | Veredicto |
|---|---|---|---|---|---|---|
| 250 | 15 s | 3,68 / 13,54 | 7,428 | 33,65 | 0 | PASA |
| 275 | 15 s | 6,63 / 15,42 | 7,525 | 36,54 | 0 | NO PASA (por poco) |
| 300 | 15 s | 7,97 / 18,37 | 7,652 | 39,21 | 0 | NO PASA |
| 400 | 30 s | 20,82 / 29,59 | 7,632 | 52,41 | 0 | PASA |
| 425 | 30 s | 22,63 / 34,37 | 7,613 | 55,82 | 0 | NO PASA |
El rendimiento se satura cerca de 7,5 req/s sea cual sea el SLO.
De agentes a suscripciones (derivado de lo modelado)
- Unas 200: 400 agentes (TTFT p95 <= 30 s) / 2 agentes a la vez por usuario intensivo, todo el día (nuestra suposición). Cada agente llama cada 52 s, frente a 27 s en Claude para el usuario de referencia.
- Unas 80: 7,5 req/s / 0,092 llamadas/s, la tasa media de llamadas en hora punta del usuario de referencia. Igual para los dos SLO.
- Otras cuentas: unas 170 contando los 2,3 agentes activos del usuario de referencia en hora punta (400 / 2,3), unas 140 con su media mensual de 0,054 llamadas/s (no válida para dimensionar), unas 38 si todos están a la vez en su hora de más carga (0,198 llamadas/s).
- El usuario de referencia incluye agentes autónomos, así que un usuario típico de Claude Max carga menos la máquina. Las tasas de llamadas salen de nuestro análisis interno de sus transcripciones. No hay ningún script guardado que las reproduzca, aunque la división cuadra.
Coste (derivado)
- Máquina: 27.900 USD al mes, precio público de la máquina 4x B200 en la nube de inferencekey.
- Suscripciones: 200 x 200 USD (Claude Max 20x) = 40.000 USD. 1 - 27.900 / 40.000 = 30,25 %, 12.100 USD menos al mes. Punto de equilibrio frente a Max 20x en 27.900 / 200 = unas 140 suscripciones. Con la cuenta estricta de 80: 16.000 USD en suscripciones, así que la máquina cuesta un 75 % más.
- Por millón de tokens de entrada: 27.900 / (1,8 M x 3.600 x 730 / 1e6) = 0,0059 USD, unos 0,006, con uso completo durante 730 h. Pone precio solo a los tokens de entrada, con una mezcla muy cargada de caché (aquí el 96,1 %, el 96,8 % de lecturas de caché en el mes real con Claude).
- API de Claude, el mes de un desarrollador muy intensivo (del 21-09-2026 al 20-10-2026): 12.365 USD / 26.161 M de tokens = 0,47 USD por millón. 0,47 / 0,006 = unas 80 veces. Es una ventana de 30 días distinta del mes de referencia del simulador, del mismo usuario.
- API de DeepSeek, el mismo mes: 274 USD, unos 0,0105 USD por millón, casi el doble que nuestra máquina. Es la opción alojada barata, pero el código sigue yendo a un proveedor de modelos.
- El 30 % (frente a las suscripciones) y las 80 veces (por token, frente a la API) responden a preguntas distintas. No los combinéis.
Calidad
- Control de calidad (
quality_check.py): un dato escondido entre relleno a una profundidad dada, enviado en frío y después desde la caché de prefijos a temperatura 0. Ejecución 3 (25-10-2026, backend 0.3.2):
| Caso | Tokens del prompt | Tokens en caché | En frío (s) | Desde caché (s) | Respuesta |
|---|---|---|---|---|---|
| 16K, dato al 50 % | 15.570 | 15.232 | 1,25 | 0,79 | coincide |
| 64K, dato al 10 % | 63.767 | 63.488 | 3,93 | 0,78 | coincide |
| 64K, dato al 50 % | 63.667 | 63.360 | 4,31 | 0,80 | coincide |
| 64K, dato al 90 % | 63.715 | 63.360 | 3,91 | 0,79 | coincide |
| 200K, dato al 30 % | 200.542 | 200.192 | 12,97 | 0,80 | coincide |
La ejecución 2 (24-10-2026, 0.3.2) también pasó 5/5. El control solo comprueba la recuperación del dato, no la calidad del código. La equivalencia de respuestas con L1 solo se comprobó con pesos sintéticos en una prueba con 1x B200.
- El backend 0.3.1 servía 0 tokens en caché con 4 ranks: el bucle del rank llamaba a
cache.forget()en la última salida, pero DeepInfer finaliza la secuencia un paso después. Arreglado en el commit66bf620del SDK (output_finishedmás una limpieza a los 30 s), publicado como 0.3.2, que servía las repeticiones entre un 95 y un 99 % desde la caché. - LiveBench agentic coding (10-10-2026, esfuerzo máximo, modelos completos de sus propios proveedores): DeepSeek-V4.1-Flash 77,3 (1.º de 69), Claude Opus 5.5 71,7, Claude Fable 5.1 66,1, Claude Opus 5 65,2. Artificial Analysis Intelligence Index (16-10-2026): Opus 5.5 58, Flash 39. Citado de nuestro artículo del 20-10-2026, sin volver a verificar.
Tarea de Claude Code (24-10-2026)
Claude Code 2.1.310, sin cambios, ANTHROPIC_BASE_URL apuntando al endpoint, modelo deepseek-v4.1-flash. Tarea: implementar parse_duration en durations.py para que pase test_durations.py. 15/15 tests, 39 s de reloj, 37,3 s dentro de Claude Code (tiempo de API 32,0 s, primer token 2,6 s). 14 llamadas a herramientas (Read 7, Bash 4, Edit 2, Write 1, una llamada Bash denegada por permisos), 15 turnos, 22.117 tokens de entrada, 173.696 de lectura de caché y 3.549 de salida. La escena de Claude Code del vídeo es la aplicación real grabada haciendo la misma tarea otra vez contra un servidor local de Anthropic Messages que devuelve en streaming las respuestas del modelo grabadas en esta sesión, con las herramientas ejecutándose de verdad.
Límites
- Todos los pasos medidos usaron un tiempo de reflexión medio de 3 s, así que casi todos los agentes estaban activos a la vez. Son cargas de agentes en el peor caso, no ritmo humano. No se midió ninguna prueba a ritmo humano, así que el beneficio de L1 para las sesiones en reposo está sin medir.
- Las cifras de rendimiento son sumas de tokens sobre ventanas cortas (de 22 a 175 s), no contadores del motor. La prueba en frío solo completó el calentamiento, así que su tasa es una tasa de prefill.
- La ruta por el gateway de inferencekey tuvo un paso de confirmación (128K x 300: TTFT p95 22,17 s frente a 14,76 s en directo), 479 turnos en una ventana de 59 s. Su sobrecoste en la latencia con contextos largos no está establecido. El nivel 1M no pasó por el gateway (necesita
max_model_len1.068.000, por encima de los 1.064.960 configurados). - Todas las cuentas de agentes y suscripciones están modeladas. La cola de entrada del simulador es inferida y fija el techo de unos 7,5 req/s. La velocidad de decodificación en el modelo es pesimista con 128K y 500K y optimista con 1M, y subestima la cola lenta (p95 en bucle cerrado de 5,90 s frente a 36,98 s reales en 500K x 100). Su contexto simulado ronda los 270K por llamada frente a unos 200K del usuario de referencia. Una ejecución de aiperf por punto, sin intervalos de confianza.
- El precio por millón supone 730 h de uso completo y cubre solo los tokens de entrada.
- La tarea de Claude Code es una tarea pequeña, no un benchmark. La calidad del código sobre vuestro propio código no se midió.
- Sin medir: 500K x 300 (parado durante el calentamiento), 1M x 36 (omitido).
Fuentes
Registro interno de ingeniería docs/deepinfer-4xb200/ en el repositorio de inferencekey (README.md, real-tests.md, simulation.md, cost-and-quality.md, methodology.md, data/). Ficheros brutos de los pasos de las campañas b200-final y b200-500k, de los que recalculamos las cifras de los 100 agentes y de la prueba en frío. Salidas del simulador rehearsal/sim500k/runs/aiperf_results.json (SLO de 15 s) y rehearsal/sim500k/runs/aiperf_results_ttft30.json (SLO de 30 s). DeepInfer (Apache 2.0). LiveBench. Artificial Analysis. Precios de Claude. Nuestro artículo anterior sobre lo que cuesta un mes de agente de código.