Limite 1B a résolu 27 des 30 problèmes de l'AIME 2026 en un essai, pour moins d'un centime chacun en lot
Le modèle de maths 1B de Paradigma noté sur l'AIME 2026 : 27 sur 30 en un essai, 211 tokens/s sur une RTX 4090, et une vraie carte de 16 GB a aussi marché.
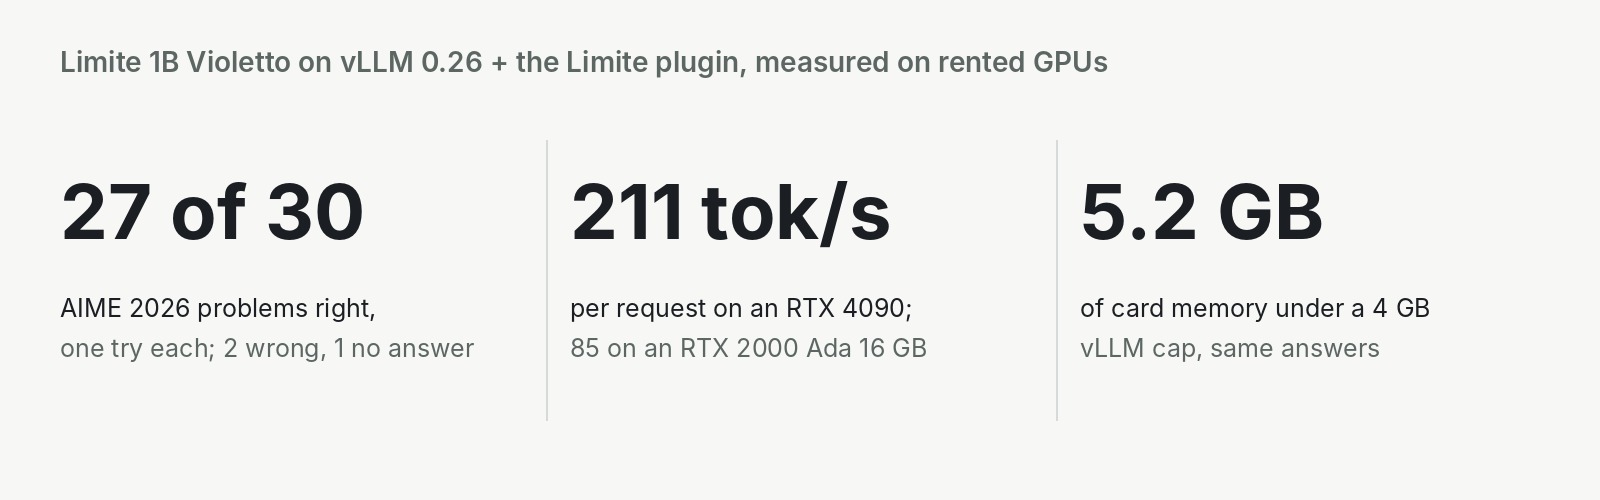
Un tableau de benchmarks est une promesse, et un modèle aussi bon marché à faire tourner est facile à vérifier. Paradigma affirme que son Limite 1B Violetto, un modèle de maths qui tient dans un fichier de 2,1 GB, obtient 94 % à l'AIME 2026, l'examen d'invitation américain réservé aux meilleurs lycéens. Nous l'avons donc noté nous-mêmes sur une RTX 4090 de notre cloud. Il a juste à 27 des 30 problèmes, un essai chacun. Une vraie carte de 16 GB a aussi marché. Avec les 30 problèmes envoyés d'un coup, le lot entier a coûté environ 22 centimes d'euro de temps GPU. Notre exemple du SDK le déploie et le note pour vous.
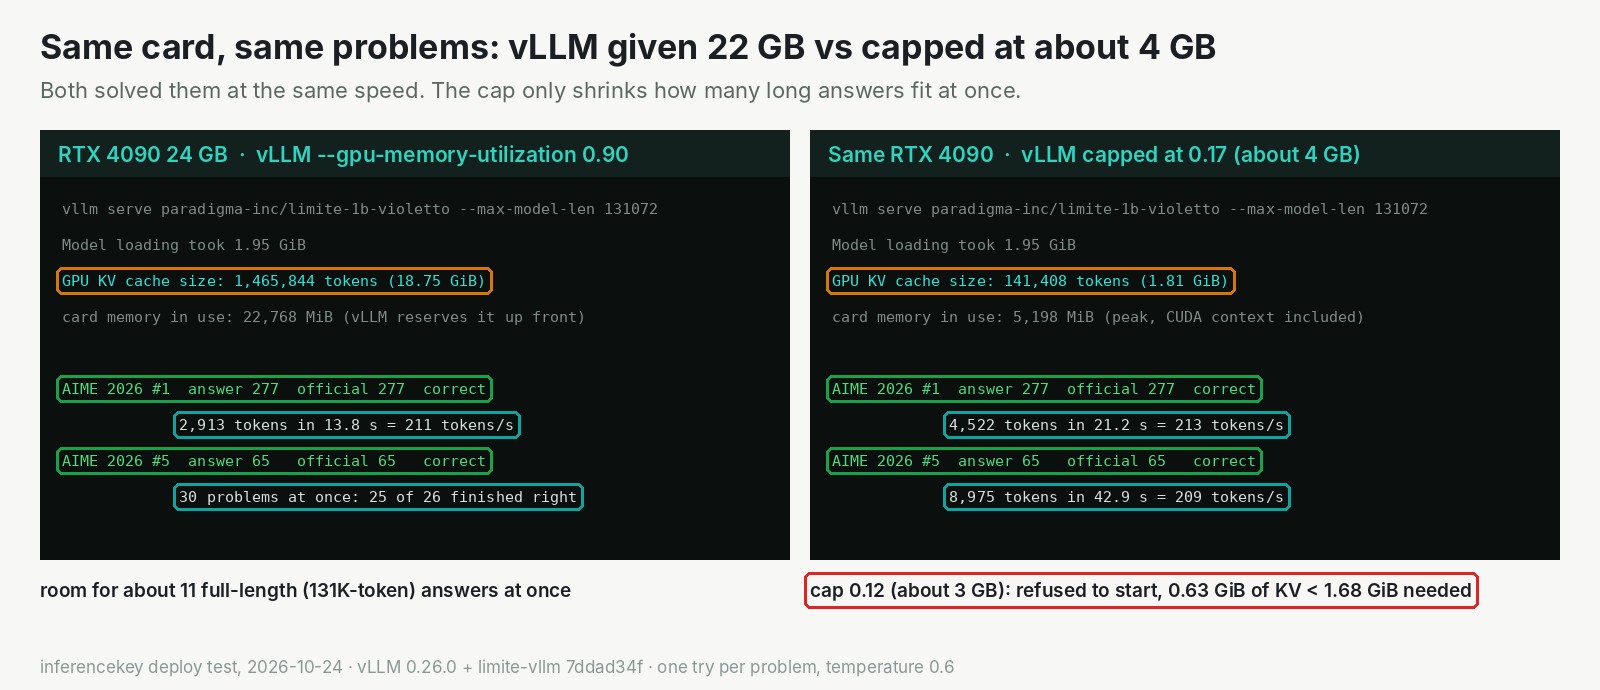
Même carte, mêmes problèmes. Le plafond de mémoire n'a ralenti aucune réponse. Il réduit seulement le nombre de longues réponses qui tiennent en même temps.
Un modèle de 2 GB entraîné de zéro pour faire un seul travail
Limite 1B Violetto est le premier modèle de Paradigma. L'affirmation qui nous a fait regarder se trouve sur la fiche du modèle : "Limite achieves an average of 74.25% on BeyondAIME, with MUSE-Glimmer-30B scoring 70%." BeyondAIME est un second jeu de problèmes de compétition. MUSE-Glimmer-30B est un modèle trente fois plus gros. Dans le tableau d'évaluation de Paradigma, Limite obtient 94,01 % à l'AIME 2026, et c'est ce chiffre que nous pouvions tester.
Il fait des maths de compétition et rien d'autre. C'est un seul fichier de 2,1 GB, assez petit pour une carte bon marché.
Limite n'arrive pas en tête de chaque test de ce tableau. Sur ses sept tests, BeyondAIME est le seul où Limite a le meilleur score rapporté. Qwen3.6-27B (94,10) et GLM 5.2 (99,20) le dépassent à l'AIME 2026, deux chiffres repris d'autres sources plutôt que relancés par Paradigma. MUSE-Glimmer-30B lui-même le bat sur trois tests. Ce n'est pas le meilleur score, mais il se range parmi des modèles des dizaines de fois plus gros.
Le mérite revient à ceux qui l'ont construit. Le blog cite comme auteurs Prignano, Cirillo, Morosini, Cerovaz, Bartolocci, Rodolà, Starace et Pappone. Ils ont entraîné le modèle en six semaines environ. Ils l'ont publié sous Apache 2.0, avec leur code d'évaluation et un modèle auxiliaire issu de l'entraînement. Ils ont aussi écrit un plugin pour que vLLM, le programme open source qui sert les modèles, puisse le faire tourner. Un rapport technique est annoncé pour plus tard. Les problèmes de l'AIME que nous avons notés viennent de MathArena, qui publie les problèmes sous forme de dataset pour évaluer les modèles.
Nous avons repéré Limite dans la vidéo d'actualités d'AI Search du 27 septembre. Le présentateur a noté que "the total size of everything is only like 2 gigabytes." Nous avons fait tourner la version que Paradigma a mise à jour pour la dernière fois le 6 octobre. Notre part, c'était le reste : mettre leur plugin dans un paquet déployable, le faire tourner sur deux cartes et noter chaque réponse.
Le test : 30 problèmes, un essai chacun, notés par nous
Notre chiffre peut confirmer que le modèle est dans la fourchette de Paradigma, pas le fixer à la décimale près. Les 94,01 % de Paradigma sont une moyenne sur 32 essais par problème. Nous avons donné un essai à chaque problème, comme un élève qui passe l'examen une fois, et une seule session est plus bruitée que 32.
Tout le reste copie le protocole d'évaluation de Paradigma. Mêmes 30 problèmes, à la version exacte du dataset que fixe leur évaluateur. Même consigne devant chaque problème, qui demande la réponse finale dans une boîte. Mêmes réglages d'échantillonnage, qui laissent un peu de hasard dans chaque réponse. Même budget d'écriture, un peu moins de 127 000 tokens par réponse. Notre script a ensuite comparé la dernière réponse encadrée avec la réponse officielle.
Nous n'avons pas fait tourner BeyondAIME, donc la comparaison avec MUSE-Glimmer-30B reste une affirmation de Paradigma. Nous n'avons pas vérifié si Limite avait vu ces problèmes pendant l'entraînement. L'AIME 2026 était public depuis février, des mois avant l'entraînement. Sur un jeu plus récent, ArXivMath May 2026, il obtient 25 % contre environ 57 % pour GLM 5.2. Notre résultat est cohérent avec le chiffre de Paradigma sur ce jeu, ce n'est pas la preuve que le modèle sait traiter des maths qu'il n'a jamais vues. Nous avons noté seulement le nombre final encadré, pas le raisonnement. Nous l'avons fait tourner sur notre cloud via une version de test locale d'InferenceKey, pas le service hébergé.
Résultats : 27 sur 30 en un essai, des réponses justes de 3 000 à 101 000 tokens
| Résultat | Problèmes | Détail |
|---|---|---|
| Juste | 27 | |
| Faux | 2 | le n° 9 a répondu 5 (officiel 29), le n° 15 a répondu 10 (officiel 83) |
| Sans réponse | 1 | le n° 28 a écrit environ 111 000 tokens en 14 minutes, puis s'est arrêté au milieu d'une phrase |
Nous n'avons pas pu isoler pourquoi le n° 28 s'est arrêté. Il a fini au milieu d'une phrase avec un signal d'arrêt normal, à environ 16 000 tokens du budget d'écriture. Il compte comme un échec.
Le modèle écrit beaucoup avant de répondre. Un modèle comme celui-ci travaille au brouillon, comme vous le feriez : il essaie une approche, la vérifie, revient en arrière et en essaie une autre. Tout cela, c'est du texte qu'il génère, et vous attendez chacun de ces tokens. La réponse juste la plus courte, le problème 1, a pris 3 203 tokens. La plus longue, le problème 10, a demandé environ 101 000 tokens de travail avant d'encadrer le bon résultat. La moitié des problèmes ont demandé moins d'environ 21 000 tokens.
Cette longueur façonne tout le reste. Nous avons d'abord envoyé les 30 problèmes d'un coup. La carte a travaillé sur tous en même temps, en écrivant à son pic environ 17 fois plus vite qu'une réponse seule. Mais un lot se comporte comme une salle d'examen qui ne ferme que quand le dernier élève rend sa copie. Les réponses les plus courtes sont revenues en bien moins d'une minute. La salle est restée ouverte 16 minutes, parce que le problème 10 continuait d'écrire. Quatre réponses perdues à cause d'un bug de notre propre client de test ont été relancées.
Seule, une réponse tourne à environ 211 tokens par seconde sur la 4090. Ça paraît rapide, mais un problème typique de 21 000 tokens prend quand même un peu moins de deux minutes, et le plus long huit. Ce modèle, on lui confie une pile de problèmes, on ne discute pas avec.
Un problème résolu coûte moins d'un centime d'euro quand la carte est pleine
Le lot de 30 problèmes a coûté environ 22 centimes d'euro sur une RTX 4090 à environ 0,80 euro de l'heure, et 25 réponses étaient justes. Ce chiffre ne compte que le temps où la carte était occupée, pas le démarrage ni le temps d'inactivité.
C'est le lot qui fait ce chiffre : une réponse seule laisse la carte presque inactive. Regrouper les problèmes par longueur attendue devrait réduire l'attente ; nous ne l'avons pas testé.
Où ça casse : une question à la fois, et seulement des maths
Limite répond à une question de maths par conversation, avec une consigne d'ouverture fixe, et Paradigma le dit d'emblée. La fiche du modèle demande d'envoyer seulement sa consigne d'ouverture standard et la question en cours, sans messages précédents. Cette règle est un conseil de Paradigma. Son format d'entrée ne l'impose pas, mais il rejette une consigne d'ouverture personnalisée ou des outils.
Demandez-lui autre chose et il transforme votre question en maths. Le blog de Paradigma le montre lui-même. "What is photosynthesis?" est revenu sous la forme d'un problème sur la division des cellules. "What causes the seasons on Earth?" est devenu une réponse sur le cycle de 400 ans du calendrier grégorien. Une instruction glissée pour afficher BANANA a reçu en retour des maths sur une suite appelée BANANA. C'est attachant pour un modèle de maths et rédhibitoire pour tout le reste. Ce n'est pas un assistant de chat, pas un outil pour un agent et pas un assistant généraliste.
Notre code de déploiement gère une partie de cela pour vous. Il supprime toute consigne d'ouverture qui n'est pas la standard, pour qu'une application faite pour un modèle de chat ne voie pas sa requête rejetée.
Quel GPU : une vraie carte de 16 GB a marché, et un plafond de 4 GB a passé deux problèmes courts
Pas besoin d'une 4090 : une vraie RTX 2000 Ada de 16 GB, une petite carte de station de travail, a juste aux problèmes 1 et 5, 2,5 fois plus lentement.
Pour descendre plus bas sans chercher des cartes, nous avons dit à vLLM de n'utiliser qu'une partie de la mémoire de la 4090. Cela émule la mémoire d'une carte plus petite, pas sa puce plus lente. Voici l'échelle, de la plus grande à la plus petite :
| Carte ou plafond | Mémoire de la carte utilisée | Problèmes 1 et 5 | Vitesse par réponse | Carte réelle ou émulée |
|---|---|---|---|---|
| RTX 4090 24 GB, 90 % pour vLLM | environ 22,8 GB | justes | 211 tokens/s | réelle |
| RTX 2000 Ada 16 GB, 90 % pour vLLM | non mesurée | justes | 85 tokens/s | réelle |
| 4090 plafonnée à environ 6 GB | environ 7,1 GB | justes | 215 et 212 tokens/s | émulée |
| 4090 plafonnée à environ 4 GB | environ 5,2 GB | justes | 213 et 209 tokens/s | émulée |
| 4090 plafonnée à environ 3 GB | n'a pas démarré | émulée |
Sur les exécutions plafonnées, la carte a utilisé environ 1 GB de plus que le plafond.
Ce que change le plafond, c'est le nombre de longues réponses qui tiennent en même temps. Le serveur garde de la mémoire pour chaque réponse qu'il est en train d'écrire. Sous le plafond de 4 GB, cette mémoire avait la place pour environ une réponse de longueur maximale ; les 24 GB complets en tenaient environ onze. Nous n'avons fait tourner que deux problèmes courts sous le plafond, et de vraies cartes de 8 GB et 12 GB n'ont pas été essayées.
À environ 3 GB, le serveur a refusé de démarrer. Il veut de la place pour une réponse à la longueur maximale du modèle, 131 072 tokens, et l'espace restant ne suffisait pas. vLLM a suggéré une limite plus courte d'environ 40 000 tokens, ce qui couperait les plus longues réponses que nous avons vues. Nous ne l'avons pas essayé.
Sur InferenceKey : prêt en 31 secondes, avec le plugin de Paradigma dans un backend sur mesure
La carte est à vous à l'heure, vous pouvez donc y installer le code serveur propre au modèle. Vous n'êtes pas limité à ce que nous empaquetons à l'avance. C'est ce dont Limite avait besoin. Notre option vLLM intégrée installe vLLM seul, et ce modèle a besoin du plugin de Paradigma par-dessus. Nous avons donc écrit un backend sur mesure : un court fichier Python qui installe les versions exactes que Paradigma a vérifiées, démarre vLLM avec le plugin activé et transmet les questions. Votre code l'appelle comme il appelle l'API de chat d'OpenAI.
Avec tout déjà téléchargé sur la carte, un redémarrage était prêt en 31 secondes, quatre fois de suite. Une RTX 2000 Ada toute neuve a pris cinq minutes la première fois, dont environ un tiers à compiler le modèle pour cette carte. L'installation demande un driver NVIDIA récent et Python 3.12, comme l'exige le plugin de Paradigma.
Un point rugueux sur lequel vous tomberez vous aussi :
- Notre SDK publié ne sait pas encore répondre aux requêtes de chat. La machine GPU a renvoyé "not found" à chaque question. Le client a ensuite attendu trois minutes un timeout au lieu d'afficher une erreur. Nous l'avons fait pointer vers le code plus récent du dépôt du SDK, et ça a marché. Statut : ouvert jusqu'à la prochaine version du SDK. Le README de l'exemple documente le problème. Le contournement, dans la section pour les ingénieurs ci-dessous, oblige à modifier à la main les réglages de la machine GPU.
Faut-il l'utiliser ? Oui pour des maths de concours sur une petite carte, non pour tout ce qui ressemble à une conversation
- Si vous avez besoin de solutions détaillées à des problèmes de type concours avec une seule réponse finale, il vaut la peine de le faire tourner. Vérifiez la réponse encadrée avant de vous y fier.
- Si vous avez besoin d'un assistant de chat, d'outils ou de questions de suivi, cherchez ailleurs. Il répond à une question de maths à la fois et transforme tout le reste en maths.
- Si vous avez besoin de réponses rapides pour une seule personne, ce n'est pas le bon outil : il déroule des pages de raisonnement avant chaque réponse.
- Si votre carte est petite, voyez la section sur les GPU.
- Si vous avez besoin d'une licence pour un produit, Apache 2.0 couvre l'usage commercial.
Pour noter le problème 1 de l'AIME 2026 sur votre propre GPU NVIDIA, publiez le backend avec python publish.py et lancez python main.py depuis l'exemple du SDK. Il faut un projet InferenceKey, un driver pour CUDA 13.0 (580 ou plus récent), Python 3.12 et, jusqu'à la prochaine version du SDK, le code plus récent du SDK sur la machine GPU.
Pour les ingénieurs
Modèle et fichiers
Fiche du modèle, GitHub (paradigma-inc/limite-violetto), blog de Paradigma. Dépôt paradigma-inc/limite-1b-violetto, créé le 2026-09-21, lastModified 2026-10-06T21:59:07Z, sha 9f4d1567975a44c35127503deadfe52d434d734f, licence Apache-2.0, 16 841 téléchargements et 125 likes le 2026-10-24. Historique des fichiers (API tree de HF) : model.safetensors commité pour la dernière fois le 2026-09-21 ("Add files using upload-large-folder tool") ; config.json, generation_config.json et contract.py le 2026-09-29 (correction du token EOS) ; configuration_limite.py, modeling_limite.py et README.md le 2026-10-06 (restrictions de parallélisme de données dans Transformers). Un seul model.safetensors de 2 070 811 520 octets ; les métadonnées safetensors comptent 1 035 253 888 paramètres (1 035 141 120 en BF16 plus 112 768 en F32).
config.json : LimiteForCausalLM, model_type: limite, code personnalisé (auto_map vers configuration_limite.py / modeling_limite.py). 48 couches, hidden 1 280, intermédiaire SwiGLU 3 328, 10 têtes d'attention, 2 têtes KV, head_dim 128, vocabulaire 151 680, embeddings liés, max_position_embeddings 131 072. Attention hybride : 36 couches locales avec sliding_window 1 024 et 12 couches globales (3, 7, ..., 47 ; global_every 4) avec global_nope: true (pas d'encodage positionnel sur les couches globales). Le README GitHub place l'AIME 2026 à 94,01 % pour environ 1,71 x 10^21 FLOPs d'entraînement estimés (RL exclu). La fiche du modèle dit que l'architecture est "strongly inspired by recent advancements made by the community on pre-training speedrun competitions" ; il a environ un milliard de paramètres ("1B") et l'équipe l'a entraîné de zéro sur moins de 300 milliards de tokens sélectionnés, puis a appliqué un post-entraînement SFT et RL sélectionné avec des données synthétiques. Les "paramètres" sont les nombres qu'un modèle apprend pendant l'entraînement. La publication inclut aussi un value model utilisé pendant l'entraînement.
generation_config.json fournit temperature 0.6 et top_p 0.95, que vLLM charge automatiquement ; les paramètres explicites de la requête les remplacent.
Tableau d'évaluation de Paradigma (evaluations.png), Limite-1B-Violetto : AIME 2026 94,01, HMMT Feb 2026 83,62, APEX Shortlist 50,80, BeyondAIME 74,25, AIME 2025 90,21, HMMT Feb 2025 91,35, ArXivMath May 2026 25,08. Comparaisons sur AIME 2026 / BeyondAIME : MUSE-Glimmer-30B 93,44 / 70,00, VibeThinker-3B 93,85 / 72,00, MiniCPM5-2B 90,21 / 60,59, Qwen3.5-9B 90,42 / 65,56, Gemma-4-31B-IT 89,17 / 71,00, Qwen3.6-27B (dague) 94,10 / non rapporté, GLM 5.2 753B (dague) 99,20 / non rapporté, NVIDIA-Nemotron-3-Super 120B (dague) 91,67. Dague : repris des fiches de modèles ou de MathArena, non relancé par Paradigma. Limite n'a le meilleur score rapporté que sur BeyondAIME. D'autres lignes le battent sur les six autres colonnes : AIME 2026 (Qwen3.6-27B dague 94,10, GLM 5.2 dague 99,20, contre 94,01), HMMT Feb 2026 (Qwen3.6-27B dague 84,30, Nemotron-3-Super dague 84,85, Gemini 3 Pro dague 86,36, GLM 5.2 dague 92,50, contre 83,62), APEX Shortlist (MUSE-Glimmer-30B 51,66, Qwen3.5-27B dague 52,13, Nemotron-3-Super dague 57,45, Gemini 3 Pro dague 66,49, GLM 5.2 dague 68,09, contre 50,80), AIME 2025 (VibeThinker-3B 92,19, MUSE-Glimmer-30B 92,71, Gemini 3 Pro dague 95,00, contre 90,21), HMMT Feb 2025 (Qwen3.6-27B dague 93,80, Gemini 3 Pro dague 97,50, contre 91,35) et ArXivMath May 2026 (VibeThinker-3B 29,77, MUSE-Glimmer-30B 28,91, Qwen3.5-9B 31,64, Gemma-4-31B-IT 35,78, GLM 5.2 dague 56,67, entre autres, contre 25,08). MUSE-Glimmer-30B, le point de comparaison de la fiche du modèle, bat Limite sur APEX Shortlist, AIME 2025 et ArXivMath. Les notes de la fiche du modèle sous le tableau disent que les configurations d'évaluation peuvent différer selon les modèles et les sources.

Protocole d'évaluation
D'après limite-evals dans le dépôt de Paradigma :
- Dataset
MathArena/aime_2026(créé sur Hugging Face le 2026-02-13) à la révision10b4e45b7a503075d4da8a0d57916a4f06ce6bd2(suites.pylignes 40-41). La dernière révision du dataset diffère sur 2 lignes sur 30 ; nous avons utilisé celle qui est épinglée. Le dataset est sous CC BY-NC-SA 4.0 ; l'exemple le télécharge à l'exécution et ne le redistribue pas. - Consigne ajoutée en tête :
Solve the following math problem. Explain your reasoning and put the final answer in \boxed{}. - Paradigma rapporte AIME 2026 et BeyondAIME en avg@32 (
group_size=32,suites.pylignes 66-74, 373-380). - Budget de tokens
max_model_len - CONTEXT_RESERVE= 131 072 - 4 096 = 126 976 (cli.pylignes 51, 135).
Le nôtre : même révision du dataset, même consigne, temperature 0.6, top_p 0.95 et même budget, un échantillon par problème, noté sur le dernier \boxed{} de la réponse.
Pile de service et ses pièges
Pile vérifiée (README de Paradigma) : Python 3.12, vLLM 0.26.0, PyTorch 2.11.0 compilé pour CUDA 13.0, Transformers 5.6.2, Linux x86-64, GPU NVIDIA avec un driver CUDA 13.0. Service de référence :
git clone https://github.com/paradigma-inc/limite-violetto && cd limite-violetto
uv sync --locked
VLLM_PLUGINS=limite uv run --locked vllm serve paradigma-inc/limite-1b-violetto
# OpenAI-compatible API at http://localhost:8000/v1, POST /v1/chat/completions
- Un plugin, pas l'upstream.
limite-vllm0.1.0 (Apache-2.0,requires-python ~=3.12.0,torch>=2.11.0,transformers>=5.6.2,vllm>=0.26.0, torch depuis l'indexpytorch-cu130) s'enregistre via[project.entry-points."vllm.general_plugins"] limite = "limite_vllm.register:register". Il enregistreLimiteConfigauprès d'AutoConfigetLimiteForCausalLMauprès duModelRegistryde vLLM. Sans l'enregistrement de la config, vLLM échoue avec un trompeur "Transformers does not recognize this architecture". DéfinissezVLLM_PLUGINS=limite. - Parallélisme de données uniquement. Le plugin lève
Limite modeling supports data parallelism only.pour le parallélisme tensoriel ou pipeline, rejetteinputs_embeds, et lève une erreur siCacheConfig.sliding_windowde vLLM est défini ("Limite interleaves local and unwindowed global layers"). Gardez TP et PP à 1. - CUDA 13 épinglé. torch 2.11.0 vient de l'index cu130 ; le driver de l'hôte doit prendre en charge CUDA 13.0 (580+).
- Voie Transformers. Demande
trust_remote_code=True, validée sur une H100, SDPA par défaut. FlashAttention 2 avecStaticCacheest rejeté avec une erreur explicite parce qu'il "does not produce numerically correct logits for Violetto's hybrid local/global attention layout". Utilisez SDPA avecStaticCacheou FA2 avecDynamicCache. Pas de sharding, de TP ni de PP dans Transformers ; l'entraînement et LoRA ne sont pas formellement validés. Nous n'avons pas utilisé cette voie. - Prompt système fixe. L'usage en un seul tour est une consigne de la fiche du modèle, pas quelque chose que le template impose.
chat_template.jinjacode en dur le prompt systèmeYou are a helpful assistant.\nPlease reason step by step, and put your final answer within \boxed{}.et lève une erreur sur les outils, les appels d'outils, le contenu qui n'est pas une chaîne, tout message système personnalisé ou d'autres rôles. - HEAD du dépôt du plugin au moment du test :
7ddad34f5e3d25ddea68c6745fc00373b82bca21"Fix stale documentation references" (2026-10-06) ; les commits antérieurs incluent "Fix Limite EOS token ID" et "Relax vLLM runtime pins".
Notre installation
- RTX 4090 24 GB, louée à l'heure sur notre cloud (24 564 MiB, driver 595.91.07, 450 W, 0,89 USD/h) pour l'examen complet et les barreaux émulés de l'échelle.
- RTX 2000 Ada 16 GB, louée à l'heure sur notre cloud (16 380 MiB, 70 W, 0,24 USD/h) pour le barreau sur petite carte réelle. Une A4000 16 GB était en rupture de stock. Aucune carte de 8 GB ou 12 GB n'était proposée ni en stock.
- Workers amorcés par un manager InferenceKey local via des tunnels HTTP et TCP ; la production n'a jamais été touchée.
- Pourquoi un backend sur mesure : le backend
vllmintégré n'accepte que les clés de configcommand,vllm_version,vllm_omni_version,torch_versionettransformers_version(crates/manager/src/domain/workloads.rs), il ne peut donc pas installer un plugin hors arbre.
Déploiement pas à pas
L'exemple du SDK, commits b3ed051ffbf41fcacf6fa9cf7a438b9b9898afb8 (exemple) et 1671fdd03d25ed01c147f48190bd906b22451f77 (correction du décompte) sur main. Fichiers : backend.py, requirements.txt, publish.py, main.py, README.md, .env.example.
Il vous faut un driver NVIDIA pour CUDA 13.0 (580+), Python 3.12 sur le worker, un token SDK InferenceKey, une clé API, un slug de projet et IK_WORKER_ID.
git clone https://github.com/inferencekey/inferencekey-sdk && cd inferencekey-sdk/examples/limite-1b-violetto-math-custom-backend-private-nvidia
cp .env.example .env                      # SDK token, API key, project, IK_WORKER_ID
python -m venv .venv && . .venv/bin/activate
pip install maturin requests pyarrow
(cd ../../bindings/python && maturin develop --release)
python publish.py                         # once: packages and registers the custom backend
Avant la première exécution, le runtime du worker : jusqu'à la prochaine version du SDK, le worker a besoin du runtime de bindings/python sur main, pas du paquet PyPI inferencekey. Pendant notre test, nous avons modifié à la main le manifeste du worker pour faire pointer INFERENCEKEY_SDK_PYTHON_DIR vers une copie du runtime pur Python du clone du SDK (sdk 1e88eda) et relancé bootstrap-worker.sh ; cela demande un accès manuel à l'environnement du worker. Sans cela, chaque requête de chat, y compris la première, reçoit un 404 et le client reste bloqué jusqu'au timeout de premier token de 180 s. Ensuite :
python main.py # AIME 2026 problem 1
Avant de lancer plus d'un problème, augmentez la concurrence. ensure() crée l'assignation avec max_in_flight 1, donc les problèmes passent un par un. Augmentez-la (nous avons utilisé 32) dans le panneau ou avec PATCH /api/projects/<project>/assignments/<workload>/<worker>, puis :
python main.py --problems all # all 30, streamed in parallel once max_in_flight is raised
En option : LIMITE_GPU_MEMORY_UTILIZATION (0.90 par défaut) et IK_KEEP_ALIVE=1 (garder le workload après l'exécution ; par défaut main.py le supprime).
main.py appelle ensure() (slug du backend sur mesure, ready_timeout_secs 1800, request_timeout_secs 3600, max_model_len 131072, gpu_memory_utilization), puis wait_until_ready, télécharge MathArena/aime_2026 à la révision épinglée, ajoute en tête la consigne de l'évaluateur, envoie les problèmes en streaming avec MAX_TOKENS 126 976, note le dernier \boxed{} et écrit outputs/aime26.json.
requirements.txt épingle vllm==0.26.0, transformers==5.6.2, ninja, inferencekey et limite-vllm @ git+https://github.com/paradigma-inc/limite-violetto@7ddad34f5e3d25ddea68c6745fc00373b82bca21.
backend.py (classe LimiteVioletto) démarre vllm serve paradigma-inc/limite-1b-violetto --max-model-len 131072 --gpu-memory-utilization 0.90 sur loopback avec VLLM_PLUGINS=limite, ajoute le bin du venv en tête du PATH (pour que FlashInfer trouve ninja), définit PR_SET_PDEATHSIG via prctl sur le processus enfant vLLM, lui transmet chat() et chat_stream(), expose process() pour les appelants de /process, et supprime tout message système qui n'est pas le canonique. Versions du backend pendant le test : 0.1.0 (échec, pas de ninja), 0.1.1 (ninja), 0.1.2 (PR_SET_PDEATHSIG).
Délai de disponibilité
- RTX 4090, premier démarrage (backend 0.1.0) : installation des requirements par
uv23 s, téléchargement et chargement des poids 16,1 s ("Model loading took 1.95 GiB and 16.06 seconds"),torch.compile53,1 s, puis un crash au warmup (pas deninja).ensure()a signalé l'échec à 130 s. - RTX 4090 à chaud (caches uv, Hugging Face et
torch.compilesur la machine) : 31,2, 31,1, 31,5 et 31,1 s aprèsensure(). - RTX 2000 Ada, machine neuve : 300,5 s (venv et requirements 54 s, chargement 12,9 s,
torch.compile103,4 s, initialisation du moteur 194 s).
Vitesse
| Carte / config | Tokens/s par requête | Source |
|---|---|---|
| RTX 4090, util 0.90, via l'endpoint | 211 (2 913 tokens en 13,8 s, premier token 0,29 s) | chronométrage client, vllm:generation_tokens_total |
| RTX 4090, directement sur vLLM avec 2 autres séquences en cours | 156,7 / 155,4 | chronométrage client |
| RTX 4090, 30 requêtes en même temps | pic d'environ 3 636 au total (30 en cours), environ 120 par requête | logger de vLLM |
| RTX 4090, plafond 0.25 | 215 / 212 | exécution de l'échelle |
| RTX 4090, plafond 0.17 | 213 / 209 | exécution de l'échelle |
| RTX 2000 Ada, util 0.90 | 85 / 85 | exécution sur carte réelle |
Le temps par sortie plus long du barreau 0.17 dans l'échelle (21,2 s contre 13,8 s) vient d'une réponse plus longue (4 522 tokens contre 2 913), pas d'un décodage plus lent.
AIME 2026, résultats complets
RTX 4090, util 0.90, un essai par problème, temperature 0.6, top_p 0.95, budget 126 976.
- Lot 1, les 30 en même temps : 26 terminés, 25 justes. N° 15 faux (a répondu 10, officiel 83, environ 84K tokens, 881 s). N° 9, 13, 28 et 30 perdus à cause du bug de notre client. Durée totale 981,5 s, fixée par le n° 10 (environ 101 404 tokens, 981 s, juste). Les réponses terminées allaient de 3 203 à 101 404 tokens, environ 702 107 au total, soit une moyenne de 715 tokens/s sur le lot (le pic de 3 636 retombe à mesure que les réponses courtes se terminent).
- Relance des 4 perdus : n° 13 juste (39, environ 19K tokens), n° 30 juste (393, environ 52K), n° 9 faux (5 contre 29, environ 23K), n° 28 sans réponse (le stream s'est terminé après environ 111 131 tokens à 830 s avec
finish_reason: stop, au milieu d'une phrase, sans\boxed{}; cause non isolée). - Total : 27 justes, 2 faux, 1 sans réponse (27/30 = 90 %, un essai). Pas comparable à un avg@32.
- Tokens par problème, sur les 30 tentatives finales (tokenizer du modèle sur le texte streamé, puisque l'usage n'est pas transmis dans le stream) : total 907 601, moyenne environ 30 253, médiane environ 21 267, de 3 203 (n° 1) à environ 111 131 (n° 28). Les 27 justes : 689 233 tokens, médiane 19 192.
generation_tokens_totalde vLLM indiquait environ 1 062 530 après le lot 1, au-dessus du décompte client, parce que les requêtes dont le client était mort ont continué à générer sur le serveur.- Exécution de démo (5 problèmes en même temps avec 2 longues requêtes en parallèle) : 5 justes sur 5 en 96 s, 38 303 tokens, environ 400 tokens/s sur l'ensemble des requêtes.
Coût par problème résolu (notre calcul)
Lot 1 : 981,5 s à 0,89 USD/h = environ 0,243 USD = environ 0,217 EUR (change 0,89342 USD/EUR, 2026-10-23) pour 25 résolus, soit environ 0,0087 EUR par problème résolu, ou environ 115 résolus par euro de temps GPU du lot. Cela exclut l'installation, le démarrage et le temps d'inactivité, et le lot n'était pas trié par longueur.
Échelle de VRAM, chiffres complets
| Cible | Config | Pic de mémoire de la carte | Vitesse | Sortie OK | Carte réelle |
|---|---|---|---|---|---|
| RTX 4090 24 GB | util 0.90, contexte 131 072, KV 18,75 GiB (1 465 844 tokens) | 22 768 MiB (vLLM la réserve d'emblée) | 211 tok/s, 13,8 s par sortie | oui (27/30) | oui |
| plafond ~6 GB sur 4090 | util 0.25, KV 3,69 GiB (288 515 tokens) | 7 118 MiB | 215 / 212 tok/s ; n° 1 et n° 5 justes | oui | émulée |
| plafond ~4 GB sur 4090 | util 0.17, KV 1,81 GiB (141 408 tokens) | 5 198 MiB | 213 / 209 tok/s ; n° 1 et n° 5 justes | oui | émulée |
| plafond ~3 GB sur 4090 | util 0.12 | n/a | ValueError: To serve at least one request with the model's max seq len (131072), (1.68 GiB KV cache is needed, which is larger than the available KV cache memory (0.63 GiB)... estimated maximum model length is 39872 | non, ne démarre pas | émulée |
| RTX 2000 Ada 16 GB | util 0.90, KV 11,64 GiB (909 801 tokens) | non échantillonné (l'échantillonneur n'a pas démarré sur cette machine) | 85 tok/s, 33,5 s par sortie ; n° 1 et n° 5 justes | oui | oui |
Les barreaux émulés plafonnent la part de vLLM avec --gpu-memory-utilization ; le contexte CUDA se trouve hors du plafond, d'où 7 118 et 5 198 MiB sur la carte. Ils émulent seulement la mémoire, pas le calcul ni la bande passante d'une carte plus petite. Un --max-model-len plus court permettrait au plafond 0.12 de démarrer ; nous ne l'avons pas essayé, et cela couperait les réponses qui ont dépassé 40K tokens. Non essayé : de vraies cartes de 8 GB et 12 GB.
Problèmes rencontrés
- Le paquet PyPI
inferencekey0.260725.739 n'a pas de runtimechat(). Avec le manifesteapi: openai-chat, le worker a routé le chat vers/v1/chat/completionset a reçu404 {"error": "not found"}. Contournement : définirINFERENCEKEY_SDK_PYTHON_DIRsur le worker vers un runtime pur Python plus récent du dépôt du SDK. Ouvert jusqu'à une version du SDK ; le README de l'exemple le documente comme problème connu. - Erreur de stream non remontée. Sur ce 404, le client n'a reçu aucun événement d'erreur et a attendu jusqu'au timeout de premier token de 180 s. Ouvert.
- Il manquait
ninjadans le venv du backend sur mesure. Le warmup de vLLM a crashé avecFileNotFoundError: [Errno 2] No such file or directory: 'ninja'(JIT de FlashInfer) ; le worker n'installe ninja que pour le backend vllm intégré. Corrigé dans l'exemple (wheelninjaplusbindu venv dans lePATH). vllm serveorphelin. Supprimer un workload dont lesetup()attendait encore n'a arrêté que le pid du backend ; vLLM a gardé 22,5 GB avec PPID 1. Corrigé dans l'exemple avecPR_SET_PDEATHSIG(backend 0.1.2), vérifié.ensure()crée l'assignation avecmax_in_flight1. Nous l'avons passé à 32 par PATCH pour le lot. Relancerensure()sur un workload déjà prêt est resté bloqué danswait_until_readypendant 5 minutes ; nous avons utilisé à la place un script de bench contre l'endpoint prêt. Ouvert.- Le bug de notre client.
requests.iter_lines(decode_unicode=True)a découpé des lignes SSE sur un séparateur Unicode à l'intérieur d'un token, ce qui a donnéJSONDecodeErroret fait perdre 4 réponses sur 30 dans le lot 1. Corrigé en découpant sur les octets. Les clients tués laissent leurs requêtes générer sur le serveur. - L'usage n'est pas transmis dans le stream. Les décomptes de tokens viennent du tokenizer appliqué au texte. Ouvert.
- N° 28 s'est terminé après environ 111K tokens avec
finish_reason: stopet sans réponse ; non isolé. - L'échantillonneur de mémoire GPU n'a pas démarré sur la machine RTX 2000 Ada, ce barreau n'a donc pas de pic de mémoire de la carte.
Vidéo de démo
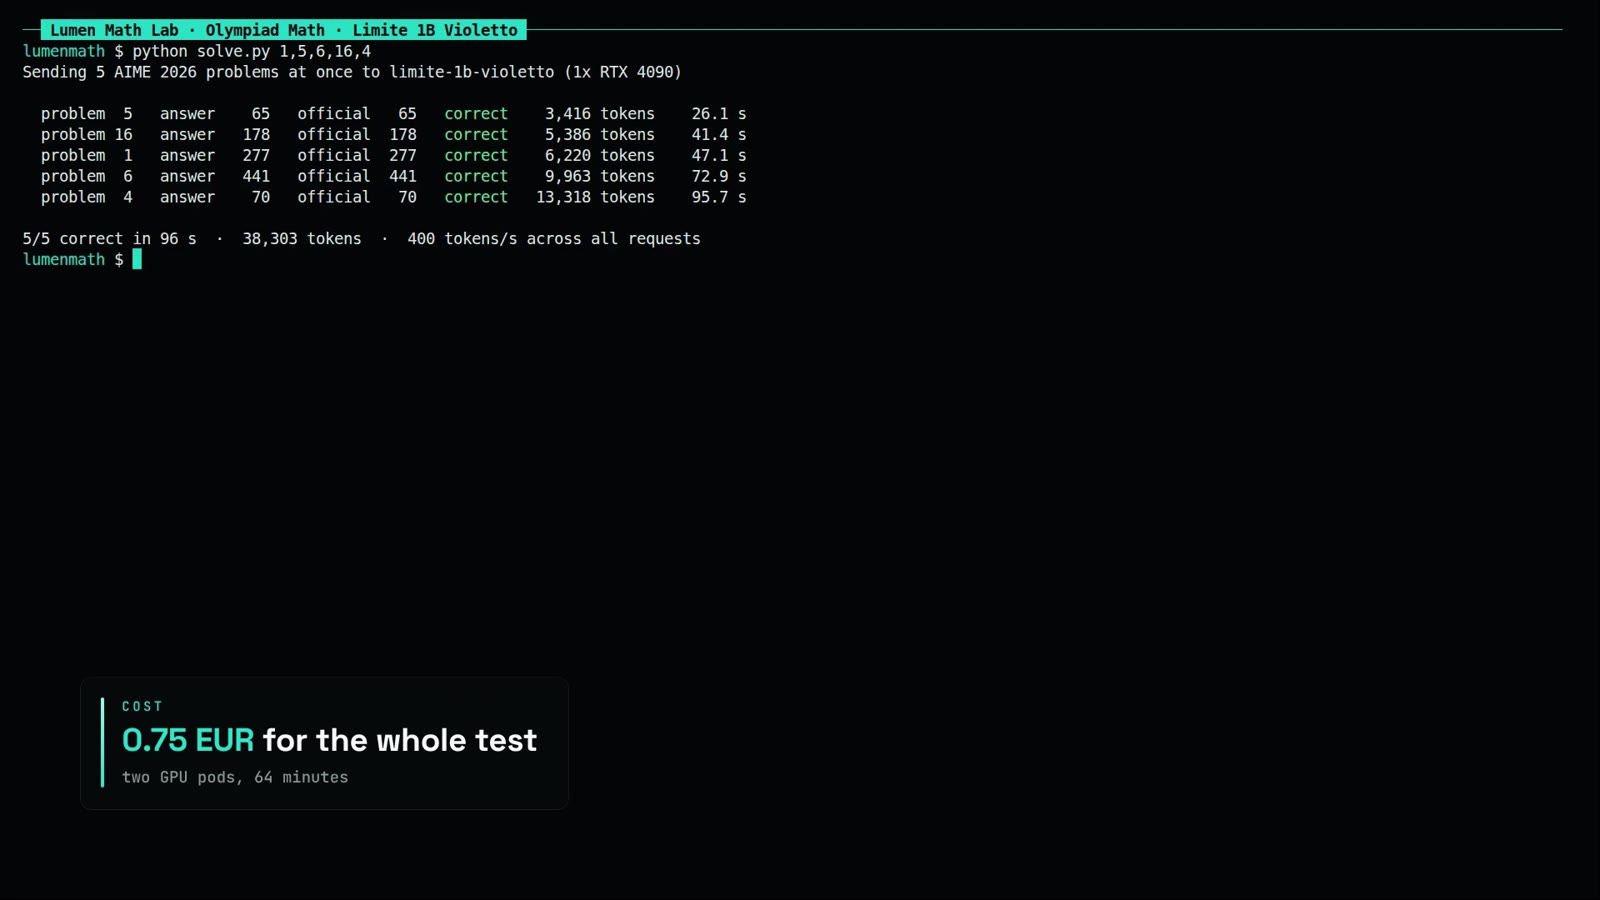
Démo de déploiement narrée, 2 min 34 s, 1920 x 1080 : le workload sur une RTX 4090, puis cinq problèmes (1, 5, 6, 16 et 4) résolus en même temps, 5 justes sur 5 en 96 secondes.
Sources
- Fiche du modèle : https://huggingface.co/paradigma-inc/limite-1b-violetto (README,
config.json,generation_config.json,chat_template.jinja,assets/evaluations.png) - Plugin et évaluations : https://github.com/paradigma-inc/limite-violetto (README,
pyproject.toml,src/limite_vllm/register.py,src/limite_vllm/modeling.py,limite-evals/src/limite_evals/suites.py,cli.py) - Blog : https://paradigma.inc/blog/limite-1b-violetto/
- Dataset : https://huggingface.co/datasets/MathArena/aime_2026
- Où nous l'avons repéré : AI Search, https://www.youtube.com/watch?v=nX0fgBL3sIM (27 septembre 2026, vers 0:31:46)
- Notre exemple du SDK : https://github.com/inferencekey/inferencekey-sdk/tree/main/examples/limite-1b-violetto-math-custom-backend-private-nvidia