Limite 1B resolvió 27 de 30 problemas del AIME 2026 al primer intento, a menos de un céntimo cada uno en lote
Evaluamos el modelo matemático de 1B de Paradigma en el AIME 2026: 27 de 30 a la primera, 211 tokens/s en una RTX 4090 y una de 16 GB real también sirvió.
Una tabla de benchmarks es una promesa, y un modelo tan barato de ejecutar es fácil de comprobar. Paradigma dice que su Limite 1B Violetto, un modelo de matemáticas en un fichero de 2,1 GB, saca un 94 % en el AIME 2026, el examen por invitación de Estados Unidos para los mejores estudiantes de secundaria. Así que lo corregimos nosotros mismos en una RTX 4090 de nuestra nube. Acertó 27 de los 30 problemas, con un intento cada uno. Una tarjeta real de 16 GB también funcionó. Con los 30 problemas a la vez, el lote entero costó unos 22 céntimos de euro de tiempo de GPU. Nuestro ejemplo del SDK lo despliega y lo corrige por ti.
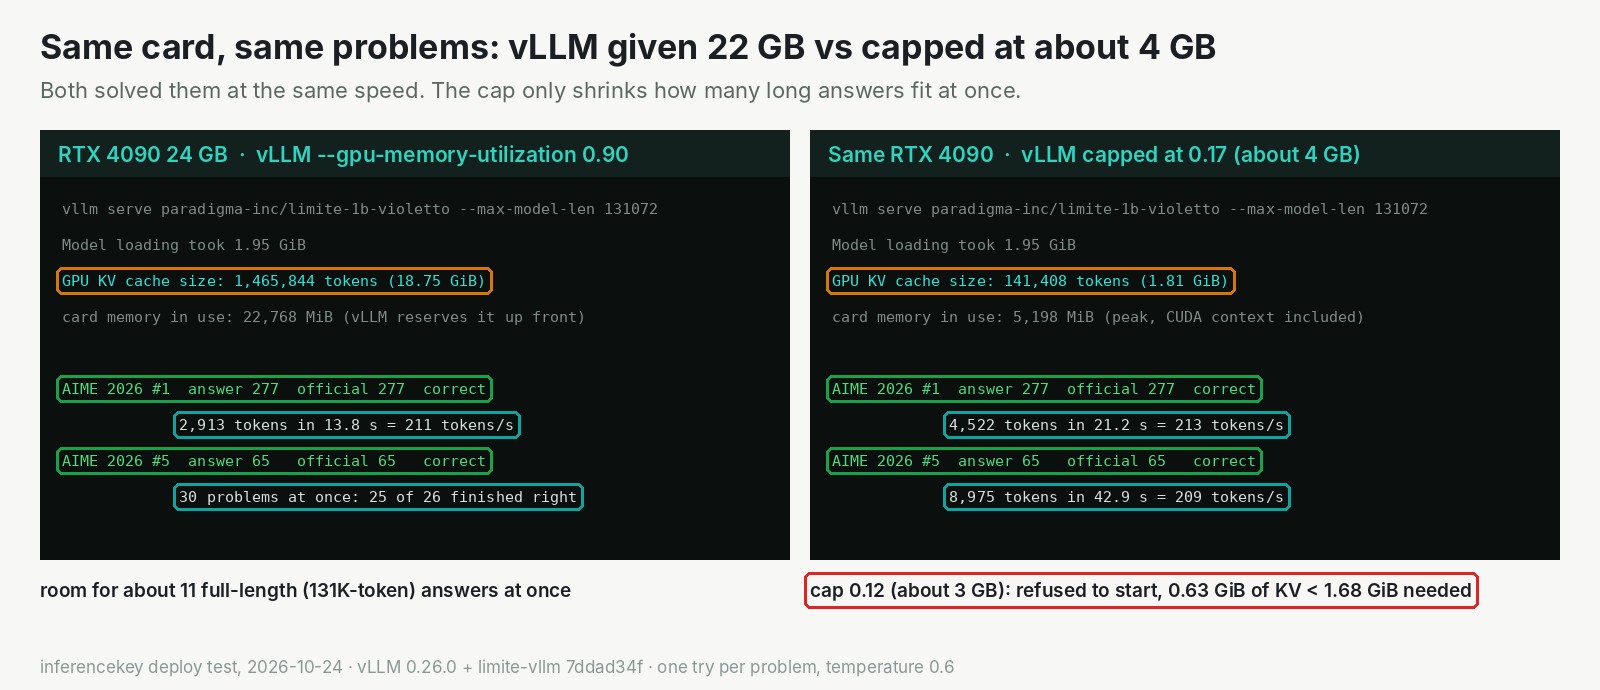
Misma tarjeta, mismos problemas. El límite de memoria no hizo más lenta ninguna respuesta. Solo reduce cuántas respuestas largas entran a la vez.
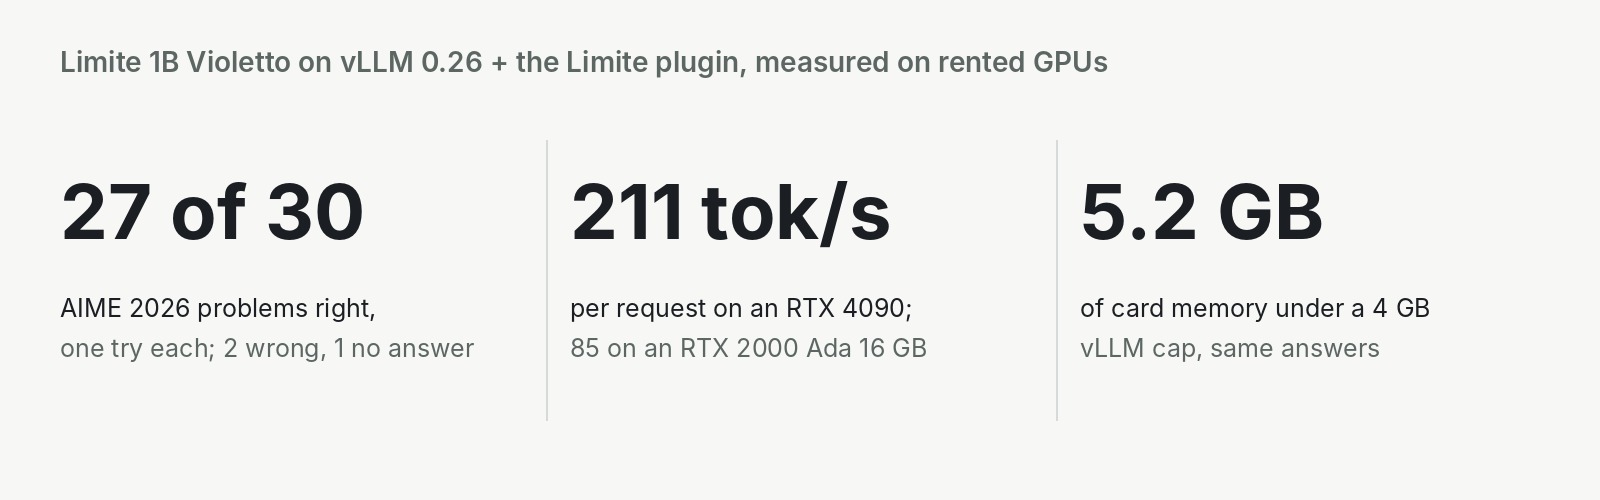
Un modelo de 2 GB entrenado desde cero para hacer una sola cosa
Limite 1B Violetto es el primer modelo de Paradigma. La afirmación que nos hizo mirarlo está en la ficha del modelo: "Limite logra una media del 74,25 % en BeyondAIME, con MUSE-Glimmer-30B en el 70 %". BeyondAIME es otro conjunto de problemas de competición. MUSE-Glimmer-30B es un modelo treinta veces más grande. En la tabla de evaluación de Paradigma, Limite saca un 94,01 % en el AIME 2026, y esa es la cifra que podíamos comprobar.
Hace matemáticas de competición y nada más. Es un único fichero de 2,1 GB, lo bastante pequeño para una tarjeta barata.
Limite no gana en todas las pruebas de esa tabla. De sus siete pruebas, BeyondAIME es la única en la que Limite tiene la puntuación más alta publicada. Qwen3.6-27B (94,10) y GLM 5.2 (99,20) quedan por encima en el AIME 2026, y las dos cifras están copiadas de otras fuentes, no las volvió a medir Paradigma. El propio MUSE-Glimmer-30B le gana en tres pruebas. No es el que más puntúa, pero está entre modelos decenas de veces más grandes.
El mérito es de quienes lo construyeron. El blog firma como autores a Prignano, Cirillo, Morosini, Cerovaz, Bartolocci, Rodolà, Starace y Pappone. Entrenaron el modelo en unas seis semanas. Lo publicaron bajo Apache 2.0, con su código de evaluación y un modelo auxiliar del entrenamiento. También escribieron un plugin para que vLLM, el programa de código abierto que sirve modelos, pueda ejecutarlo. Han anunciado un informe técnico para más adelante. Los problemas del AIME que corregimos vienen de MathArena, que publica los problemas como dataset para evaluar modelos.
Vimos Limite en el vídeo de noticias de AI Search del 27 de septiembre. El presentador comentó que "el tamaño total de todo es de solo unos 2 gigabytes". Ejecutamos la versión que Paradigma actualizó por última vez el 6 de octubre. Lo nuestro fue el resto: meter su plugin en un paquete desplegable, ejecutarlo en dos tarjetas y corregir cada respuesta.
La prueba: 30 problemas, un intento cada uno, corregidos por nosotros
Nuestra cifra puede confirmar que el modelo está en el rango de Paradigma, no fijarla al decimal. El 94,01 % de Paradigma es una media de 32 intentos por problema. Nosotros dimos un intento por problema, como un estudiante que hace el examen una vez, y una sola convocatoria tiene más ruido que 32.
Todo lo demás copia la configuración de evaluación de la propia Paradigma. Los mismos 30 problemas, en la versión exacta del dataset que fija su evaluador. La misma instrucción delante de cada problema, que pide la respuesta final dentro de un recuadro. Los mismos ajustes de muestreo, que dejan algo de aleatoriedad en cada respuesta. El mismo presupuesto de escritura, algo menos de 127.000 tokens por respuesta. Después, nuestro script comparó la última respuesta en recuadro con la oficial.
No ejecutamos BeyondAIME, así que la comparación con MUSE-Glimmer-30B sigue siendo una afirmación de Paradigma. No comprobamos si Limite vio estos problemas durante el entrenamiento. El AIME 2026 era público desde febrero, meses antes del entrenamiento. En un conjunto más reciente, ArXivMath de mayo de 2026, saca un 25 % frente a cerca del 57 % de GLM 5.2. Nuestro resultado es coherente con la cifra de Paradigma en este conjunto, no una prueba de que el modelo resuelva matemáticas que nunca ha visto. Solo corregimos el número final en recuadro, no el razonamiento. Lo ejecutamos en nuestra nube a través de una compilación local de prueba de InferenceKey, no en el servicio alojado.
Resultados: 27 de 30 bien al primer intento, con respuestas correctas de 3.000 a 101.000 tokens
| Resultado | Problemas | Detalle |
|---|---|---|
| Bien | 27 | |
| Mal | 2 | El #9 respondió 5 (oficial 29), el #15 respondió 10 (oficial 83) |
| Sin respuesta | 1 | El #28 escribió unos 111.000 tokens durante 14 minutos y se paró a mitad de frase |
No pudimos aislar por qué se paró el #28. Terminó a mitad de frase con una señal de parada normal, unos 16.000 tokens antes de agotar el presupuesto de escritura. Cuenta como fallo.
El modelo escribe mucho antes de responder. Un modelo así trabaja en papel, como lo harías tú: prueba un enfoque, lo comprueba, da marcha atrás y prueba otro. Todo eso es texto que genera, y esperas cada uno de sus tokens. La respuesta correcta más corta, la del problema 1, llevó 3.203 tokens. La más larga, la del problema 10, llevó unos 101.000 tokens de desarrollo antes de poner el resultado correcto en el recuadro. La mitad de los problemas necesitó menos de unos 21.000 tokens.
Esa longitud lo condiciona todo. Primero mandamos los 30 problemas a la vez. La tarjeta trabajó en todos juntos y, en su pico, escribía unas 17 veces más rápido que con una sola respuesta. Pero un lote se comporta como un aula de examen que solo cierra cuando el último estudiante entrega. Las respuestas más cortas volvieron en bastante menos de un minuto. El aula siguió abierta 16 minutos, porque el problema 10 seguía escribiendo. Cuatro respuestas que se perdieron por un bug de nuestro propio cliente de prueba se repitieron.
Sola, una respuesta va a unos 211 tokens por segundo en la 4090. Suena rápido, pero un problema típico de 21.000 tokens sigue tardando menos de dos minutos, y el más largo ocho. A este modelo se le pasa un montón de problemas, no se charla con él.
Un problema resuelto cuesta menos de un céntimo de euro con la tarjeta llena
El lote de 30 problemas costó unos 22 céntimos de euro en una RTX 4090 a unos 0,80 euros la hora, y 25 respuestas salieron bien. Esa cifra cuenta solo el tiempo que la tarjeta estuvo ocupada, no el arranque ni el tiempo parado.
Es el lote lo que da esa cifra: una sola respuesta deja la tarjeta casi parada. Agrupar los problemas por longitud esperada debería recortar la espera; no lo probamos.
Dónde falla: una pregunta cada vez, y solo matemáticas
Limite responde una pregunta de matemáticas por conversación, con una instrucción inicial fija, y Paradigma lo dice de entrada. La ficha del modelo pide enviar solo su instrucción inicial estándar y la pregunta actual, sin mensajes anteriores. Esa regla es un consejo de Paradigma. Su formato de entrada no lo impone, pero rechaza una instrucción inicial personalizada o herramientas.
Pregúntale otra cosa y convierte tu pregunta en matemáticas. El propio blog de Paradigma lo enseña. "¿Qué es la fotosíntesis?" volvió como un problema sobre células que se dividen. "¿Qué causa las estaciones en la Tierra?" se convirtió en una respuesta sobre el ciclo de 400 años del calendario gregoriano. Una instrucción colada para que escribiera BANANA recibió de vuelta matemáticas sobre una secuencia llamada BANANA. En un modelo de matemáticas tiene su gracia, y para cualquier otra cosa lo descarta. No es un asistente de chat, ni una herramienta para un agente, ni un ayudante general.
Nuestro código de despliegue resuelve una parte de esto por ti. Descarta cualquier instrucción inicial que no sea la estándar, para que a una app hecha para un modelo de chat no le rechacen la petición.
Qué GPU: una tarjeta real de 16 GB funcionó, y un límite de 4 GB pasó dos problemas cortos
No te hace falta una 4090: una RTX 2000 Ada real de 16 GB, una tarjeta pequeña de estación de trabajo, resolvió bien los problemas 1 y 5, 2,5 veces más despacio.
Para bajar más sin ir a buscar tarjetas, le dijimos a vLLM que usara solo parte de la memoria de la 4090. Eso emula la memoria de una tarjeta más pequeña, no su chip más lento. Esta es la escalera, de mayor a menor:
| Tarjeta o límite | Memoria de la tarjeta usada | Problemas 1 y 5 | Velocidad por respuesta | Tarjeta real o emulada |
|---|---|---|---|---|
| RTX 4090 24 GB, 90 % para vLLM | unos 22,8 GB | bien | 211 tokens/s | real |
| RTX 2000 Ada 16 GB, 90 % para vLLM | no medida | bien | 85 tokens/s | real |
| 4090 limitada a unos 6 GB | unos 7,1 GB | bien | 215 y 212 tokens/s | emulada |
| 4090 limitada a unos 4 GB | unos 5,2 GB | bien | 213 y 209 tokens/s | emulada |
| 4090 limitada a unos 3 GB | no arrancó | emulada |
En las ejecuciones con límite, la tarjeta usó cerca de 1 GB más que el límite.
Lo que cambia el límite es cuántas respuestas largas entran a la vez. El servidor reserva memoria para cada respuesta que está escribiendo. Con el límite de 4 GB esa memoria tenía sitio para más o menos una respuesta de longitud completa; los 24 GB enteros admitían unas once. Con el límite solo ejecutamos dos problemas cortos, y no probamos tarjetas reales de 8 GB ni de 12 GB.
Con unos 3 GB el servidor se negó a arrancar. Quiere sitio para una respuesta a la longitud máxima del modelo, 131.072 tokens, y el espacio que quedaba no llegaba. vLLM sugirió un límite más corto, de unos 40.000 tokens, que cortaría las respuestas más largas que vimos. No lo probamos.
En InferenceKey: listo en 31 segundos, con el plugin de Paradigma dentro de un backend a medida
La tarjeta es tuya por horas, así que puedes instalar en ella el código de servidor del propio modelo. No te limitas a lo que empaquetamos de antemano. Eso es lo que necesitaba Limite. Nuestra opción de vLLM integrada instala solo vLLM, y este modelo necesita el plugin de Paradigma encima. Así que escribimos un backend a medida: un fichero Python corto que instala las versiones exactas que verificó Paradigma, arranca vLLM con el plugin activado y le pasa las preguntas. Tu código lo llama igual que llama a la API de chat de OpenAI.
Con todo ya descargado en la tarjeta, un reinicio estuvo listo en 31 segundos, cuatro veces seguidas. Una RTX 2000 Ada recién estrenada tardó cinco minutos la primera vez, cerca de un tercio de ellos compilando el modelo para esa tarjeta. El montaje necesita un driver de NVIDIA reciente y Python 3.12, como exige el plugin de Paradigma.
Un problema con el que también te vas a topar:
- Nuestro SDK publicado todavía no puede responder peticiones de chat. La máquina con GPU devolvía "not found" a cada pregunta. El cliente esperaba entonces tres minutos hasta un timeout en lugar de mostrar un error. Lo apuntamos al código más nuevo del repositorio del SDK y funcionó. Estado: abierto hasta la próxima versión del SDK. El README del ejemplo documenta el problema. El apaño, en la sección para ingenieros más abajo, obliga a editar a mano la configuración de la máquina con GPU.
¿Deberías usarlo? Sí para matemáticas de concurso en una tarjeta pequeña, no para nada conversacional
- Si necesitas soluciones desarrolladas de problemas tipo competición con una única respuesta final, merece la pena ejecutarlo. Comprueba la respuesta del recuadro antes de fiarte.
- Si necesitas un asistente de chat, herramientas o preguntas de seguimiento, busca en otra parte. Responde una pregunta de matemáticas cada vez y convierte todo lo demás en matemáticas.
- Si necesitas respuestas rápidas para una persona, es la herramienta equivocada: recorre páginas de razonamiento antes de cada respuesta.
- Si tu tarjeta es pequeña, mira la sección de GPU.
- Si necesitas una licencia para un producto, Apache 2.0 cubre el uso comercial.
Para corregir el problema 1 del AIME 2026 en tu propia GPU NVIDIA, publica el backend con python publish.py y ejecuta python main.py desde el ejemplo del SDK. Necesita un proyecto de InferenceKey, un driver para CUDA 13.0 (580 o más reciente), Python 3.12 y, hasta la próxima versión del SDK, el código más nuevo del SDK en la máquina con GPU.
Para ingenieros
Modelo y ficheros
Ficha del modelo, GitHub (paradigma-inc/limite-violetto), blog de Paradigma. Repo paradigma-inc/limite-1b-violetto, creado el 2026-09-21, lastModified 2026-10-06T21:59:07Z, sha 9f4d1567975a44c35127503deadfe52d434d734f, licencia Apache-2.0, 16.841 descargas y 125 likes a 2026-10-24. Historial de ficheros (API de árbol de HF): model.safetensors con último commit el 2026-09-21 ("Add files using upload-large-folder tool"); config.json, generation_config.json y contract.py el 2026-09-29 (arreglo del token EOS); configuration_limite.py, modeling_limite.py y README.md el 2026-10-06 (restricciones de paralelismo de datos en Transformers). Un único model.safetensors de 2.070.811.520 bytes; los metadatos safetensors cuentan 1.035.253.888 parámetros (1.035.141.120 en BF16 más 112.768 en F32).
config.json: LimiteForCausalLM, model_type: limite, código propio (auto_map a configuration_limite.py / modeling_limite.py). 48 capas, hidden 1.280, intermediate SwiGLU 3.328, 10 cabezas de atención, 2 cabezas KV, head_dim 128, vocabulario 151.680, embeddings atados, max_position_embeddings 131.072. Atención híbrida: 36 capas locales con sliding_window 1.024 y 12 capas globales (3, 7, ..., 47; global_every 4) con global_nope: true (sin codificación posicional en las capas globales). El README de GitHub sitúa el 94,01 % del AIME 2026 en unos 1,71 x 10^21 FLOPs de entrenamiento estimados (sin contar el RL). La ficha del modelo dice que la arquitectura está "muy inspirada en los avances recientes de la comunidad en las competiciones de speedrun de preentrenamiento"; tiene alrededor de 1B de parámetros (de ahí el "1B") y el equipo lo entrenó desde cero con menos de 300.000 millones de tokens seleccionados, y después aplicó un post-entrenamiento de SFT seleccionado y RL con datos sintéticos. Los "parámetros" son los números que un modelo aprende durante el entrenamiento. La publicación incluye también un value model usado durante el entrenamiento.
generation_config.json trae temperature 0,6 y top_p 0,95, que vLLM carga automáticamente; los parámetros explícitos de la petición los sobrescriben.
Tabla de evaluación de Paradigma (evaluations.png), Limite-1B-Violetto: AIME 2026 94,01, HMMT Feb 2026 83,62, APEX Shortlist 50,80, BeyondAIME 74,25, AIME 2025 90,21, HMMT Feb 2025 91,35, ArXivMath May 2026 25,08. Comparativas en AIME 2026 / BeyondAIME: MUSE-Glimmer-30B 93,44 / 70,00, VibeThinker-3B 93,85 / 72,00, MiniCPM5-2B 90,21 / 60,59, Qwen3.5-9B 90,42 / 65,56, Gemma-4-31B-IT 89,17 / 71,00, Qwen3.6-27B (daga) 94,10 / no publicado, GLM 5.2 753B (daga) 99,20 / no publicado, NVIDIA-Nemotron-3-Super 120B (daga) 91,67. Daga: tomado de fichas de modelos o de MathArena, no vuelto a medir por Paradigma. Limite tiene la puntuación más alta publicada solo en BeyondAIME. Otras filas le ganan en las otras seis columnas: AIME 2026 (Qwen3.6-27B daga 94,10, GLM 5.2 daga 99,20, frente a 94,01), HMMT Feb 2026 (Qwen3.6-27B daga 84,30, Nemotron-3-Super daga 84,85, Gemini 3 Pro daga 86,36, GLM 5.2 daga 92,50, frente a 83,62), APEX Shortlist (MUSE-Glimmer-30B 51,66, Qwen3.5-27B daga 52,13, Nemotron-3-Super daga 57,45, Gemini 3 Pro daga 66,49, GLM 5.2 daga 68,09, frente a 50,80), AIME 2025 (VibeThinker-3B 92,19, MUSE-Glimmer-30B 92,71, Gemini 3 Pro daga 95,00, frente a 90,21), HMMT Feb 2025 (Qwen3.6-27B daga 93,80, Gemini 3 Pro daga 97,50, frente a 91,35) y ArXivMath May 2026 (VibeThinker-3B 29,77, MUSE-Glimmer-30B 28,91, Qwen3.5-9B 31,64, Gemma-4-31B-IT 35,78, GLM 5.2 daga 56,67, entre otros, frente a 25,08). MUSE-Glimmer-30B, el modelo con el que se compara la ficha, gana a Limite en APEX Shortlist, AIME 2025 y ArXivMath. Las notas de la ficha bajo la tabla dicen que las configuraciones de evaluación pueden variar entre modelos y fuentes.

Protocolo de evaluación
De limite-evals en el repo de Paradigma:
- Dataset
MathArena/aime_2026(creado en Hugging Face el 2026-02-13) en la revisión10b4e45b7a503075d4da8a0d57916a4f06ce6bd2(suites.py, líneas 40-41). La última revisión del dataset difiere en 2 de las 30 filas; usamos la fijada. El dataset es CC BY-NC-SA 4.0; el ejemplo lo descarga al ejecutarse y no lo redistribuye. - Instrucción antepuesta:
Solve the following math problem. Explain your reasoning and put the final answer in \boxed{}. - Paradigma publica AIME 2026 y BeyondAIME como avg@32 (
group_size=32,suites.py, líneas 66-74 y 373-380). - Presupuesto de tokens
max_model_len - CONTEXT_RESERVE= 131.072 - 4.096 = 126.976 (cli.py, líneas 51 y 135).
Lo nuestro: la misma revisión del dataset, instrucción, temperature 0,6, top_p 0,95 y presupuesto, una muestra por problema, corregida sobre el último \boxed{} de la respuesta.
Stack de servicio y sus trampas
Stack verificado (README de Paradigma): Python 3.12, vLLM 0.26.0, PyTorch 2.11.0 compilado para CUDA 13.0, Transformers 5.6.2, Linux x86-64, GPU NVIDIA con un driver para CUDA 13.0. Servicio de referencia:
git clone https://github.com/paradigma-inc/limite-violetto && cd limite-violetto
uv sync --locked
VLLM_PLUGINS=limite uv run --locked vllm serve paradigma-inc/limite-1b-violetto
# OpenAI-compatible API at http://localhost:8000/v1, POST /v1/chat/completions
- Plugin, no upstream.
limite-vllm0.1.0 (Apache-2.0,requires-python ~=3.12.0,torch>=2.11.0,transformers>=5.6.2,vllm>=0.26.0, torch del índicepytorch-cu130) se registra a través de[project.entry-points."vllm.general_plugins"] limite = "limite_vllm.register:register". RegistraLimiteConfigenAutoConfigyLimiteForCausalLMen elModelRegistryde vLLM. Sin el registro de la config, vLLM falla con un engañoso "Transformers does not recognize this architecture". PonVLLM_PLUGINS=limite. - Solo paralelismo de datos. El plugin lanza
Limite modeling supports data parallelism only.con paralelismo de tensor o de pipeline, rechazainputs_embedsy lanza un error siCacheConfig.sliding_windowde vLLM está definido ("Limite interleaves local and unwindowed global layers"). Deja TP y PP en 1. - CUDA 13 fijado. torch 2.11.0 viene del índice cu130; el driver del host tiene que soportar CUDA 13.0 (580+).
- Ruta de Transformers. Necesita
trust_remote_code=True, validado en una H100, SDPA por defecto. FlashAttention 2 conStaticCachese rechaza con un error explícito porque "does not produce numerically correct logits for Violetto's hybrid local/global attention layout". Usa SDPA conStaticCacheo FA2 conDynamicCache. Sin sharding, TP ni PP en Transformers; el entrenamiento y LoRA no están validados formalmente. No usamos esta ruta. - System prompt fijo. El uso de un solo turno es una instrucción de la ficha del modelo, no algo que imponga la plantilla.
chat_template.jinjalleva fijo el system promptYou are a helpful assistant.\nPlease reason step by step, and put your final answer within \boxed{}.y lanza un error con herramientas, llamadas a herramientas, contenido que no sea texto, cualquier mensaje de sistema personalizado u otros roles. - HEAD del repo del plugin en el momento de la prueba:
7ddad34f5e3d25ddea68c6745fc00373b82bca21"Fix stale documentation references" (2026-10-06); entre los commits anteriores están "Fix Limite EOS token ID" y "Relax vLLM runtime pins".
Nuestro montaje
- RTX 4090 de 24 GB, alquilada por horas en nuestra nube (24.564 MiB, driver 595.91.07, 450 W, 0,89 USD/h) para el examen completo y los peldaños emulados de la escalera.
- RTX 2000 Ada de 16 GB, alquilada por horas en nuestra nube (16.380 MiB, 70 W, 0,24 USD/h) para el peldaño de tarjeta pequeña real. La A4000 de 16 GB no tenía stock. No había ninguna tarjeta de 8 GB ni de 12 GB en la lista ni con stock.
- Workers arrancados por un manager local de InferenceKey a través de túneles HTTP y TCP; producción no se tocó.
- Por qué un backend a medida: el backend
vllmintegrado solo acepta las claves de configcommand,vllm_version,vllm_omni_version,torch_versionytransformers_version(crates/manager/src/domain/workloads.rs), así que no puede instalar un plugin externo.
Despliegue paso a paso
El ejemplo del SDK, commits b3ed051ffbf41fcacf6fa9cf7a438b9b9898afb8 (ejemplo) y 1671fdd03d25ed01c147f48190bd906b22451f77 (corrección del recuento) en main. Ficheros: backend.py, requirements.txt, publish.py, main.py, README.md, .env.example.
Necesitas un driver de NVIDIA para CUDA 13.0 (580+), Python 3.12 en el worker, un token del SDK de InferenceKey, una API key, un slug de proyecto y IK_WORKER_ID.
git clone https://github.com/inferencekey/inferencekey-sdk && cd inferencekey-sdk/examples/limite-1b-violetto-math-custom-backend-private-nvidia
cp .env.example .env                      # SDK token, API key, project, IK_WORKER_ID
python -m venv .venv && . .venv/bin/activate
pip install maturin requests pyarrow
(cd ../../bindings/python && maturin develop --release)
python publish.py                         # once: packages and registers the custom backend
Antes de la primera ejecución, el runtime del worker: hasta la próxima versión del SDK, el worker necesita el runtime de bindings/python en main, no el paquete inferencekey de PyPI. En nuestra prueba editamos a mano el manifiesto del worker para apuntar INFERENCEKEY_SDK_PYTHON_DIR a una copia del runtime en Python puro del clon del SDK (sdk 1e88eda) y relanzamos bootstrap-worker.sh; esto exige acceso manual al entorno del worker. Sin ello, cada petición de chat, incluida la primera, recibe un 404 y el cliente se queda colgado hasta el timeout de primer token de 180 s. Después:
python main.py # AIME 2026 problem 1
Antes de ejecutar más de un problema, sube la concurrencia. ensure() crea la asignación con max_in_flight 1, así que los problemas van de uno en uno. Súbelo (nosotros usamos 32) en el panel o con PATCH /api/projects/<project>/assignments/<workload>/<worker>, y después:
python main.py --problems all # all 30, streamed in parallel once max_in_flight is raised
Opcional: LIMITE_GPU_MEMORY_UTILIZATION (0.90 por defecto) e IK_KEEP_ALIVE=1 (conserva el workload después de la ejecución; por defecto main.py lo borra).
main.py llama a ensure() (slug del backend a medida, ready_timeout_secs 1800, request_timeout_secs 3600, max_model_len 131072, gpu_memory_utilization), después a wait_until_ready, descarga MathArena/aime_2026 en la revisión fijada, antepone la instrucción del evaluador, envía los problemas en streaming con MAX_TOKENS 126.976, corrige el último \boxed{} y escribe outputs/aime26.json.
requirements.txt fija vllm==0.26.0, transformers==5.6.2, ninja, inferencekey y limite-vllm @ git+https://github.com/paradigma-inc/limite-violetto@7ddad34f5e3d25ddea68c6745fc00373b82bca21.
backend.py (clase LimiteVioletto) arranca vllm serve paradigma-inc/limite-1b-violetto --max-model-len 131072 --gpu-memory-utilization 0.90 en loopback con VLLM_PLUGINS=limite, antepone el bin del venv al PATH (para que FlashInfer encuentre ninja), pone PR_SET_PDEATHSIG mediante prctl en el proceso hijo de vLLM, le reenvía chat() y chat_stream(), expone process() para quien llame a /process y descarta cualquier mensaje de sistema que no sea el canónico. Versiones del backend durante la prueba: 0.1.0 (falló, sin ninja), 0.1.1 (ninja), 0.1.2 (PR_SET_PDEATHSIG).
Tiempo hasta estar listo
- RTX 4090, primer arranque (backend 0.1.0): instalación de requirements con
uv23 s, descarga y carga de pesos 16,1 s ("Model loading took 1.95 GiB and 16.06 seconds"),torch.compile53,1 s y después un fallo en el warmup (sinninja).ensure()informó del fallo a los 130 s. - RTX 4090 en caliente (cachés de uv, Hugging Face y
torch.compileen la máquina): 31,2, 31,1, 31,5 y 31,1 s después deensure(). - RTX 2000 Ada, máquina nueva: 300,5 s (venv y requirements 54 s, carga 12,9 s,
torch.compile103,4 s, inicialización del motor 194 s).
Velocidad
| Tarjeta / config | Tokens/s por petición | Fuente |
|---|---|---|
| RTX 4090, util 0,90, a través del endpoint | 211 (2.913 tokens en 13,8 s, primer token en 0,29 s) | tiempos del cliente, vllm:generation_tokens_total |
| RTX 4090, directo a vLLM con otras 2 secuencias en marcha | 156,7 / 155,4 | tiempos del cliente |
| RTX 4090, 30 peticiones a la vez | pico de unos 3.636 en total (30 en marcha), unos 120 por petición | logger de vLLM |
| RTX 4090, límite 0,25 | 215 / 212 | ejecución de la escalera |
| RTX 4090, límite 0,17 | 213 / 209 | ejecución de la escalera |
| RTX 2000 Ada, util 0,90 | 85 / 85 | ejecución en tarjeta real |
El mayor tiempo por salida del peldaño 0,17 en la escalera (21,2 s frente a 13,8 s) se debe a una respuesta más larga (4.522 tokens frente a 2.913), no a una decodificación más lenta.
AIME 2026, resultados completos
RTX 4090, util 0,90, un intento por problema, temperature 0,6, top_p 0,95, presupuesto 126.976.
- Lote 1, los 30 a la vez: 26 terminadas, 25 bien. El #15 mal (respondió 10, oficial 83, unos 84K tokens, 881 s). El #9, el #13, el #28 y el #30 se perdieron por el bug de nuestro cliente. Tiempo total 981,5 s, marcado por el #10 (unos 101.404 tokens, 981 s, bien). Las respuestas terminadas fueron de 3.203 a 101.404 tokens, unos 702.107 en total, lo que da una media de 715 tokens/s en el lote (el pico de 3.636 cae a medida que terminan las respuestas cortas).
- Repetición de las 4 perdidas: #13 bien (39, unos 19K tokens), #30 bien (393, unos 52K), #9 mal (5 frente a 29, unos 23K), #28 sin respuesta (el stream terminó tras unos 111.131 tokens a los 830 s con
finish_reason: stop, a mitad de frase, sin\boxed{}; causa no aislada). - Total: 27 bien, 2 mal, 1 sin respuesta (27/30 = 90 %, un intento). No comparable con avg@32.
- Tokens por problema, los 30 intentos finales (tokenizer del modelo sobre el texto en streaming, porque el uso no se reenvía en el stream): 907.601 en total, media de unos 30.253, mediana de unos 21.267, rango de 3.203 (#1) a unos 111.131 (#28). Las 27 correctas: 689.233 tokens, mediana de 19.192.
generation_tokens_totalde vLLM marcaba unos 1.062.530 después del lote 1, por encima del recuento del cliente, porque las peticiones cuyos clientes murieron siguieron generando en el servidor.- Ejecución de demo (5 problemas a la vez con 2 peticiones largas en paralelo): 5 de 5 bien en 96 s, 38.303 tokens, unos 400 tokens/s entre todas las peticiones.
Coste por problema resuelto (nuestras cuentas)
Lote 1: 981,5 s a 0,89 USD/h = unos 0,243 USD = unos 0,217 euros (cambio de 0,89342 USD/EUR, 2026-10-23) para 25 resueltos, así que unos 0,0087 euros por problema resuelto, o unos 115 resueltos por euro de tiempo de GPU del lote. Esto excluye el montaje, el arranque y el tiempo parado, y el lote no estaba ordenado por longitud.
Escalera de VRAM, cifras completas
| Objetivo | Config | Pico de memoria de la tarjeta | Velocidad | Salida correcta | Tarjeta real |
|---|---|---|---|---|---|
| RTX 4090 24 GB | util 0,90, contexto 131.072, KV 18,75 GiB (1.465.844 tokens) | 22.768 MiB (vLLM la reserva de entrada) | 211 tok/s, 13,8 s por salida | sí (27/30) | sí |
| Límite de ~6 GB en la 4090 | util 0,25, KV 3,69 GiB (288.515 tokens) | 7.118 MiB | 215 / 212 tok/s; #1 y #5 bien | sí | emulada |
| Límite de ~4 GB en la 4090 | util 0,17, KV 1,81 GiB (141.408 tokens) | 5.198 MiB | 213 / 209 tok/s; #1 y #5 bien | sí | emulada |
| Límite de ~3 GB en la 4090 | util 0,12 | n/d | ValueError: To serve at least one request with the model's max seq len (131072), (1.68 GiB KV cache is needed, which is larger than the available KV cache memory (0.63 GiB)... estimated maximum model length is 39872 | no, no arranca | emulada |
| RTX 2000 Ada 16 GB | util 0,90, KV 11,64 GiB (909.801 tokens) | sin muestrear (el muestreador no arrancó en esa máquina) | 85 tok/s, 33,5 s por salida; #1 y #5 bien | sí | sí |
Los peldaños emulados limitan la parte de vLLM con --gpu-memory-utilization; el contexto CUDA queda fuera del límite, de ahí los 7.118 y 5.198 MiB en la tarjeta. Emulan solo la memoria, no el cómputo ni el ancho de banda de una tarjeta más pequeña. Un --max-model-len más corto dejaría arrancar el límite de 0,12; no lo probamos, y cortaría las respuestas que pasaron de 40K tokens. Sin probar: tarjetas reales de 8 GB y de 12 GB.
Problemas encontrados
inferencekey0.260725.739 de PyPI no tiene runtime dechat(). Con el manifiestoapi: openai-chatel worker enrutaba el chat a/v1/chat/completionsy recibía404 {"error": "not found"}. Apaño: ponerINFERENCEKEY_SDK_PYTHON_DIRen el worker apuntando a un runtime en Python puro más nuevo del repo del SDK. Abierto hasta una versión del SDK; el README del ejemplo lo documenta como problema conocido.- El error del stream no se propaga. Con ese 404 el cliente no recibía ningún evento de error y esperaba hasta el timeout de primer token de 180 s. Abierto.
- Al venv del backend a medida le faltaba
ninja. El warmup de vLLM fallaba conFileNotFoundError: [Errno 2] No such file or directory: 'ninja'(JIT de FlashInfer); el worker solo instala ninja para el backend vllm integrado. Arreglado en el ejemplo (wheel deninjamás elbindel venv en elPATH). vllm servehuérfano. Borrar un workload cuyosetup()seguía esperando paraba solo el pid del backend; vLLM se quedaba con 22,5 GB y PPID 1. Arreglado en el ejemplo conPR_SET_PDEATHSIG(backend 0.1.2), verificado.ensure()crea la asignación conmax_in_flight1. Le hicimos PATCH a 32 para el lote. Volver a ejecutarensure()sobre un workload ya listo se quedó colgado enwait_until_readydurante 5 minutos; en su lugar usamos un script de benchmark contra el endpoint listo. Abierto.- El bug de nuestro cliente.
requests.iter_lines(decode_unicode=True)partía las líneas SSE en un separador Unicode dentro de un token, lo que dabaJSONDecodeErrory perdía 4 de 30 respuestas en el lote 1. Arreglado partiendo sobre bytes. Los clientes matados dejan sus peticiones generando en el servidor. - El uso no se reenvía en el stream. Los recuentos de tokens salen del tokenizer sobre el texto. Abierto.
- #28 terminó tras unos 111K tokens con
finish_reason: stopy sin respuesta; no aislado. - El muestreador de memoria de GPU no arrancó en la máquina de la RTX 2000 Ada, así que ese peldaño no tiene pico de memoria de la tarjeta.
Vídeo de demo
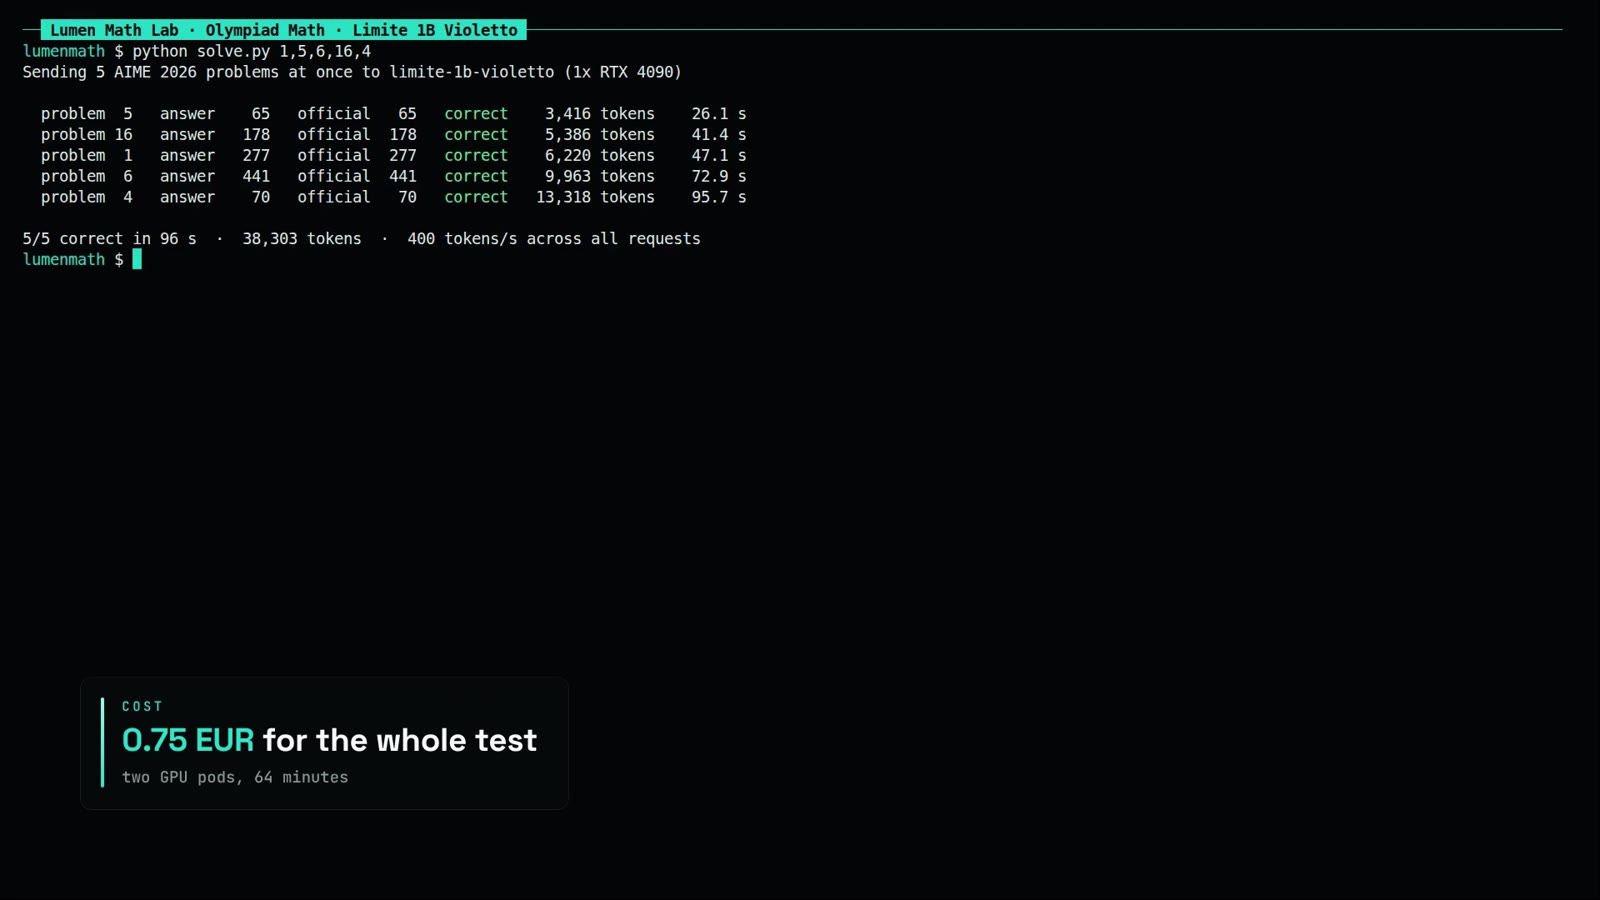
Demo de despliegue narrada, 2 min 34 s, 1920 x 1080: el workload en una RTX 4090 y después cinco problemas (1, 5, 6, 16 y 4) resueltos a la vez, 5 de 5 bien en 96 segundos.
Fuentes
- Ficha del modelo: https://huggingface.co/paradigma-inc/limite-1b-violetto (README,
config.json,generation_config.json,chat_template.jinja,assets/evaluations.png) - Plugin y evaluaciones: https://github.com/paradigma-inc/limite-violetto (README,
pyproject.toml,src/limite_vllm/register.py,src/limite_vllm/modeling.py,limite-evals/src/limite_evals/suites.py,cli.py) - Blog: https://paradigma.inc/blog/limite-1b-violetto/
- Dataset: https://huggingface.co/datasets/MathArena/aime_2026
- Dónde lo vimos: AI Search, https://www.youtube.com/watch?v=nX0fgBL3sIM (27 de septiembre de 2026, hacia el 0:31:46)
- Nuestro ejemplo del SDK: https://github.com/inferencekey/inferencekey-sdk/tree/main/examples/limite-1b-violetto-math-custom-backend-private-nvidia