Limite 1B löste 27 von 30 Aufgaben der AIME 2026 mit je einem Versuch, für unter einen Cent pro Aufgabe im Stapel
Paradigmas 1B-Mathemodell auf der AIME 2026 bewertet: 27 von 30 mit je einem Versuch, 211 Tokens/s auf einer RTX 4090, und eine echte 16-GB-Karte lief auch.
Eine Benchmark-Tabelle ist ein Versprechen, und ein Modell, das so billig läuft, lässt sich leicht nachprüfen. Paradigma sagt, sein Limite 1B Violetto, ein Mathemodell in einer Datei von 2,1 GB, erreicht 94 % bei der AIME 2026, der amerikanischen Einladungsprüfung für die besten Schülerinnen und Schüler der Oberstufe. Also haben wir es selbst bewertet, auf einer RTX 4090 in unserer Cloud. Es hat 27 der 30 Aufgaben richtig gelöst, mit je einem Versuch. Auch eine echte 16-GB-Karte hat funktioniert. Mit allen 30 Aufgaben auf einmal hat der ganze Stapel etwa 22 Euro-Cent GPU-Zeit gekostet. Unser SDK-Beispiel deployt das Modell und bewertet es für dich.
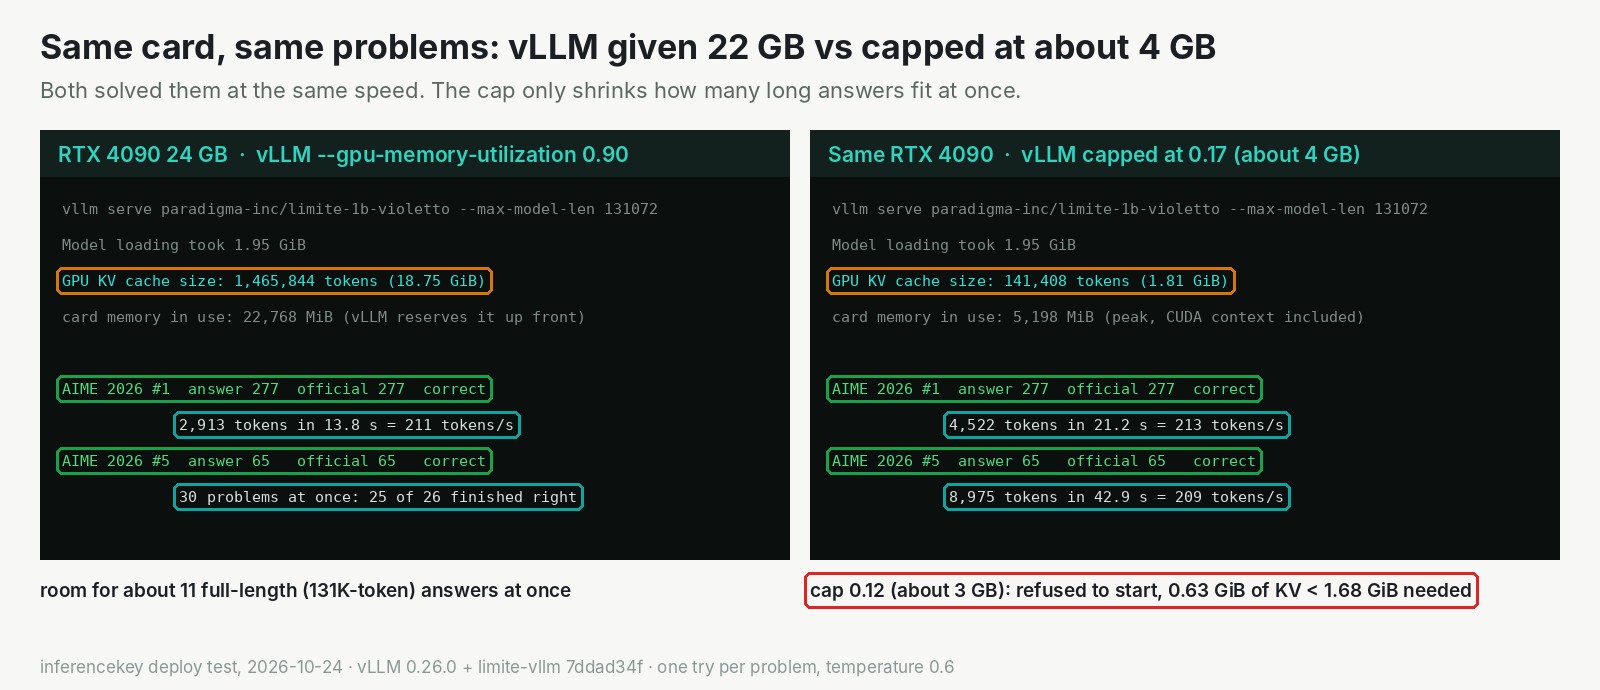
Gleiche Karte, gleiche Aufgaben. Die Speichergrenze hat keine Antwort langsamer gemacht. Sie verringert nur, wie viele lange Antworten gleichzeitig hineinpassen.
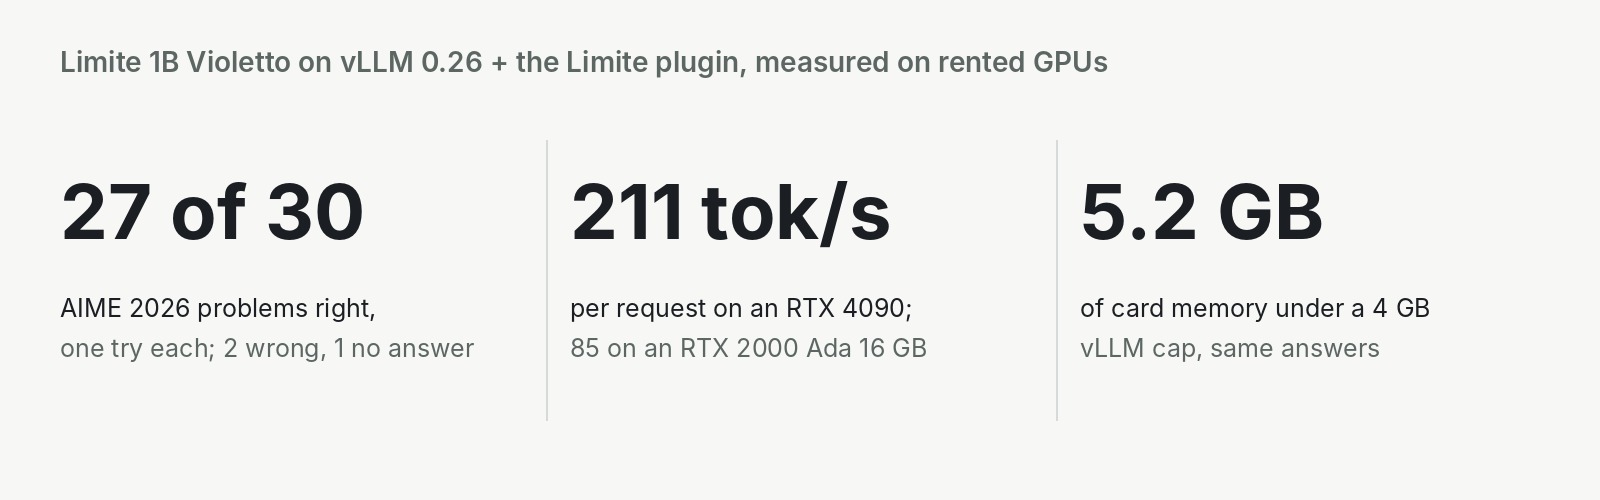
Ein 2-GB-Modell, von Grund auf für einen einzigen Job trainiert
Limite 1B Violetto ist das erste Modell von Paradigma. Die Behauptung, die uns hat hinschauen lassen, steht in der Model Card: „Limite achieves an average of 74.25% on BeyondAIME, with MUSE-Glimmer-30B scoring 70%.“ (Limite erreicht im Schnitt 74,25 % bei BeyondAIME, MUSE-Glimmer-30B kommt auf 70 %.) BeyondAIME ist ein zweiter Satz Wettbewerbsaufgaben. MUSE-Glimmer-30B ist ein Modell, das dreißigmal so groß ist. In Paradigmas Evaluierungstabelle erreicht Limite 94,01 % bei der AIME 2026, und diese Zahl konnten wir testen.
Es macht Wettbewerbsmathematik und sonst nichts. Es ist eine einzige Datei von 2,1 GB, klein genug für eine billige Karte.
Limite liegt nicht in jedem Test dieser Tabelle vorn. Von seinen sieben Tests ist BeyondAIME der einzige, in dem Limite den höchsten gemeldeten Wert hat. Qwen3.6-27B (94,10) und GLM 5.2 (99,20) liegen bei der AIME 2026 darüber, beide Werte aus anderen Quellen übernommen und nicht von Paradigma nachgerechnet. MUSE-Glimmer-30B selbst schlägt es in drei Tests. Es ist nicht der Spitzenreiter, aber es spielt in der Liga von Modellen, die Dutzende Male größer sind.
Der Verdienst gehört den Leuten, die es gebaut haben. Der Blog nennt Prignano, Cirillo, Morosini, Cerovaz, Bartolocci, Rodolà, Starace und Pappone als Autoren. Sie haben das Modell in etwa sechs Wochen trainiert. Sie haben es unter Apache 2.0 veröffentlicht, zusammen mit ihrem Evaluierungscode und einem Hilfsmodell aus dem Training. Außerdem haben sie ein Plugin geschrieben, damit vLLM, das Open-Source-Programm, das Modelle ausliefert, es ausführen kann. Ein technischer Bericht ist für später angekündigt. Die AIME-Aufgaben, die wir bewertet haben, stammen von MathArena, die die Aufgaben als Datensatz für die Evaluierung von Modellen veröffentlichen.
Entdeckt haben wir Limite im News-Video von AI Search vom 27. September. Der Moderator merkte an, dass „the total size of everything is only like 2 gigabytes“ (alles zusammen nur ungefähr 2 Gigabyte groß ist). Wir haben die Version laufen lassen, die Paradigma zuletzt am 6. Oktober aktualisiert hat. Unser Teil war der Rest: ihr Plugin in ein deploybares Paket stecken, es auf zwei Karten laufen lassen und jede Antwort bewerten.
Der Test: 30 Aufgaben, je ein Versuch, von uns bewertet
Unsere Zahl kann bestätigen, dass das Modell in Paradigmas Bereich liegt, sie kann es aber nicht auf die Nachkommastelle festnageln. Paradigmas 94,01 % sind ein Durchschnitt über 32 Versuche pro Aufgabe. Wir haben jeder Aufgabe einen Versuch gegeben, so wie jemand die Prüfung einmal schreibt, und ein Durchgang streut mehr als 32.
Alles andere übernimmt Paradigmas eigenes Evaluierungs-Setup. Dieselben 30 Aufgaben, in genau der Datensatzversion, die ihr Evaluator festschreibt. Dieselbe Anweisung vor jeder Aufgabe, die die Endantwort in einem Kasten verlangt. Dieselben Sampling-Einstellungen, die jeder Antwort ein wenig Zufall lassen. Dasselbe Schreibbudget, knapp 127.000 Tokens pro Antwort. Unser Skript hat dann die letzte Antwort im Kasten mit der offiziellen verglichen.
BeyondAIME haben wir nicht laufen lassen, der Vergleich mit MUSE-Glimmer-30B bleibt also Paradigmas Behauptung. Wir haben nicht geprüft, ob Limite diese Aufgaben im Training gesehen hat. Die AIME 2026 war seit Februar öffentlich, Monate vor dem Training. Bei einem neueren Satz, ArXivMath Mai 2026, kommt es auf 25 % gegen etwa 57 % für GLM 5.2. Unser Ergebnis passt zu Paradigmas Zahl für diesen Satz, es beweist aber nicht, dass das Modell Mathematik beherrscht, die es nie gesehen hat. Wir haben nur die letzte Zahl im Kasten bewertet, nicht den Rechenweg. Wir haben es in unserer Cloud über einen lokalen Test-Build von InferenceKey laufen lassen, nicht über den gehosteten Dienst.
Ergebnisse: 27 von 30 im ersten Versuch richtig, richtige Antworten 3.000 bis 101.000 Tokens lang
| Ergebnis | Aufgaben | Detail |
|---|---|---|
| Richtig | 27 | |
| Falsch | 2 | #9 antwortete 5 (offiziell 29), #15 antwortete 10 (offiziell 83) |
| Keine Antwort | 1 | #28 schrieb etwa 111.000 Tokens über 14 Minuten und hörte dann mitten im Satz auf |
Warum #28 aufgehört hat, konnten wir nicht eingrenzen. Die Antwort endete mitten im Satz mit einem normalen Stoppsignal, etwa 16.000 Tokens vor dem Ende des Schreibbudgets. Sie zählt als Fehlschlag.
Das Modell schreibt viel, bevor es antwortet. Ein Modell wie dieses rechnet auf Papier, so wie du es tun würdest: Es probiert einen Ansatz, prüft ihn, geht zurück und probiert einen anderen. All das ist Text, den es erzeugt, und du wartest auf jedes einzelne Token davon. Die kürzeste richtige Antwort, Aufgabe 1, brauchte 3.203 Tokens. Die längste, Aufgabe 10, brauchte etwa 101.000 Tokens Rechenarbeit, bevor sie das richtige Ergebnis in den Kasten setzte. Die Hälfte der Aufgaben brauchte weniger als etwa 21.000 Tokens.
Diese Länge bestimmt alles andere. Zuerst haben wir alle 30 Aufgaben auf einmal geschickt. Die Karte hat an allen gleichzeitig gearbeitet und in der Spitze etwa 17-mal so schnell geschrieben wie bei einer einzelnen Antwort. Aber ein Stapel verhält sich wie ein Prüfungsraum, der erst schließt, wenn der Letzte abgibt. Die kürzesten Antworten kamen in deutlich unter einer Minute zurück. Der Raum blieb 16 Minuten offen, weil Aufgabe 10 weiterschrieb. Vier Antworten, die ein Bug in unserem eigenen Test-Client gekostet hatte, haben wir neu laufen lassen.
Allein läuft eine Antwort auf der 4090 mit etwa 211 Tokens pro Sekunde. Das klingt schnell, aber eine typische Aufgabe mit 21.000 Tokens dauert trotzdem knapp zwei Minuten und die längste acht. Diesem Modell gibst du einen Stapel Aufgaben, mit ihm chattest du nicht.
Eine gelöste Aufgabe kostet unter einem Euro-Cent, wenn die Karte voll ist
Der Stapel mit 30 Aufgaben hat auf einer RTX 4090 zu etwa 0,80 Euro pro Stunde rund 22 Euro-Cent gekostet, und 25 Antworten waren richtig. Diese Zahl zählt nur die Zeit, in der die Karte beschäftigt war, nicht Start- oder Leerlaufzeit.
Erst der Stapel macht diese Zahl möglich: Eine einzelne Antwort lässt die Karte größtenteils leerlaufen. Aufgaben nach erwarteter Länge zu gruppieren sollte die Wartezeit verkürzen; das haben wir nicht getestet.
Wo es bricht: eine Frage auf einmal, und nur Mathematik
Limite beantwortet eine Mathefrage pro Unterhaltung, mit einer festen Eröffnungsanweisung, und Paradigma sagt das vorab. Die Model Card bittet dich, nur die Standard-Eröffnungsanweisung und die aktuelle Frage zu schicken, ohne frühere Nachrichten. Diese Regel ist Paradigmas Rat. Das Eingabeformat erzwingt sie nicht, aber es lehnt eine eigene Eröffnungsanweisung oder Tools ab.
Frag es etwas anderes, und es macht aus deiner Frage Mathematik. Paradigmas eigener Blog zeigt es. „Was ist Photosynthese?“ kam als Aufgabe über Zellteilung zurück. „Was verursacht die Jahreszeiten auf der Erde?“ wurde zu einer Antwort über den 400-Jahres-Zyklus des gregorianischen Kalenders. Eine eingeschleuste Anweisung, BANANA auszugeben, brachte Mathematik über eine Folge namens BANANA zurück. Bei einem Mathemodell ist das sympathisch, für alles andere ein Ausschlusskriterium. Es ist kein Chat-Assistent, kein Tool für einen Agenten und kein Allzweckhelfer.
Unser Deployment-Code nimmt dir einen Teil davon ab. Er verwirft jede Eröffnungsanweisung, die nicht die Standardanweisung ist, damit eine App, die für ein Chat-Modell gebaut ist, ihre Anfrage nicht abgelehnt bekommt.
Welche GPU: Eine echte 16-GB-Karte lief, und eine Grenze von 4 GB bestand zwei kurze Aufgaben
Du brauchst keine 4090: Eine echte RTX 2000 Ada mit 16 GB, eine kleine Workstation-Karte, hat die Aufgaben 1 und 5 richtig gelöst, 2,5-mal langsamer.
Um kleiner zu werden, ohne Karten zu suchen, haben wir vLLM angewiesen, nur einen Teil des Speichers der 4090 zu nutzen. Das emuliert den Speicher einer kleineren Karte, nicht ihren langsameren Chip. Hier ist die Leiter, von groß nach klein:
| Karte oder Grenze | Belegter Kartenspeicher | Aufgaben 1 und 5 | Tempo pro Antwort | Echte Karte oder emuliert |
|---|---|---|---|---|
| RTX 4090 24 GB, 90 % für vLLM | etwa 22,8 GB | richtig | 211 Tokens/s | echt |
| RTX 2000 Ada 16 GB, 90 % für vLLM | nicht gemessen | richtig | 85 Tokens/s | echt |
| 4090 begrenzt auf etwa 6 GB | etwa 7,1 GB | richtig | 215 und 212 Tokens/s | emuliert |
| 4090 begrenzt auf etwa 4 GB | etwa 5,2 GB | richtig | 213 und 209 Tokens/s | emuliert |
| 4090 begrenzt auf etwa 3 GB | startete nicht | emuliert |
Bei den begrenzten Läufen hat die Karte etwa 1 GB mehr belegt als die Grenze.
Was die Grenze ändert, ist, wie viele lange Antworten gleichzeitig hineinpassen. Der Server reserviert Speicher für jede Antwort, die er gerade schreibt. Unter der Grenze von 4 GB hatte dieser Speicher Platz für etwa eine Antwort in voller Länge; die vollen 24 GB fassten etwa elf. Unter der Grenze haben wir nur zwei kurze Aufgaben laufen lassen, und echte Karten mit 8 GB und 12 GB haben wir nicht ausprobiert.
Bei etwa 3 GB wollte der Server nicht starten. Er will Platz für eine Antwort in der vollen Länge des Modells, 131.072 Tokens, und der übrige Platz reichte nicht. vLLM schlug eine kürzere Grenze von etwa 40.000 Tokens vor, die die längsten Antworten, die wir gesehen haben, abschneiden würde. Das haben wir nicht ausprobiert.
Auf InferenceKey: in 31 Sekunden bereit, mit Paradigmas Plugin in einem Custom Backend
Die Karte gehört stundenweise dir, also kannst du den eigenen Server-Code des Modells darauf installieren. Du bist nicht auf das beschränkt, was wir vorab paketieren. Genau das brauchte Limite. Unsere eingebaute vLLM-Option installiert nur vLLM, und dieses Modell braucht obendrauf Paradigmas Plugin. Also haben wir ein Custom Backend geschrieben: eine kurze Python-Datei, die genau die Versionen installiert, die Paradigma verifiziert hat, vLLM mit eingeschaltetem Plugin startet und die Fragen durchreicht. Dein Code ruft es so auf wie die Chat-API von OpenAI.
Mit allem bereits auf der Karte heruntergeladen war ein Neustart in 31 Sekunden bereit, viermal hintereinander. Eine brandneue RTX 2000 Ada brauchte beim ersten Mal fünf Minuten, etwa ein Drittel davon, um das Modell für diese Karte zu kompilieren. Das Setup braucht einen aktuellen NVIDIA-Treiber und Python 3.12, wie Paradigmas Plugin es verlangt.
Eine raue Stelle, auf die auch du stoßen wirst:
- Unser veröffentlichtes SDK kann noch keine Chat-Anfragen beantworten. Die GPU-Maschine hat auf jede Frage „not found“ zurückgegeben. Der Client hat dann drei Minuten auf ein Timeout gewartet, statt einen Fehler anzuzeigen. Wir haben ihn auf den neueren Code im SDK-Repository gerichtet, und es hat funktioniert. Status: offen bis zum nächsten SDK-Release. Das README des Beispiels dokumentiert das Problem. Der Workaround, im Abschnitt für Ingenieure unten, heißt, die Einstellungen der GPU-Maschine von Hand zu ändern.
Solltest du es nutzen? Ja für Wettbewerbsmathe auf einer kleinen Karte, nein für alles Gesprächsartige
- Wenn du ausgearbeitete Lösungen für Wettbewerbsaufgaben mit einer einzigen Endantwort brauchst, lohnt es sich, es laufen zu lassen. Prüf die Antwort im Kasten, bevor du ihr vertraust.
- Wenn du einen Chat-Assistenten, Tools oder Rückfragen brauchst, schau dich anderswo um. Es beantwortet eine Mathefrage auf einmal und macht aus allem anderen Mathematik.
- Wenn du schnelle Antworten für eine einzelne Person brauchst, ist es das falsche Werkzeug: Vor jeder Antwort arbeitet es sich durch seitenweise Überlegungen.
- Wenn deine Karte klein ist, sieh dir den GPU-Abschnitt an.
- Wenn du eine Lizenz für ein Produkt brauchst, deckt Apache 2.0 die kommerzielle Nutzung ab.
Um Aufgabe 1 der AIME 2026 auf deiner eigenen NVIDIA-GPU zu bewerten, veröffentlichst du das Backend mit python publish.py und startest python main.py aus dem SDK-Beispiel. Du brauchst ein InferenceKey-Projekt, einen Treiber für CUDA 13.0 (580 oder neuer), Python 3.12 und, bis zum nächsten SDK-Release, den neueren SDK-Code auf der GPU-Maschine.
Für Ingenieure
Modell und Dateien
Model Card, GitHub (paradigma-inc/limite-violetto), Blog von Paradigma. Repo paradigma-inc/limite-1b-violetto, angelegt 2026-09-21, lastModified 2026-10-06T21:59:07Z, sha 9f4d1567975a44c35127503deadfe52d434d734f, Lizenz Apache-2.0, 16.841 Downloads und 125 Likes am 2026-10-24. Dateihistorie (HF-Tree-API): model.safetensors zuletzt committet 2026-09-21 ("Add files using upload-large-folder tool"); config.json, generation_config.json und contract.py am 2026-09-29 (Fix des EOS-Tokens); configuration_limite.py, modeling_limite.py und README.md am 2026-10-06 (Einschränkungen für Data Parallel in Transformers). Eine model.safetensors mit 2.070.811.520 Bytes; die safetensors-Metadaten zählen 1.035.253.888 Parameter (1.035.141.120 BF16 plus 112.768 F32).
config.json: LimiteForCausalLM, model_type: limite, eigener Code (auto_map auf configuration_limite.py / modeling_limite.py). 48 Layer, hidden 1.280, SwiGLU intermediate 3.328, 10 Attention-Heads, 2 KV-Heads, head_dim 128, Vokabular 151.680, gebundene Embeddings, max_position_embeddings 131.072. Hybride Attention: 36 lokale Layer mit sliding_window 1.024 und 12 globale Layer (3, 7, ..., 47; global_every 4) mit global_nope: true (keine Positionskodierung auf den globalen Layern). Das GitHub-README trägt AIME 2026 94,01 % bei geschätzten 1,71 x 10^21 Trainings-FLOPs ein (ohne RL). Die Model Card sagt, die Architektur sei "strongly inspired by recent advancements made by the community on pre-training speedrun competitions"; es hat etwa eine Milliarde Parameter ("1B"), und das Team hat es von Grund auf mit weniger als 300 Milliarden kuratierten Tokens trainiert und danach kuratiertes SFT- und RL-Post-Training mit synthetischen Daten angewendet. "Parameter" sind die Zahlen, die ein Modell im Training lernt. Das Release enthält außerdem ein Value-Modell, das im Training verwendet wurde.
generation_config.json liefert temperature 0.6 und top_p 0.95 mit, die vLLM automatisch lädt; explizite Request-Parameter überschreiben sie.
Paradigmas Evaluierungstabelle (evaluations.png), Limite-1B-Violetto: AIME 2026 94,01, HMMT Feb 2026 83,62, APEX Shortlist 50,80, BeyondAIME 74,25, AIME 2025 90,21, HMMT Feb 2025 91,35, ArXivMath May 2026 25,08. Vergleichsmodelle bei AIME 2026 / BeyondAIME: MUSE-Glimmer-30B 93,44 / 70,00, VibeThinker-3B 93,85 / 72,00, MiniCPM5-2B 90,21 / 60,59, Qwen3.5-9B 90,42 / 65,56, Gemma-4-31B-IT 89,17 / 71,00, Qwen3.6-27B (Dagger) 94,10 / nicht gemeldet, GLM 5.2 753B (Dagger) 99,20 / nicht gemeldet, NVIDIA-Nemotron-3-Super 120B (Dagger) 91,67. Dagger: aus Model Cards oder von MathArena übernommen, nicht von Paradigma nachgerechnet. Limite hat nur bei BeyondAIME den höchsten gemeldeten Wert. In den anderen sechs Spalten schlagen es andere Zeilen: AIME 2026 (Qwen3.6-27B Dagger 94,10, GLM 5.2 Dagger 99,20, gegen 94,01), HMMT Feb 2026 (Qwen3.6-27B Dagger 84,30, Nemotron-3-Super Dagger 84,85, Gemini 3 Pro Dagger 86,36, GLM 5.2 Dagger 92,50, gegen 83,62), APEX Shortlist (MUSE-Glimmer-30B 51,66, Qwen3.5-27B Dagger 52,13, Nemotron-3-Super Dagger 57,45, Gemini 3 Pro Dagger 66,49, GLM 5.2 Dagger 68,09, gegen 50,80), AIME 2025 (VibeThinker-3B 92,19, MUSE-Glimmer-30B 92,71, Gemini 3 Pro Dagger 95,00, gegen 90,21), HMMT Feb 2025 (Qwen3.6-27B Dagger 93,80, Gemini 3 Pro Dagger 97,50, gegen 91,35) und ArXivMath May 2026 (VibeThinker-3B 29,77, MUSE-Glimmer-30B 28,91, Qwen3.5-9B 31,64, Gemma-4-31B-IT 35,78, GLM 5.2 Dagger 56,67, neben anderen, gegen 25,08). MUSE-Glimmer-30B, das Vergleichsmodell der Model Card, schlägt Limite bei APEX Shortlist, AIME 2025 und ArXivMath. Die Anmerkungen der Model Card unter der Tabelle sagen, dass sich die Evaluierungskonfigurationen zwischen Modellen und Quellen unterscheiden können.

Evaluierungsprotokoll
Aus limite-evals in Paradigmas Repo:
- Datensatz
MathArena/aime_2026(auf Hugging Face angelegt am 2026-02-13) in Revision10b4e45b7a503075d4da8a0d57916a4f06ce6bd2(suites.pyZeilen 40-41). Die neueste Revision des Datensatzes weicht in 2 von 30 Zeilen ab; wir haben die festgeschriebene genutzt. Der Datensatz steht unter CC BY-NC-SA 4.0; das Beispiel lädt ihn zur Laufzeit herunter und verbreitet ihn nicht weiter. - Vorangestellte Anweisung:
Solve the following math problem. Explain your reasoning and put the final answer in \boxed{}. - Paradigma meldet AIME 2026 und BeyondAIME als avg@32 (
group_size=32,suites.pyZeilen 66-74, 373-380). - Token-Budget
max_model_len - CONTEXT_RESERVE= 131.072 - 4.096 = 126.976 (cli.pyZeilen 51, 135).
Unseres: dieselbe Datensatzrevision, Anweisung, temperature 0.6, top_p 0.95 und dasselbe Budget, ein Sample pro Aufgabe, bewertet auf dem letzten \boxed{} der Antwort.
Serving-Stack und seine Fallen
Verifizierter Stack (README von Paradigma): Python 3.12, vLLM 0.26.0, PyTorch 2.11.0 gebaut für CUDA 13.0, Transformers 5.6.2, Linux x86-64, NVIDIA-GPU mit einem Treiber für CUDA 13.0. Referenz-Serving:
git clone https://github.com/paradigma-inc/limite-violetto && cd limite-violetto
uv sync --locked
VLLM_PLUGINS=limite uv run --locked vllm serve paradigma-inc/limite-1b-violetto
# OpenAI-compatible API at http://localhost:8000/v1, POST /v1/chat/completions
- Plugin, nicht Upstream.
limite-vllm0.1.0 (Apache-2.0,requires-python ~=3.12.0,torch>=2.11.0,transformers>=5.6.2,vllm>=0.26.0, torch aus dem Indexpytorch-cu130) registriert sich über[project.entry-points."vllm.general_plugins"] limite = "limite_vllm.register:register". Es registriertLimiteConfigbeiAutoConfigundLimiteForCausalLMin derModelRegistryvon vLLM. Ohne die Registrierung der Config scheitert vLLM mit einem irreführenden "Transformers does not recognize this architecture". SetzVLLM_PLUGINS=limite. - Nur Data Parallel. Das Plugin wirft
Limite modeling supports data parallelism only.bei Tensor oder Pipeline Parallelism, lehntinputs_embedsab und wirft, wennCacheConfig.sliding_windowvon vLLM gesetzt ist ("Limite interleaves local and unwindowed global layers"). Lass TP und PP auf 1. - CUDA 13 festgeschrieben. torch 2.11.0 kommt aus dem cu130-Index; der Treiber des Hosts muss CUDA 13.0 unterstützen (580+).
- Transformers-Pfad. Braucht
trust_remote_code=True, validiert auf einer H100, standardmäßig SDPA. FlashAttention 2 mitStaticCachewird mit einem expliziten Fehler abgelehnt, weil es "does not produce numerically correct logits for Violetto's hybrid local/global attention layout". Nutze SDPA mitStaticCacheoder FA2 mitDynamicCache. Kein Sharding, TP oder PP in Transformers; Training und LoRA sind nicht formell validiert. Diesen Pfad haben wir nicht genutzt. - Fester System-Prompt. Single-Turn ist die Anweisung der Model Card, nichts, was das Template erzwingt.
chat_template.jinjacodiert den System-PromptYou are a helpful assistant.\nPlease reason step by step, and put your final answer within \boxed{}.fest ein und wirft bei Tools, Tool Calls, Inhalt, der kein String ist, jeder eigenen System-Nachricht oder anderen Rollen. - HEAD des Plugin-Repos zum Testzeitpunkt:
7ddad34f5e3d25ddea68c6745fc00373b82bca21"Fix stale documentation references" (2026-10-06); frühere Commits umfassen "Fix Limite EOS token ID" und "Relax vLLM runtime pins".
Unser Setup
- RTX 4090 24 GB, stundenweise gemietet in unserer Cloud (24.564 MiB, Treiber 595.91.07, 450 W, 0,89 USD/h) für die komplette Prüfung und die emulierten Sprossen der Leiter.
- RTX 2000 Ada 16 GB, stundenweise gemietet in unserer Cloud (16.380 MiB, 70 W, 0,24 USD/h) für die Sprosse mit der echten kleinen Karte. Eine A4000 16 GB war nicht verfügbar. Keine Karte mit 8 GB oder 12 GB war gelistet oder verfügbar.
- Worker gebootstrappt von einem lokalen InferenceKey-Manager über HTTP- und TCP-Tunnel; Produktion nie angefasst.
- Warum ein Custom Backend: Das eingebaute Backend
vllmakzeptiert nur die Config-Keyscommand,vllm_version,vllm_omni_version,torch_versionundtransformers_version(crates/manager/src/domain/workloads.rs), also kann es kein Plugin außerhalb des Trees installieren.
Deployment Schritt für Schritt
Das SDK-Beispiel, Commits b3ed051ffbf41fcacf6fa9cf7a438b9b9898afb8 (Beispiel) und 1671fdd03d25ed01c147f48190bd906b22451f77 (Korrektur der Auszählung) auf main. Dateien: backend.py, requirements.txt, publish.py, main.py, README.md, .env.example.
Du brauchst einen NVIDIA-Treiber für CUDA 13.0 (580+), Python 3.12 auf dem Worker, ein InferenceKey-SDK-Token, einen API-Key, einen Projekt-Slug und IK_WORKER_ID.
git clone https://github.com/inferencekey/inferencekey-sdk && cd inferencekey-sdk/examples/limite-1b-violetto-math-custom-backend-private-nvidia
cp .env.example .env                      # SDK token, API key, project, IK_WORKER_ID
python -m venv .venv && . .venv/bin/activate
pip install maturin requests pyarrow
(cd ../../bindings/python && maturin develop --release)
python publish.py                         # once: packages and registers the custom backend
Vor dem ersten Lauf die Worker-Runtime: Bis zum nächsten SDK-Release braucht der Worker die Runtime aus bindings/python auf main, nicht das PyPI-Paket inferencekey. In unserem Test haben wir das Worker-Manifest von Hand bearbeitet, um INFERENCEKEY_SDK_PYTHON_DIR auf eine Kopie der reinen Python-Runtime aus dem SDK-Klon zu setzen (sdk 1e88eda), und bootstrap-worker.sh neu gestartet; das braucht manuellen Zugriff auf die Umgebung des Workers. Ohne das bekommt jede Chat-Anfrage, auch die erste, ein 404, und der Client hängt bis zum First-Token-Timeout von 180 s. Dann:
python main.py # AIME 2026 problem 1
Bevor du mehr als eine Aufgabe laufen lässt, setz die Parallelität hoch. ensure() legt das Assignment mit max_in_flight 1 an, also laufen die Aufgaben nacheinander. Setz den Wert hoch (wir haben 32 genommen), im Panel oder mit PATCH /api/projects/<project>/assignments/<workload>/<worker>, dann:
python main.py --problems all # all 30, streamed in parallel once max_in_flight is raised
Optional: LIMITE_GPU_MEMORY_UTILIZATION (Standard 0.90) und IK_KEEP_ALIVE=1 (behält den Workload nach dem Lauf; standardmäßig löscht main.py ihn).
main.py ruft ensure() auf (Slug des Custom Backends, ready_timeout_secs 1800, request_timeout_secs 3600, max_model_len 131072, gpu_memory_utilization), dann wait_until_ready, lädt MathArena/aime_2026 in der festgeschriebenen Revision herunter, stellt die Anweisung des Evaluators voran, streamt die Aufgaben mit MAX_TOKENS 126.976, bewertet das letzte \boxed{} und schreibt outputs/aime26.json.
requirements.txt schreibt vllm==0.26.0, transformers==5.6.2, ninja, inferencekey und limite-vllm @ git+https://github.com/paradigma-inc/limite-violetto@7ddad34f5e3d25ddea68c6745fc00373b82bca21 fest.
backend.py (Klasse LimiteVioletto) startet vllm serve paradigma-inc/limite-1b-violetto --max-model-len 131072 --gpu-memory-utilization 0.90 auf Loopback mit VLLM_PLUGINS=limite, stellt das bin des venv an den Anfang von PATH (damit FlashInfer ninja findet), setzt PR_SET_PDEATHSIG über prctl auf dem vLLM-Kindprozess, leitet chat() und chat_stream() an ihn weiter, stellt process() für Aufrufer von /process bereit und verwirft jede System-Nachricht, die nicht die kanonische ist. Backend-Versionen während des Tests: 0.1.0 (gescheitert, kein ninja), 0.1.1 (ninja), 0.1.2 (PR_SET_PDEATHSIG).
Zeit bis bereit
- RTX 4090, erster Start (Backend 0.1.0):
uv-Installation der Requirements 23 s, Download und Laden der Gewichte 16,1 s ("Model loading took 1.95 GiB and 16.06 seconds"),torch.compile53,1 s, dann ein Absturz beim Warmup (keinninja).ensure()meldete den Fehler nach 130 s. - RTX 4090 warm (Caches von uv, Hugging Face und
torch.compileauf der Maschine): 31,2, 31,1, 31,5 und 31,1 s nachensure(). - RTX 2000 Ada, frische Maschine: 300,5 s (venv und Requirements 54 s, Laden 12,9 s,
torch.compile103,4 s, Engine-Init 194 s).
Tempo
| Karte / Konfiguration | Tokens/s pro Anfrage | Quelle |
|---|---|---|
| RTX 4090, util 0.90, über den Endpoint | 211 (2.913 Tokens in 13,8 s, erstes Token 0,29 s) | Client-Timing, vllm:generation_tokens_total |
| RTX 4090, direkt an vLLM mit 2 anderen laufenden Sequenzen | 156,7 / 155,4 | Client-Timing |
| RTX 4090, 30 Anfragen gleichzeitig | Spitze etwa 3.636 gesamt (30 laufend), etwa 120 pro Anfrage | vLLM-Logger |
| RTX 4090, Grenze 0.25 | 215 / 212 | Lauf der Leiter |
| RTX 4090, Grenze 0.17 | 213 / 209 | Lauf der Leiter |
| RTX 2000 Ada, util 0.90 | 85 / 85 | Lauf auf der echten Karte |
Die längere Zeit pro Ausgabe der Sprosse 0.17 in der Leiter (21,2 s gegen 13,8 s) kommt von einer längeren Antwort (4.522 Tokens gegen 2.913), nicht von langsamerem Decoding.
AIME 2026, vollständige Ergebnisse
RTX 4090, util 0.90, ein Versuch pro Aufgabe, temperature 0.6, top_p 0.95, Budget 126.976.
- Stapel 1, alle 30 gleichzeitig: 26 fertig, 25 richtig. #15 falsch (antwortete 10, offiziell 83, etwa 84K Tokens, 881 s). #9, #13, #28 und #30 an unseren Client-Bug verloren. Wandzeit 981,5 s, bestimmt von #10 (etwa 101.404 Tokens, 981 s, richtig). Die fertigen Antworten reichten von 3.203 bis 101.404 Tokens, zusammen etwa 702.107, im Schnitt 715 Tokens/s über den Stapel (die Spitze von 3.636 fällt, während die kurzen Antworten fertig werden).
- Neulauf der 4 verlorenen: #13 richtig (39, etwa 19K Tokens), #30 richtig (393, etwa 52K), #9 falsch (5 gegen 29, etwa 23K), #28 keine Antwort (Stream endete nach etwa 111.131 Tokens bei 830 s mit
finish_reason: stop, mitten im Satz, kein\boxed{}; Ursache nicht eingegrenzt). - Gesamt: 27 richtig, 2 falsch, 1 ohne Antwort (27/30 = 90 %, ein Versuch). Nicht vergleichbar mit avg@32.
- Tokens pro Aufgabe, alle 30 letzten Versuche (Tokenizer des Modells auf dem gestreamten Text, weil die Usage im Stream nicht weitergereicht wird): gesamt 907.601, Mittelwert etwa 30.253, Median etwa 21.267, Spanne 3.203 (#1) bis etwa 111.131 (#28). Die 27 richtigen: 689.233 Tokens, Median 19.192.
generation_tokens_totalvon vLLM stand nach Stapel 1 bei etwa 1.062.530, über der Zählung des Clients, weil Anfragen, deren Clients abgestürzt waren, auf dem Server weitergeneriert haben.- Demo-Lauf (5 Aufgaben gleichzeitig, mit 2 langen Anfragen parallel): 5 von 5 richtig in 96 s, 38.303 Tokens, etwa 400 Tokens/s über alle Anfragen.
Kosten pro gelöster Aufgabe (unsere Rechnung)
Stapel 1: 981,5 s zu 0,89 USD/h = etwa 0,243 USD = etwa 0,217 EUR (Kurs 0,89342 USD/EUR, 2026-10-23) für 25 gelöste, also etwa 0,0087 EUR pro gelöster Aufgabe, oder etwa 115 gelöste pro Euro GPU-Zeit des Stapels. Das schließt Setup, Start und Leerlauf aus, und der Stapel war nicht nach Länge sortiert.
VRAM-Leiter, vollständige Zahlen
| Ziel | Konfiguration | Spitze Kartenspeicher | Tempo | Ausgabe OK | Echte Karte |
|---|---|---|---|---|---|
| RTX 4090 24 GB | util 0.90, Kontext 131.072, KV 18,75 GiB (1.465.844 Tokens) | 22.768 MiB (vLLM reserviert ihn vorab) | 211 tok/s, 13,8 s pro Ausgabe | ja (27/30) | ja |
| ~6 GB Grenze auf 4090 | util 0.25, KV 3,69 GiB (288.515 Tokens) | 7.118 MiB | 215 / 212 tok/s; #1 und #5 richtig | ja | emuliert |
| ~4 GB Grenze auf 4090 | util 0.17, KV 1,81 GiB (141.408 Tokens) | 5.198 MiB | 213 / 209 tok/s; #1 und #5 richtig | ja | emuliert |
| ~3 GB Grenze auf 4090 | util 0.12 | n/a | ValueError: To serve at least one request with the model's max seq len (131072), (1.68 GiB KV cache is needed, which is larger than the available KV cache memory (0.63 GiB)... estimated maximum model length is 39872 | nein, startet nicht | emuliert |
| RTX 2000 Ada 16 GB | util 0.90, KV 11,64 GiB (909.801 Tokens) | nicht erfasst (der Sampler startete auf dieser Maschine nicht) | 85 tok/s, 33,5 s pro Ausgabe; #1 und #5 richtig | ja | ja |
Die emulierten Sprossen begrenzen den Anteil von vLLM mit --gpu-memory-utilization; der CUDA-Kontext liegt außerhalb der Grenze, daher 7.118 und 5.198 MiB auf der Karte. Sie emulieren nur den Speicher, nicht Rechenleistung oder Bandbreite einer kleineren Karte. Ein kürzeres --max-model-len würde die Grenze 0.12 starten lassen; das haben wir nicht ausprobiert, und es würde Antworten abschneiden, die über 40K Tokens liefen. Nicht ausprobiert: echte Karten mit 8 GB und 12 GB.
Gefundene Probleme
- PyPI
inferencekey0.260725.739 hat keinechat()-Runtime. Mit Manifestapi: openai-chathat der Worker Chat an/v1/chat/completionsgeroutet und404 {"error": "not found"}bekommen. Workaround:INFERENCEKEY_SDK_PYTHON_DIRauf dem Worker auf eine neuere reine Python-Runtime aus dem SDK-Repo setzen. Offen bis zu einem SDK-Release; das README des Beispiels dokumentiert es als bekanntes Problem. - Stream-Fehler nicht weitergegeben. Bei diesem 404 hat der Client kein Fehler-Event bekommen und bis zum First-Token-Timeout von 180 s gewartet. Offen.
- Dem venv des Custom Backends fehlte
ninja. Der Warmup von vLLM stürzte mitFileNotFoundError: [Errno 2] No such file or directory: 'ninja'ab (FlashInfer-JIT); der Worker installiert ninja nur für das eingebaute vllm-Backend. Im Beispiel behoben (ninja-Wheel plusbindes venv inPATH). - Verwaistes
vllm serve. Das Löschen eines Workloads, dessensetup()noch wartete, hat nur die pid des Backends gestoppt; vLLM hielt 22,5 GB mit PPID 1. Im Beispiel mitPR_SET_PDEATHSIGbehoben (Backend 0.1.2), verifiziert. ensure()legt das Assignment mitmax_in_flight1 an. Für den Stapel haben wir es per PATCH auf 32 gesetzt. Ein erneutesensure()auf einem bereits bereiten Workload hing 5 Minuten inwait_until_ready; stattdessen haben wir ein Bench-Skript gegen den bereiten Endpoint genutzt. Offen.- Unser Client-Bug.
requests.iter_lines(decode_unicode=True)hat SSE-Zeilen an einem Unicode-Trennzeichen innerhalb eines Tokens gespalten, wasJSONDecodeErrorergab und in Stapel 1 4 von 30 Antworten gekostet hat. Behoben durch Splitten auf Bytes. Abgebrochene Clients lassen ihre Anfragen auf dem Server weitergenerieren. - Usage im Stream nicht weitergereicht. Die Token-Zahlen kommen vom Tokenizer auf dem Text. Offen.
- #28 endete nach etwa 111K Tokens mit
finish_reason: stopund ohne Antwort; nicht eingegrenzt. - Der GPU-Speicher-Sampler startete auf der Maschine mit der RTX 2000 Ada nicht, deshalb hat diese Sprosse keine Spitze für den Kartenspeicher.
Demovideo
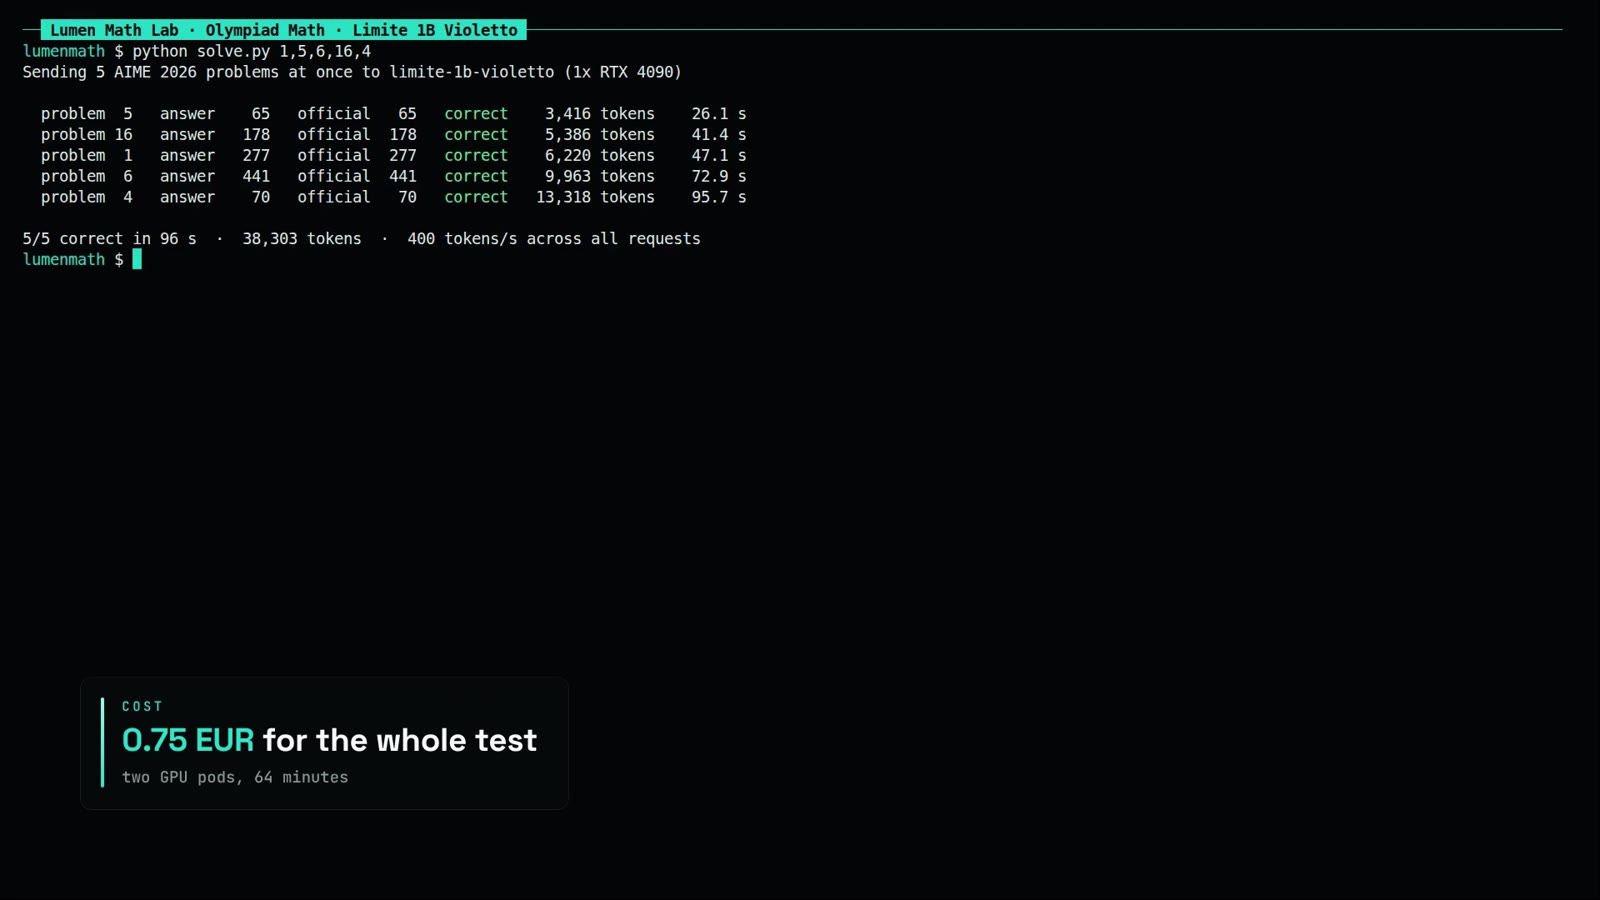
Deploy-Demo mit Sprecher, 2 min 34 s, 1920 x 1080: der Workload auf einer RTX 4090, dann fünf Aufgaben (1, 5, 6, 16 und 4) gleichzeitig gelöst, 5 von 5 richtig in 96 Sekunden.
Quellen
- Model Card: https://huggingface.co/paradigma-inc/limite-1b-violetto (README,
config.json,generation_config.json,chat_template.jinja,assets/evaluations.png) - Plugin und Evals: https://github.com/paradigma-inc/limite-violetto (README,
pyproject.toml,src/limite_vllm/register.py,src/limite_vllm/modeling.py,limite-evals/src/limite_evals/suites.py,cli.py) - Blog: https://paradigma.inc/blog/limite-1b-violetto/
- Datensatz: https://huggingface.co/datasets/MathArena/aime_2026
- Wo wir es entdeckt haben: AI Search, https://www.youtube.com/watch?v=nX0fgBL3sIM (27. September 2026, etwa bei 0:31:46)
- Unser SDK-Beispiel: https://github.com/inferencekey/inferencekey-sdk/tree/main/examples/limite-1b-violetto-math-custom-backend-private-nvidia